

最短路径分词基于词典全切分构造有向无环图,每条边赋予词频权重。采用Viterbi算法计算从起点到终点的最短总权值路径,通过转移概率和回溯确定最终分词结果,提升切分精度。
HanLP最短路径分词算法解析
作者:技术拾光
时间:2026-06-09
浏览:105
文章目录
最短路径分词——一个看起来直观,但实现起来颇有门道的算法。最近正好在折腾开发环境,顺带把一些基础内容重新梳理了一遍。这就来聊聊它的核心思路。
基本思想
先根据词典,把字串中所有可能的词都找出来,这就是所谓的“全切分”。然后,用这些词构造一个词语切分的有向无环图——可以理解成一个粗分词图。在这个图里,每个词对应一条有向边,每条边都可以带一个权值,这个权值可以是常数,也可以是词本身的属性。接下来,在起点到终点的所有路径中,找到一条总权值最短的路径,这条路径上的词,就是最终的切分结果。如果每个节点不只看一条最短路径,而是保留N条,那就成了N-最短路径算法。
提升切分精度的权重设计
为了进一步提升切分精度,可以在词典里给每个词加上属性,也就是权重。这样一来,不同词在汉字串中的权重就不一样了——有向图的边不再是等长的。最直接的权重可以用词频来表示:高频词权重大,低频词权重小。具体的权重值,可以通过大规模语料库统计获得。
Viterbi算法应用示例
有一点值得注意:虽然HanLP里也提供了Dijkstra算法的实现,但目前最短路径分词用的是Viterbi算法。我们来看一个例子:“他说的确实在理”。
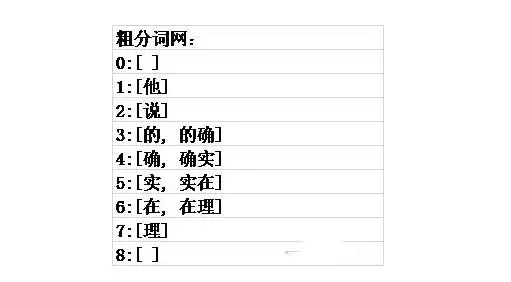
下面是详细的计算过程和回溯路径。
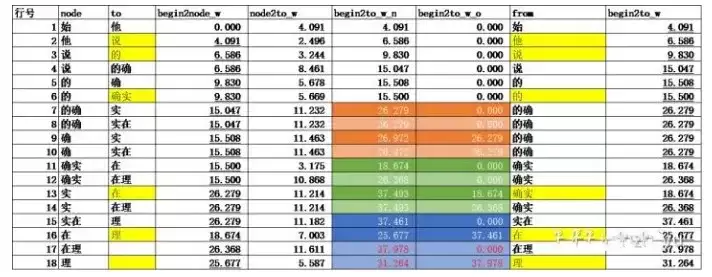
关键列含义解析
(1)node列与to列
node列存放的是粗分词网里的所有词,to列则表示在node为某个词的情况下,后面可能接的所有词。第一个词之前有个虚拟的“始”,最后一个词之后有个虚拟的“末”。
(2)begin2node_w的计算
这个值代表从“始”到当前node词的最短路径权值。计算方法是:找到待计算值所在行的node词,然后从该行向上查找第一次出现这个词的行,取那行中begin2to_w列对应的值。第一个词对“始-他”的begin2node_w值为0,因为起点就是0。
(3)node2to_w的计算
这个值由node和to构成的2-gram串的概率决定,也就是转移概率。计算公式如下:
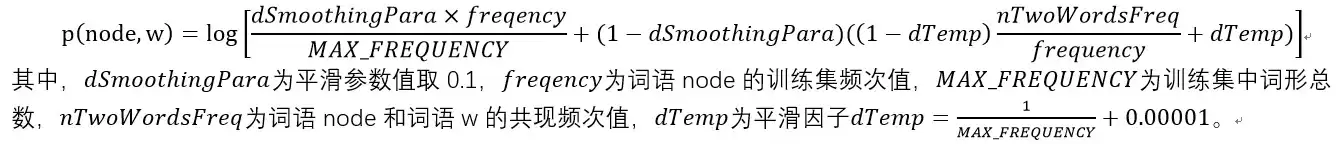
HanLP中的具体实现可以参考 MathUtility.ja va 的 calculateWeight(Vertex from, Vertex to) 方法。值得注意的是,“始”的频次取为 MAX_FREQUENCY,“始-他”的共现频次就是“他”作为句首的频次,“理-末”的共现频次则对应“理”作为句末的频次。
(4)begin2to_w_n的计算
这个值表示从“始”到to词的最短路径权值。计算公式很简单:begin2to_w_n = begin2node_w + node2to_w。
(5)begin2to_w_o
这个词记录的是在to词路径下,到to词的最短路径权值。初始值为0,之后由begin2to_w逐步更新。
(6)from
这个词表示to词的前驱词,也就是这条最短路径上,to的上一站是哪个词。
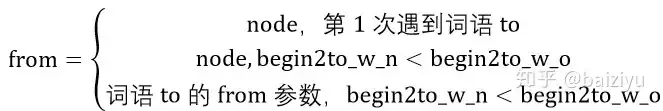
在表格中,(7,9)、(8,10)、(11,13)、(12,14)、(15,16)、(17,18)这几组成对行可以用来验证公式,其中只有(17,18)满足了第3个式子。
(6)和(7)的HanLP实现代码在 Vertex.ja va 的 updateFrom(Vertex from) 方法中。
确定分词路径的回溯过程
最后一步是回溯确定分词路径。从“末”开始向前回溯:末→理→在→确实→的→说→他。表格中的黄色单元格可以验证这一点。
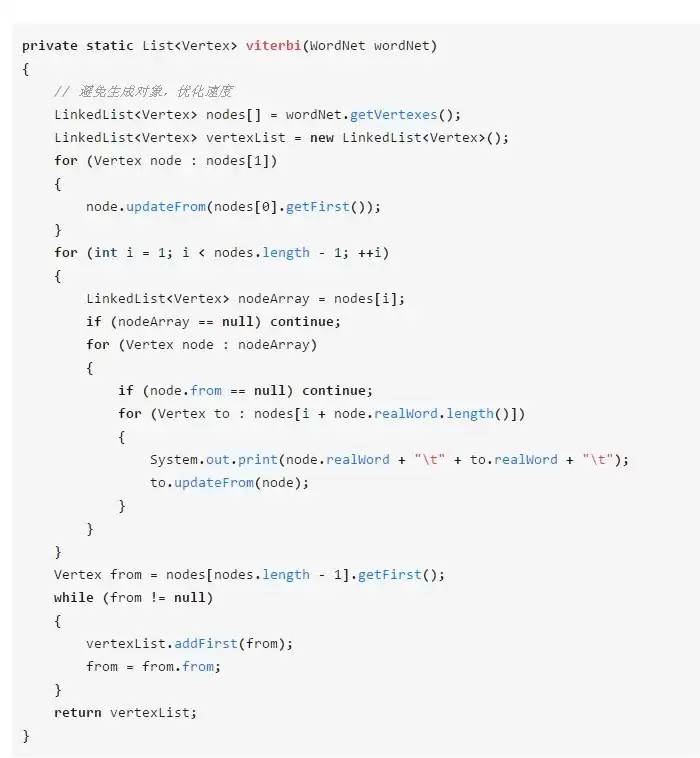
经过第(6)和第(7)步的处理,粗分词网中任意词的前驱词,都可以确保是最短路径上的。整个遍历和回溯过程的HanLP实现,在 ViterbiSegment.ja va 的 viterbi(WordNet wordNet) 方法里。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
相关文章