

RAG通过检索私有文档辅助大模型回答,解决知识截止与幻觉问题。关键踩坑包括:机械按字数切分打断语义完整性,需基于标题层级保留上下文;向量检索存在语义鸿沟,需优化嵌入与检索策略以确保准确性。
大模型RAG实战:从被骂不靠谱到部门MVP的踩坑记录
作者:技术拾光
时间:2026-06-07
浏览:209
文章目录
一、RAG 到底在解决什么问题
在动手之前,先聊聊 RAG 这个概念。很多刚接触的朋友容易搞混,咱们把底层的逻辑理清楚。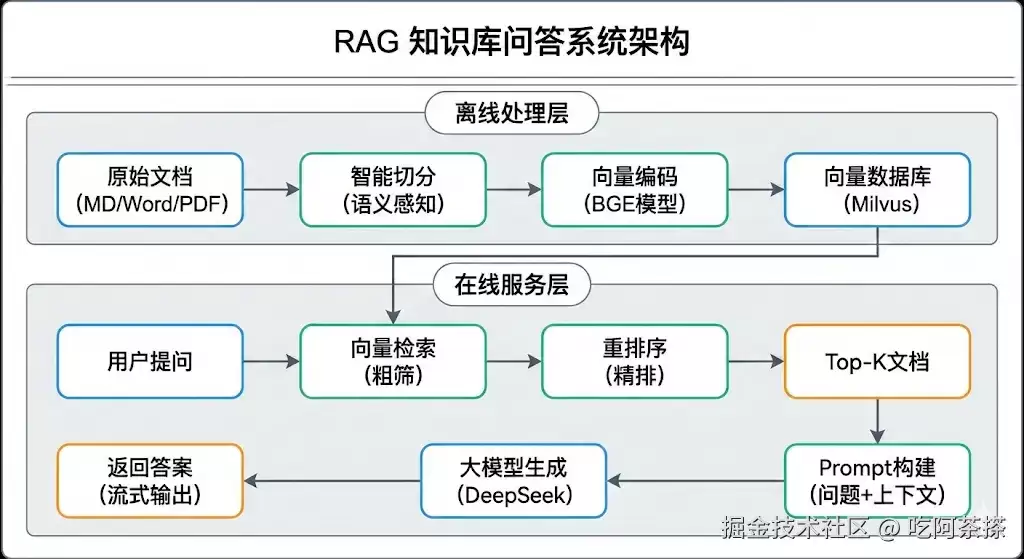 大模型很强,但有两个致命弱点:
第一,知识有截止日期。
GPT-4 的训练数据截止到某个时间点,它不知道你们公司上周发布的新规范,也不知道你们昨天刚修复的那个 bug 是怎么解决的。第二,会一本正经地胡说八道。
当大模型遇到不知道的问题时,它不会老老实实说“我不知道”,而是会基于它学过的通用知识,给你编一个看起来很合理但其实是错的答案。这就是所谓的幻觉(Hallucination)。 RAG(Retrieval-Augmented Generation,检索增强生成)的核心思路其实很简单:**别让大模型靠想象力答题,先帮它把参考资料找出来,让它照着资料回答。**
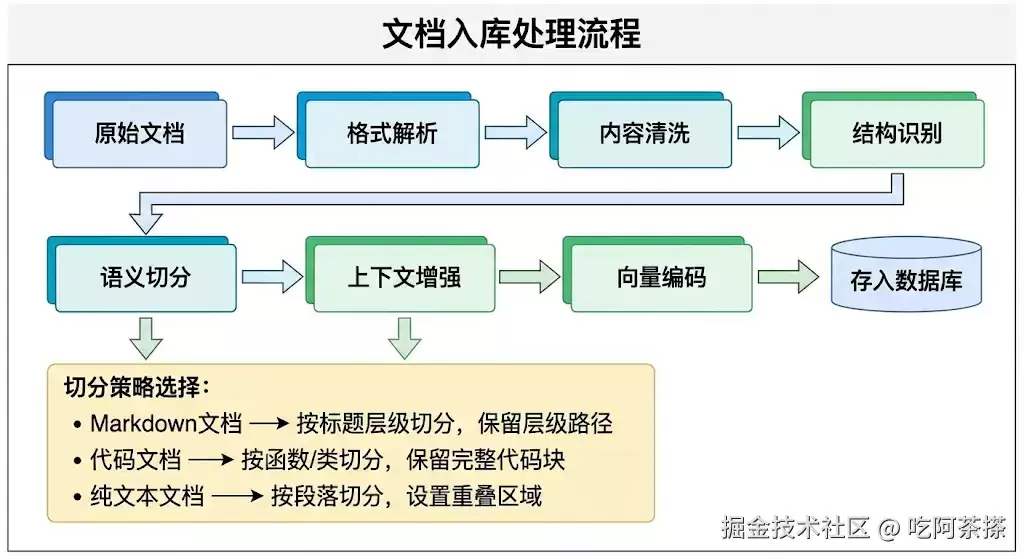 具体来说分三步:
1. 把你的私有文档切成小块,转成向量存起来
2. 用户提问时,先根据问题检索出最相关的文档片段
3. 把问题和检索到的内容一起喂给大模型,让它基于这些材料生成答案
听起来不复杂,对吧?当时也是这么想的,然后踩了一堆坑。
二、第一个大坑:文档切分没那么简单
最初的方案特别粗暴——用 LangChain 的 RecursiveCharacterTextSplitter,设置 chunk_size=500,overlap=50,直接把所有文档切成小块。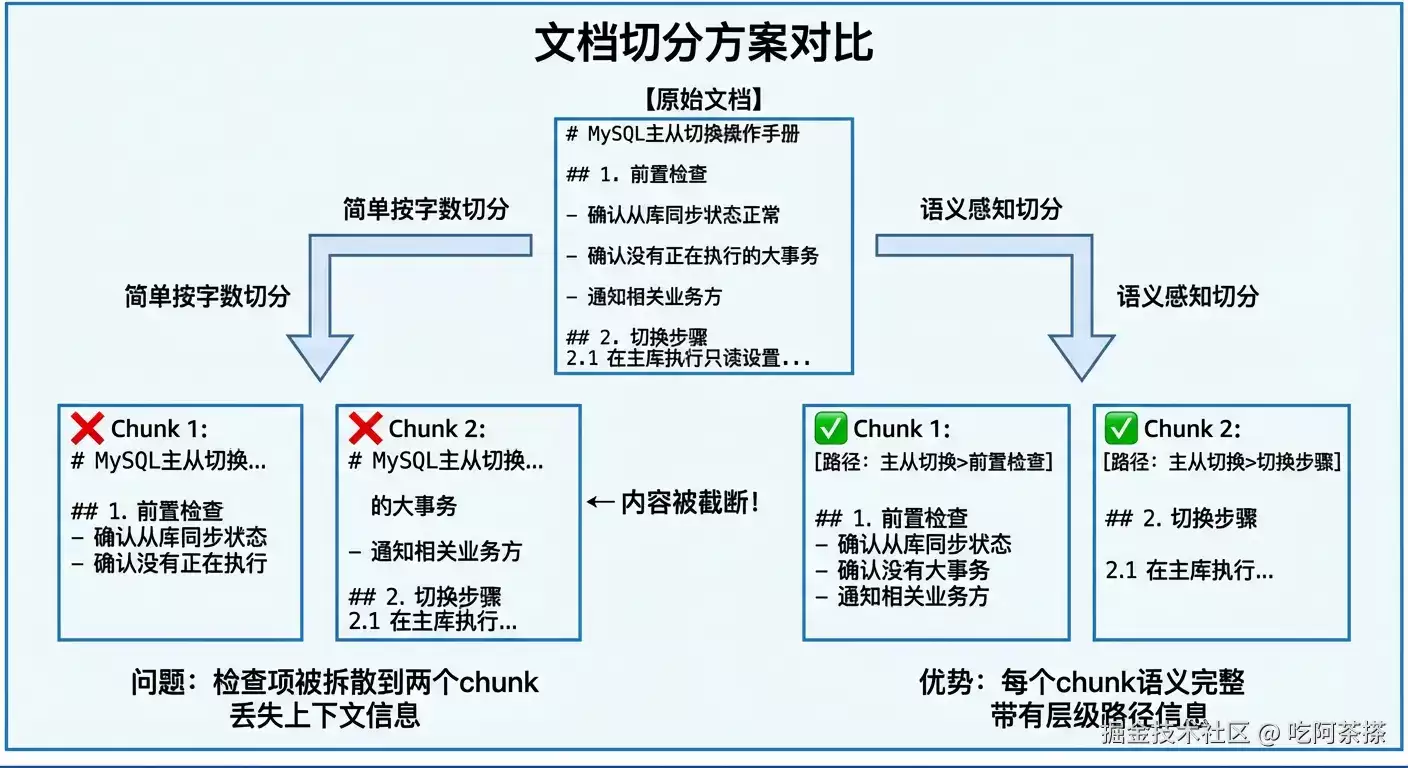 代码写起来确实很简单:
from langchain.text_splitter import RecursiveCharacterTextSplitter

def naive_split(text):
    # 最初的简单切分方案——后来证明这是个坑
    splitter = RecursiveCharacterTextSplitter(
        chunk_size=500,
        chunk_overlap=50,
        separators=["\n\n", "\n", "。", "!", "?", ",", " "]
    )
    chunks = splitter.split_text(text)
    return chunks

# 测试一下
sample_text = """
# MySQL主从切换操作手册
## 1. 前置检查
在执行主从切换之前,必须完成以下检查:
- 确认从库同步状态正常(Seconds_Behind_Master = 0)
- 确认没有正在执行的大事务
- 通知相关业务方,确认切换时间窗口
## 2. 切换步骤
2.1 在主库执行只读设置
SET GLOBAL read_only = 1;
2.2 等待从库完全同步
在从库执行 SHOW SLA VE STATUS,确认 Seconds_Behind_Master = 0
2.3 停止从库复制
STOP SLA VE;
RESET SLA VE ALL;
## 3. 回滚方案
如果切换失败,按以下步骤回滚...
"""
chunks = naive_split(sample_text)
for i, chunk in enumerate(chunks):
    print(f"Chunk {i+1}:")
    print(chunk[:100] + "..." if len(chunk) > 100 else chunk)
确认没有正在执行的大事务
- 通知相关业务方,确认切换时间窗口
## 2. 切换步骤
2.1 在主库执行只读设置
SET GLOBAL read_only = 1;
import re
from typing import List, Dict

class SmartDocumentSplitter:
    """
    语义感知的文档切分器
    核心思路:尊重文档的原有结构,按标题、段落等语义边界切分
    """

    def __init__(self, max_chunk_size=800, min_chunk_size=100):
        self.max_chunk_size = max_chunk_size
        self.min_chunk_size = min_chunk_size

    def split_markdown(self, text: str) -> List[Dict]:
        """
        针对 Markdown 文档的切分
        保持标题层级结构,每个 chunk 都带上完整的上下文路径
        """
        chunks = []
        current_headers = {1: "", 2: "", 3: ""}  # 记录当前的标题层级

        # 按行处理,识别标题和内容
        lines = text.split('\n')
        current_content = []

        for line in lines:
            # 检测 Markdown 标题
            header_match = re.match(r'^(#{1,3})\s+(.+)$', line)

            if header_match:
                # 遇到新标题,先保存之前的内容
                if current_content:
                    chunk_text = '\n'.join(current_content).strip()
                    if len(chunk_text) >= self.min_chunk_size:
                        chunks.append({
                            'content': chunk_text,
                            'headers': dict(current_headers),
                            'context_path': self._build_context_path(current_headers)
                        })
                    current_content = []

                # 更新标题层级
                level = len(header_match.group(1))
                title = header_match.group(2)
                current_headers[level] = title

                # 清除下级标题
                for l in range(level + 1, 4):
                    current_headers[l] = ""

                current_content.append(line)
            else:
                current_content.append(line)

                # 如果当前内容超过最大长度,强制切分(但尽量在段落边界)
                content_so_far = '\n'.join(current_content)
                if len(content_so_far) > self.max_chunk_size:
                    chunk_text = content_so_far.strip()
                    chunks.append({
                        'content': chunk_text,
                        'headers': dict(current_headers),
                        'context_path': self._build_context_path(current_headers)
                    })
                    current_content = []

        # 别忘了最后一段
        if current_content:
            chunk_text = '\n'.join(current_content).strip()
            if len(chunk_text) >= self.min_chunk_size:
                chunks.append({
                    'content': chunk_text,
                    'headers': dict(current_headers),
                    'context_path': self._build_context_path(current_headers)
                })

        return chunks

    def _build_context_path(self, headers: Dict) -> str:
        """构建层级路径,比如:MySQL主从切换 > 前置检查"""
        path_parts = [h for h in [headers[1], headers[2], headers[3]] if h]
        return ' > '.join(path_parts) if path_parts else '未分类'

    def enrich_chunk_with_context(self, chunk: Dict) -> str:
        """
        关键技巧:给每个 chunk 加上上下文前缀
        这样即使单独看这个片段,也能知道它属于哪个章节
        """
        context = f"[文档路径:{chunk['context_path']}]\n\n"
        return context + chunk['content']

# 实际使用示例
splitter = SmartDocumentSplitter(max_chunk_size=800)
chunks = splitter.split_markdown(sample_text)
print(f"切分后共 {len(chunks)} 个片段\n")
for i, chunk in enumerate(chunks):
    print(f"=== Chunk {i+1} ===")
    print(f"路径:{chunk['context_path']}")
    print(f"内容预览:{chunk['content'][:150]}...")
    print()
三、第二个大坑:向量检索的语义鸿沟
解决了切分问题,下一步就是向量化和检索了。这里用的是开源的 BGE 模型做 Embedding,用 Milvus 做向量数据库。 第一版的检索代码很直白:from sentence_transformers import SentenceTransformer
from pymilvus import connections, Collection, FieldSchema, CollectionSchema, DataType, utility
import numpy as np
class VectorStore:
"""向量存储和检索"""
def __init__(self, model_name='BAAI/bge-base-zh-v1.5'):
# 加载 Embedding 模型
self.model = SentenceTransformer(model_name)
self.dim = 768 # BGE base 模型的向量维度
# 连接 Milvus
connections.connect("default", host="localhost", port=19530)
def create_collection(self, collection_name: str):
"""创建集合"""
if utility.has_collection(collection_name):
utility.drop_collection(collection_name)
fields = [
FieldSchema(name="id", dtype=DataType.INT64, is_primary=True, auto_id=True),
FieldSchema(name="content", dtype=DataType.VARCHAR, max_length=4096),
FieldSchema(name="context_path", dtype=DataType.VARCHAR, max_length=512),
FieldSchema(name="embedding", dtype=DataType.FLOAT_VECTOR, dim=self.dim)
]
schema = CollectionSchema(fields, description="知识库文档")
collection = Collection(collection_name, schema)
# 创建索引
index_params = {
"metric_type": "COSINE",
"index_type": "IVF_FLAT",
"params": {"nlist": 128}
}
collection.create_index("embedding", index_params)
return collection
def insert_documents(self, collection_name: str, chunks: list):
"""插入文档"""
collection = Collection(collection_name)
contents = [chunk['content'] for chunk in chunks]
context_paths = [chunk['context_path'] for chunk in chunks]
# 批量生成 Embedding
embeddings = self.model.encode(contents, normalize_embeddings=True)
collection.insert([contents, context_paths, embeddings.tolist()])
collection.flush()
print(f"成功插入 {len(chunks)} 条文档")
def search(self, collection_name: str, query: str, top_k: int = 5):
"""基础检索"""
collection = Collection(collection_name)
collection.load()
# 生成查询向量
query_embedding = self.model.encode([query], normalize_embeddings=True)
results = collection.search(
data=query_embedding.tolist(),
anns_field="embedding",
param={"metric_type": "COSINE", "params": {"nprobe": 16}},
limit=top_k,
output_fields=["content", "context_path"]
)
return results[0]
from transformers import AutoModelForSequenceClassification, AutoTokenizer
import torch

class EnhancedRetriever:
    """增强版检索器:向量检索 + 重排序"""

    def __init__(self, vector_store: VectorStore):
        self.vector_store = vector_store

        # 加载重排序模型(BGE Reranker 效果不错)
        self.reranker_tokenizer = AutoTokenizer.from_pretrained('BAAI/bge-reranker-base')
        self.reranker_model = AutoModelForSequenceClassification.from_pretrained('BAAI/bge-reranker-base')
        self.reranker_model.eval()

    def retrieve_with_rerank(self, collection_name: str, query: str,
                             initial_top_k: int = 20, final_top_k: int = 5):
        """
        两阶段检索:
        1. 向量检索召回 initial_top_k 个候选
        2. 用重排序模型精排,返回 final_top_k 个结果
        """
        # 第一阶段:向量检索(召回更多候选)
        initial_results = self.vector_store.search(collection_name, query, top_k=initial_top_k)

        if not initial_results:
            return []

        # 准备重排序
        candidates = []
        for hit in initial_results:
            candidates.append({
                'content': hit.entity.get('content'),
                'context_path': hit.entity.get('context_path'),
                'vector_score': hit.score  # 保留向量检索得分,用于调试
            })

        # 第二阶段:重排序
        rerank_scores = self._compute_rerank_scores(query, [c['content'] for c in candidates])

        for i, score in enumerate(rerank_scores):
            candidates[i]['rerank_score'] = score

        # 按重排序分数排序
        candidates.sort(key=lambda x: x['rerank_score'], reverse=True)

        return candidates[:final_top_k]

    def _compute_rerank_scores(self, query: str, documents: list) -> list:
        """计算 query 和每个文档的相关性分数"""
        scores = []

        with torch.no_grad():
            for doc in documents:
                # Reranker 的输入格式是 [query, document]
                inputs = self.reranker_tokenizer(
                    [[query, doc]],
                    padding=True,
                    truncation=True,
                    max_length=512,
                    return_tensors='pt'
                )
                outputs = self.reranker_model(**inputs)
                score = outputs.logits.squeeze().item()
                scores.append(score)

        return scores

    def retrieve_with_query_expansion(self, collection_name: str, query: str,
                                       llm_client, top_k: int = 5):
        """
        进阶技巧:查询扩展
        用大模型改写用户问题,生成多个变体,再合并检索结果
        """
        # 让大模型帮我们扩展查询
        expansion_prompt = f"""请将下面这个问题改写成3个不同的表达方式,保持意思相同但用词不同。
每行输出一个改写结果,不要序号,不要其他解释。
原问题:{query}"""

        expanded_queries = llm_client.generate(expansion_prompt).strip().split('\n')
        expanded_queries = [q.strip() for q in expanded_queries if q.strip()]

        # 加上原始查询
        all_queries = [query] + expanded_queries[:3]  # 最多取3个扩展查询

        print(f"扩展后的查询:{all_queries}")  # 调试用

        # 对每个查询分别检索
        all_candidates = {}
        for q in all_queries:
            results = self.vector_store.search(collection_name, q, top_k=10)
            for hit in results:
                content = hit.entity.get('content')
                if content not in all_candidates:
                    all_candidates[content] = {
                        'content': content,
                        'context_path': hit.entity.get('context_path'),
                        'best_score': hit.score,
                        'hit_count': 1
                    }
                else:
                    # 被多个查询命中的文档,增加权重
                    all_candidates[content]['hit_count'] += 1
                    all_candidates[content]['best_score'] = max(
                        all_candidates[content]['best_score'],
                        hit.score
                    )

        # 综合评分:命中次数 * 最高得分
        candidates = list(all_candidates.values())
        for c in candidates:
            c['combined_score'] = c['hit_count'] * c['best_score']

        candidates.sort(key=lambda x: x['combined_score'], reverse=True)
        return candidates[:top_k]
四、第三大坑:Prompt 工程的门道比想象中深
检索的问题解决了,接下来就是把检索到的内容和用户问题一起喂给大模型了。这一步本以为最简单,没想到也踩了不少坑。 最初的 Prompt 特别朴素:def build_naive_prompt(query: str, context_docs: list) -> str:
# 最初的简单 Prompt——后来证明太天真了
context = "\n\n".join([doc['content'] for doc in context_docs])
prompt = f"""根据以下参考资料回答用户问题。
参考资料:
{context}
用户问题:{query}
请回答:"""
return prompt
def build_rag_prompt(query: str, context_docs: list,
                     include_sources: bool = True) -> str:
    """
    生产环境使用的 Prompt 模板
    关键设计:明确角色定位、限制回答范围、要求标注来源
    """

    # 格式化上下文,每段都标注来源
    context_parts = []
    for i, doc in enumerate(context_docs, 1):
        source = doc.get('context_path', '未知来源')
        context_parts.append(f"【资料{i},来源:{source}】\n{doc['content']}")

    context = "\n\n\n".join(context_parts)

    prompt = f"""你是一个企业内部知识库助手,专门帮助员工查找和理解公司内部文档。
## 你的工作准则
1. **只根据提供的参考资料回答问题**,不要使用你自己的知识。
2. 如果参考资料中没有相关信息,请明确说"根据现有资料,我无法找到关于这个问题的信息",并建议用户联系相关部门或换个关键词搜索。
3. 回答时请标注信息来源,格式如【资料1】,方便用户追溯原文。
4. 对于操作类问题,请按步骤清晰地列出;对于概念类问题,先给出简明定义再展开解释。
5. 如果不同资料中的信息有冲突,请指出差异并说明各自的适用场景。
## 参考资料
{context}
## 用户问题
{query}
## 回答要求
请根据上述参考资料回答用户问题。记住:
- 只使用参考资料中的信息
- 标注信息来源
- 没有把握的内容不要编造
"""
    return prompt

def build_conversational_prompt(query: str, context_docs: list,
                                 chat_history: list = None) -> str:
    """
    支持多轮对话的 Prompt
    需要带上历史对话记录,让大模型理解上下文
    """

    context_parts = []
    for i, doc in enumerate(context_docs, 1):
        source = doc.get('context_path', '未知来源')
        context_parts.append(f"【资料{i},来源:{source}】\n{doc['content']}")
    context = "\n\n\n".join(context_parts)

    # 格式化历史对话
    history_text = ""
    if chat_history:
        history_parts = []
        for turn in chat_history[-5:]:  # 只保留最近5轮,避免太长
            history_parts.append(f"用户:{turn['user']}")
            history_parts.append(f"助手:{turn['assistant']}")
        history_text = "\n".join(history_parts)

    prompt = f"""你是一个企业内部知识库助手。
## 参考资料
{context}
## 对话历史
{history_text if history_text else "(这是对话的开始)"}
## 当前问题
用户:{query}
## 回答准则
1. 优先根据参考资料回答,如无相关信息请明确说明
2. 考虑对话历史的上下文(如用户说"它"可能指代之前提到的概念)
3. 标注信息来源
助手:
"""

    return prompt
class PromptBuilder:
    """Prompt 构建器:根据问题类型动态调整"""

    # 核心指令——任何情况都必须包含
    CORE_INSTRUCTIONS = """
1. 只使用参考资料中的信息回答,不要编造
2. 资料中没有的信息,明确说无法找到相关信息
3. 标注信息来源【资料X】
"""
    # 操作类问题的额外指令
    PROCEDURE_INSTRUCTIONS = """
回答格式要求:
- 按步骤编号列出(第一步、第二步...)
- 每个步骤要明确操作对象和操作动作
- 重要的警告或注意事项用标出
"""
    # 概念解释类问题的额外指令
    CONCEPT_INSTRUCTIONS = """
回答格式要求:
- 先用一句话给出核心定义
- 再详细解释关键点
- 如有必要,举例说明"""
    # 故障排查类问题的额外指令
    TROUBLESHOOT_INSTRUCTIONS = """
回答格式要求:
- 先列出可能的原因
- 针对每个原因给出排查方法
-给出解决方案或规避建议
"""

    @classmethod
    def build(cls, query: str, context_docs: list, question_type: str = "general") -> str:
        """根据问题类型构建 Prompt"""

        # 简单的问题分类逻辑(实际项目中可以用分类模型)
        if question_type == "auto":
            question_type = cls._classify_question(query)

        extra_instructions = ""
        if question_type == "procedure":
            extra_instructions = cls.PROCEDURE_INSTRUCTIONS
        elif question_type == "concept":
            extra_instructions = cls.CONCEPT_INSTRUCTIONS
        elif question_type == "troubleshoot":
            extra_instructions = cls.TROUBLESHOOT_INSTRUCTIONS

        context = cls._format_context(context_docs)

        prompt = f"""你是企业内部知识库助手。
## 必须遵守的规则
{cls.CORE_INSTRUCTIONS}
{f"## 回答格式\n{extra_instructions}" if extra_instructions else ""}
## 参考资料
{context}
## 用户问题
{query}
请回答:"""

        return prompt

    @classmethod
    def _classify_question(cls, query: str) -> str:
        """简单的问题分类(基于关键词)"""
        procedure_keywords = ["怎么做", "如何操作", "步骤", "流程", "怎样"]
        concept_keywords = ["是什么", "什么是", "定义", "解释", "区别"]
        troubleshoot_keywords = ["为什么", "报错", "失败", "异常", "问题", "故障"]

        query_lower = query.lower()

        if any(kw in query_lower for kw in procedure_keywords):
            return "procedure"
        elif any(kw in query_lower for kw in concept_keywords):
            return "concept"
        elif any(kw in query_lower for kw in troubleshoot_keywords):
            return "troubleshoot"
        else:
            return "general"

    @classmethod
    def _format_context(cls, context_docs: list) -> str:
        parts = []
        for i, doc in enumerate(context_docs, 1):
            source = doc.get('context_path', '未知来源')
            parts.append(f"【资料{i},来源:{source}】\n{doc['content']}")
        return "\n\n\n".join(parts)
五、串起来:完整的 RAG Pipeline
前面说了一堆细节,现在把它们串成一个完整的 Pipeline: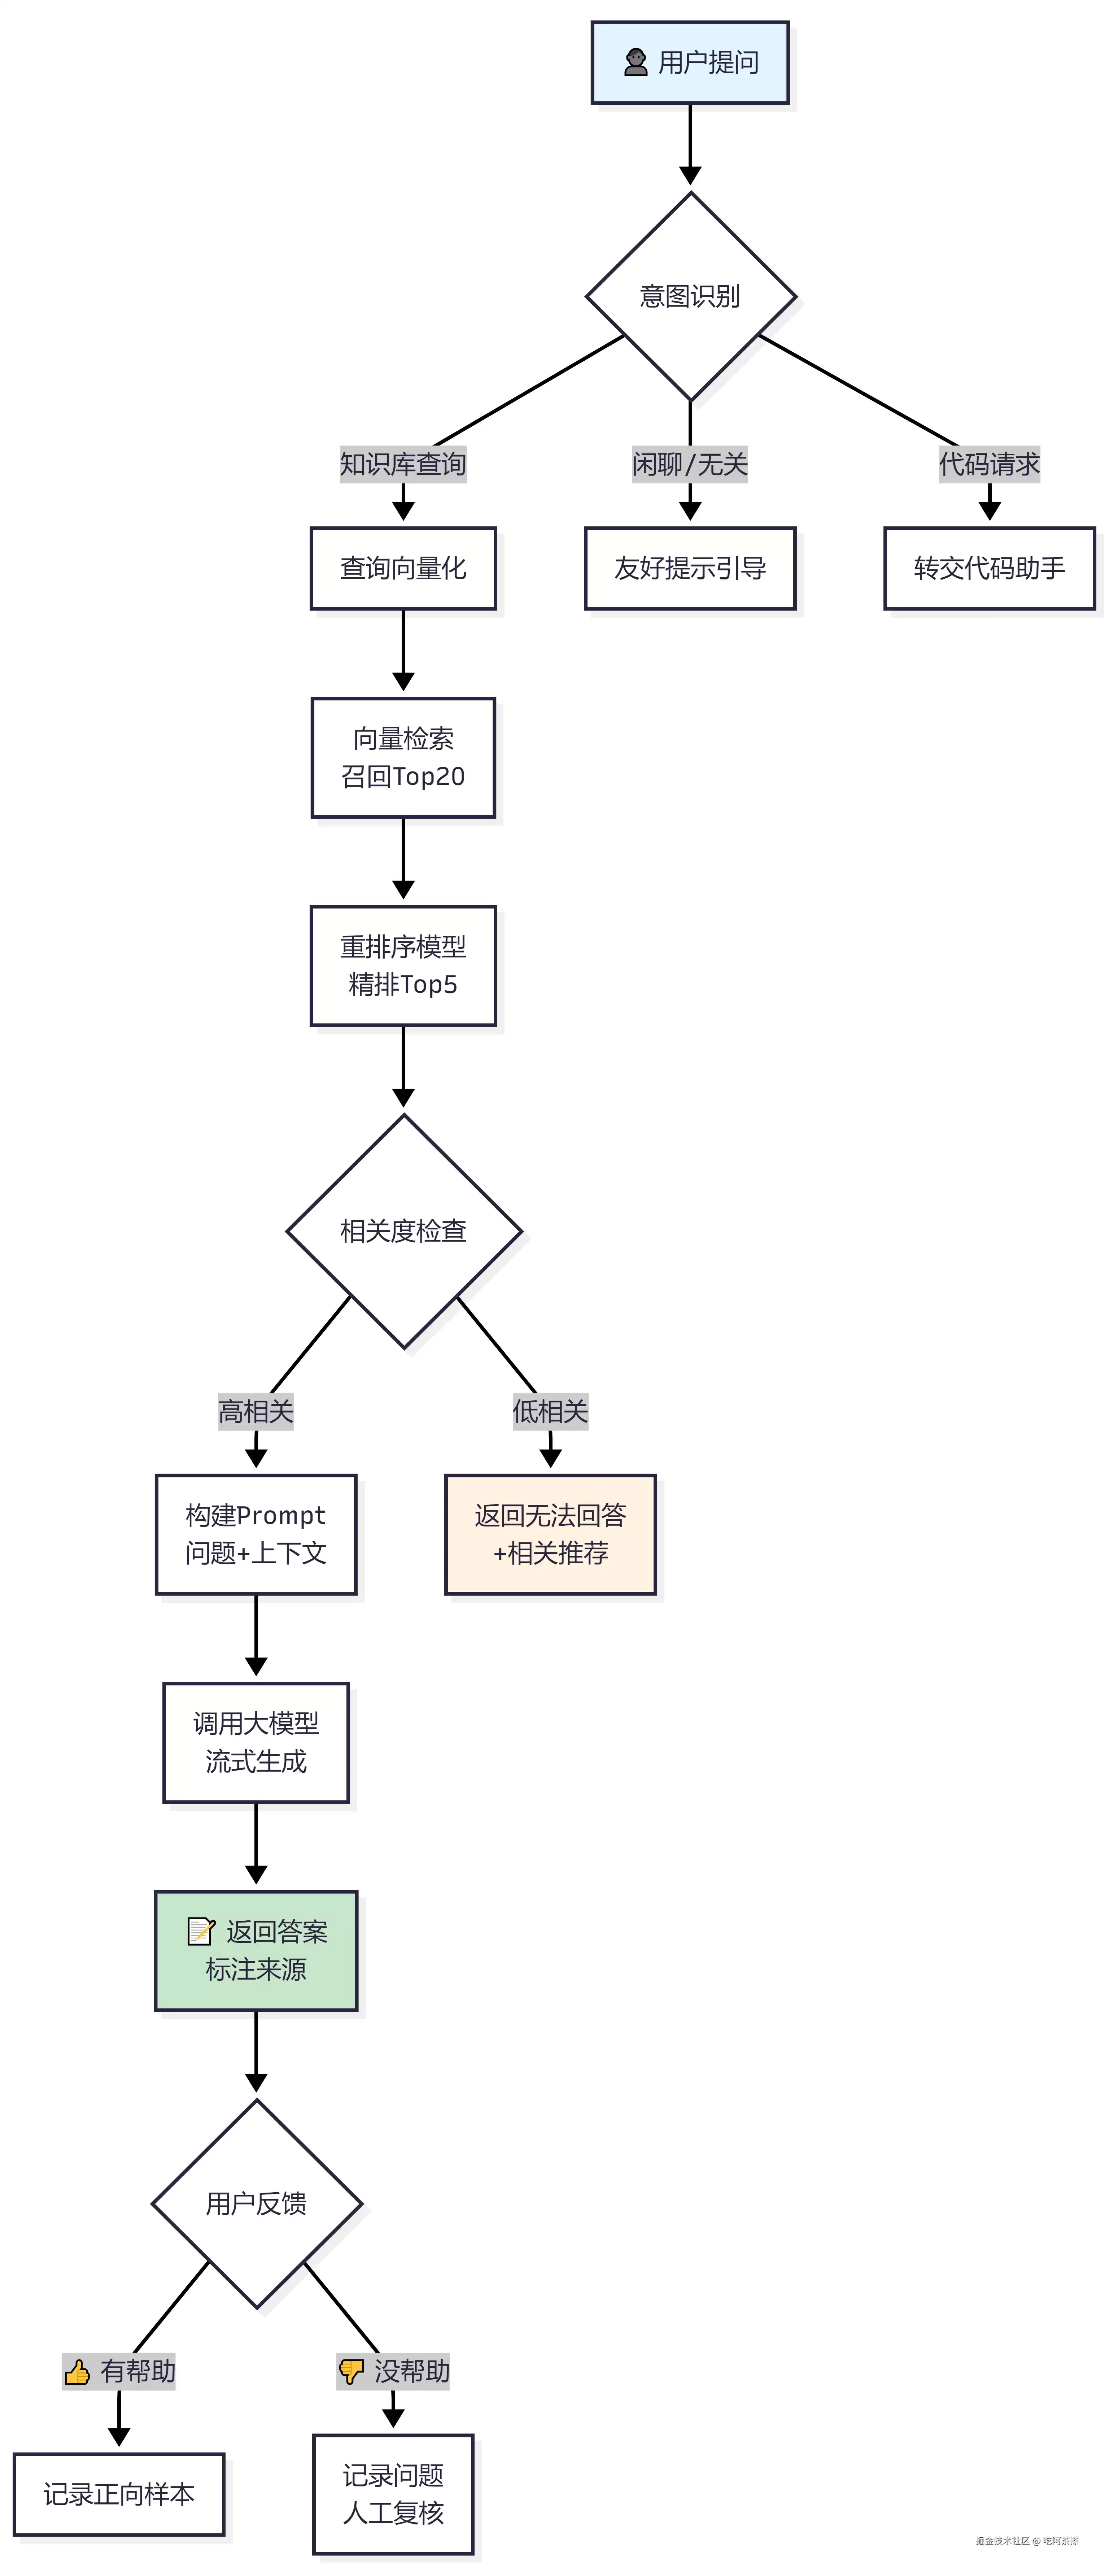
from openai import OpenAI
from typing import List, Dict, Optional
import json

class RAGPipeline:
    """
    完整的 RAG 处理流程
    文档切分 -> 向量化存储 -> 检索 -> 重排序 -> 生成回答
    """

    def __init__(self,
                 llm_base_url: str = "",
                 llm_api_key: str = "your-api-key",
                 llm_model: str = "deepseek-chat"):

        # 初始化各个组件
        self.splitter = SmartDocumentSplitter(max_chunk_size=800)
        self.vector_store = VectorStore()
        self.retriever = EnhancedRetriever(self.vector_store)

        # 初始化 LLM 客户端(这里用 DeepSeek,也可以换成其他的)
        self.llm_client = OpenAI(base_url=llm_base_url, api_key=llm_api_key)
        self.llm_model = llm_model

        self.collection_name = "knowledge_base"

    def ingest_documents(self, documents: List[Dict]):
        """
        文档入库
        documents 格式:[{title: 文档标题, content: 文档内容, source: 来源}]
        """
        print(f"开始处理 {len(documents)} 篇文档...")

        all_chunks = []
        for doc in documents:
            # 在内容前加上标题,帮助切分器识别结构
            full_content = f"# {doc['title']}\n\n{doc['content']}"

            chunks = self.splitter.split_markdown(full_content)

            # 给每个 chunk 加上文档来源信息
            for chunk in chunks:
                chunk['source_doc'] = doc.get('source', doc['title'])

            all_chunks.extend(chunks)

        print(f"切分后共 {len(all_chunks)} 个片段")

        # 创建集合并插入
        self.vector_store.create_collection(self.collection_name)
        self.vector_store.insert_documents(self.collection_name, all_chunks)

        print("文档入库完成!")

    def query(self,
              question: str,
              chat_history: Optional[List[Dict]] = None,
              top_k: int = 5,
              use_rerank: bool = True) -> Dict:
        """
        处理用户查询
        返回:{answer: 回答内容, sources: [引用的来源], retrieved_docs: [检索到的文档]}
        """

        # 1. 检索相关文档
        if use_rerank:
            retrieved_docs = self.retriever.retrieve_with_rerank(
                self.collection_name, question,
                initial_top_k=20, final_top_k=top_k
            )
        else:
            results = self.vector_store.search(self.collection_name, question, top_k=top_k)
            retrieved_docs = [{
                'content': hit.entity.get('content'),
                'context_path': hit.entity.get('context_path'),
                'score': hit.score
            } for hit in results]

        if not retrieved_docs:
            return {
                "answer": "抱歉,我没有找到与您问题相关的资料。您可以尝试换个关键词,或联系相关部门获取帮助。",
                "sources": [],
                "retrieved_docs": []
            }

        # 2. 构建 Prompt
        if chat_history:
            prompt = build_conversational_prompt(question, retrieved_docs, chat_history)
        else:
            prompt = PromptBuilder.build(question, retrieved_docs, question_type="auto")

        # 3. 调用 LLM 生成回答
        response = self.llm_client.chat.completions.create(
            model=self.llm_model,
            messages=[{"role": "user", "content": prompt}],
            temperature=0.3,  # 知识库问答用较低的 temperature
            max_tokens=2000
        )

        answer = response.choices[0].message.content

        # 4. 提取引用的来源
        sources = list(set([doc.get('context_path', '未知来源') for doc in retrieved_docs]))

        return {
            "answer": answer,
            "sources": sources,
            "retrieved_docs": retrieved_docs
        }

    def evaluate_response(self, question: str, answer: str,
                          ground_truth: str = None) -> Dict:
        """
        回答质量评估(可选)
        用 LLM 评估回答的质量,方便持续优化
        """
        eval_prompt = f"""请评估以下问答的质量。
问题:{question}
回答:{answer}
{f"参考答案:{ground_truth}" if ground_truth else ""}
请从以下维度评分(1-5分)并说明理由:
1. 相关性:回答是否切题
2. 准确性:信息是否正确
3. 完整性:是否完整解答了问题
4. 可读性:表述是否清晰易懂
请用 JSON 格式输出:{{"relevance": 分数, "accuracy": 分数, "completeness": 分数, "readability": 分数, "comments": "评价说明"}}"""

        response = self.llm_client.chat.completions.create(
            model=self.llm_model,
            messages=[{"role": "user", "content": eval_prompt}],
            temperature=0
        )

        try:
            eval_result = json.loads(response.choices[0].message.content)
            return eval_result
        except:
            return {"error": "评估结果解析失败"}

# 使用示例
if __name__ == "__main__":
    # 初始化 Pipeline
    rag = RAGPipeline(
        llm_base_url="",
        llm_api_key="your-api-key",
        llm_model="deepseek-chat"
    )

    # 准备测试文档
    test_documents = [
        {
            "title": "MySQL 主从切换操作手册",
            "content": """
## 1. 前置检查
在执行主从切换之前,必须完成以下检查:
- 确认从库同步状态正常(Seconds_Behind_Master = 0)
- 确认没有正在执行的大事务
- 通知相关业务方,确认切换时间窗口
## 2. 切换步骤
### 2.1 在主库执行只读设置
SET GLOBAL read_only = 1;
### 2.2 等待从库完全同步
在从库执行 SHOW SLA VE STATUS,确认 Seconds_Behind_Master = 0
### 2.3 停止从库复制并提升为主库
STOP SLA VE;
RESET SLA VE ALL;
SET GLOBAL read_only = 0;
## 3. 切换后验证
- 确认新主库可以正常写入
- 确认应用连接已切换到新主库
- 监控新主库的性能指标
""",
            "source": "DBA团队文档"
        }
    ]

    # 入库
    rag.ingest_documents(test_documents)

    # 测试查询
    result = rag.query("MySQL 切换前需要做哪些检查?")

    print("=" * 50)
    print("问题:MySQL 切换前需要做哪些检查?")
    print("=" * 50)
    print(f"\n回答:\n{result['answer']}")
    print(f"\n参考来源:{result['sources']}")
六、上线后的一些经验教训
系统上线到现在差不多两个月了,期间又踩了不少坑,这里挑几个印象最深的说说。教训一:用户的问题千奇百怪
在设计时假设用户会问“MySQL 怎么做主从切换”这种正常问题。但实际上呢? 有人问:“上次那个事故怎么处理的来着?”——没有任何上下文,系统根本不知道“那个事故”是哪个。 有人问:“帮我写个 SQL。”——这根本不是知识库问答,这是让大模型帮写代码。 还有人问:“在吗?”——也不知道他想干啥。 后来加了一个意图识别层,先判断用户的问题是否属于知识库问答的范畴:def classify_intent(self, query: str) -> str:
"""识别用户意图"""
intent_prompt = f"""判断用户输入的意图类别,只输出类别名称:
- knowledge_query:查询知识库信息(如询问流程、规范、操作方法)
- code_request:请求生成代码
- chitchat:闲聊或无明确意图
- other:其他
用户输入:{query}
意图类别:"""
response = self.llm_client.chat.completions.create(
model=self.llm_model,
messages=[{"role": "user", "content": intent_prompt}],
temperature=0,
max_tokens=20
)
return response.choices[0].message.content.strip()
教训二:冷启动时的尴尬
系统刚上线时,知识库里的文档不多,覆盖的场景有限。用户问了几个问题都答不上来,体验特别差,于是就不来用了。 后来的解决办法: 1. 上线前先梳理高频问题,确保至少这些问题能回答好 2. 搞了一个“问题收集”功能,对于答不上来的问题,记录下来反馈给内容团队,让他们补充相关文档 3. 做了一个兜底策略——如果检索不到高相关度的内容,就展示“相关推荐”,把一些相似度尚可的文档标题列出来,引导用户自己去看教训三:文档更新的同步问题
知识库的文档是会更新的。老版本的操作手册废弃了,新版本发布了。但如果向量数据库里还存着老版本的内容,用户检索到的可能是过时信息。 这个问题说起来简单,做起来挺麻烦的。最后的方案是: 1. 每个文档入库时记录版本号和更新时间 2. 定期全量重新入库(每周一次) 3. 对于紧急更新的重要文档,支持手动触发单篇重入库七、性能优化:让系统不那么慢
RAG 系统有个让人头疼的问题——慢。 整个流程跑一遍:Embedding 编码、向量检索、重排序、LLM 生成,全部加起来可能要好几秒。用户体验就很差,问一个问题要等半天。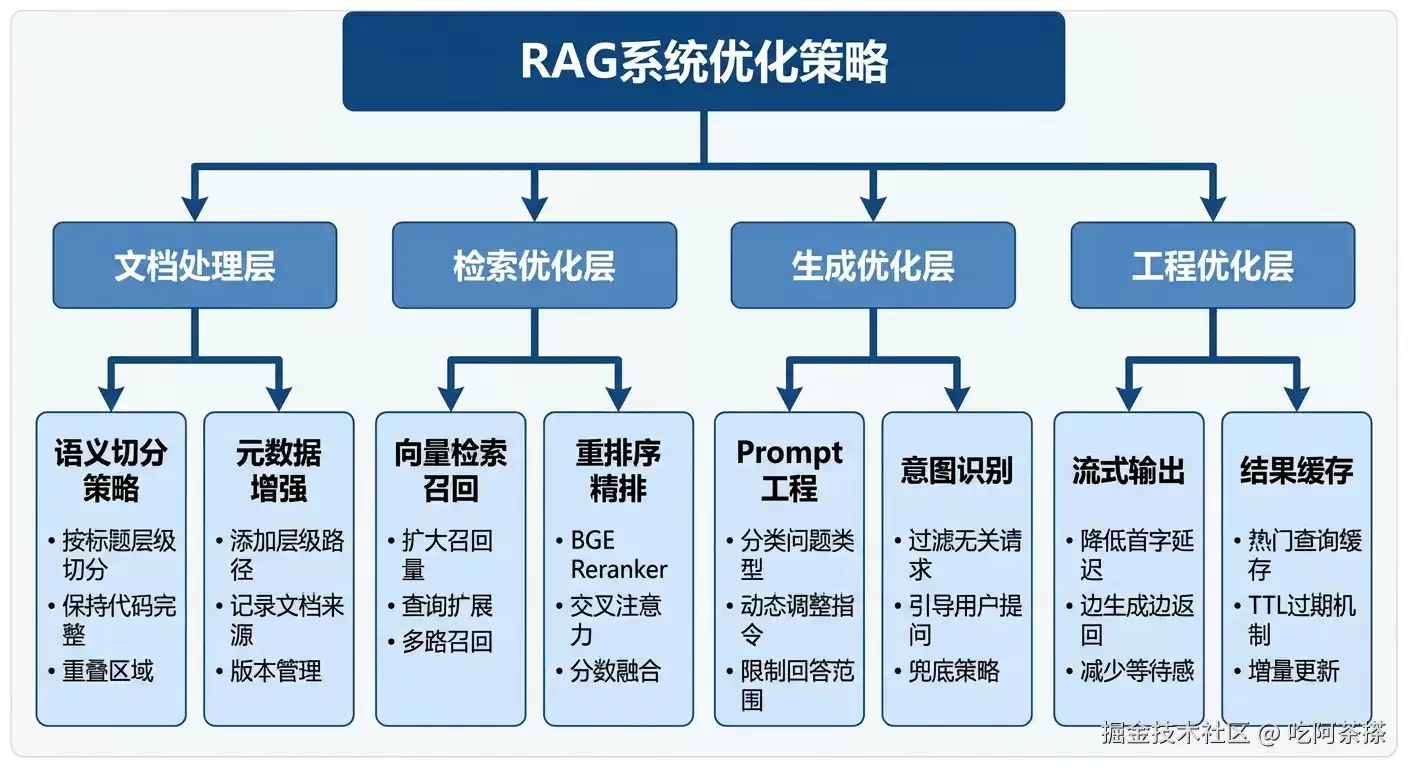 几个优化措施:
import asyncio
from functools import lru_cache
import hashlib

class OptimizedRAG:
    """性能优化版 RAG"""

    def __init__(self):
        # 缓存热门查询的结果
        self.query_cache = {}
        self.cache_ttl = 3600  # 1小时过期

    @lru_cache(maxsize=1000)
    def _compute_query_embedding(self, query: str):
        """
        Embedding 结果缓存
        同样的问题不用重复计算向量
        """
        return self.model.encode([query], normalize_embeddings=True)[0]

    def _get_cache_key(self, query: str) -> str:
        """生成缓存 key"""
        return hashlib.md5(query.lower().strip().encode()).hexdigest()

    async def stream_query(self, question: str):
        """
        流式输出
        不用等整个回答生成完,边生成边输出
        """
        retrieved_docs = await asyncio.to_thread(
            self.retriever.retrieve_with_rerank,
            self.collection_name, question, 20, 5
        )

        prompt = PromptBuilder.build(question, retrieved_docs, question_type="auto")

        # 使用流式 API
        stream = self.llm_client.chat.completions.create(
            model=self.llm_model,
            messages=[{"role": "user", "content": prompt}],
            temperature=0.3,
            stream=True  # 开启流式
        )

        for chunk in stream:
            if chunk.choices[0].delta.content:
                yield chunk.choices[0].delta.content
八、回顾与思考
把这套系统从“被骂下线”到“成为部门标配”,前后折腾了将近一个月。趟过的坑挺多,但收获也很大。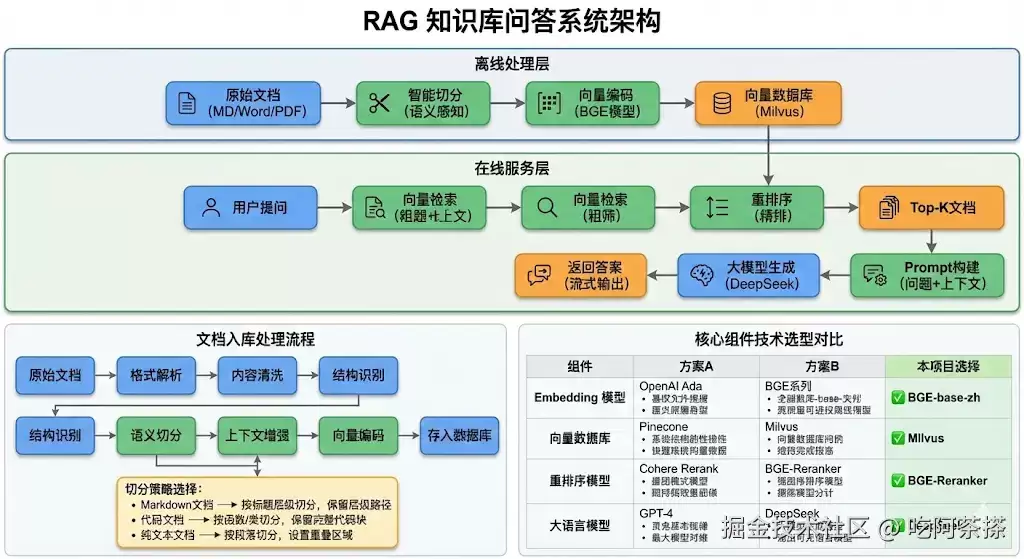
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
相关文章