

火山引擎近日宣布,其豆包大模型家族中的全模态理解模型——Doubao-Seed-2.0-lite,已完成重要升级。 此次发布的新版本,核心在于实现了“原生统一”的多模态理解框架。这意味着视频、图像、音频、文本等不同形态的信息,现可被置于同一框架内进行综合理解与分析。与此同时,模型的智能体(Agent
豆包Seed 2.0 Lite升级:全模态理解模型上线
作者:技术拾光
时间:2026-06-04
浏览:474
文章目录
火山引擎近日宣布,其豆包大模型家族中的全模态理解模型——Doubao-Seed-2.0-lite,已完成重要升级。
此次发布的新版本,核心在于实现了“原生统一”的多模态理解框架。这意味着视频、图像、音频、文本等不同形态的信息,现可被置于同一框架内进行综合理解与分析。与此同时,模型的智能体(Agent)、代码(Coding)及图形界面(GUI)能力也同步获得提升。其目标明确,旨在更好地应对日益复杂、对综合推理能力要求更高的实际业务场景。
视觉理解能力:从识别到深度认知
视觉理解能力始终是多模态模型的关键竞争领域。Doubao-Seed-2.0-lite在此方面持续增强,在物理学科推理(HiPhO)、医疗问答(MedXpertQA)等高阶学科任务上,其表现已超越今年2月发布的、定位更高的Doubao-Seed-2.0-pro版本。
此外,在BabyVision(婴儿视觉)、WorldVQA(世界问答)以及需要结合物理世界理解的ERQA(具身问答)等考验细粒度视觉分析的任务上,新版本达到了业界领先的SOTA水平。这一提升,使其在工业质检、医疗影像分析、自动驾驶环境感知等高价值、高精度要求的应用场景中,具备更强的实用性与规模化部署潜力。
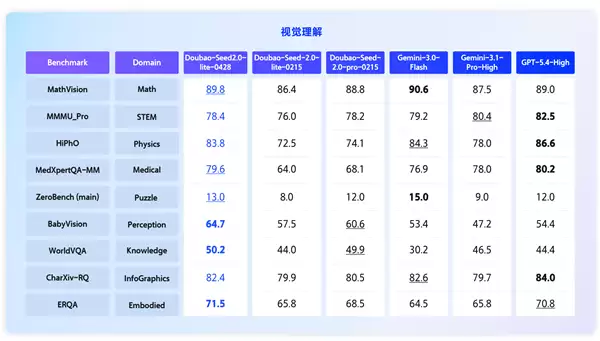
加粗表示最优结果,下划线表示次优结果
跨模态融合:音画协同与联合推理
本次升级的一大重点,是融入了深度语音理解能力。这并非简单的语音识别与图像识别功能叠加,而是实现了真正的多模态联合推理。在许多实际业务场景中,仅凭画面或声音难以做出准确判断,必须依赖“音画结合”的综合分析。
例如,在视频理解场景中,新版模型能够同步分析视觉内容与背景音频,精准判断视频内的“视听一致性”,即画面事件与声音信息是否匹配。这对于内容安全审核与深度视频内容理解至关重要。
模型还能根据自然语言指令(如“找出主角首次出现惊讶表情的时刻”),在长视频中进行精准时间点定位。更进一步,它能够跨越多个时间片段,提取关键线索,持续追踪人物或事件的发展脉络,并基于画面内容进行多步逻辑推理,还原事件之间的因果关系。
音频能力:从转译到语义与情感洞察
在独立的音频处理方面,新模型支持19种语言的精准语音转写,以及中英文与另外14种语言间的互译。
但其能力不止于此。模型还能捕捉语音中的细微情绪变化、分辨环境背景声、识别音乐细节。因此,其输出不再是干瘪的文字稿,而是更完整、更贴近人类真实认知的语义信息。这对于客服质检、情感分析、媒体内容生产等场景具有显著价值。
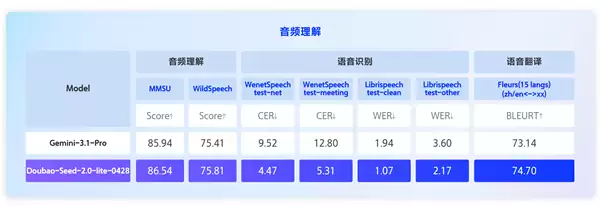
根据公开评测集数据,Doubao-Seed-2.0-lite在语音识别、翻译等多项音频理解基准测试中,表现优于谷歌的Gemini-3.1-Pro模型。
智能体适配与持续学习进化
另一值得关注的亮点是,Doubao-Seed-2.0-lite深度适配了OpenClaw、Hermes Agent等主流智能体框架。这强化了其深度搜索与动态技能调用能力。更重要的是,模型能在任务执行过程中持续沉淀经验,实现“越用越聪明”的进化效果,这对于需要长期、复杂交互的AI应用而言,显著增强了其实用性与生命周期。
总体来看,此次升级清晰地揭示了一个趋势:大模型正从处理单一模态信息的“专家”,加速进化为能同时处理、关联并深度推理多种信息的“通才”。这场“全模态”的竞赛,已深入渗透至具体业务场景的每一个环节。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。