

故事背景 先说一下背景。运维反馈,有台设备在后台始终查不到。第一时间怀疑是数据出了问题,服务报错后未入库。 拿到日志在本地调接口,发现程序并未报错。代码逻辑很直接:先把唯一ID存入Redis,Redis中不存在则执行insert,存在则执行update——相当于加了一层缓存,希望批量插入和更新时能快
MySQL自增ID超出int最大值解决方案
作者:技术拾光
时间:2026-06-04
浏览:458
文章目录
故事背景
先说一下背景。运维反馈,有台设备在后台始终查不到。第一时间怀疑是数据出了问题,服务报错后未入库。
拿到日志在本地调接口,发现程序并未报错。代码逻辑很直接:先把唯一ID存入Redis,Redis中不存在则执行insert,存在则执行update——相当于加了一层缓存,希望批量插入和更新时能快一些。
检查Redis,有值。起初以为是Redis与数据库数据不一致的老问题,删掉key后重新运行。结果打印了insert语句,但数据库里依然没有插入。看来问题并不简单。
问题分析
数据表数据量很大,约为5亿条。第一反应是MySQL表数据量可能达到上限,但查询后发现并无明显限制。
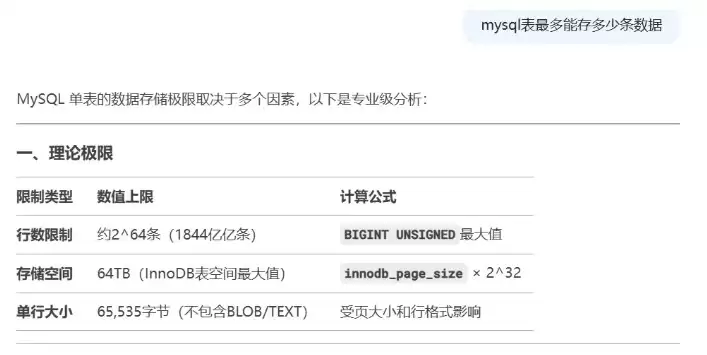
进一步查看表的自增ID,发现这个数字很眼熟:2147483647——正是int类型的最大值。这意味着自增ID已经超出int范围,插入自然失败。id字段类型设置为int,还有一个细节:表里设置的int长度为50,但实际上长度并不起作用。

问题找到了,但处理起来很棘手——数据量太大。先咨询一下deepseek如何解决。
方案处理
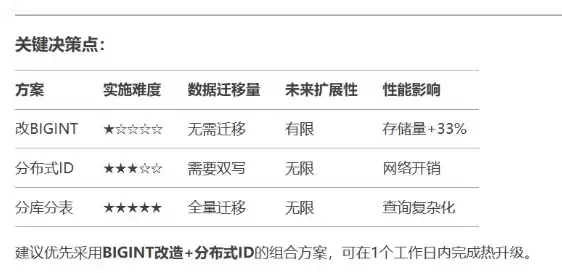
deepseek给出了三个方案:
第一个,最直接:改为BIGINT,无需迁移数据,但会全程锁表。第二个,分布式ID:需要重新设计表、迁移数据,还需要Redis支撑。第三个,分库分表:更加复杂,需要引入框架,不按分片查询时还需使用ES,引入ES后还要同步中间件logstash。
改为BIGINT锁表时间太长,先想办法紧急处理数据。不过按理说int最大值为21亿,数据表只有5亿,应该用不完。结果发现自增ID值并不连续。
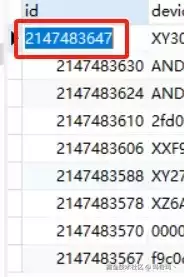
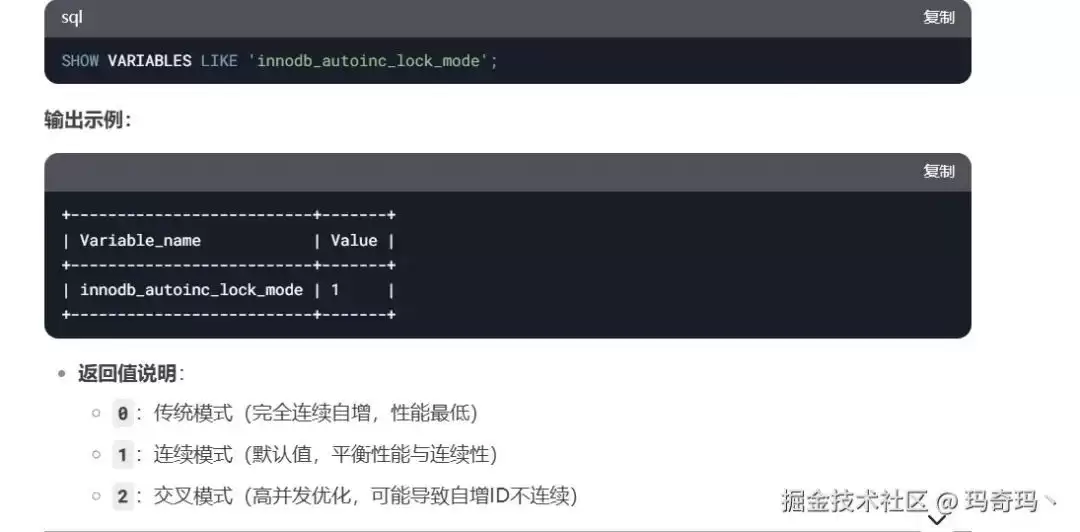
自增ID应该依次递增,不会留空隙。查询后得知,MySQL自增ID有一种高性能策略,设置了ID后不一定会连续。
又查找了是否有方法可以一键重排数据表ID,结果是没有。最后编写了一个存储过程,先清理出最后100万条ID段,能支撑几天再说。
BEGIN
  DECLARE start_id INT DEFAULT 1;
  DECLARE end_id INT DEFAULT 100000;
  DECLARE current_batch INT DEFAULT 0;

  WHILE start_id <= end_id DO
    -- 更新临时表中的ID
    UPDATE table
    SET id = start_id + 1
    WHERE id = (select original_id from (
      SELECT id AS original_id
      FROM table
      ORDER BY id DESC
      LIMIT 1) as test);

    SET start_id = start_id + 1;
  END WHILE;
END
然后重新设置自增值——如果该值已经存在,会自动跳到max(id)+1。
-- 重置自增值
ALTER TABLE your_table AUTO_INCREMENT = max(id) + 1;
清理出大约500万条ID段。怀疑ID间隔过大是因为并发太高。最初采用单线程消费,攒够500条后批量入库,但单线程慢导致数据堆积有延迟。后来改为Java批量消费,配置了30个消费者。接着尝试减少消费者数量到15个,ID的间隔确实变小了。
设置BIGINT
节后回来,ID还剩200万。讨论后决定将数据类型从int改为bigint。
ALTER TABLE xxx MODIFY id BIGINT UNSIGNED NOT NULL AUTO_INCREMENT
UNSIGNED无符号位,不计负数,数据容量翻倍;NOT NULL非空;AUTO_INCREMENT自增。
测试环境有一亿数据,修改id类型用了一个小时。预计现网用六七个小时就能完成。结果改了一整晚都没好。找到一条可以查询SQL进度的语句:
SELECT EVENT_NAME, WORK_COMPLETED, WORK_ESTIMATED, ROUND(WORK_COMPLETED/WORK_ESTIMATED*100, 2) AS "Progress (%)" FROM performance_schema.events_stages_current;
不查不知道,一查吓一跳:跑了十几个小时还不到50%,而且速度越来越慢。对比测试环境和现网的buffer_pool等参数,设置都正常。
估计是因为索引树变大,插入数据需要更多时间;另外现网还有其他线程抢占CPU,自然更慢。计算下来,后面大约每小时完成1.5%左右。
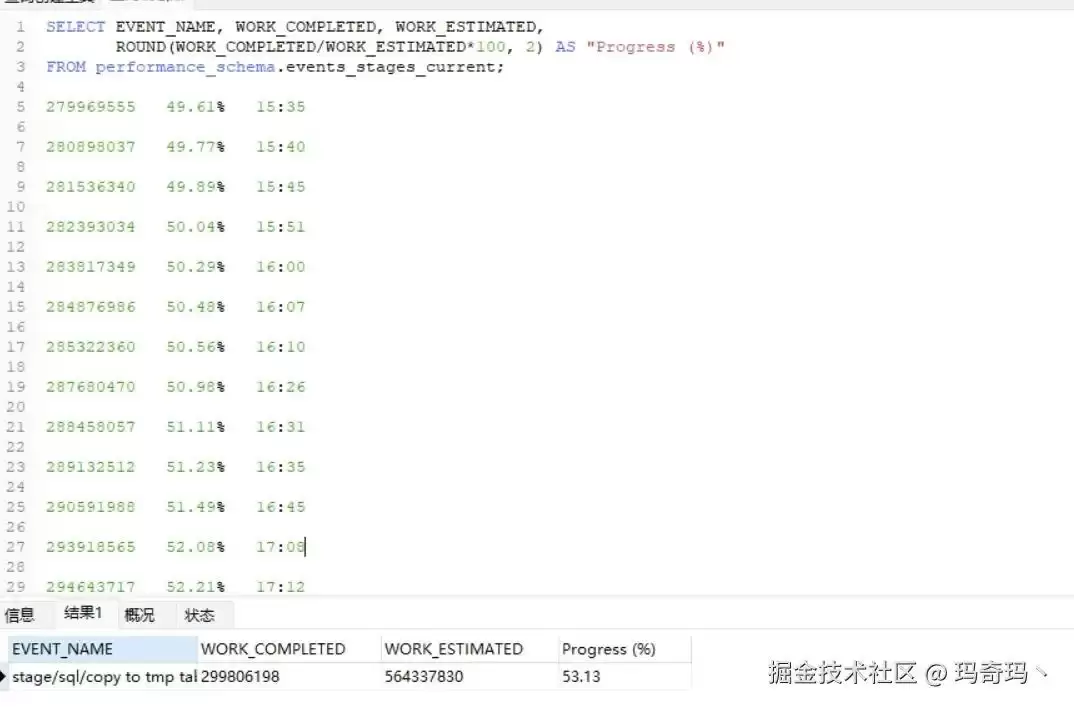
周一晚上执行,周四早上上班才跑完,用了两天多时间。
总结
看到一篇技术文章《字节面试:MySQL自增ID用完会怎样?》,评论区都说用不完——结果真用完了,感觉有些不可思议。总结几个原因:
1、数据量确实大,达到5亿多条,并发也高。当初设计时其实预料到这个问题,所以设置了int长度为50,但长度并未起作用。设计数据库时一定要考虑周全,否则几亿数据修改字段类型需要两天时间。
2、自增ID策略选择了高性能模式,导致并发高时ID间隔很大。30个消费者异步处理,10条数据大约消耗100个ID。多线程异步操作确实需要谨慎。这里存在时间和空间的取舍,使用多线程要当心。
还有一个小插曲:系统两天未消费,Kafka数据严重堆积。将消费者从30个增加到50个,跑了两天后Kafka仍然有一天的延迟。单纯增加线程数量已经无法提升效率。想起八股文中说的多线程太多会增加上下文切换的时间浪费,道理相同。
最后改为SQL批量消费,速度立刻提升。最终的消费策略为:单线程批量500条 → 30个线程单条消费 → 30个线程批量50条消费。
多线程异步+批量操作的策略仍然很重要。不过多线程一定要注意异步问题。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
相关文章