

在神经网络推理中,Conv+BN可数学融合为等效新卷积,消除BN层以降低访存与调度开销。Add与ReLU虽无法代数合并,但可通过算子融合在同一内核中连续执行,避免中间张量读写,显著提升推理性能。
Conv+BN+Add+ReLU融合机制详解
作者:技术拾光
时间:2026-06-02
浏览:225
文章目录
1. 引言
在深度学习模型的量化部署过程中,算子融合(Operator Fusion)是提升推理性能的重要手段。地平线算法工具链提供了两种常见融合模式:OnlyBN 和 BNAddReLu。这引出了几个关键问题:为什么需要融合?融合的具体机制是什么?融合操作在数学上是否严格等价?本文将从原理到实践进行解析。
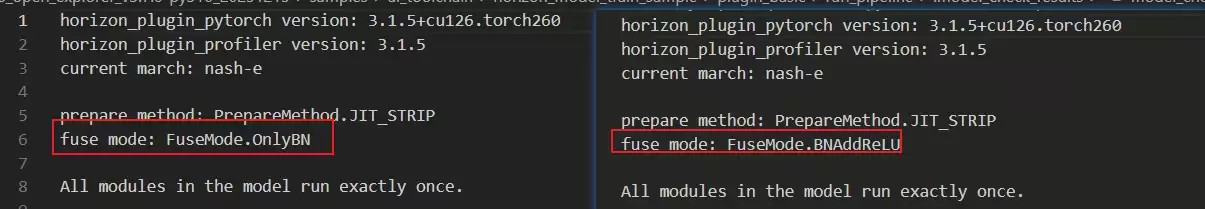
实际上,在神经网络推理阶段,算子融合是一种经典且高效的优化策略,其核心目标是降低计算量、减少访存开销、加速推理执行。常见的融合模式主要有两种:
- Conv + BatchNorm
- Conv + BatchNorm + Add(残差) + ReLU
2. Conv + BN 融合原理
在推理阶段(Eval Mode),BatchNorm2d 的计算本质是一个线性变换:
y = (x - mean) / sqrt(var + eps) * gamma + beta
其中,mean 和 var 是统计得到的均值和方差,gamma 和 beta 是可学习参数。关键在于将 BatchNorm 与卷积层合并。常规卷积的输出为:
z = Conv(x) = W * x + b
BatchNorm 作用于 z 的结果上:
y = (z - mean) / sqrt(var + eps) * gamma + beta
代入展开后,该组合可等效为一个新的卷积层:
W_fused = W * (gamma / sqrt(var + eps))b_fused = (b - mean) / sqrt(var + eps) * gamma + beta
注意,权重和偏置均已改变。通过此步骤,Conv+BN 组合被无缝替换为一个全新的 Conv,而 BN 层从计算图中消失。这种融合带来以下显著好处:
- 减少一次 BN 的访存,降低内存带宽压力。
- 减少一次算子调用,简化推理调度。
- 便于后续量化,避免 BN 层对数值范围产生潜在影响。
3. Conv+BN+Add+ReLU 融合原理
如上一节所述,Conv 和 BN 已融合为新的 Conv'。接下来处理 Add 和 ReLU。在量化部署时,Add 操作(通常来自残差连接)要求两个输入具有一致的量化 scale 值。因此,框架在 FX 层会识别出类似 add(conv_out, skip_tensor) 的模式,并可能调整量化 scale,使整个链路处于同一量化域。这样硬件才能在同一个 kernel 内高效执行 Add 和 ReLU。
从数学上看,ReLU 直接作用于 Add 的输出,数值关系完全一致,因此可将 Add+ReLU 合并为一个 fused activation:
fused_out = relu(add(x, y))
在量化推理语境下,这表示 Add 的输出可直接进入 ReLU 的裁剪范围,从而减少中间不必要的量化/反量化开销。以下是一个具体示例:
import torch
import torch.nn as nn
from torch.fx import symbolic_trace
class ResidualModel(nn.Module):
    def __init__(self):
        super().__init__()
        self.conv = nn.Conv2d(3, 3, kernel_size=3, padding=1)
        self.bn = nn.BatchNorm2d(3)
        self.relu = nn.ReLU()
该模型的 FX 图输出为:
placeholder x x
call_module conv conv
call_module bn bn
call_function add
call_module relu relu
output output output
部署框架会识别此子图,其中 Conv+BN 被融合,而 Add 和 ReLU 形成连续节点,可进一步融合优化。你可能会有疑问:Conv+BN 可通过等效公式融合为一个算子,但 Add 和 ReLU 显然无法做类似操作,那么它们是如何融合的?目的又是什么?
4. 拓展解读
“Conv+BN+Add+ReLU 融合”这一说法,实际上并非将所有算子物理上变成一个,而是分步完成:
- Conv+BN → 融合为 Conv'(数学上严格等价)
- Conv' + Add → 融合为更高效的“卷积 + 残差加法”算子(计算图优化)
- Add + ReLU → 融合为“带激活的残差”算子(计算图优化)
真正从数学上消失的只有 BN。Add 和 ReLU 更多属于算子合并(Operator Folding)。
4.1 Conv+Add 融合
Conv+Add 的融合并非代数消去,而是操作符流水线融合(Operator Fusion)。典型残差块为:out = Conv'(x),然后 out = out + skip。Add 是逐元素加法,不涉及参数,数学形式 Add(a,b) = a+b 不会改变 Conv' 的结构,也无法代数合并为新卷积。但在推理框架(如 TensorRT、ONNXRuntime、OpenExplorer)中,实现方式完全不同:Conv' 的输出内存可直接作为 Add 的输入,在同一个 kernel 中完成累加,无需创建中间张量。硬件执行流程如下:
for each output pixel:
    tmp = ConvKernel(x)
    tmp = tmp + skip(x)
    output = tmp
这样带来实际性能提升:
- 节省一次 Conv 输出的内存写回
- 节省一次 Add 输入 a-tmp 的内存读回
- 节省一次 Add 输出的内存写回
因此,尽管在数学类型上无法合并,但在计算图优化层面,它们可被“内联”到同一 kernel 中执行。该融合可放在量化结束后,在编译时进行。
4.2 Add+ReLU 融合
Add 和 ReLU 的融合原理类似。数学形式为 y = relu(a + b),ReLU 仅对加法结果做逐元素裁剪(relu(z) = max(z, 0)),不改变 Add 的结构。硬件执行时,在加法后的同一寄存器内直接进行 ReLU 操作,无需将 Add 的输出写回内存。融合后过程简化为:
tmp = a + b
out = max(tmp, 0)
这同样节省了:
- Add 输出的写回
- Add 输出再次读回以执行 ReLU
综上所述,BN 可数学上融合到 Conv 中;而 Add 和 ReLU 虽不能进行数学融合,但可在硬件执行层面融合到同一个 kernel 里,避免中间张量的反复读写,从而实现显著的性能提升。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
相关文章