

豆包专攻食物多模态识别,快速返回营养数据;DeepSeek负责推理对话,生成个性化饮食计划与建议。双引擎通过统一抽象层管理,互不干扰,替换仅需修改三处配置。对话数据本地持久化,保障隐私且零延迟。实测记录效率提升40倍,从传统2-5分钟压缩至10秒内。
鸿蒙首个双AI引擎饮食App 豆包与DeepSeek协同工作
作者:技术拾光
时间:2026-05-31
浏览:579
文章目录
在体验过几十款饮食记录App之后,可能不止我一人觉得,准确记录每一餐,比坚持健身本身更令人头疼。更遗憾的是,记录下来的只是一堆冰冷的数据——热量、蛋白质、碳水——可然后呢?接下来该怎么做,绝大多数工具都给不出答案。这正是智能饮食管理工具「食刻」及其双AI引擎架构的设计初衷。不是为了炫技,而是为了解决一个真实且被反复验证的痛点:记录太慢、反馈太浅、建议太模板化。
一、为什么需要双 AI 引擎?
传统饮食 App 的痛点
用过Keep、薄荷健康、MyFitnessPal的用户都清楚,手动记录一顿饭需要多长时间。从搜索食物名称,到手动筛选匹配项,再到确认份量、归类餐段,整个过程至少要花2到5分钟。而且,记完之后呢?App只告诉你:今天摄入1450千卡,蛋白质45克。然后——就结束了。碳水比例偏高怎么办?蛋白质如何补充?App无法给出明确指导。
我们的解法:双引擎分工
食刻的解决方案是引入两个AI引擎,各司其职,不搞全能型路线。一个擅长图像识别与数据处理,另一个专注逻辑推理与个性化方案生成。
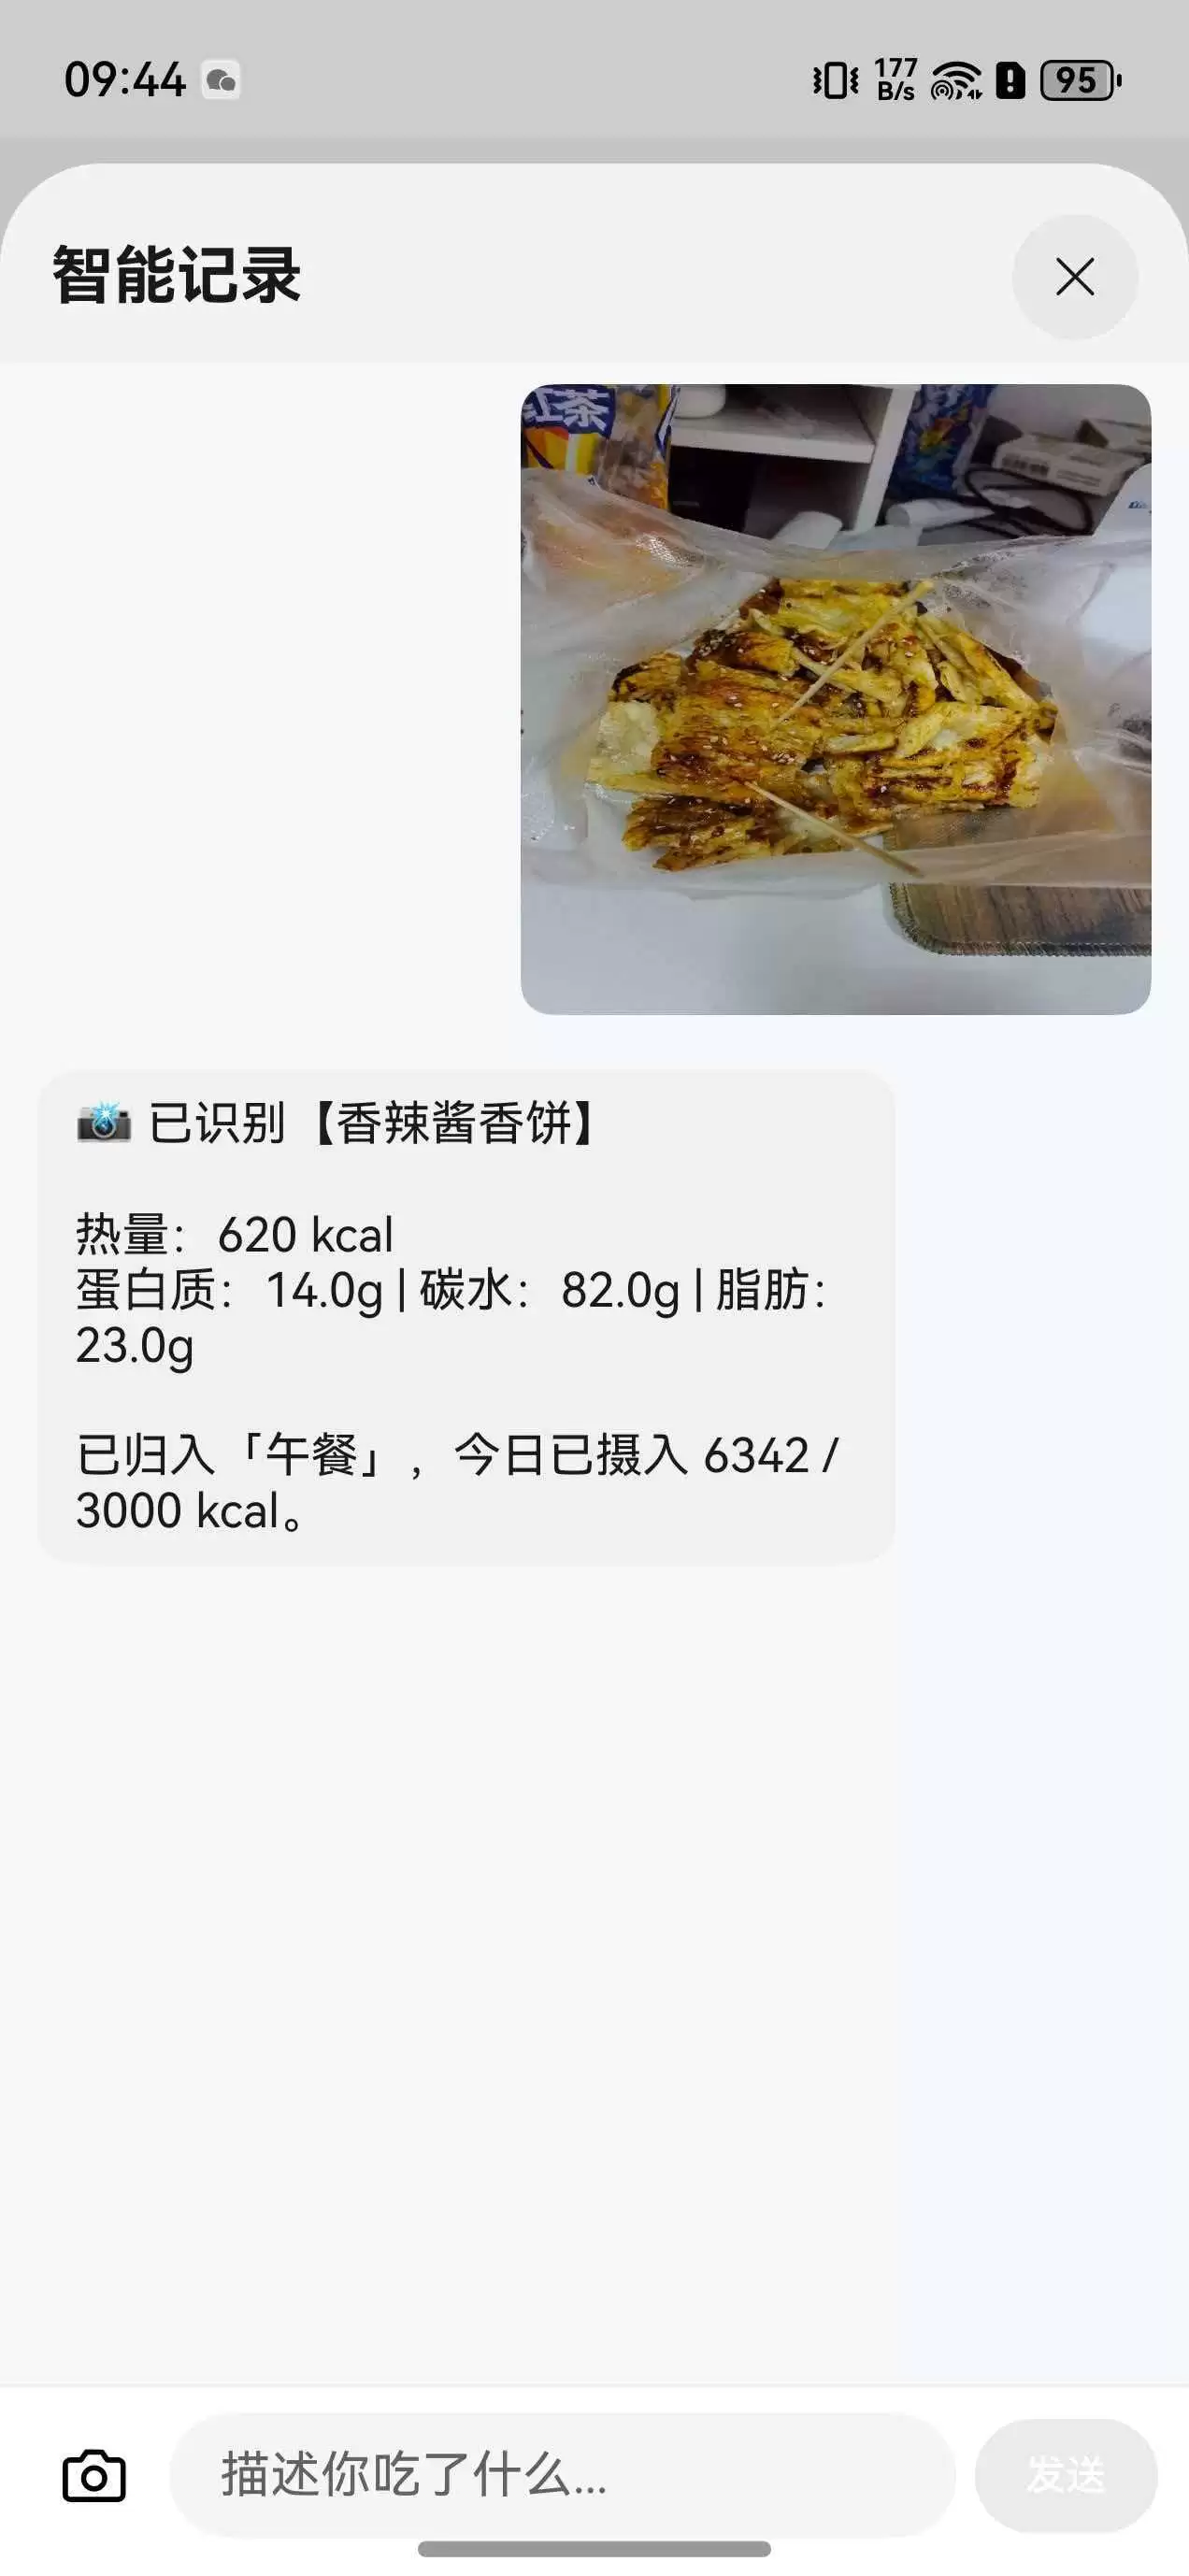
🧠 豆包 doubao-seed-2-0-pro
专攻多模态识别。文字描述也好,拍张照片也好,它都能快速返回结构化的营养数据。一句话描述「今天中午吃了鸡腿饭」,它能瞬间识别出具体的食物种类和对应的营养信息。
🔮 DeepSeek v4-pro
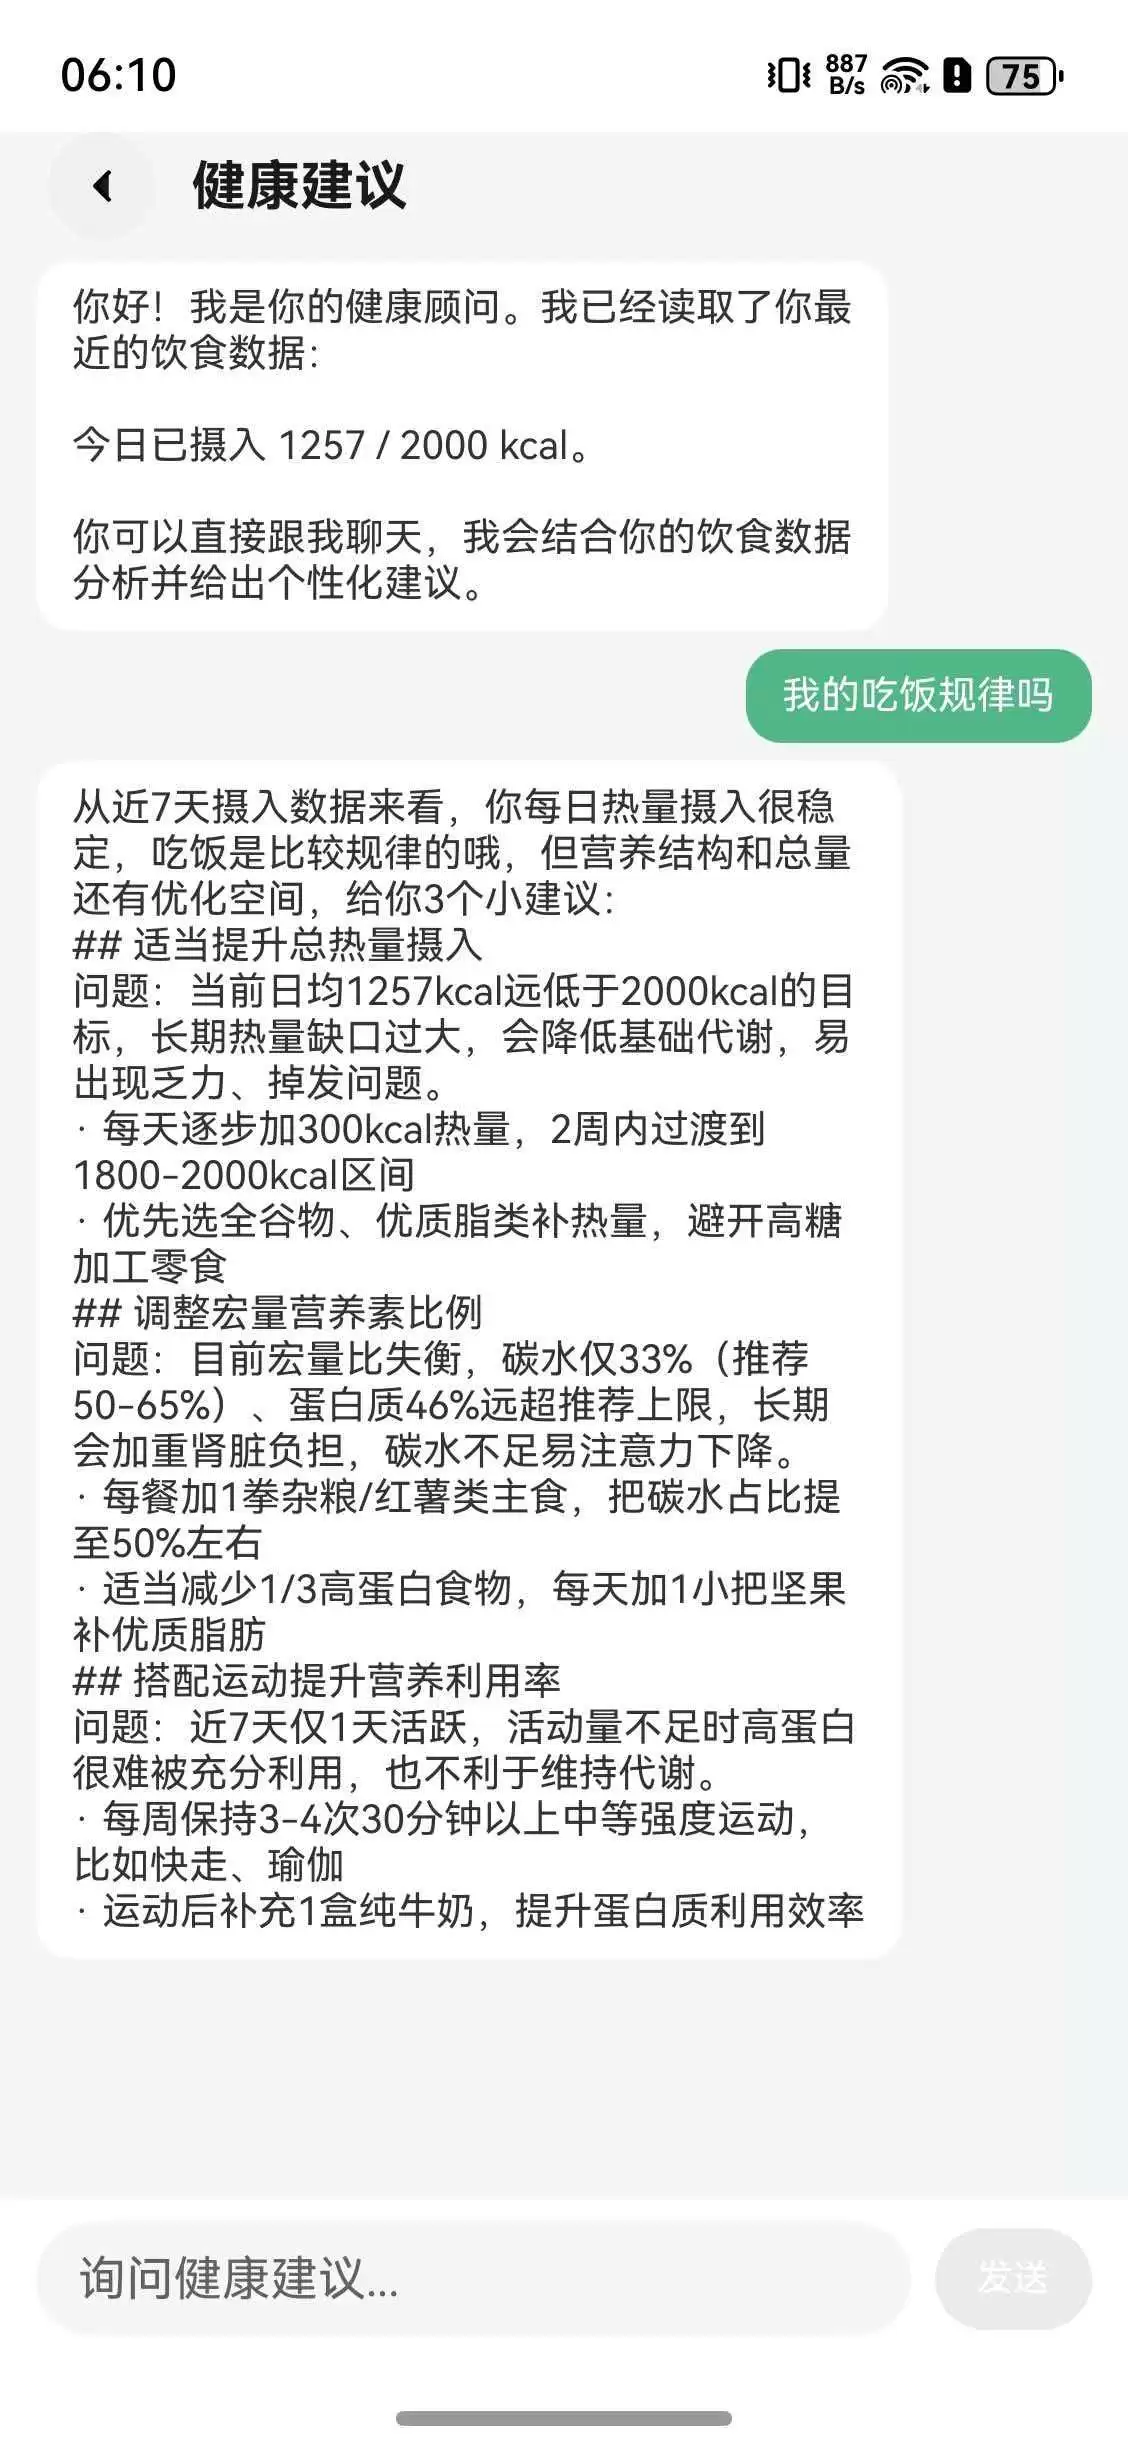
负责推理与对话。它不处理图片,但擅长生成个性化的饮食计划、分析用户的健康数据、预测体重趋势、甚至生成智能报告。简单说,豆包负责把「吃了什么」翻译成数据,DeepSeek负责回答「接下来吃什么」「怎么吃更好」。
二、架构设计:统一抽象层
核心思路
两个引擎各自独立,但通过一个统一的DoubaoApiService抽象层管理。API Key、Endpoint、Model各自配置,互不干扰。这样设计的优势在于,未来若需替换某个AI引擎,只需修改核心配置,业务逻辑几乎无需变动。从用户输入开始,系统根据场景自动分流:食物识别任务调用AI视觉引擎,智能对话任务调用推理引擎。
关键代码层面,DoubaoApiService核心结构很清晰:豆包端提供identifyFood方法,支持文字和图片两种输入;DeepSeek端提供generateDietPlan等方法,走纯文本推理路线。
关键设计决策:为什么不共用一个 API 方法?
这里有一个工程层面的严谨判断。端点和鉴权:豆包走的是火山引擎的ark.cn-beijing.volces.com,DeepSeek是api.deepseek.com,鉴权方式也略有不同,前者用火山引擎的Bearer Token,后者用DeepSeek自己的Bearer Token。请求格式上,豆包是自定义JSON结构,DeepSeek则兼容OpenAI的格式。响应解析更是天差地别,豆包需要提取foodName、calories等字段,DeepSeek直接返回Markdown文本。更不用提超时设置,识别场景要求10秒内出结果,推理场景可以放宽到30秒。
结论很清晰:强行合并只会让代码陷入无尽的if-else分支,维护成本远高于分而治之。
三、AI 对话数据流:历史记录如何持久化?
问题场景
想象一个典型场景:用户在「饮食计划」页面和DeepSeek聊了10轮,然后临时切到首页看一眼热量环,再回来时——对话的上下文还在吗?
答案是肯定的。食刻利用本地存储组件,在设备端加密持久化了每一轮对话。整个过程是这样的:页面加载时,先从本地磁盘读取历史消息;当用户发送新消息时,系统携带完整上下文向DeepSeek发起请求;收到回复后,连同所有历史一起写回磁盘。
每个 AI 场景独立存储
这里有一个细节值得关注:不同页面的AI对话使用不同的存储标识。DietPlanPage用chat_diet_plan,HealthAdvicePage用chat_health_advice,以此类推。这样做的好处是,用户在不同模块的对话互不干扰,且每次只读写当前页面的数据,性能开销降到最低。
那么,为什么不选择云端存储?一个关键原因在于,饮食数据属于高度隐私的个人信息,用户大概率不希望自己的饮食习惯被上传到他人的服务器上。本地存储同时保证了零网络延迟,页面切换时几乎瞬间恢复对话上下文。
四、实际效果:3 秒 vs 3 分钟
记录效率对比
效率是衡量一款AI饮食工具好坏的关键指标。食刻的AI文字或拍照识别,从输入到输出完整食物识别和营养估算,仅需3秒。相比之下,传统的手动查库方式,光是搜索加筛选这一步,每道食物就要耗掉30到60秒。加上手动归类餐段,一顿饭的总耗时从传统的2到5分钟,直接压缩到10秒以内,时间降低了整整40倍。
随便对比一下:传统方式下,打开记录入口1秒,输入搜索食物30到60秒,营养计算自动完成,但归类餐段还得手动操作。而食刻的AI模式,同样是打开入口1秒,输入「鸡腿饭」2秒完成,营养计算由AI自动返回,餐段归类也由AI自动判断。
DeepSeek 的数据驱动建议
传统App所谓的"建议"往往是一段模板化的通用文本,比如"建议多吃蔬菜"。坦率说,这类建议有没有营养都存疑,更别说指导意义。食刻的DeepSeek会读取用户近7天的真实饮食数据,然后给出基于数据的个性化反馈。比如,"您最近三天晚餐的碳水摄入比例超过60%,建议在晚餐中用30克粗粮替代部分白米饭"。这就是数据驱动与模板化的本质区别。
五、竞品全景对比
与市场主流的饮食管理App相比,食刻在AI能力上形成了显著差异。Keep、薄荷健康、MyFitnessPal目前均未提供基于AI的实时食物识别、个性化饮食计划生成以及智能健康分析功能。而食刻通过双引擎架构,将这些功能集于一身,为用户提供从记录到规划的全链路服务。桌面Widget方面,竞品提供的是基础版本,食刻则做了3张卡片式的丰富展示。视觉效果上,保持2D和扁平化风格的竞品,与食刻的Neumorphism 3D风格形成了明显分层。
六、总结与下篇预告
核心要点再回顾一下:双引擎并非技术炫技,而是基于真实用户场景驱动的工程选择——识别场景追求速度与准确性,用专用视觉模型;推理场景追求深度与个性化,用语言大模型。统一抽象层的设计让系统未来可扩展性更强。所有历史数据通过本地加密持久化,为用户数据隐私筑起防线,且所有饮食数据始终留在设备上,不离开本地。
下一篇将换个视角,从视觉层面切入:《纯 ArkUI 实现 7 层拟物 3D 环形进度图:零依赖的视觉革命》。届时会拆解食刻首页那个令人印象深刻的环形进度图,看看它是如何用纯ArkUI组件,在无Canvas、无3D引擎、无第三方依赖的前提下,靠7层组件的创意叠加手工打造出来的。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
相关文章