

说到Ja va操作数据库,JDBC(Ja va Database Connectivity)是绕不开的基石。它本质上是一套Ja va官方定义的接口规范,扮演着程序与数据库之间的“翻译官”和“传令兵”角色。它的核心使命很明确:建立连接、发送SQL指令、并处理数据库返回的结果。无论底层是Oracle、M
JDBC连接池Druid配置与优化指南
作者:技术拾光
时间:2026-05-26
浏览:609
文章目录
说到Ja va操作数据库,JDBC(Ja va Database Connectivity)是绕不开的基石。它本质上是一套Ja va官方定义的接口规范,扮演着程序与数据库之间的“翻译官”和“传令兵”角色。它的核心使命很明确:建立连接、发送SQL指令、并处理数据库返回的结果。无论底层是Oracle、MySQL还是PostgreSQL,只要提供了对应的JDBC驱动,Ja va程序就能用统一的方式与之对话。
一个典型的JDBC访问流程,可以概括为下面五个标准步骤:
- 加载驱动:告诉JVM我们要连接哪种数据库。
- 确认连接信息:准备好数据库的地址(URL)、用户名和密码。
- 创建Statement:获取一个能执行SQL语句的对象。
- 执行SQL并处理结果:发送查询或更新命令,并接收返回的数据集。
- 关闭连接:释放占用的数据库资源,这是个好习惯。
JDBC配置
建立连接
万事开头难,第一步是引入数据库驱动。以Oracle为例,你需要先下载对应的JDBC驱动jar包,然后将其放入项目的依赖库中。在IDE里,通常右键点击jar包,选择“添加到库”或“Add as Library”即可完成配置。
基础配置
注册驱动与获取连接
驱动加载后,就可以在代码中建立连接了。注册驱动常见的有几种方式,其中Class.forName()是较为传统和明确的一种。紧接着,通过DriverManager传入数据库URL、用户名和密码,就能拿到一个宝贵的Connection对象。
    //注册驱动,有三种方式,我比较习惯使用class.forname
    Class.forName("oracle.jdbc.driver.OracleDriver");
    //获取连接
	Connection con = DriverManager.getConnection(
			"jdbc:oracle:thin:@localhost:1521:XE",
			"XIAOMING",
			"123456"
	);
配置Statement
拿到连接后,需要创建Statement对象来执行SQL。这里有两个主要选择:Statement和PreparedStatement。它们的区别直接影响着程序的效率和安全性:
PreparedStatement:推荐使用。它会预先将SQL语句提交给数据库编译和优化,后续只需传入参数即可。这种方式不仅效率高(特别是重复执行时),更重要的是能有效防止SQL注入攻击,因为参数是预编译的,不会被解释为SQL指令的一部分。Statement:相对基础。每次执行都需要将完整的SQL字符串发送给数据库,如果SQL中包含变量,需要在代码中拼接字符串。这种方式不仅效率低,而且拼接字符串极易引入SQL注入的安全漏洞。
下面是两种方式的代码对比:
使用Statement(不推荐用于动态参数):
String sql = "select * from family_member where name";
Statement stat = con.createStatement();
ResultSet resultSet = stat.executeQuery(sql);
while(resultSet.next()){
	System.out.println(resultSet.getString("name")
						+"t"
						+resultSet.getString("gender")
	);
}
使用PreparedStatement(推荐方式):
String sql = "select * from family_member where name = ";
PreparedStatement stat = con.prepareStatement(sql);
stat.setString(1,"爸爸");
ResultSet resultSet = stat.executeQuery();
while(resultSet.next()){
	System.out.println(resultSet.getString("name")
						+"t"
						+resultSet.getString("gender")
	);
}
释放资源
所有操作完成后,务必按照ResultSet -> Statement -> Connection的顺序反向关闭资源,确保连接池资源能被正确回收。
resultSet.close();
stat.close();
con.close();
Spring实战 --手动构建DataSource
在Spring框架中,我们很少直接使用原生的JDBC API,而是通过DataSource和数据访问模板(如JdbcTemplate)来操作,这能获得连接池管理、事务控制等诸多好处。下面以阿里开源的Druid连接池为例,看看如何手动配置一个功能完备的数据源。
配置类结构
一个完整的手动配置通常包含三块核心内容:
- 数据源配置:定义数据库连接信息和连接池的各项参数。
- Druid监控Servlet:配置一个内置的管理页面,用于可视化监控连接池状态和SQL性能。
- Druid Web过滤器:用于关联HTTP请求与后台执行的SQL,方便在监控页进行链路追踪。
配置
数据源核心配置
这是最核心的部分,我们通过@Bean注解定义一个DataSource。除了基本的连接四要素(URL、驱动类、用户名、密码),Druid提供了丰富的连接池优化和监控参数。
@Bean
public DataSource dataSource() throws SQLException {
    DruidDataSource ds = new DruidDataSource();
    //基础连接信息
    ds.setUrl("jdbc:oracle:thin:@localhost:1521:XE");
    ds.setDriverClassName("oracle.jdbc.driver.OracleDriver");
    ds.setUsername("XIAOMING");
    ds.setPassword("123456");
    //连接池大小控制
    ds.setMinIdle(5);  //最小连接数
    ds.setMaxWait(60000);  //获取连接的最大等待时间
    ds.setMaxActive(20);  //最多20个连接同时活跃
    ds.setInitialSize(5);  //5个初始连接
    //空闲连接回收策略
    ds.setMinEvictableIdleTimeMillis(60000);  //最小回收等待时间
	ds.setMaxEvictableIdleTimeMillis(900000);  //最大回收等待时间
    ds.setTimeBetweenEvictionRunsMillis(30000);  //每30s检测一次
    //连接检测
    ds.setValidationQuery("SELECT 1 FROM DUAL");  //检测语句
    ds.setTestWhileIdle(true);  //空闲时检测
    ds.setTestOnBorrow(false);  //借出不检测
    ds.setTestOnReturn(false);  //还回不检测
    //废弃处理
    ds.setRemoveAbandoned( true);  //自动回收泄露的连接
    ds.setRemoveAbandonedTimeout(180);  //设置3分钟未关闭为泄露
	ds.setLogAbandoned(true);  //回收时打印
	//扩展功能
    ds.setFilters("stat,wall");  //stat=SQL监控,wall=SQL防火墙
    ds.setPoolPreparedStatements(true);  //开启预先输入缓存
    ds.setUseGlobalDataSourceStat( true);  //启用全局数据源统计
    return ds;
}
这里有个细节值得注意:setFilters("stat,wall")中的wall指的是Druid内置的SQL防火墙功能。它能有效防御SQL注入攻击,在生产环境中是一个非常实用的安全特性。
Druid监控页面Servlet
配置这个Servlet后,你就可以通过浏览器访问一个内置的监控管理页面,直观地查看连接池状态、SQL执行统计等信息。为了安全,通常需要设置登录账号和密码。
@Bean
public ServletRegistrationBean statViewServlet() {
    ServletRegistrationBean servletReg =
            new ServletRegistrationBean<>(new StatViewServlet(), "/druid/*");
    servletReg.addInitParameter("loginUsername", "admin");  // 监控页登录账号
    servletReg.addInitParameter("loginPassword", "123456"); // 监控页登录密码
    return servletReg;
}
Druid Web过滤器
这个过滤器的作用是将前端的HTTP请求和后端执行的SQL语句关联起来。配置后,在监控页面上你就能清晰地看到“哪个URL接口执行了哪些SQL、各自耗时多少”,这对于性能分析和问题排查至关重要。
@Bean
public FilterRegistrationBean webStatFilter() {
    FilterRegistrationBean filterReg = new FilterRegistrationBean<>();
    filterReg.setFilter(new WebStatFilter());
    filterReg.addUrlPatterns("/*");
    filterReg.addInitParameter("exclusions", "*.js,*.css,/druid/*");
    return filterReg;
}
验证配置
配置完成后,如何验证一切工作正常呢?可以从两方面入手。
-
测试数据库连接和业务代码
编写一个简单的Controller方法,调用Service层查询数据。如果能够正常返回数据,说明数据源配置和基础连接是通的。@GetMapping("/listAll") public Result listAll() { Listlistall= familyMemberService.listAll(); if(listall.size()>0){ return Result.ok(listall); }else{ return Result.fail("没有数据"); } } 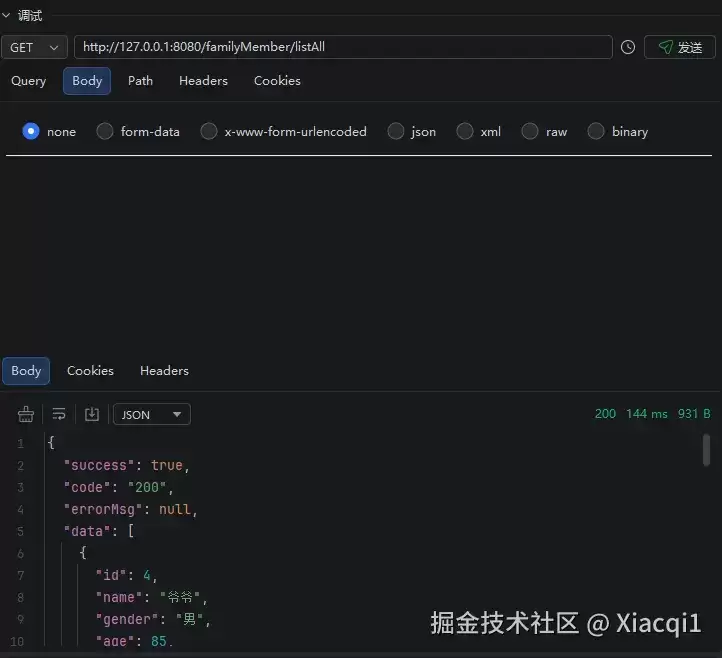
-
访问监控页面
启动应用后,在浏览器中访问http://你的服务器地址:端口/druid,输入配置的用户名和密码(如上面的admin/123456),即可进入Druid监控后台。在这里,你可以全方位地监控连接池状态、SQL执行情况、Web请求关联等,是线上运维的得力工具。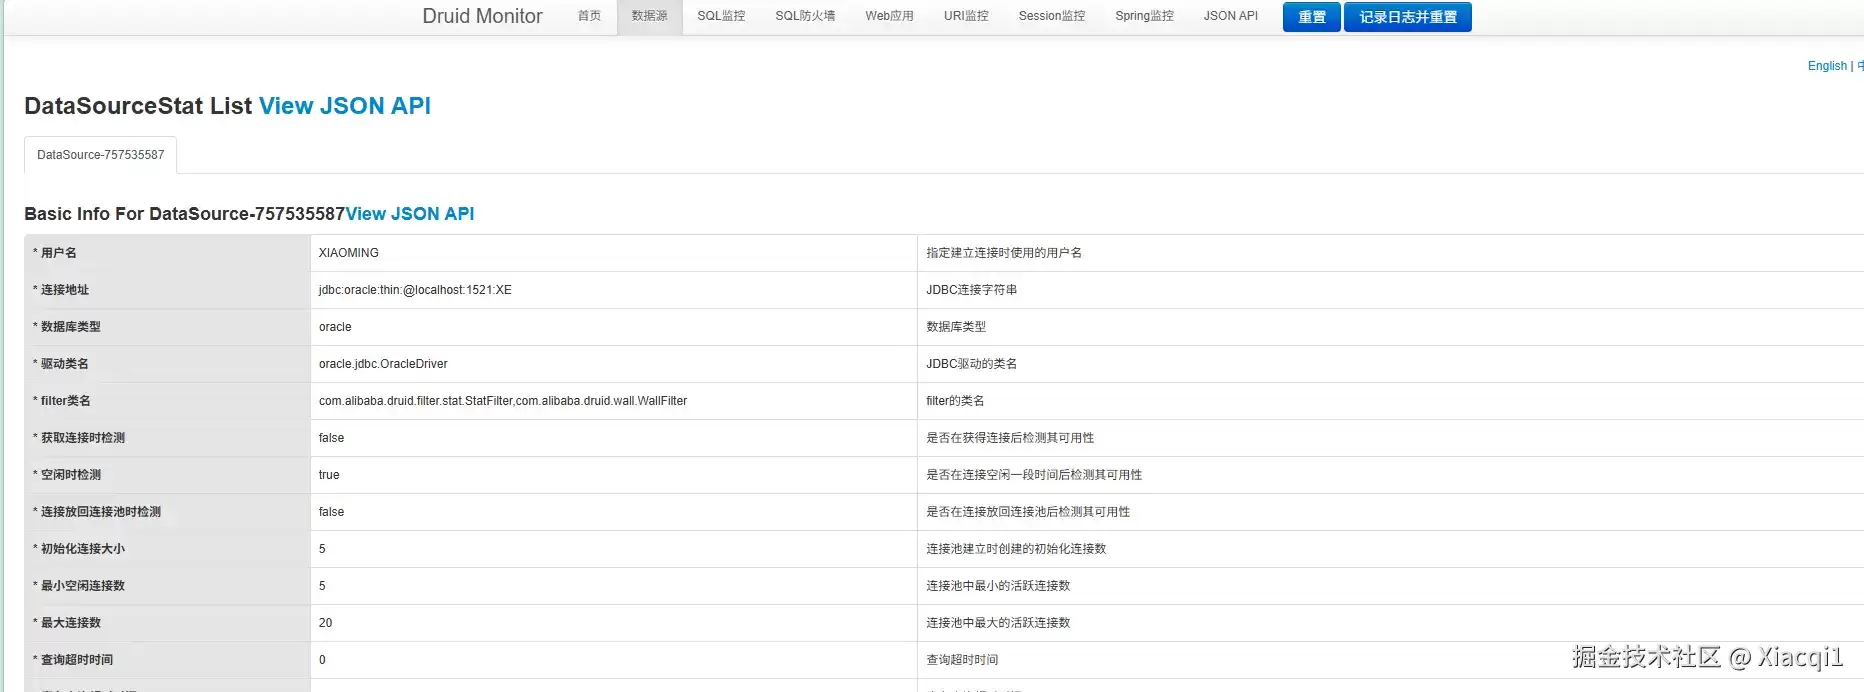
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
相关文章