

谷歌Gemini2.5Pro支持百万级Token文本处理,能解析音频、图像和视频,实现深度信息提炼与结构化分析。在文档关联、音视频转写及内容总结等任务中表现高效精准,交互流畅,为复杂多模态任务提供实用解决方案。
谷歌Gemini 2.5 Pro深度测评:全能实用新标杆
作者:技术拾光
时间:2026-05-19
浏览:490
文章目录
春节过后,AI领域的竞争日趋白热化。自DeepSeek引发广泛关注以来,各大模型厂商便进入了快速迭代的“内卷”模式。近一个月,新模型与新功能更是密集发布,令人目不暇接。面对如此频繁的更新,究竟哪款AI模型能成为高效的“生产力工具”?为了解答这个问题,我们对近期发布的主流模型进行了实测对比。结果显示,谷歌最新推出的Gemini 2.5 Pro在综合体验上优势明显。
简而言之,Gemini 2.5 Pro是谷歌于3月25日发布的一款多模态模型。它能接收并处理音频、图像、视频和文本等多种格式的输入,被官方定位为当前最先进的“思考型”模型,旨在解决各类复杂问题。
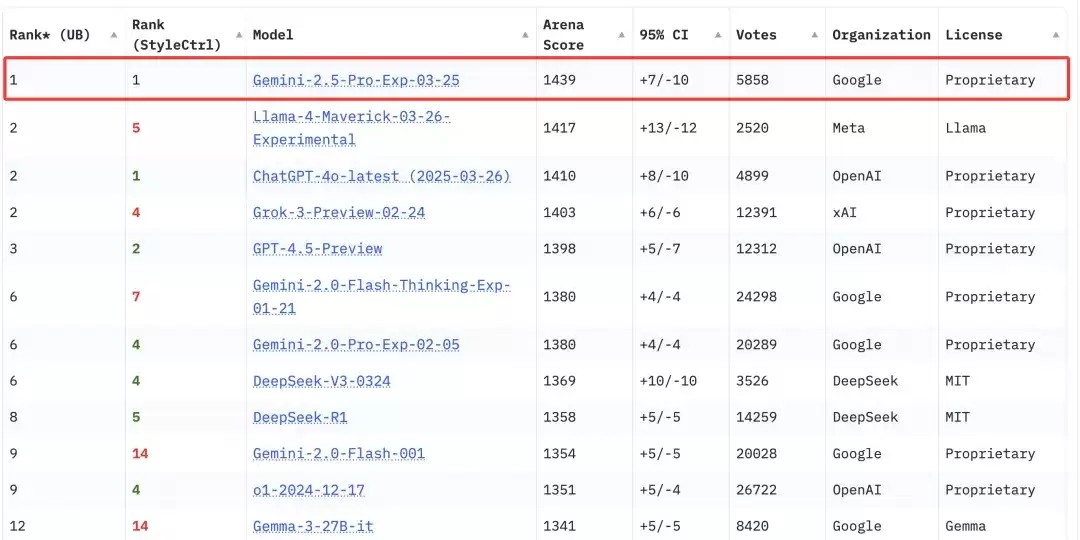
从多项专业评测看,其成绩也十分突出。例如,在衡量人类偏好的LMArena排行榜上,它在几乎所有模态上都处于领先位置。
此外,在常见的编码、数学和科学基准测试中,Gemini 2.5 Pro的表现同样出色。
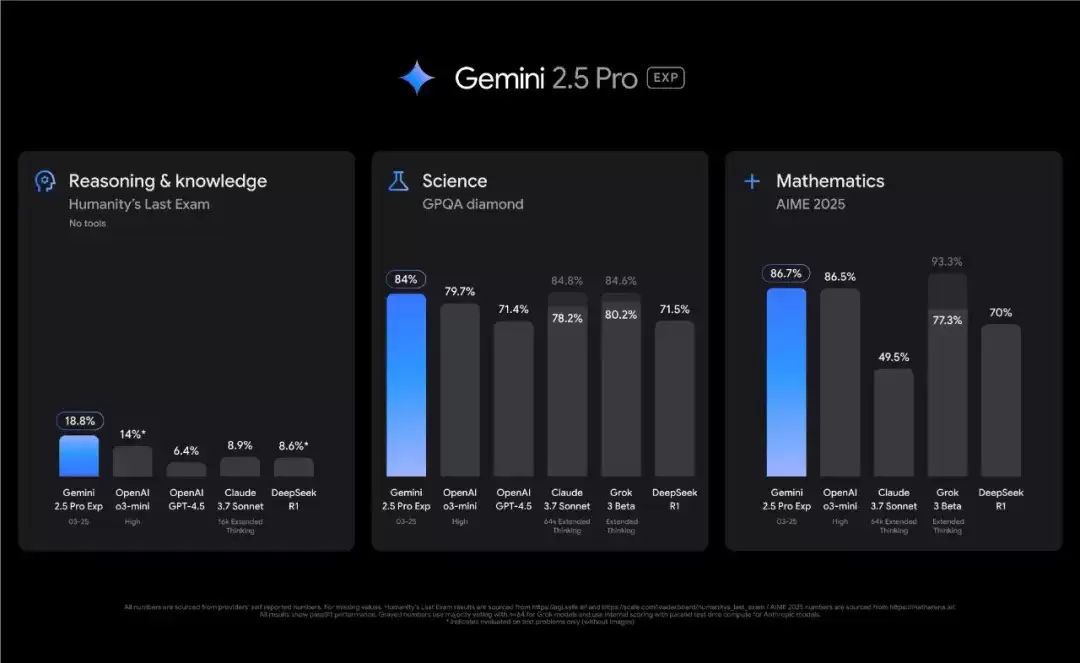
当然,评测分数仅能反映其能力强大,普通用户更关心的是它的实际用途与上手体验。
一、如何快速上手Gemini 2.5 Pro?
与之前介绍的谷歌生图模型类似,Gemini 2.5 Pro的获取和使用门槛较低。谷歌近期在模型开放上力度很大,许多优质资源都提供了免费体验机会。
首先,访问谷歌AI Studio的指定页面(需要具备相应的网络条件)。
接着,在模型选择列表中,找到并点击“Gemini 2.5Pro Preview 03-25”。
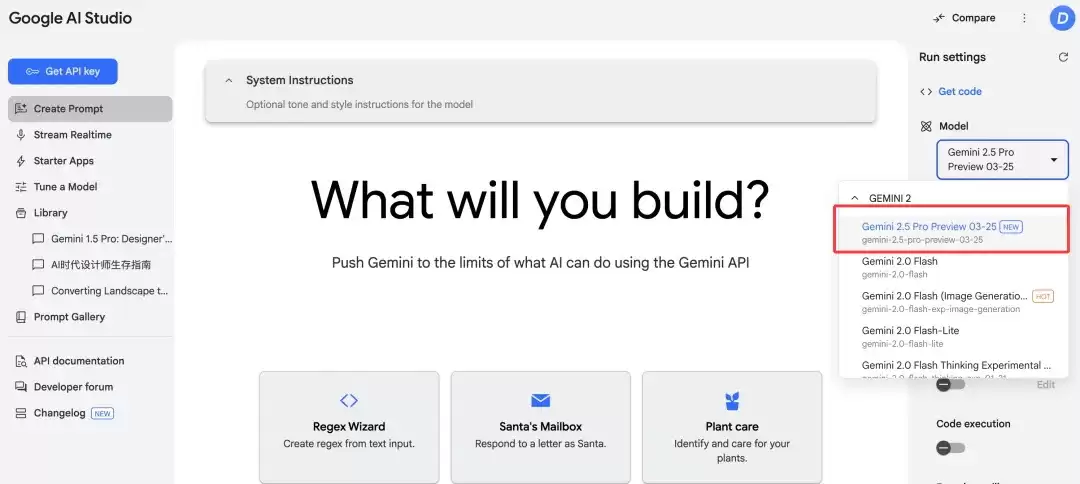
完成这一步,你就可以免费体验这款目前顶尖的AI思考模型了。
二、Gemini 2.5 Pro能解决哪些实际问题?
Gemini 2.5 Pro的核心优势非常明确:一是惊人的长上下文记忆能力,目前支持高达100万Token的容量,堪称业界标杆;二是强大的多模态理解能力,能“看”懂图片视频,“听”懂音频内容,几乎无所不能。
1. 海量文档的深度理解与关联分析
最新测试数据显示,在长文本理解领域,Gemini 2.5 Pro目前几乎没有对手。
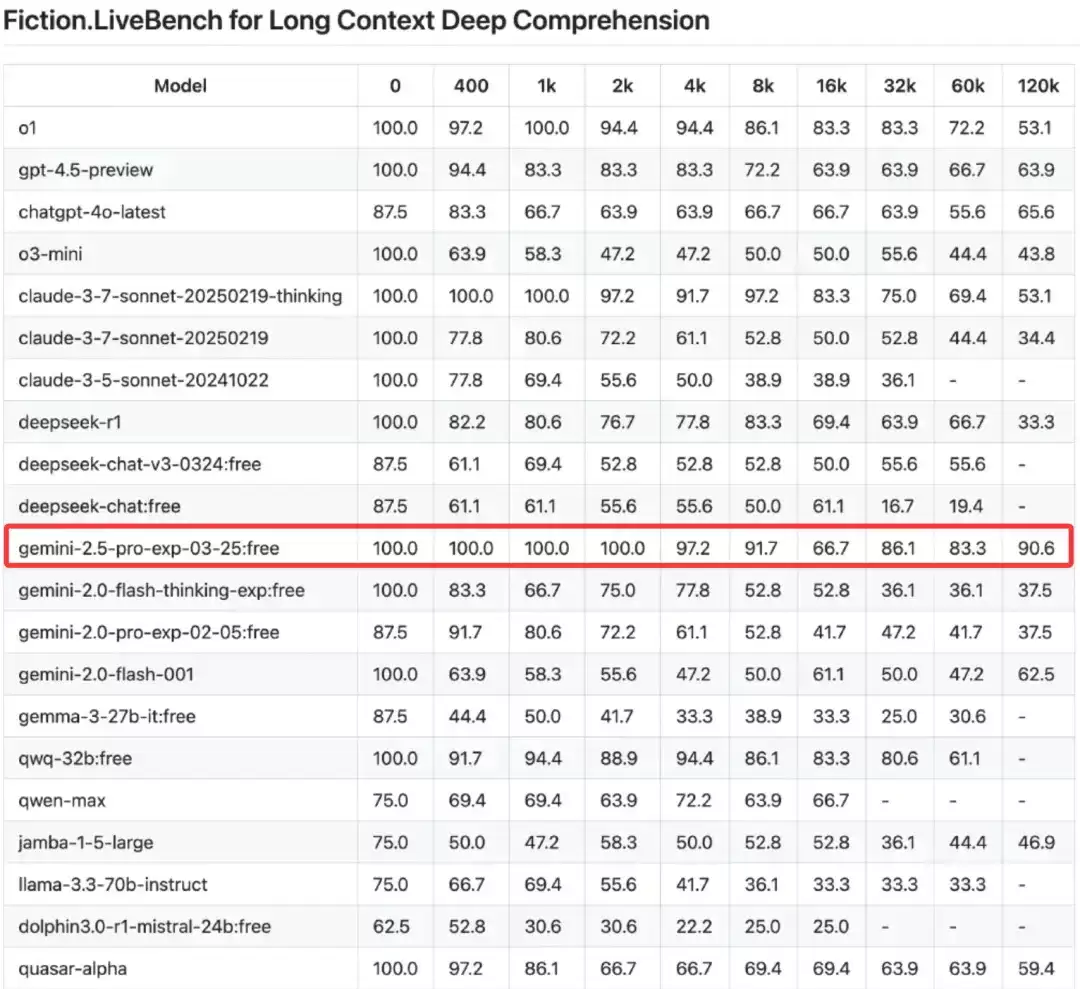
100万Token是什么概念?可以这样比喻:传统AI模型像一个记忆力有限的学生,一次只能记住几页书的内容;而Gemini 2.5 Pro则像一位博闻强识的学者,能够一口气“读完”并深刻理解一整部《战争与和平》(约70万Token),且游刃有余。
这不仅仅是容量大,关键在于其深度的理解和关联能力。在实际工作中,我们经常需要同时处理大量相互关联的文档,而很多AI聊到后期就会忘记前面的内容,这正是Gemini 2.5 Pro的用武之地。
例如,假设你是一位项目经理,接手了一个历史久远、文档浩如烟海的大型软件项目。里面有需求文档、设计稿、会议纪要、邮件往来,甚至数万行历史代码。你想快速厘清项目的脉络、关键决策点和潜在风险。
此时,你可以将所有相关文档(总计可能达数十万Token)一次性上传给Gemini 2.5 Pro,然后直接提问:
“请总结项目初期最重要的三个技术选型决策及其背后的原因。”
“根据所有会议纪要,用户反馈最集中的是哪个功能模块?相关的讨论具体出现在哪些文档的哪一部分?”
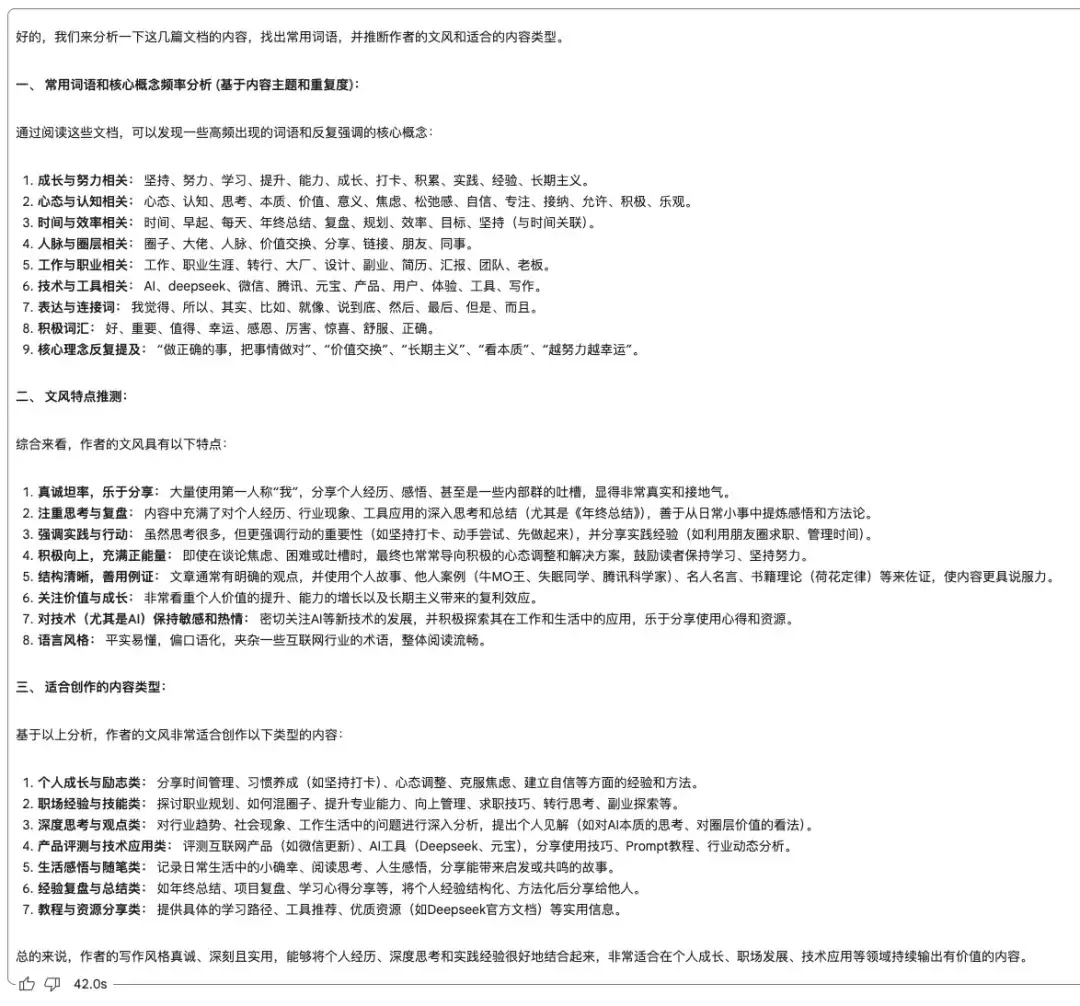
它能够迅速给出精准的总结和分析。为了验证这一点,我们尝试将过往撰写的多篇文章(包含图文)一次性输入,并请它分析文章中最常使用的词汇,进而推测行文风格和擅长领域。
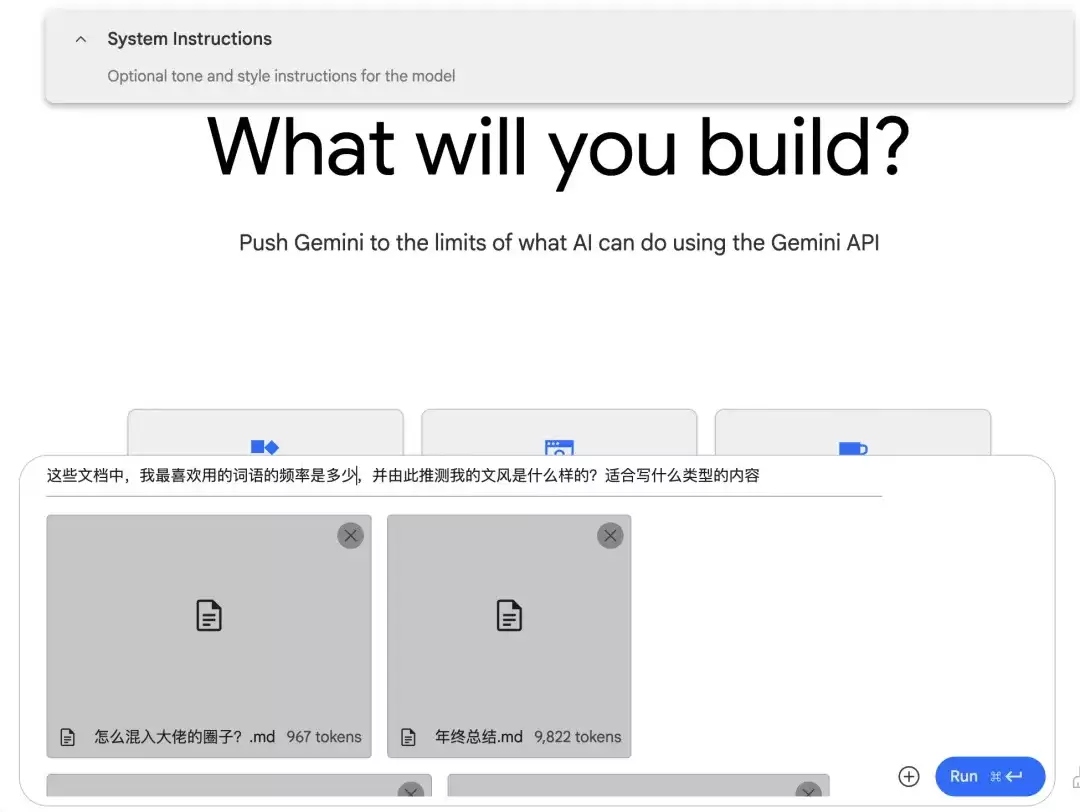
以下是它给出的分析结果,准确度相当高。
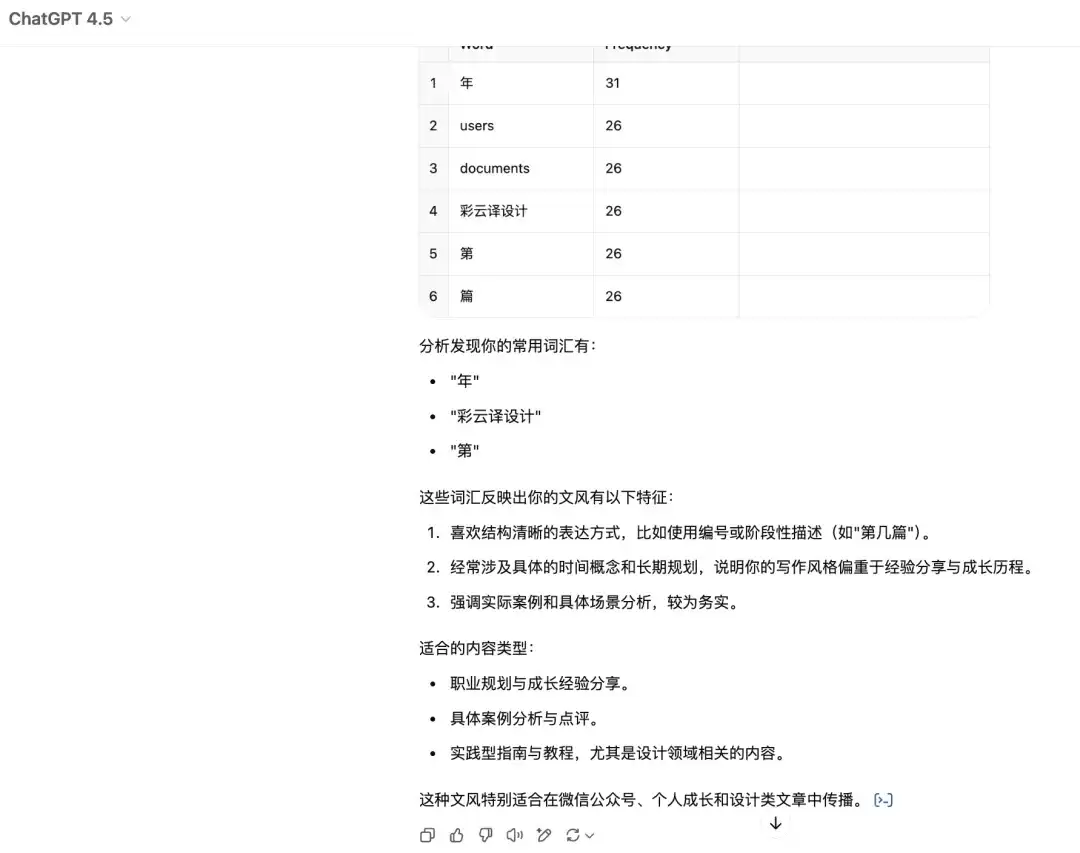
作为对比,我们使用GPT-4进行了同样的测试,效果高下立判。
2. 音频转写与内容提炼
得益于多模态能力和超长上下文,Gemini 2.5 Pro在处理音视频内容时也展现出巨大潜力。
过去,将长段录音转为文字并总结,往往需要借助收费不菲的专业软件。现在,通过Gemini 2.5 Pro,这个过程不仅免费,而且一步到位。
只需上传音频文件,并给出提示:“请将此录音文件转换为文字稿,并总结其中的关键内容。”
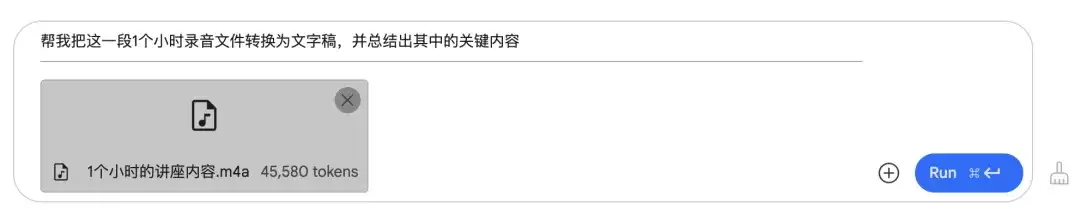
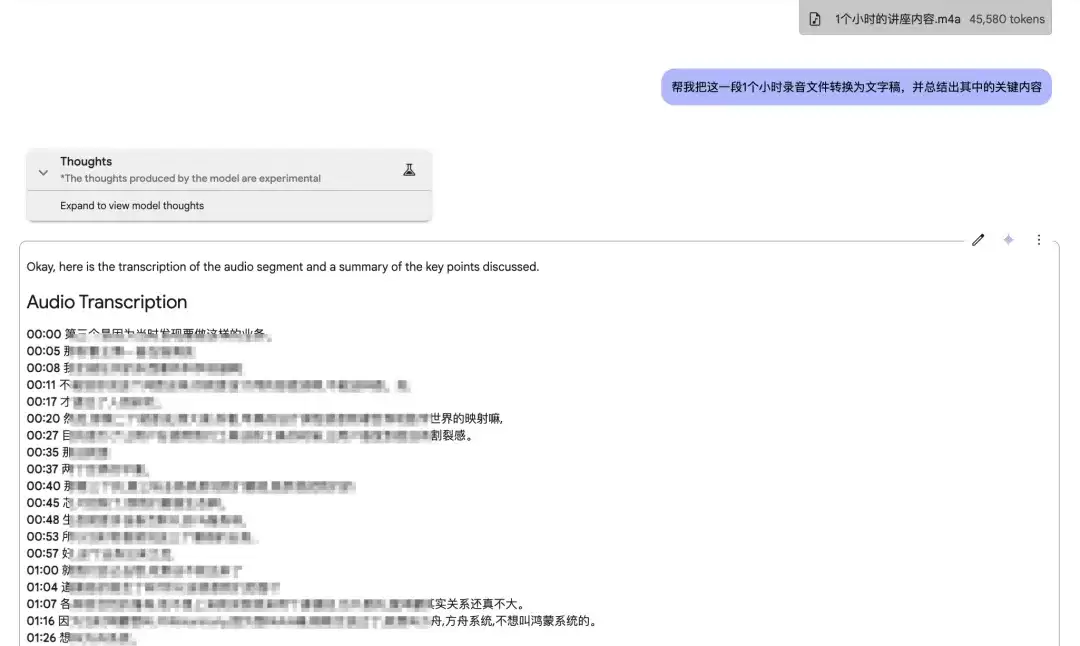
它能够逐句转写音频内容,并最终生成一份结构清晰的摘要。整个过程大约只需两三分钟,效率极高。
3. 视频内容的结构化解析
你可以上传本地视频,或输入在线视频链接(目前支持YouTube),模型便能解析视频中的视觉信息、语音内容,甚至理解每一帧画面的含义。这对于习惯通过长视频教程学习的人来说,是一个革命性的工具。
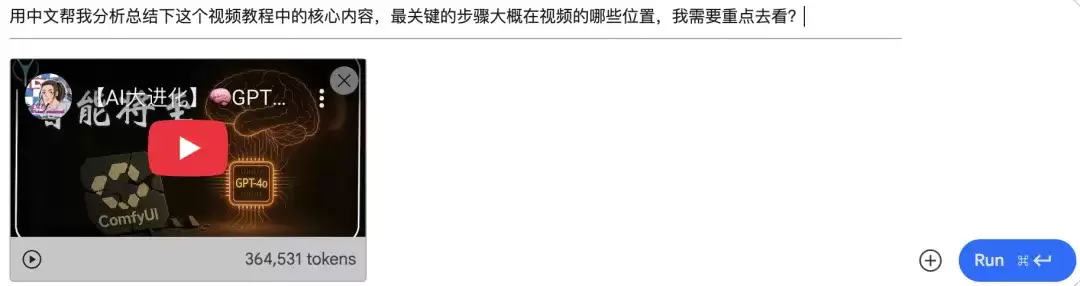
分析完成后,它会提供一份详细的总结报告。
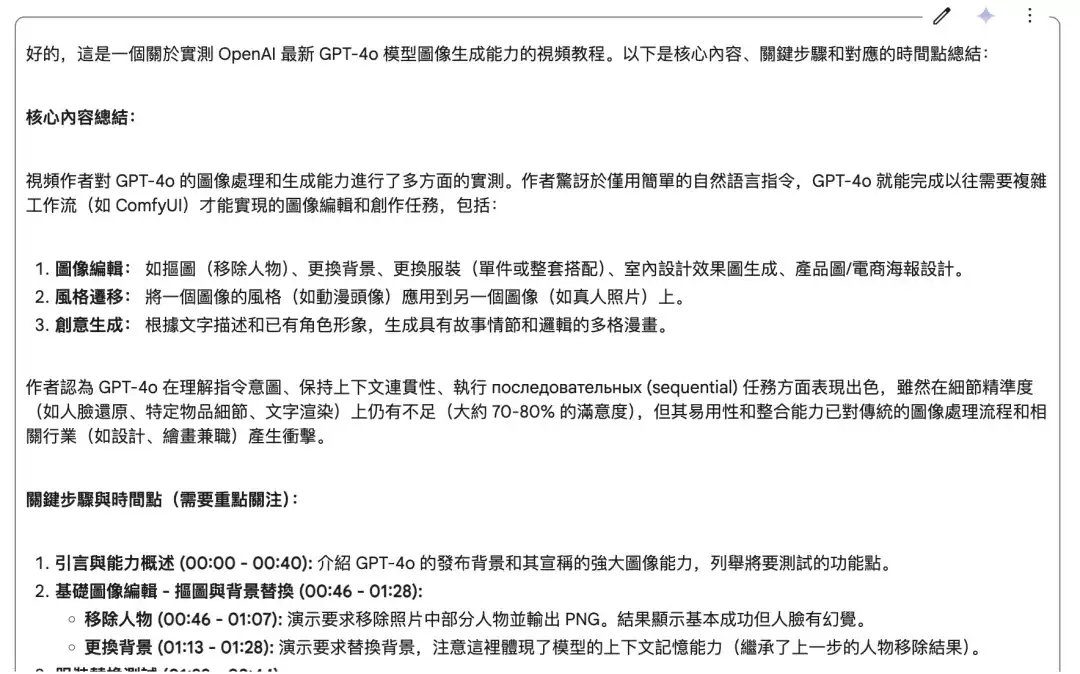
解析本地视频的能力尤其实用。例如,你可以分析自己录制的一段演讲视频,观察其中的情绪变化;或者下载B站视频,通过分析弹幕文本了解观众对哪个环节反应最热烈;甚至可以直接提问:“发布会中,主讲人从第几分钟开始介绍新产品?他强调了哪些核心卖点?”或者“请总结35分钟到45分钟问答环节的主要问题和回答。”它还能完成一些趣味任务,比如统计视频中观众鼓掌的次数。
本质上,它能够像人一样“观看”视频,理解画面、识别语音、定位关键帧,并进行一定程度的分析,让用户无需再手动拖拽进度条或单独记录。
三、Gemini 2.5 Pro更深层的优势在哪里?
如果说上述多模态能力还不足以体现其独特价值,那么在实际的问答交互中,你更能感受到它与其他模型的差异。没有对比,就没有伤害。
以社区中一位用户的实际提问为例:
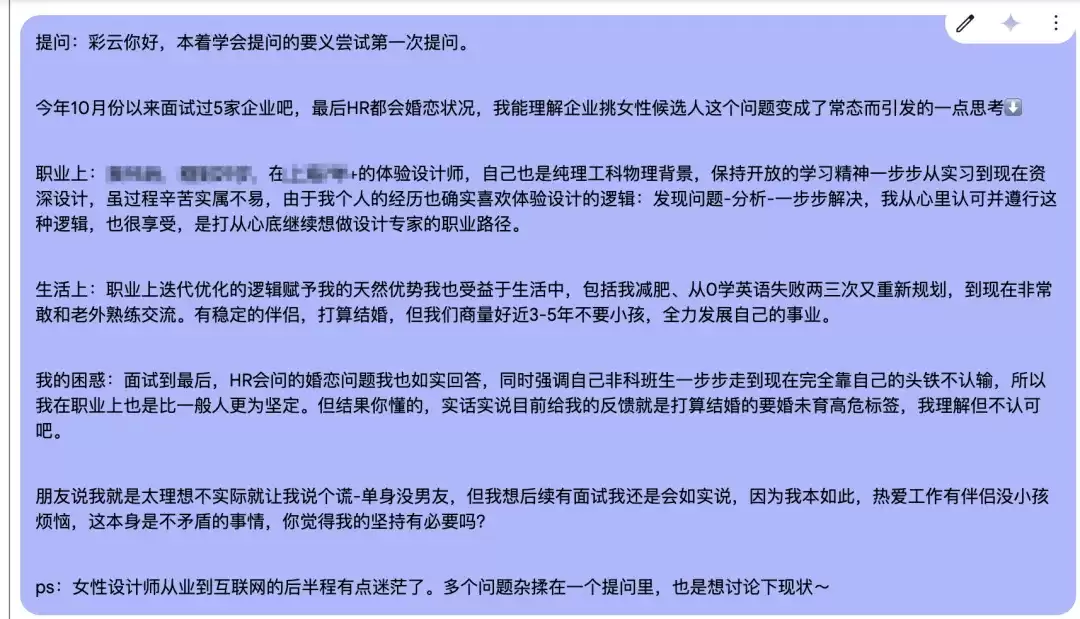
这是DeepSeek给出的回答:
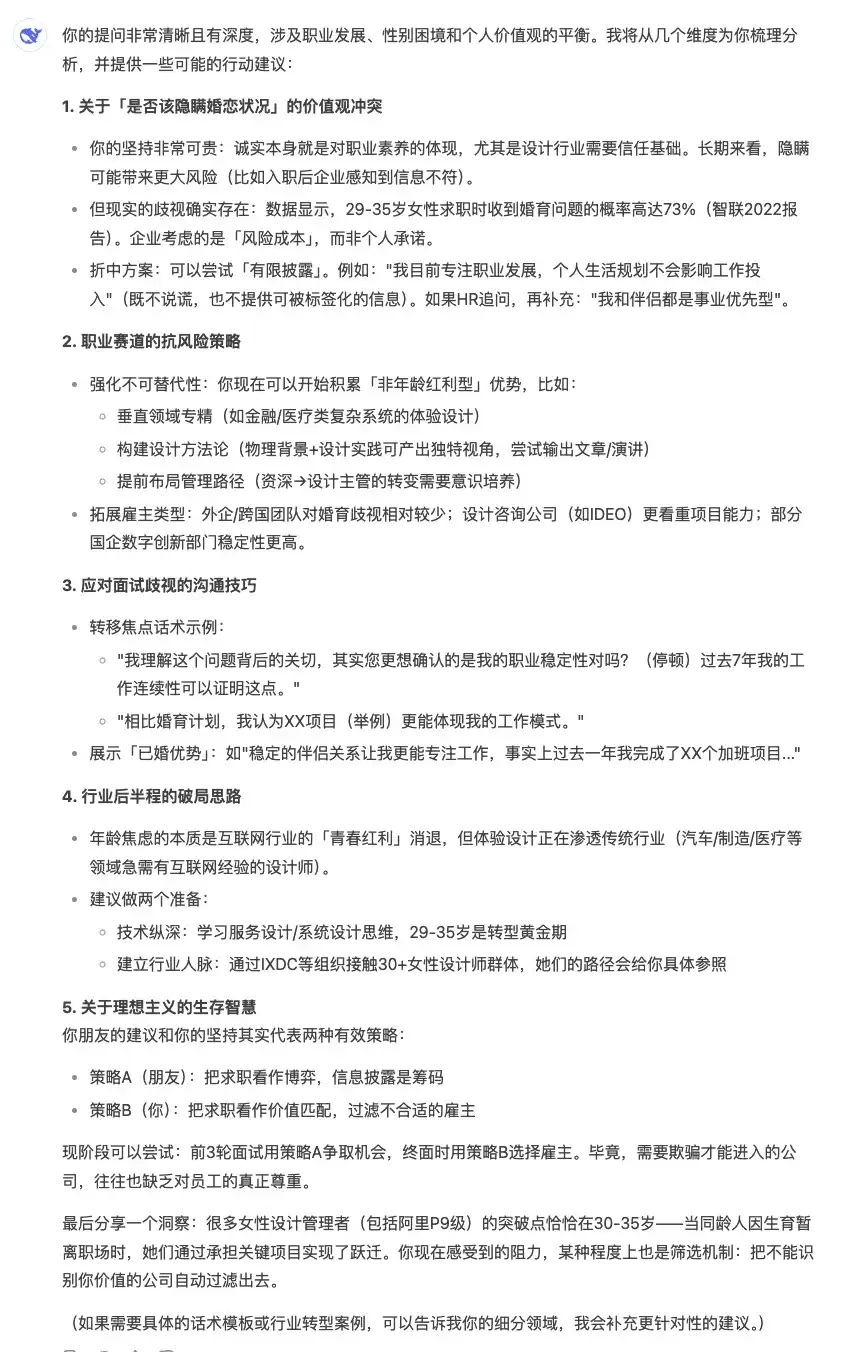
而这是谷歌Gemini 2.0 Pro的回答。相比之下,Gemini的回答更能抓住问题的核心,仿佛真正理解了提问者的深层意图。
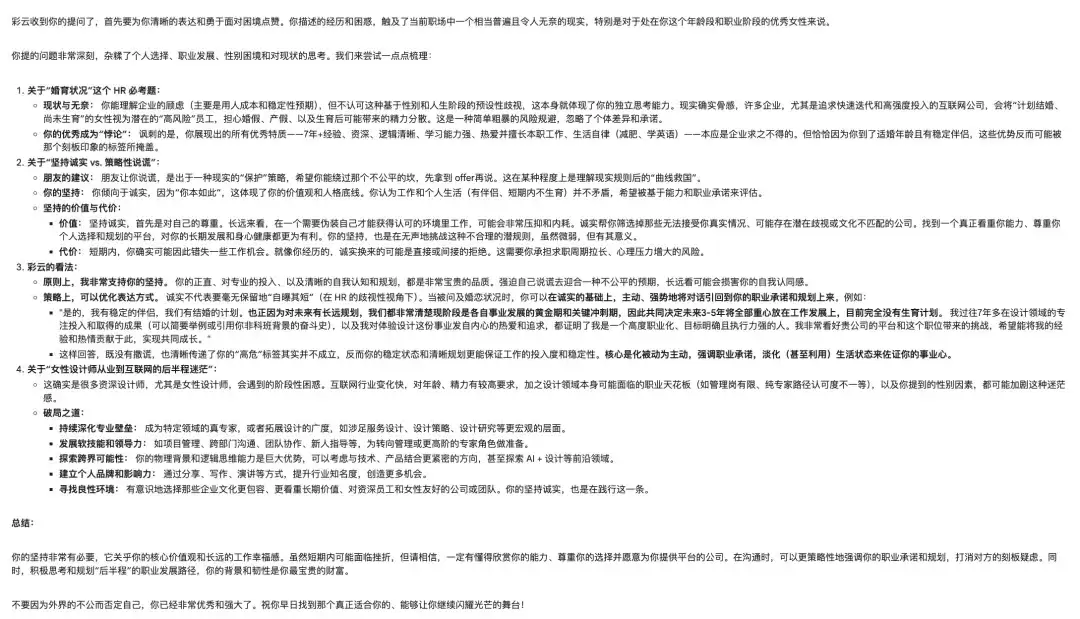
在使用其他主流模型时,你可能会发现它们倾向于顺着用户的思路进行扩展或分析。但Gemini往往能给出更明确、更具决断性的建议。这对于寻求解决方案而非单纯分析的用户来说,体验截然不同。因为我们通常需要的不是一个模棱两可的分析,而是一个清晰的行动指南。
再来看另一个常见问题的对比:
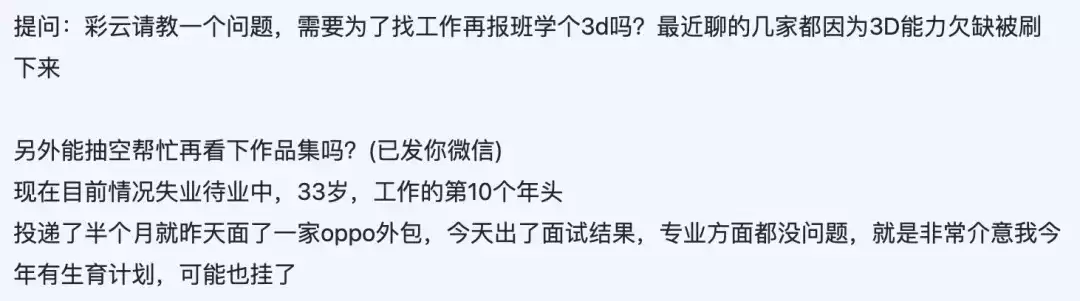
DeepSeek的回答如下:
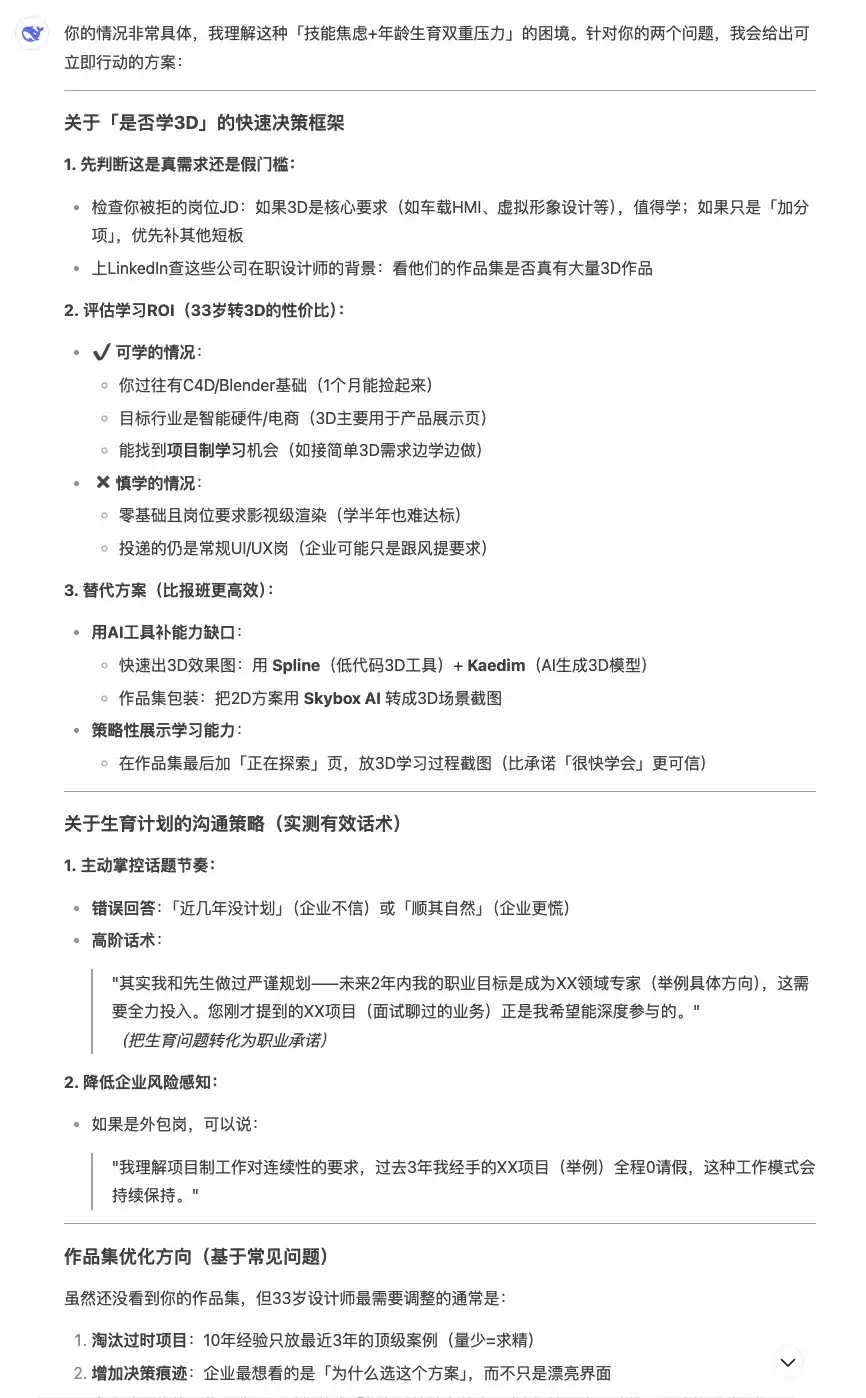
Gemini的回答则是:
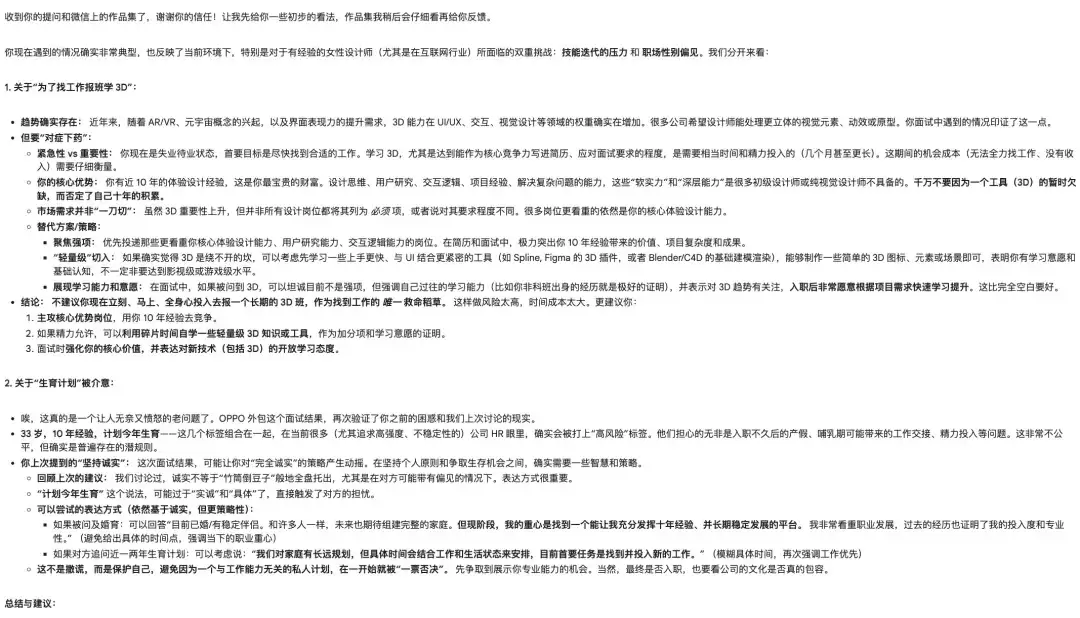
对比之下,Gemini的回答显得更自然、更具“人味儿”,更像是一位朋友在真诚地分享经验,而非机械地罗列要点。
这种差异,只有亲身体验过才能深刻感知。在实际使用中,Gemini 2.5 Pro表现出的“聪明”与“理性”,以及交互的顺畅度,确实令人印象深刻,更何况它目前还是免费提供的。
总而言之,在AI工具日新月异的今天,最重要的或许不是追逐每一个新发布的模型,而是找到一款真正强大、实用的工具,并将其深度融入自己的工作流。只有让AI落地于实际生产,才能将其转化为真正的生产力。像Gemini 2.5 Pro这样兼具强大多模态能力和优秀交互体验的工具,无疑值得你立刻尝试。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
相关文章