

索引是什么?有什么好处? 如果把数据库比作一本厚厚的书,那么索引就是这本书的目录。没有索引的时候,数据库查找数据就像从第一页开始逐页翻找,这就是所谓的“全表扫描”,其时间复杂度是 O(N),数据量一大,效率就会直线下降。 而有了索引,查找过程就变成了先在目录里定位章节,再翻到具体页码。在MySQL中
MySQL索引分类、最左匹配与失效场景详解
作者:技术拾光
时间:2026-05-19
浏览:102
文章目录
索引是什么?有什么好处?
如果把数据库比作一本厚厚的书,那么索引就是这本书的目录。没有索引的时候,数据库查找数据就像从第一页开始逐页翻找,这就是所谓的“全表扫描”,其时间复杂度是 O(N),数据量一大,效率就会直线下降。
而有了索引,查找过程就变成了先在目录里定位章节,再翻到具体页码。在MySQL中,索引通常采用B+树数据结构,其搜索复杂度为 O(logdN),其中 d 是节点允许的最大子节点数。这意味着,即使面对海量数据,查询也能保持极高的效率。
讲讲索引的分类是什么?
MySQL的索引可以从不同维度进行分类,主要分为以下4类:
- 按数据结构分:B+Tree索引、Hash索引、Full-text索引
- 按物理存储分:聚簇索引(主键索引)、辅助索引(二级索引)
- 按字段特性分:主键索引、唯一索引、前缀索引、普通索引
- 按字段个数分:单列索引、复合索引(联合索引)
按数据结构分
这是理解索引底层工作原理的关键。MySQL主要支持三种数据结构:
B+Tree索引:这是InnoDB引擎的默认索引类型,也是应用最广泛的。它的结构设计非常巧妙:
- 对于聚簇索引:非叶子节点存储索引键值(如主键ID)和指向下一层节点的指针;叶子节点则直接存储完整的行数据。所以,找到叶子节点,就等于找到了整行数据。
- 对于二级索引:非叶子节点存储索引键值(如`name`字段的值)和指针;叶子节点存储的是索引键值和对应的主键值。这意味着,通过二级索引找到叶子节点后,只能拿到主键,还需要根据这个主键回到聚簇索引中查找完整数据,这个过程称为“回表”。
Hash索引:其底层是哈希表,通过键值对实现。它的特点是查找单个元素极快,接近O(1),但只能做精确的等值查询,不支持范围查询(如`>`、`<`、`BETWEEN`)或模糊查询(`LIKE`)。目前主要是Memory引擎支持。
Full-text索引:即全文索引,底层是倒排索引。它专为自然语言搜索设计,适用于大段文本内容的搜索,可以根据关键词定位到文档ID。需要注意的是,它不支持普通的`=`或`LIKE`查询。
什么是倒排索引? 简单来说,它是一种“根据关键词查找其所在位置”的映射表。比如,我们想在一堆文章中找包含“数据库”这个词的,正排索引是“文章A -> 关键词1,关键词2...”,而倒排索引则是“数据库 -> 文章A,文章C...”,这样搜索效率就高多了。
| 特性 | Hash 索引 | Full-Text 索引 |
|---|---|---|
| 核心设计 | 精确匹配(等值查询) | 自然语言搜索(关键词匹配) |
| 典型查询 | WHERE col = "abc" |
WHERE MATCH(col) AGAINST("关键词") |
| 不支持 | 范围查询(>、<、BETWEEN)模糊查询( LIKE) |
普通的 = 或 LIKE 查询(效率极低) |
| 底层算法 | 哈希表 | 倒排索引(Inverted Index) |
| 主要用途 | 高性能的简单键值查询 | 搜索引擎风格的内容搜索 |
| 引擎支持 | 主要是 Memory 引擎 | 仅 InnoDB、MyISAM 引擎 |
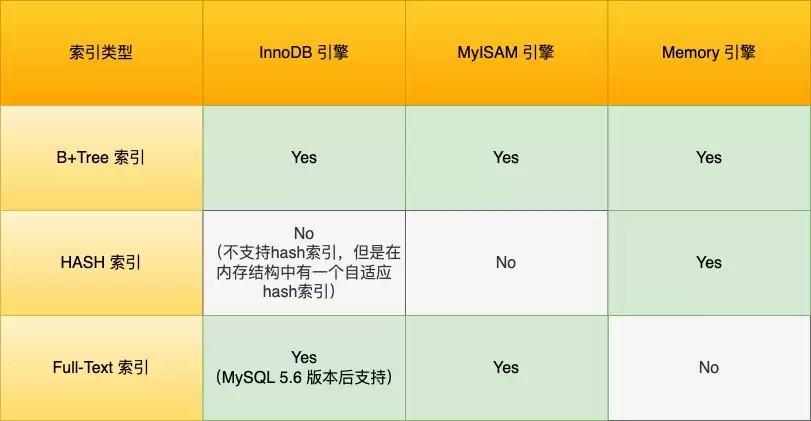
默认的InnoDB引擎在建表时会根据以下规则自动选择聚簇索引的键:
1. 如果建表时定义了主键,则主键作为聚簇索引。
2. 如果没有主键,则选择第一个不为NULL值的唯一列作为聚簇索引。
3. 如果以上两者都没有,InnoDB会隐式创建一个默认的自增ROWID作为聚簇索引。
请注意:创建的主键索引和二级索引,默认使用的都是B+Tree索引。
按物理存储分
这个分类关注的是数据在索引中是如何存储的:
- 聚簇索引(主键索引):其B+Tree的叶子节点直接存放完整的行数据。一张表有且仅有一个聚簇索引。
- 辅助索引(二级索引):其B+Tree的叶子节点存放的是主键值,而不是实际数据。一张表可以有多个二级索引。
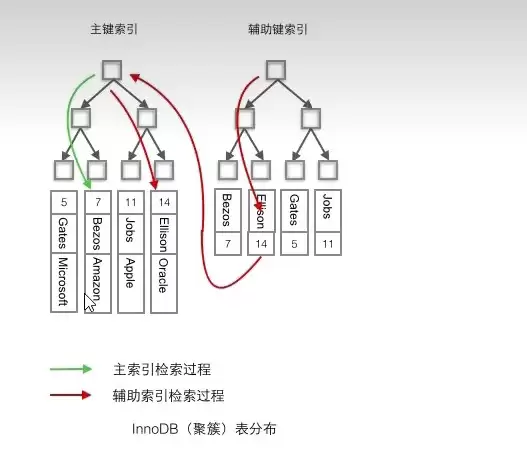
这里引出一个重要的性能概念:覆盖索引与回表。如果查询所需的数据列全部包含在二级索引的键值中(例如,索引是`(name, age)`,查询`SELECT name, age`),那么数据库直接在二级索引的叶子节点就能拿到结果,无需再去主键索引查找,这就是覆盖索引,效率极高。反之,如果需要的数据不在二级索引中,就需要先查二级索引拿到主键,再根据主键去聚簇索引查完整数据,这个多出来的步骤就是回表,会增加IO开销。
按字段特性分
顾名思义,这是根据字段本身的约束或需求来建立的索引:
主键索引:建立在主键字段上。
唯一索引:建立在要求值唯一的列上。
前缀索引:只对字段的前几个字符建立索引。
普通索引:建立在没有特殊约束但需要加速查询的列上。
主键索引创建:一张表最多一个,列值不允许为空。
CREATE TABLE table_name (
  ....
  PRIMARY KEY (index_column_1) USING BTREE
);
唯一索引创建:一张表可以有多个,列值必须唯一但允许为空。
CREATE TABLE table_name (
  ....
  UNIQUE KEY(index_column_1,index_column_2,...)
);
-- 或建表后创建
CREATE UNIQUE INDEX index_name
ON table_name(index_column_1,index_column_2,...);
普通索引创建:最常用的索引,对字段无特殊要求。
CREATE TABLE table_name (
  ....
  INDEX(index_column_1,index_column_2,...)
);
-- 或建表后创建
CREATE INDEX index_name
ON table_name(index_column_1,index_column_2,...);
前缀索引创建:适用于`char`、`varchar`等文本类型,只索引前N个字符,目的是节省空间并提升效率。
CREATE TABLE table_name(
    column_list,
    INDEX(column_name(length))
);
-- 或建表后创建
CREATE INDEX index_name
ON table_name(column_name(length));
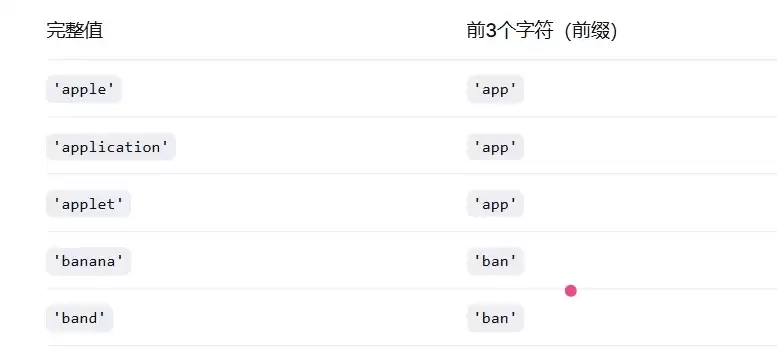
举个例子来理解前缀索引的查找过程:假设在`articles`表的`content`字段上建立了一个长度为3的前缀索引。
执行查询:
SELECT * FROM articles WHERE content = 'apple';
数据库的查找步骤是:
- 计算查询值的前缀:取`'apple'`的前3个字符 → `'app'`。
- 在索引中找`'app'`:定位到前缀索引中`'app'`这个键。
- 拿到对应的主键列表:假设`'app'`对应ID 1, 2, 3。
- 回表查完整数据:去聚簇索引取出ID为1, 2, 3的完整行数据。
- 再过滤一遍:在内存中比较这些行的`content`完整值,只返回真正等于`'apple'`的那一行(ID 1)。
按字段个数分类
分为单列索引和联合索引(也叫复合索引)。
- 单列索引:只基于一个字段建立的索引。
- 联合索引:将多个字段组合成一个索引。例如,将商品表的`product_no`和`name`字段组合:`(product_no, name)`。
CREATE INDEX index_product_no_name ON product(product_no, name);
联合索引的底层B+树结构,其叶子节点是双向链表。它的排序规则是:先按第一个字段排序,第一个字段相同的情况下,再按第二个字段排序,以此类推。
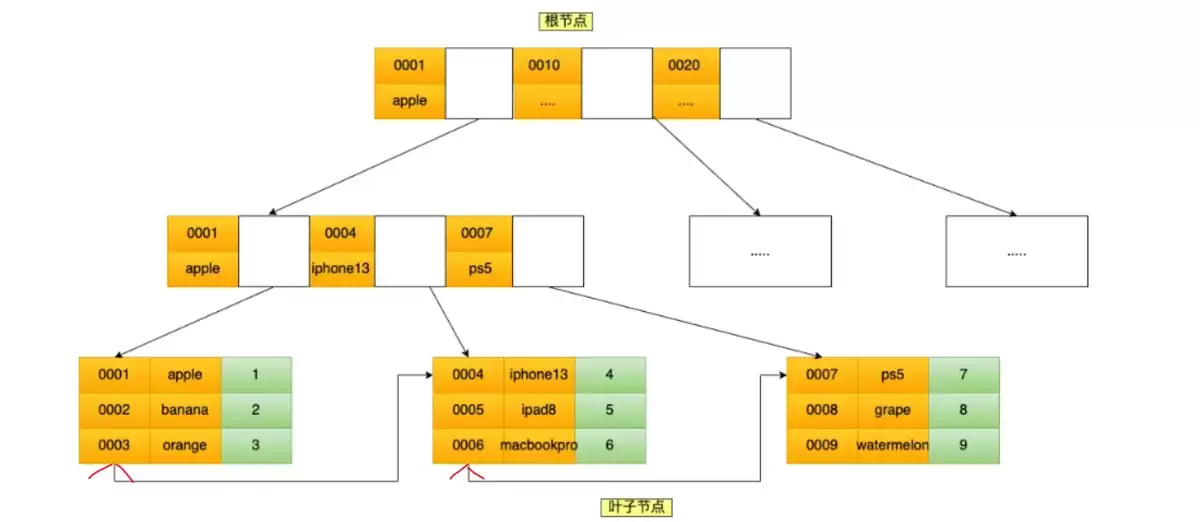
因此,在联合索引`(product_no, name)`中查询时,会先按`product_no`比较,在`product_no`相同的情况下再按`name`比较。
最左匹配原则
这是使用联合索引时必须遵循的核心原则:查询条件必须从索引的最左列开始,并且不能跳过中间的列。
假设创建了一个`(a, b, c)`联合索引,以下查询可以匹配上索引:
- `where a=1`
- `where a=1 and b=2`
- `where a=1 and b=2 and c=3`
- `where b=2 and a=1 and c=3`(查询优化器会调整顺序,只要最左列`a`存在即可)
但是,以下查询因为不符合最左匹配原则,无法使用该联合索引:
- `where b=2`
- `where c=3`
- `where b=2 and c=3`
原因在于,`(a, b, c)`索引是先按`a`全局有序,在`a`相同的情况下`b`才局部有序,`b`相同的情况下`c`才局部有序。如果查询条件不包含`a`,那么`b`和`c`在全局范围内就是无序的,无法利用索引的有序性进行快速查找。
另外,如果查询条件超出了索引列的范围,超出的部分自然无法使用索引。例如,索引是`(a, b, c)`,查询条件是`where a=1 and b=2 and c=3 and d=4`,那么只有`a, b, c`三列能用到索引,`d`列用不到。
失效情况
联合索引的最左匹配原则还有一个需要注意的细节:如果查询中间出现了范围查询(如`>`、`<`、`BETWEEN`、`LIKE`),那么范围查询列之后的索引列将无法再用于排序和过滤。
举例说明,假设联合索引是`(a, b, c, d)`,查询条件是:
WHERE a = 1 AND b > 2 AND c = 3 AND d = 4
此时的索引使用情况是:
- `a = 1` → 用到索引(等值查询,精准定位到`a=1`的范围)。
- `b > 2` → 用到索引(范围查询,可以确定`b`的起始边界)。
- `c = 3` → 用不到索引的有序性。因为`b`是范围查询,在`b`的不同值之间,`c`的值是无序的。数据库只能在`b>2`的结果集里,再对`c`进行全量扫描过滤。
- `d = 4` → 同样用不到索引。
结论:这个查询只有`a`和`b`两个字段用到了索引进行数据筛选,`c`和`d`的过滤发生在索引扫描之后,效率会降低。
为什么会这样?因为联合索引的排序逻辑是:先按`a`排序,`a`相同按`b`排序,`b`相同按`c`排序,`c`相同按`d`排序。一旦`b`是范围查询(`b > 2`),`b`的值就不再是一个固定值,导致`b`相同的这个前提条件被打破,其后的`c`列在跨`b`范围后就不再保持有序了。
例如数据可能是这样的:
(a=1, b=3, c=1)
(a=1, b=3, c=5)
(a=1, b=4, c=2)  <-- b值变了,c相对于上一个b=3的组是无序的
(a=1, b=4, c=8)
(a=1, b=5, c=3)
可以看到,在`b > 2`的范围内,`c`的值`1, 5, 2, 8, 3`并不是全局有序的,因此无法对`c=3`进行高效的二分查找。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
相关文章