

阿里千问发布全模态大模型 Qwen3.5-Omni 阿里千问正式发布全模态大模型 Qwen3.5-Omni。此次发布标志着大模型的能力边界正从文本、图像,向更复杂的音视频理解与实时交互领域进行实质性拓展。 Qwen3.5-Omni 核心功能亮点 Qwen3.5-Omni 具备多项先进能力,主要包括:
阿里千问发布全模态大模型 Qwen3.5-Omni,无缝理解文本、图片、音频及音视频输入
作者:技术拾光
时间:2026-05-05
浏览:273
文章目录
阿里千问发布全模态大模型 Qwen3.5-Omni
阿里千问正式发布全模态大模型 Qwen3.5-Omni。此次发布标志着大模型的能力边界正从文本、图像,向更复杂的音视频理解与实时交互领域进行实质性拓展。
Qwen3.5-Omni 核心功能亮点
Qwen3.5-Omni 具备多项先进能力,主要包括:
- 无缝理解文本、图片、音频及音视频输入,支持生成带时间戳的细粒度音视频描述。
- 在 215 项权威评测中获得 SOTA 成绩,其音频及音视频的分析、推理、对话、翻译等任务表现超越 Gemini3.1-Pro。
- 具备自然涌现的 Audio-Visual Vibe Coding 能力。
- 支持语义打断、音色克隆及语音控制,提升对话自然度。
- 支持 256K 超长上下文与 113 种语言识别,可处理长达 10 小时的音频或 1 小时的视频内容。
- 原生集成 WebSearch 和复杂 Function Call,不仅能对话,更能执行实际任务。
Qwen3.5-Omni 应用场景解析
智能视频创作与剪辑
上传视频后,Qwen3.5-Omni-Plus 可根据指令生成结构化、带时间戳的详细描述,包括人物、对话、背景音乐变化、镜头切换等细节。它还能辅助进行内容审核,并将长视频转化为可搜索、可管理的结构化笔记。
基于音视频指令生成网页与代码
根据音视频内容描述,Qwen3.5-Omni 能直接生成可运行的代码。模型自然涌现的 Vibe Coding 能力,使其能根据画面逻辑生成 Python 代码或前端原型,极大地缩短了从创意到实现的路径。
更自然的实时语音对话
与 Qwen3.5-Omni 对话体验接近真人交流。它能智能区分有效打断与背景杂音,并支持通过“小声点”、“用开心的语气说”等指令实时调节语音参数,实现更自然、更可控的交互。
个性化音色克隆
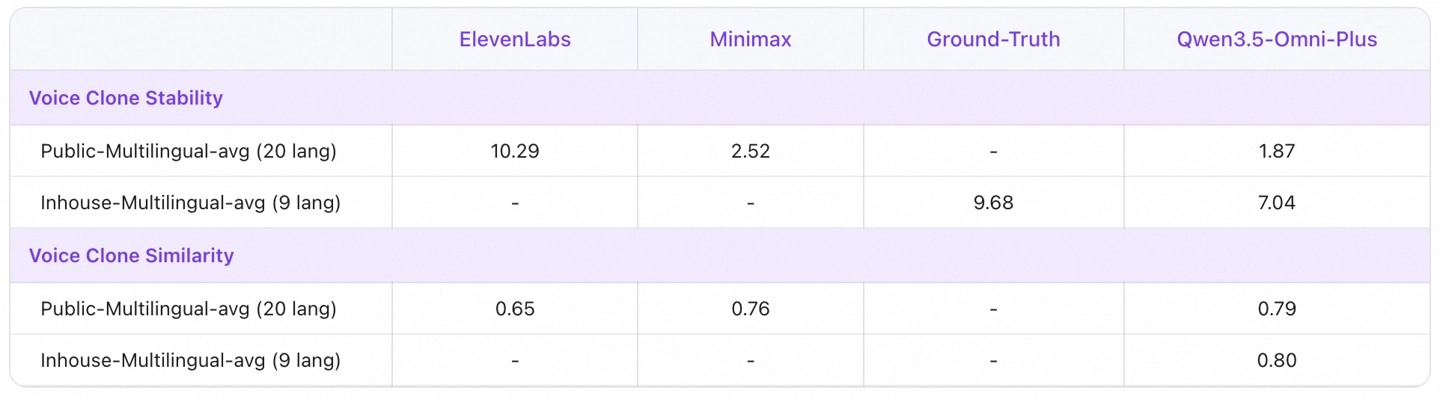
用户仅需上传一段简短录音,即可定制专属的 AI 助手音色。克隆后的音色自然稳定,支持多语言生成,可用于打造个性化的“数字分身”助手。
智能任务规划与执行
Qwen3.5-Omni 不仅能回答问题,更能处理复杂事务。例如,当被询问“明天北京天气如何,顺便推荐一家酒店”时,它能自动联网搜索、调用工具查询信息,并整合生成一份完整的建议方案。
Qwen3.5-Omni 模型能力与技术进展
相比前代模型,Qwen3.5-Omni 在长上下文支持、多语言处理及音视频深度理解等核心能力上均有显著提升。新增的语义打断、音色克隆、语音控制等功能,使人机对话体验无限逼近真人交流。结合 ARIA 技术,其语音输出的稳定性和自然度也得到进一步优化。
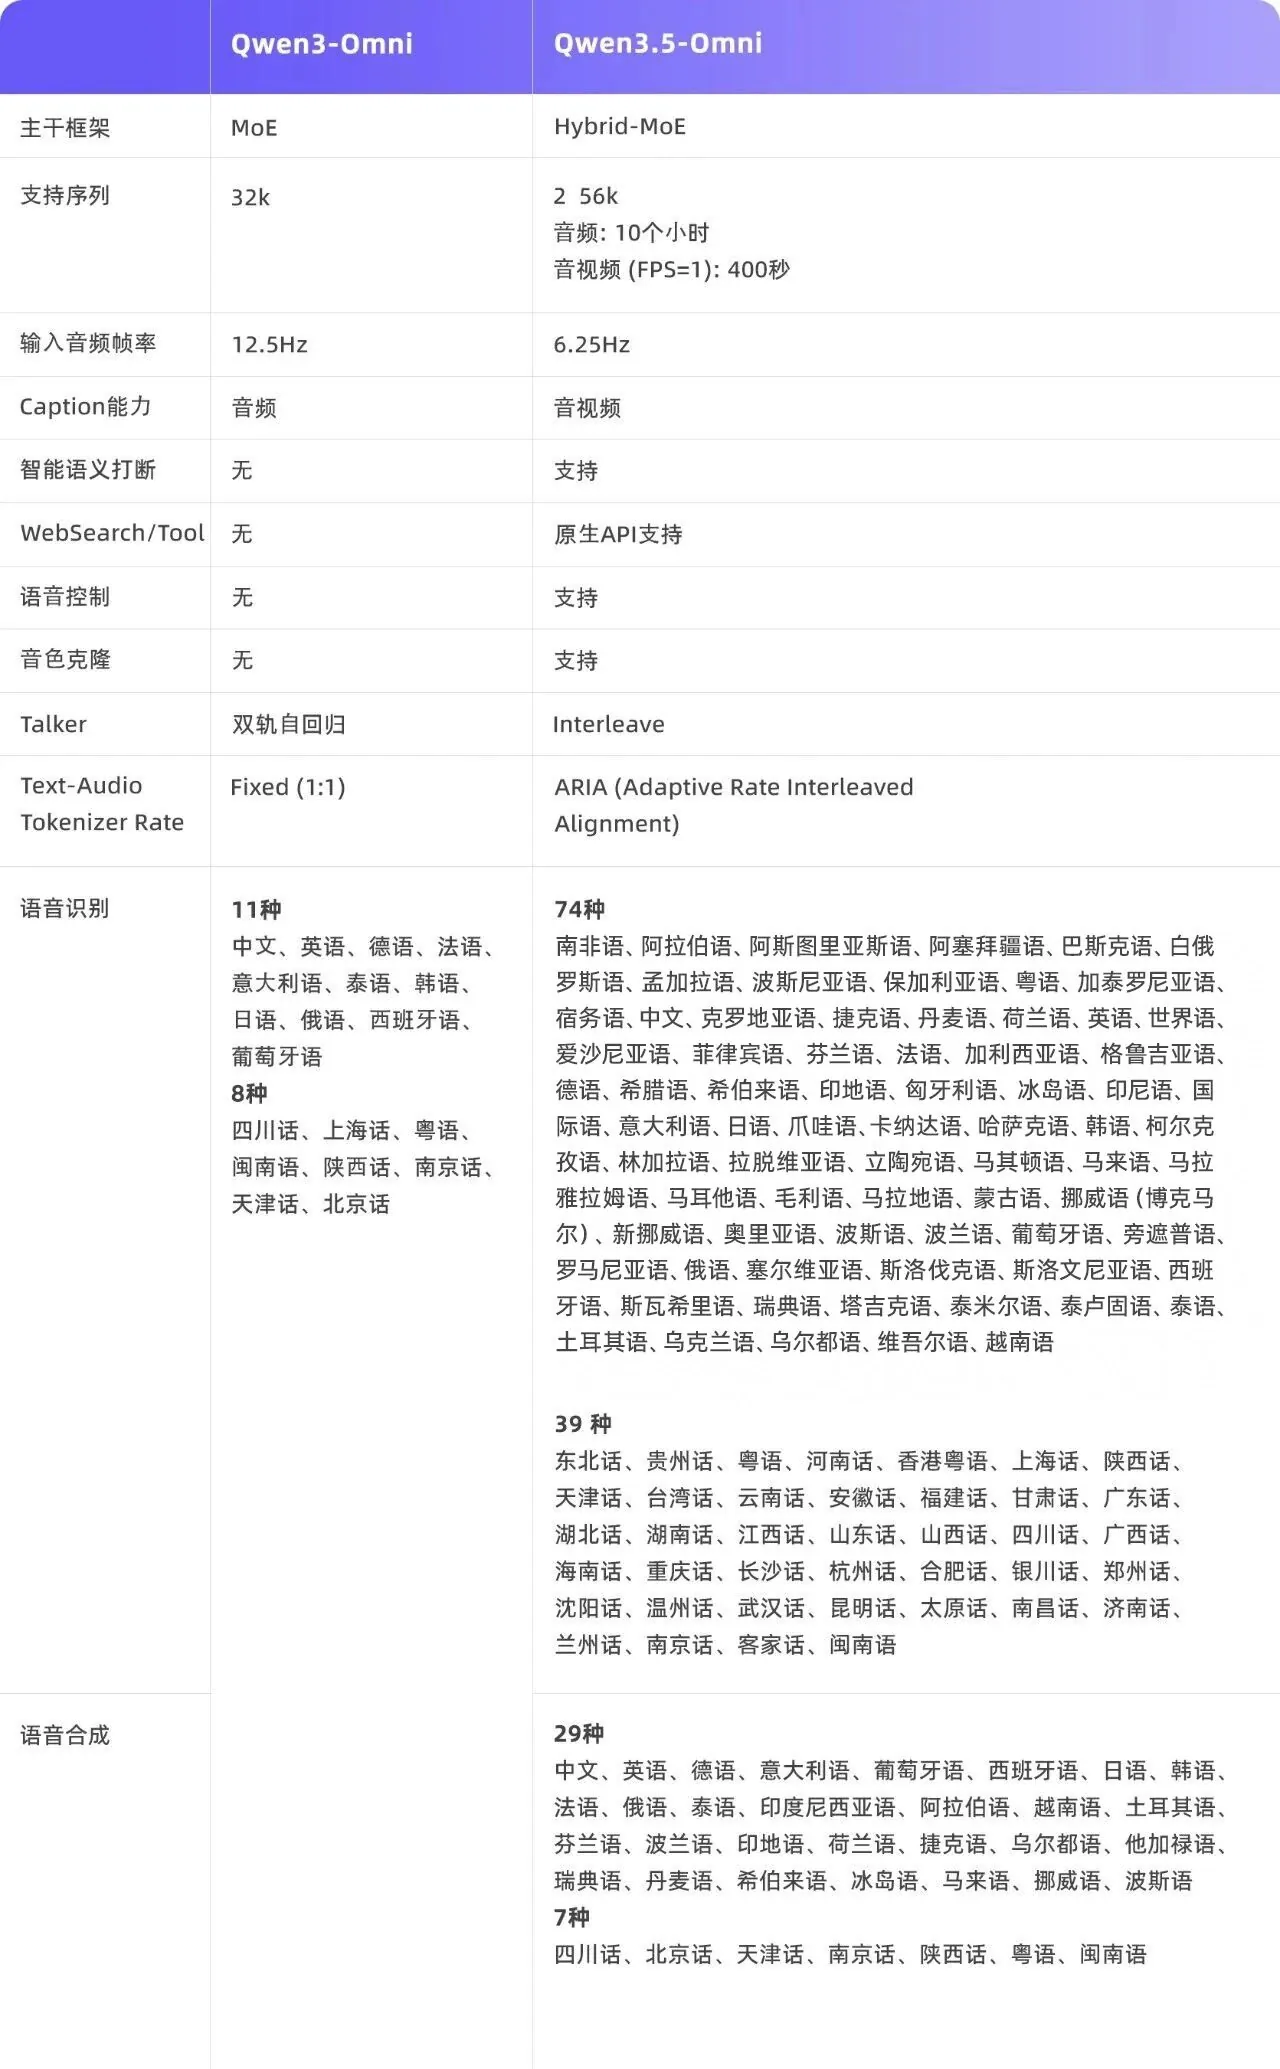
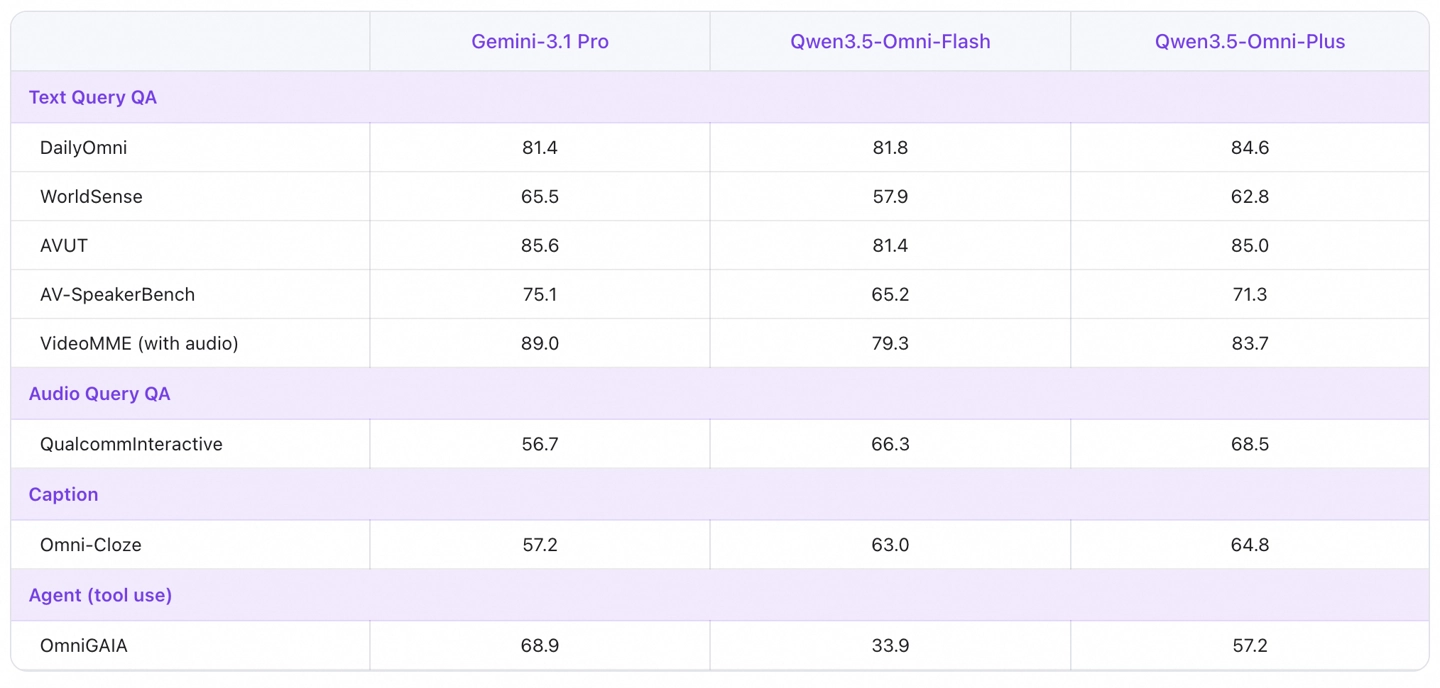
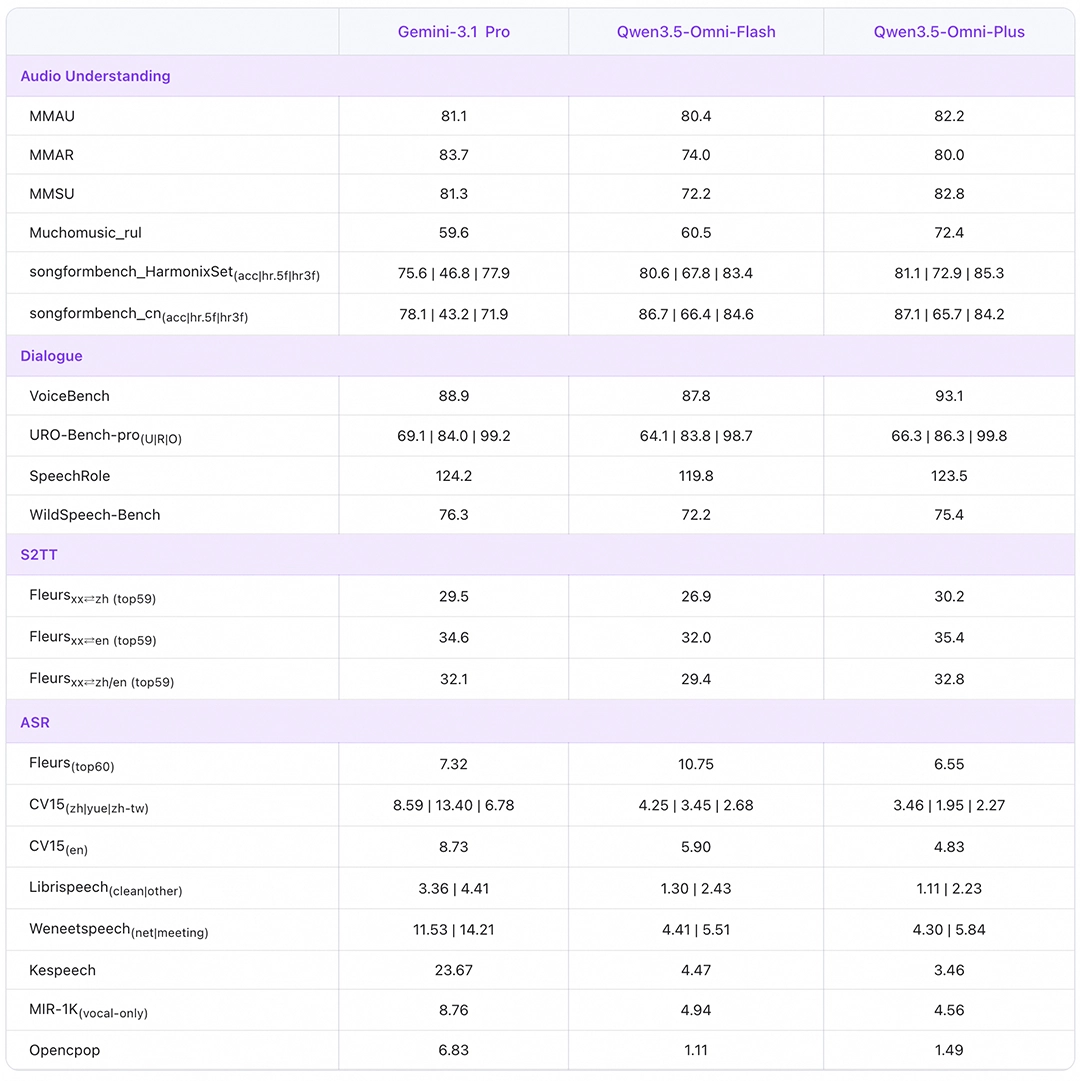
在性能表现上,Qwen3.5-Omni-Plus 版本在音频与音视频的理解、推理及交互任务中,累计取得了 215 项 SOTA 成绩,覆盖音视频理解、音频分析、语音识别、语音翻译等多个关键方向。
具体而言,其在通用音频的理解、推理、识别、翻译及对话任务上,已全面超越标杆模型 Gemini-3.1 Pro,音视频整体理解能力也达到了同等水平。该模型的视觉与文本能力则与同尺寸的 Qwen3.5 系列模型保持一致。
Qwen3.5-Omni 获取与使用
目前,开发者与用户可通过阿里云百炼平台搜索并调用 Qwen3.5-Omni 的 API。模型提供了 Plus、Flash、Light 三种不同规格版本,以灵活满足从复杂推理到轻量级应用的各种场景需求。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
相关文章