

今天咱们来探讨一个非常实际的线上问题:数据库明明已经更新成功了,但缓存删除却失败了,这时候该怎么办? 先给答案 如果你的项目里,缓存删除仅仅依赖于一句孤零零的 redis.del(key),那么数据一致性很大程度上是在“碰运气”。 一套更稳健的工程化做法,通常包含以下几个环节: 在主流程中,坚持“先
Redis删除缓存失败的原因和解决方案
作者:技术拾光
时间:2026-04-30
浏览:83
文章目录
今天咱们来探讨一个非常实际的线上问题:数据库明明已经更新成功了,但缓存删除却失败了,这时候该怎么办?
先给答案
如果你的项目里,缓存删除仅仅依赖于一句孤零零的 redis.del(key),那么数据一致性很大程度上是在“碰运气”。
一套更稳健的工程化做法,通常包含以下几个环节:
- 在主流程中,坚持“先写库,再删缓存”的顺序。
- 一旦删除失败,立即将任务丢入异步重试队列。
- 为重试设置上限,超过阈值则转入死信队列。
- 死信队列需要触发告警,并支持人工或自动补偿。
- 为整个链路打点监控,能清晰看到“删除失败率”和“补偿成功率”。
说到底,删除缓存不应该被看作一个孤立的动作,而是一条需要具备可观测性和可补偿性的完整链路。
为什么“删缓存失败”必须单独设计
很多开发者可能会想:“删失败了也没关系,下次读请求自然会回源数据库,重新加载正确的数据。”
在并发压力不大的情况下,这个逻辑看似成立。但到了线上高峰期,问题就会暴露出来:
- 热点 Key 的旧缓存依然存在,大量用户会持续读到过时的数据。
- 读流量越大,这个旧值传播得就越快、越广。
- 如果没有有效的补偿机制,这些“脏数据”可能会在缓存中存活相当长的时间。
更棘手的是,这类问题通常不会立刻引发系统报错,而是以“偶发性用户投诉”、“后台数据对不上”等形式缓慢浮现,排查定位的成本非常高。
一个真实可落地的链路
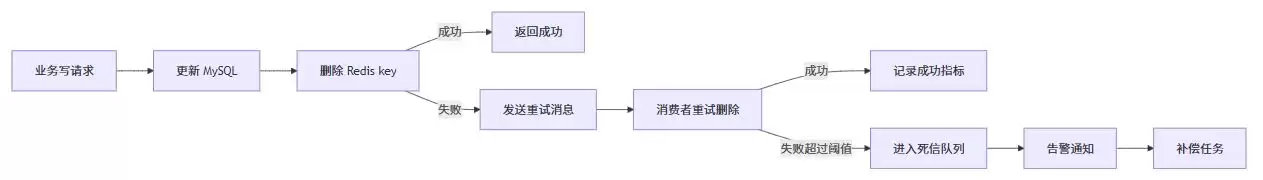
从这张图可以清晰地看到,整套方案的核心思路,已经从“如何删除”转变为“删除不掉时,如何兜底”。
代码示例:主流程 + 异步重试
1. 主流程(写库后删缓存)
@Service
public class ProductService {
    @Resource
    private ProductMapper productMapper;
    @Resource
    private StringRedisTemplate redisTemplate;
    @Resource
    private CacheDeleteProducer cacheDeleteProducer;

    @Transactional(rollbackFor = Exception.class)
    public void updateProduct(Product product) {
        String key = "product:" + product.getId();
        // 1) 数据库是事实来源,先更新
        productMapper.updateById(product);
        // 2) 主流程同步删缓存,失败则发往重试队列
        try {
            redisTemplate.delete(key);
        } catch (Exception ex) {
            cacheDeleteProducer.sendDeleteEvent(key, 1);
        }
    }
}
2. 重试消费者(指数退避 + 最大次数)
@Component
public class CacheDeleteConsumer {
    private static final int MAX_RETRY = 5;
    @Resource
    private StringRedisTemplate redisTemplate;
    @Resource
    private CacheDeleteProducer cacheDeleteProducer;
    @Resource
    private DeadLetterProducer deadLetterProducer;

    public void onMessage(CacheDeleteEvent event) {
        try {
            redisTemplate.delete(event.getCacheKey());
            // 打点:delete_success_total +1
        } catch (Exception ex) {
            int nextRetry = event.getRetryCount() + 1;
            if (nextRetry > MAX_RETRY) {
                deadLetterProducer.send(event.getCacheKey(), ex.getMessage());
                return;
            }
            long delaySeconds = (long) Math.pow(2, nextRetry); // 2,4,8,16,32秒
            cacheDeleteProducer.sendDeleteEvent(event.getCacheKey(), nextRetry, delaySeconds);
        }
    }
}
3. 死信补偿任务(定时巡检)
@Component
public class CacheDeleteCompensationJob {
    @Resource
    private DeadLetterRepository deadLetterRepository;
    @Resource
    private StringRedisTemplate redisTemplate;

    // 每 5 分钟执行一次补偿任务
    @Scheduled(cron = "0 */5 * * * ")
    public void compensate() {
        List records = deadLetterRepository.queryUnresolved(200);
        for (DeadLetterRecord record : records) {
            try {
                redisTemplate.delete(record.getCacheKey());
                deadLetterRepository.markResolved(record.getId());
            } catch (Exception e) {
                deadLetterRepository.increaseFailCount(record.getId(), e.getMessage());
            }
        }
    }
}
这 5 个细节,决定你方案能不能用
幂等性
删除缓存操作天生具备幂等性,删除一个不存在的 Key 也应视为成功,无需当作异常处理。
重试上限
切忌无限重试。必须设定明确的阈值,超过后坚决转入死信队列,否则会造成隐性的消息堆积,拖垮整个系统。
退避策略
采用固定的短间隔(比如1秒)重试,容易在Redis短暂故障时形成“重试风暴”,将其打爆。使用指数退避策略(2秒、4秒、8秒…)更为稳健。
死信可见性
死信不等于丢弃。必须配备相应的告警机制和处理面板,让运维和开发能看见、能处理。
链路监控
至少需要监控以下几个核心指标:
cache_delete_fail_total(缓存删除失败总数)cache_delete_retry_total(进入重试队列总数)cache_delete_dlt_total(进入死信队列总数)cache_delete_compensation_success_total(补偿成功总数)
常见误区
误区 1:删失败概率很低,可以忽略
线上环境总会遇到各种意外:网络瞬间抖动、Redis响应超时、连接池耗尽……这些情况并不罕见。
记住一个公式:低概率事件 × 高频请求 = 可观的事故数量。不能心存侥幸。
误区 2:有延迟双删就够了
延迟双删策略主要为了解决数据库主从延迟期间的缓存不一致问题,它无法替代针对删除操作本身失败而设计的重试补偿链路。两者解决的问题维度不同。
误区 3:死信就是失败,人工看就行
完全依赖人工监控死信队列,在深夜或节假日几乎必然会出现疏漏。理想的模式是“自动告警 + 自动补偿任务 + 人工巡检兜底”的三层防御。
选型建议(按团队规模)
| 团队阶段 | 推荐方案 |
|---|---|
| 小团队、单体服务 | 写库后删缓存 + 简单的本地重试(作为短期方案) |
| 中型团队、多服务 | 写库后删缓存 + 消息队列(MQ)异步重试 + 死信告警 |
| 大团队、高一致性要求 | 事件驱动的一致性保障 + 统一的死信处理平台 + 自动补偿任务 |
最后总结
“删除缓存失败”绝非一个可以忽略的小概率边缘场景,它恰恰是保障缓存一致性的主战场之一。
一个真正能经受住线上流量考验的方案,通常具备以下四个特征:
- 主链路要快:核心流程(写库后删缓存)必须轻量、快速。
- 失败可恢复:通过异步重试机制,消化临时性故障。
- 极端可兜底:借助死信队列和补偿任务,处理持久性故障。
- 整体可观测:具备完整的监控指标和告警,做到心中有数。
把这四件事落实到位,你的缓存一致性策略就不再是“玄学”,而是扎实的、可衡量的工程能力。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。