

本文深入解析 JavaScript 数组的底层实现机制,对比传统数组与类型化数组(Typed Arrays)在插入和读取操作上的性能差异。通过 Node.js 实测数据,揭示同质数组在现代引擎中的连续内存优化策略,以及异构数据导致的性能衰减。同时介绍 ArrayBuffer、SharedArrayBuffer 及 DataView 在高性能计算和 Web Worker 中的应用场景。
JavaScript 数组底层原理:从哈希映射到类型化数组的性能演进
本文旨在探讨 JavaScript 数组在内存管理、性能表现、语法差异及近期演进方面的技术细节,不涉及基础语法介绍或使用案例演示。
对于熟悉 C、C++ 或 C# 等语言的开发者而言,JavaScript 数组的实现机制往往带来最初的负面印象。
JavaScript 数组并非连续存储,其内部实现更接近哈希映射或字典结构。这种设计曾被视为语言层面的妥协,但随着 JavaScript 生态的发展,其实现机制与开发者认知均发生了显著变化。
JavaScript 数组与传统数组的差异
需要澄清的是,JavaScript 中的 Array 并非传统意义上的连续数组。
在深入 JavaScript 之前,首先明确“Array”的定义。
传统数组由一串连续的内存地址组成,用于存储特定类型的值。“连续”(contiguous)是这一概念的核心特征。
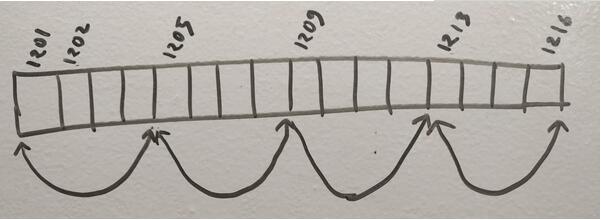
如上图所示,数组在内存中占据连续区域。以包含 4 个元素、每个元素占 4 字节的数组为例,其总内存占用为 16 字节。
假设声明 `tinyInt arr[4]`,内存起始地址为 1201。访问 `arr[2]` 时,可通过公式 `1201 + (2 * 4)` 直接计算出地址 1209,从而实现快速读取。
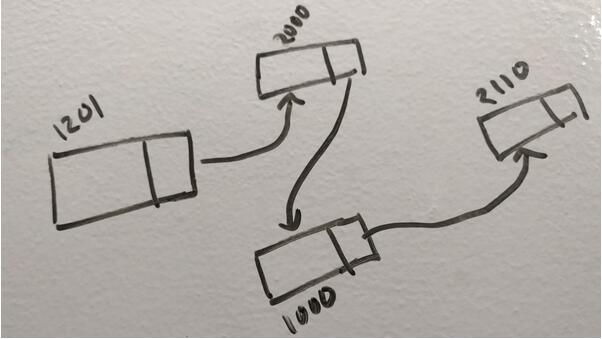
JavaScript 数组基于哈希映射实现,底层可能采用链表等数据结构。例如声明 `var arr = new Array(4)` 时,系统生成的结构如上图所示。访问 `arr[2]` 需从起始地址 1201 开始遍历寻址。
上述对比展示了 JavaScript 数组与传统数组的关键差异:直接地址计算的速度远快于链表遍历,这一优势在长数组操作中尤为明显。
JavaScript 数组的进化历程
随着硬件环境的变迁,JavaScript 数组机制也经历了显著进化。
从早期 256MB 内存的稀缺时代到如今 8GB 内存普及,硬件条件的提升为软件优化提供了基础。
类似地,JavaScript 语言本身也经历了巨大演进。从 V8、SpiderMonkey 引擎到 TC39 标准的推进,以及日益增长的 Web 用户需求,使得性能提升成为刚性需求。庞大的用户基数推动了 JavaScript 成为不可或缺的技术栈。
现代 JavaScript 引擎在数组元素类型一致(同质)的情况下,会分配连续内存。优秀的开发者通过保持数组同质性,使 JIT(即时编译器)能够采用类似 C 编译器的连续内存计算方式读取元素。
然而,若在已同质的数组中插入不同类型的元素,JIT 编译器将解构该数组,并恢复为旧有的哈希映射结构进行重建。
因此,只要代码编写规范,现代 JavaScript 数组在底层仍保持连续数组的高效形态,这对开发者至关重要。
此外,随着 ES2015(ES6)的引入,JavaScript 数组生态进一步扩展。TC39 标准引入了类型化数组(Typed Arrays),带来了 ArrayBuffer。
ArrayBuffer 提供了一块可直接操作的连续内存区域。鉴于直接操作内存过于底层且复杂,系统提供了视图(View)来处理 ArrayBuffer。目前已有多种可用视图,未来还将增加更多类型。
var buffer = new ArrayBuffer(8);
var view  = new Int32Array(buffer);
view[0] = 100;
更多关于类型化数组的详细信息,请参考 MDN 官方文档。
高性能的类型化数组在 WebGL 场景中被引入,旨在解决二进制数据处理的性能瓶颈。此外,SharedArrayBuffer 支持在多个 Web Worker 进程间共享数据,进一步提升了并发性能。
从简单的哈希映射演进至支持共享内存的 SharedArrayBuffer,这一进步显著增强了 JavaScript 的能力。
旧式数组 vs 类型化数组:性能对比
接下来对比旧式数组与类型化数组在性能上的具体表现。
前文已讨论 JavaScript 数组的演进历程,本节通过 Node.js 8.4.0 在 Mac 环境下的微型测试,量化现代数组带来的性能收益。
测试场景一:传统数组插入操作。
var LIMIT = 10000000;
var arr = new Array(LIMIT);
console.time("Array insertion time");
for (var i = 0; i < LIMIT; i++) {
arr[i] = i;
}
console.timeEnd("Array insertion time");
测试耗时:55ms
Typed Array:插入
var LIMIT = 10000000;
var buffer = new ArrayBuffer(LIMIT * 4);
var arr = new Int32Array(buffer);
console.time("ArrayBuffer insertion time");
for (var i = 0; i < LIMIT; i++) {
arr[i] = i;
}
console.timeEnd("ArrayBuffer insertion time");
测试耗时:52ms
结果显示,传统数组与 ArrayBuffer 的插入性能相近。这得益于现代编译器的优化:当元素类型相同时,传统数组内部会自动转换为连续内存数组。首个示例中,尽管使用 `new Array(LIMIT)`,实际仍按现代数组机制运行。
接着修改首个示例,将数组改为异构类型(元素类型不一致),以观察性能差异。
旧式数组:插入(异构)
var LIMIT = 10000000;
var arr = new Array(LIMIT);
arr.push({a: 22});
console.time("Array insertion time");
for (var i = 0; i < LIMIT; i++) {
arr[i] = i;
}
console.timeEnd("Array insertion time");
测试耗时:1207ms
性能差异出现在第 3 行:添加 `arr.push({a: 22})` 使数组变为异构类型。其余代码不变,但性能下降约 22 倍,直观展示了异构数据对性能的负面影响。
测试场景二:传统数组读取操作。
var LIMIT = 10000000;
var arr = new Array(LIMIT);
arr.push({a: 22});
for (var i = 0; i < LIMIT; i++) {
arr[i] = i;
}
var p;
console.time("Array read time");
for (var i = 0; i < LIMIT; i++) {
//arr[i] = i;
p = arr[i];
}
console.timeEnd("Array read time");
测试耗时:196ms
Typed Array:读取
var LIMIT = 10000000;
var buffer = new ArrayBuffer(LIMIT * 4);
var arr = new Int32Array(buffer);
console.time("ArrayBuffer insertion time");
for (var i = 0; i < LIMIT; i++) {
arr[i] = i;
}
console.time("ArrayBuffer read time");
for (var i = 0; i < LIMIT; i++) {
var p = arr[i];
}
console.timeEnd("ArrayBuffer read time");
测试耗时:27ms
结论与展望
综合上述测试,可以得出以下结论。
类型化数组的引入是 JavaScript 发展的重要里程碑。Int8Array、Uint8Array、Uint8ClampedArray、Int16Array、Uint16Array、Int32Array、Uint32Array、Float32Array、Float64Array 等视图均使用原生字节序(与本机一致)。此外,DataView 允许创建自定义视图。未来预计会出现更多基于 DataView 的库,以简化 ArrayBuffer 的操作。
JavaScript 数组的演进成果显著:现代数组兼具高速、高效与健壮性,且在内存分配上具备足够的智能性。
本文介绍了 JavaScript 数组的进化历程与性能分析,希望能为读者提供有价值的参考。如有任何疑问,欢迎留言交流,小编将及时回复。感谢大家对本站的支持!
(注:此段为原文结尾致谢,内容已自然融入 t36 或作为独立段落保留,此处按原意改写为总结性陈述)