

本文基于实际测试验证 Google 爬虫对 JavaScript 内容的处理能力。结果显示,Google 能完整执行 JS 并解析 DOM,动态插入的文本、链接及 Meta 标签均可被正常收录。测试还表明,JS 重定向在排名传递上类似 301 永久重定向,且动态生成的 nofollow 属性若执行时机过晚可能失效。理解 DOM 渲染机制对现代 SEO 至关重要。
Google 爬虫抓取 JavaScript 内容实测
我们对 Google 爬虫抓取 JavaScript 内容的机制进行了测试,并总结了以下关键发现。
许多人误以为 Google 无法处理 JavaScript,但这一观点已过时。Audette 及其同事通过一系列测试,验证了 Google 能够抓取和收录哪些类型的 JavaScript 功能。
核心结论摘要
1. 测试证实 Google 能够以多种方式执行并收录 JavaScript。Google 不仅能渲染整个页面,还能读取 DOM,从而成功收录动态生成的内容。
2. DOM 中的 SEO 信号(如页面标题、meta 描述、canonical 标签、meta robots 标签等)均被 Google 关注。动态插入 DOM 的内容同样能被抓取和收录。在某些情况下,DOM 中的内容甚至比 HTML 源码更具优先级。尽管这需要额外工作,但这仅是多个测试中的一个发现。
引言:Google 执行 JavaScript 与读取 DOM 的机制
早在 2008 年,Google 就已成功抓取 JavaScript,但当时可能仅限于特定方式。
如今,Google 不仅明确了其抓取和收录的 JavaScript 类型,还在渲染整个网页方面取得了显著进步,特别是在最近 12 到 18 个月内。
在 Merkle,我们的 SEO 技术团队旨在深入理解 Google 爬虫能抓取和收录何种类型的 JavaScript 事件。经过研究,我们发现了令人瞩目的结果:Google 不仅能执行各种 JavaScript 事件,还能收录动态生成的内容。其关键在于 Google 能够读取 DOM。
什么是 DOM?
许多从事 SEO 工作的人员并不完全理解 Document Object Model (DOM) 的概念。
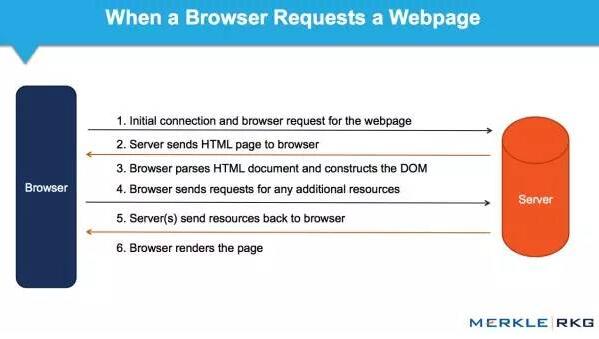
当浏览器请求页面时,DOM 在其中扮演了什么角色?
在 Web 浏览器中,DOM 本质上是一个应用程序接口 (API),用于标记和构造数据(如 HTML 和 XML)。该接口允许 Web 浏览器将这些数据组合成文档。
DOM 还定义了如何获取和操作结构。虽然 DOM 是与语言无关的 API(不绑定于特定编程语言或库),但它广泛应用于 Web 应用程序的 JavaScript 和动态内容中。
DOM 代表了接口或“桥梁”,将 Web 页面与编程语言连接起来。HTML 解析和 JavaScript 执行的结果即为 DOM。Web 页面的内容不仅仅是源码,更是 DOM。这正是其重要性所在。
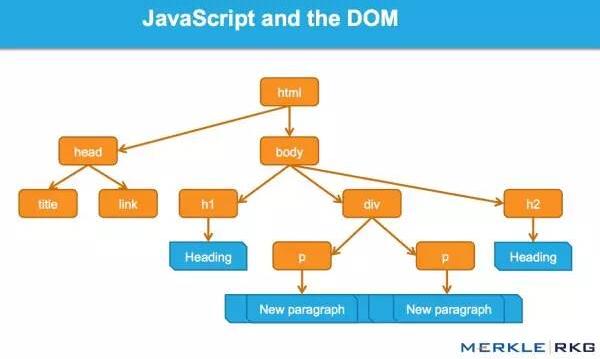
JavaScript 如何通过 DOM 接口工作
我们兴奋地发现,Google 能够读取 DOM,并解析信号和动态插入的内容,例如 title 标签、页面文本、head 标签以及 meta 注解(如 rel = canonical)。完整细节可参阅相关文档。
测试系列与结果概述
为了确定哪些 JavaScript 功能会被抓取和收录,我们针对 Google 爬虫设计了一系列测试。通过创建对照组,确保 URL 活动能被独立理解。以下我们将详细分析部分有趣的测试结果,主要分为 5 类:
1. JavaScript 重定向 2. JavaScript 链接 3. 动态插入内容 4. 动态插入 Meta 数据和页面元素 5. 包含 rel = “nofollow” 的重要案例
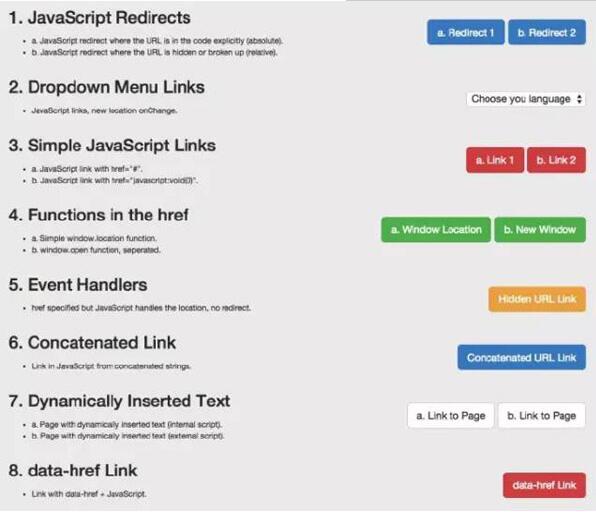
示例:用于测试 Google 爬虫理解 JavaScript 能力的页面。
JavaScript 重定向与排名传递
1. JavaScript 重定向
我们首先测试了常见的 JavaScript 重定向,观察不同 URL 表示方式的结果。我们选择了 window.location 对象进行两项测试:Test A 调用绝对路径 URL,而 Test B 使用相对路径。
结果:该重定向被 Google 快速跟踪。从收录角度看,它们被解释为 301 最终状态 URL,取代了 Google 收录中的重定向 URL。
在后续测试中,我们在一个权威网页上,利用完全相同的内容,执行了一次从原始 URL 到同一站点新页面的 JavaScript 重定向。原始 URL 当时排在 Google 热门查询的首页。
结果:果然,重定向被 Google 跟踪,原始页面未被收录。新 URL 被收录,并立即排在相同查询结果中的相同位置。这令人惊喜,从排名角度看,似乎表明 JavaScript 重定向行为(有时)类似于永久 301 重定向。
下次,当客户希望为网站实施 JavaScript 重定向时,你可能无需回答“请不要”,因为这似乎存在排名信号转移的关系。支持这一结论的依据来自 Google 指南:
使用 JavaScript 为用户进行重定向可能是一种合法做法。例如,如果你将已登录用户重定向到内部页面,可以使用 JavaScript 完成此操作。在仔细检查 JavaScript 或其他重定向方法时,请确保你的站点遵循我们的指南,并考虑其意图。记住,301 重定向跳转到你网站下是最佳选择,但如果你没有权限访问网站服务器,你可以为此使用 JavaScript 重定向。
JavaScript 链接的抓取与跟踪
2. JavaScript 链接 我们测试了多种编码方式下的不同类型 JS 链接。
我们测试了下拉菜单的链接。历史上,搜索引擎一直无法跟踪此类链接。我们希望确定 onchange 事件处理器是否会被跟踪。重要的是,这仅执行特定类型,我们需要的是其他改动后的影响,而不像上述 JavaScript 重定向那样具有强制性。
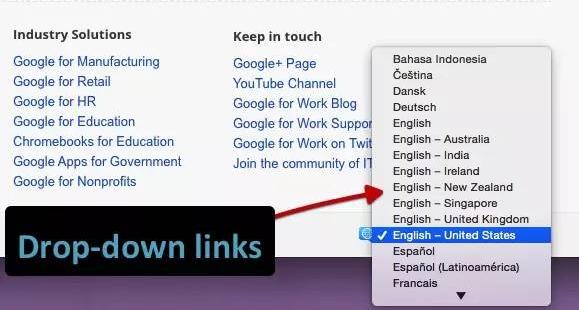
示例:Google Work 页面的语言选择下拉菜单。
结果:链接被完整抓取和跟踪。
我们还测试了常见的 JavaScript 链接。以下是常见类型的 JavaScript 链接,而传统 SEO 则推荐纯文本。这些测试包括以下 JavaScript 链接代码:
作用于外部 href 键-值对 (AVP),但在 a 标签内 (“onClick”)。
作用于 href 内部 AVP (“javascript : window.location”)。
作用于 a 标签外部,但在 href 内调用 AVP (“javascript : openlink()”)。
等等
结果:链接被完整抓取和跟踪。
我们的下一个测试进一步测试了事件处理器,如上述测试中的 onchange。具体而言,我们希望利用鼠标移动的事件处理器,然后隐藏 URL 变量,该变量仅在事件处理函数(在此案例中为 onmousedown 和 onmouseout)被触发时执行。
结果:链接被完整抓取和跟踪。
构造链接:我们知道 Google 能执行 JavaScript,但想确认它们是否能读取代码中的变量。因此在该测试中,我们连接能构造 URL 字符串的字符。 结果:链接被完整抓取和跟踪。
动态插入内容与结构化数据
3. 动态插入内容
很明显,这些都是重点:动态插入文本、图像、链接和导航。优质的文本内容对搜索引擎理解网页主题和内容至关重要。在这个动态网站时代,其重要性毋庸置疑。
这些测试旨在检查两种不同场景下动态插入文本的结果。
1). 测试搜索引擎能否统计动态插入的文本,而文本来自页面 HTML 源码内。 2). 测试搜索引擎能否统计动态插入的文本,而文本来自页面 HTML 源码外(在一个外部 JavaScript 文件内)。
结果:在两个案例中,文本都能被抓取和收录,并且页面是根据该内容进行排名。
为了了解更多相关信息,我们测试了一个通过 JavaScript 编写的客户端全局导航,而导航里的链接都是通过 document.writeIn 函数插入,并确定它们能被完全抓取和跟踪。应该指出的是:Google 能解释使用 AngularJS 框架和 HTML5 History API (pushState) 构建的网站,能渲染和收录它,并能像传统静态网页一样排名。这就是不禁止 Google 爬虫获取外部文件和 JavaScript 的重要性,而且这也许是 Google 正在从《支持 Ajax 的 SEO 指南》中移除它的原因。当你能简单地渲染整个页面时,谁还需要 HTML 快照呢?
经过测试后发现,不管什么类型的内容,都是同样的结果。例如,图像加载到 DOM 后会被抓取和收录。我们甚至做了这样一个测试:通过动态生成 data-vocabulary.org 结构数据来制作 breadcrumb (面包屑导航),并将其插入 DOM。结果呢?成功插入后的面包屑出现在搜索结果中 (search engine results page)。
值得注意的是,Google 现在推荐使用 JSON-LD 标记形成结构化数据。我敢肯定将来会出现更多基于此的东西。
动态插入 Meta 数据与页面元素
4. 动态插入 Meta 数据 & 页面元素
我们将各种对 SEO 至关重要的标签动态插入到 DOM:
Title 元素 Meta 描述 Meta robots Canonical tags
结果:在所有案例中,标签都能被抓取,其表现就像 HTML 源码里的元素一样。
一个有趣的补充实验帮助我们理解优先顺序。当存在冲突信号时,哪一个会胜出呢?如果源码里有 noindex、nofollow 标签,而 DOM 里有 noindex、follow 标签的话,将会发生什么呢?在此协议里,HTTP x-robots 响应头部的行为如何作为另一个变量?这将是未来综合测试的一部分。然而,我们的测试显示:当冲突时,Google 会无视源码里的标签,而支持 DOM。
DOM 中 nofollow 属性的处理机制
5. 一个带有 rel =“nofollow” 的重要案例
我们想测试 Google 如何应对出现在源码和 DOM 的链路级别的 nofollow 属性。我们也因此创建了一个没有应用 nofollow 的控件。
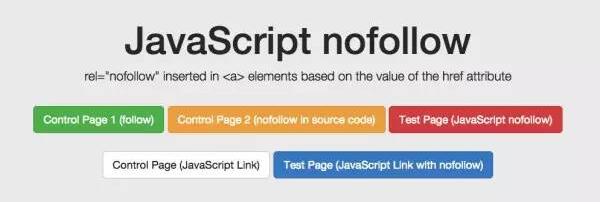
对于 nofollow,我们分别单独测试源码 vs DOM 生成的注解。
源码里的 nofollow 正如我们所期待的那样运行(链接没被跟踪)。而 DOM 里的 nofollow 却失效(链接被跟踪,并且页面被收录)。为什么?因为在 DOM 里修改 href 元素的操作发生得太晚了:Google 在执行添加 rel=”nofollow” 的 JavaScript 函数前,已准备好抓取链接和队列等待着 URL。然而,如果将带有 href =”nofollow”的 a 元素插入到 DOM,nofollow 和链接因在同一时刻插入,所以会被跟踪。
结果
从历史角度看,各种 SEO 推荐是在任何可能的时候,要尽可能专注 ‘纯文本' 内容。而动态生成内容、AJAX 和 JavaScript 链接会损害主流搜索引擎的 SEO。显然,这对 Google 不再是问题。JavaScript 链接以类似普通的 HTML 链接方式运行(这只是表面,而我们不知道幕后程序进行了什么操作)。 JavaScript 重定向都会以类似于 301 重定向方式对待。
动态插入内容,甚至 meta 标签,如 rel canonical 注解,无论在 HTML 源码,还是在最初 HTML 被解析后触发 JavaScript 生成 DOM,都以同等方式对待。
Google 似乎能完全渲染页面和理解 DOM,而不仅是源码。实在是令人不可思议!(记得允许 Google 爬虫获取那些外部文件和 JavaScript。)
Google 已经在创新方面,以惊人的速度将其它搜索引擎甩在身后。我们希望看到其它搜索引擎能有同样类型的创新。如果他们要保持竞争力,并在 Web 新时代取得实质性进展,这意味着它们要更好地支持 HTML5、JavaScript 和动态网站。
对于 SEO,那些没有理解上述基本概念和 Google 技术的人,应该好好研究和学习,以赶上当前技术。如果你不把 DOM 考虑在内,您可能会丢失一半份额。
本文所表达观点不全是由 Search Engine Land (一家搜索引擎网站)提供,部分观点是由客座作者提供。全体作者列表。