
深入解析 jQuery 与 Lodash 源码中的链式调用设计模式,对比 DOM 包装器即时求值与函数式惰性队列的实现原理、回溯栈机制及最小原型实现。

当前位置:首页 > JavaScript 对象与原型 > 正文
解析 jQuery 与 Lodash 源码中的链式调用设计模式
作者:青柠
时间:2026-11-03
浏览:186
文章目录
JavaScript 源码设计模式研读
主题:架构设计与原型模式
代码层级:生产级源码拆解
阅读时长:约 15 分钟
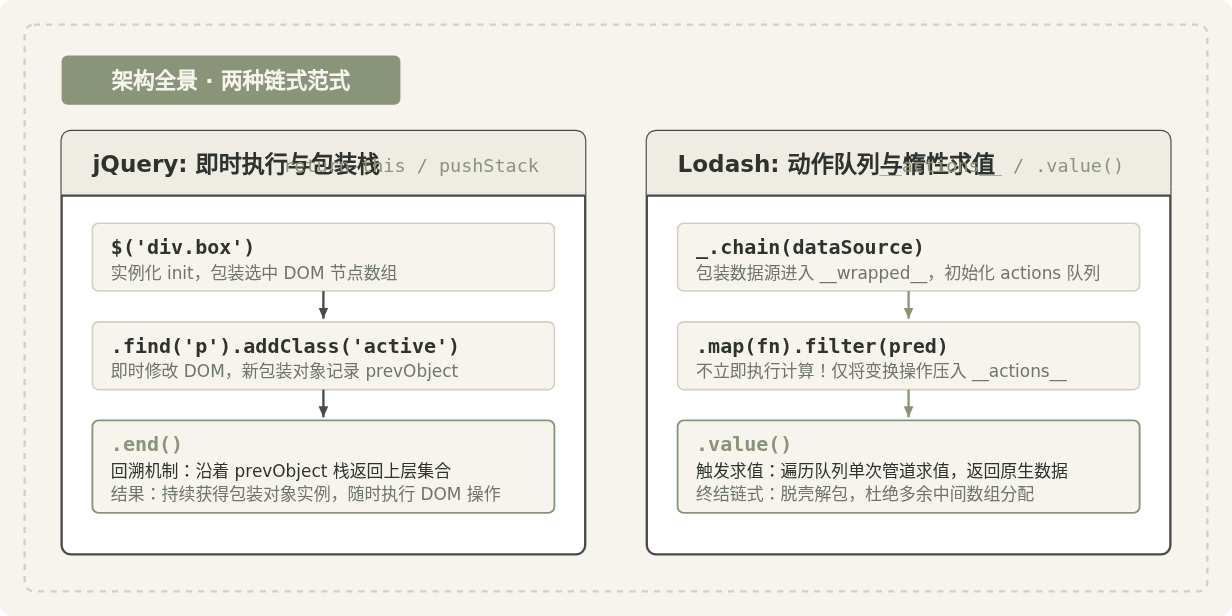
链式调用(Chaining)通过连续调用方法简化代码组织,但在底层实现上,jQuery 与 Lodash 代表了两种截然不同的架构路线:jQuery 面向 DOM 节点集合,采用“即时执行 + 包装对象栈”模式,核心依靠原型共享与
pushStack 维持操作上下文与历史回溯;Lodash 则面向纯数据变换,采用“包装器封装 + 动作队列 + 惰性求值(Lazy Evaluation)”模式,推迟计算直至显式调用 .value() 触发管道展开。本文通过剖析两者的核心源码与原型机制,还原这两种链式调用的实现细节与设计考量。
一、链式调用不仅是 return this:常见认知与设计边界辨析
在许多前端初阶读物中,“链式调用”常被一句话概括:“只需在对象的每个方法末尾写上 return this 即可”。这种解释在构建简单的对象配置器(Builder 模式)或状态累加器时确实成立,例如动画缓动设置、SQL 语句拼接器等。在这些场景中,操作对象始终是同一个实例,没有改变上下文,也不涉及复杂的状态转移。
然而,一旦进入工业级工具库的设计,单纯的 return this 就会迅速遇到瓶颈。在两类经典场景下,单纯返回当前对象会直接导致逻辑失效:
-
操作集下钻与上下文漂移:以 jQuery 的 DOM 遍历为例,当执行
$('ul').find('li')时,操作目标已经从ul节点集合切换为了子代li节点集合。如果方法直接修改当前实例内部的节点数组并return this,就会破坏原始的父级集合,导致后续无法回退到父级(即.end()失效)。 -
多类型数据流变换与中间开销:以 Lodash 对数组的处理为例,对数据执行
map、filter、take时,数据形态在不断变化。如果每一步都立即执行计算并生成全新的数组,面对十万级别的数据时,会瞬间触发多轮大数组创建与垃圾回收(GC),造成严重的内存波动。
因此,工业级库的链式设计本质上是“如何管理调用的上下文生命周期”以及“何时触发计算”。jQuery 给出的答案是“原型共享与单向链表式快照栈”,而 Lodash 给出的答案是“包装器队列与按需惰性展开”。
二、jQuery 源码解析:无 new 构造与原型共享闭环
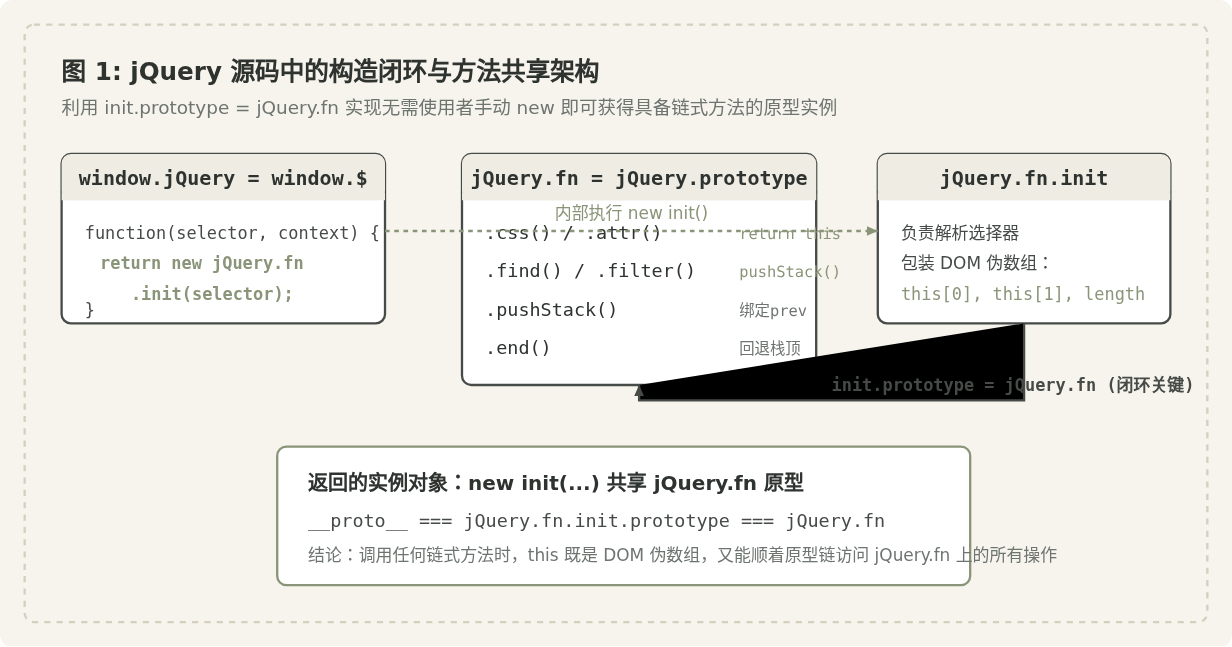
编写 jQuery 代码时,我们习惯直接调用 $('selector'),而无需写成 new $('selector')。这看似只是语法糖,但在 JavaScript 基于原型的继承模型下,却需要精巧的原型闭环设计。
若要在无 new 的情况下返回一个可以访问其实例方法的对象,最朴素的想法是在函数内 return new jQuery()。但这会导致自身无限递归爆栈。jQuery 的解决方式是引入一个辅助构造函数 init,将其作为真正的实例创建者:
// jQuery 核心架构伪代码抽取
(function(window) {
  var jQuery = function(selector, context) {
    // 每次调用 $(),实际上是实例化其原型上的 init 构造函数
    return new jQuery.fn.init(selector, context);
  };

  // jQuery.fn 是原型对象的快捷别名
  jQuery.fn = jQuery.prototype = {
    constructor: jQuery,
    // 扩展公共链式方法
    css: function(attr, val) {
      // 遍历内部 DOM 并修改属性
      for (var i = 0; i < this.length; i++) {
        this[i].style[attr] = val;
      }
      return this; // 同级修改直接返回自身
    },
    pushStack: function(elems) {
      // 栈构建逻辑,见下节
    },
    end: function() {
      // 回退逻辑,见下节
    }
  };

  // 真正的构造函数定义在原型上
  var init = jQuery.fn.init = function(selector, context) {
    if (!selector) return this;
    var nodes = document.querySelectorAll(selector);
    this.length = nodes.length;
    for (var i = 0; i < nodes.length; i++) {
      this[i] = nodes[i];
    }
    return this;
  };

  // 关键闭环:把 init 的原型指向 jQuery.fn
  init.prototype = jQuery.fn;

  window.jQuery = window.$ = jQuery;
})(window);
这里的核心点在于 init.prototype = jQuery.fn 这行赋值:
- 当用户执行
$('#main')时,底层运行了new jQuery.fn.init('#main'),生成了一个全新的init实例对象。 - 因为
init.prototype被重定向指向了jQuery.fn(即jQuery.prototype),所以新生成的实例能够无缝继承并访问挂载在jQuery.fn上的所有扩展方法。 - 该设计彻底摆脱了外部使用
new的繁琐,同时确保不同调用之间实例互相独立,各持有一份 DOM 伪数组数据(this[0],this[1],this.length)。
三、jQuery 的状态转移与回溯栈:pushStack 与 end 的实现
在 jQuery 的链式方法中,存在两类截然不同的操作:
- 同态操作(非破坏性):如
.css()、.attr()、.addClass()。这类方法只修改当前包装集中的 DOM 属性,DOM 集合本身的引用没有发生变更,方法末尾执行return this,保持当前操作链的连续性。 - 破坏性操作(过滤与衍生):如
.find()、.filter()、.children()、.eq()。这类操作筛选出了新的 DOM 节点集合。如果直接覆写当前实例,不仅打破了封装,也让历史状态荡然无存。
为了在改变目标节点的同时保留回退历史的能力,jQuery 设计了基于内部属性 prevObject 的“栈式链表”,而串联这一机制的核心函数就是 pushStack。
1. pushStack 源码剖析
查看 jQuery 源码,无论是 find 还是 filter,在匹配到新的一批节点后,最终都统一转交给了 this.pushStack():
// jQuery 内部 pushStack 实现核心
jQuery.fn.pushStack = function(elems) {
  // 1. 通过 this.constructor() 实例化一个全新的空 jQuery 对象
  var ret = jQuery.merge(this.constructor(), elems);

  // 2. 将当前调用者(旧的 jQuery 实例)挂载在新实例的 prevObject 属性上
  ret.prevObject = this;

  // 3. 返回这个包含新节点与历史指针的全新包装对象
  return ret;
};
2. end() 源码剖析
有了 prevObject 构成的回溯链,end() 的实现便极为纯粹:
jQuery.fn.end = function() {
  // 如果存在 prevObject 则返回上一个对象,若不存在(已是栈底)则返回一个空的 jQuery 对象
  return this.prevObject || this.constructor();
};
当编写如下调用链时:
$('ul.menu')            // 实例 A (内部为 ul)
  .find('li.active')    // 触发 pushStack,生成 实例 B (内部为 li),且 B.prevObject = A
  .css('color', 'red')  // 作用于 实例 B,return this (返回 实例 B)
  .end()                // 读取 B.prevObject,重新返回 实例 A
  .addClass('loaded');  // 作用于 实例 A,即 ul 节点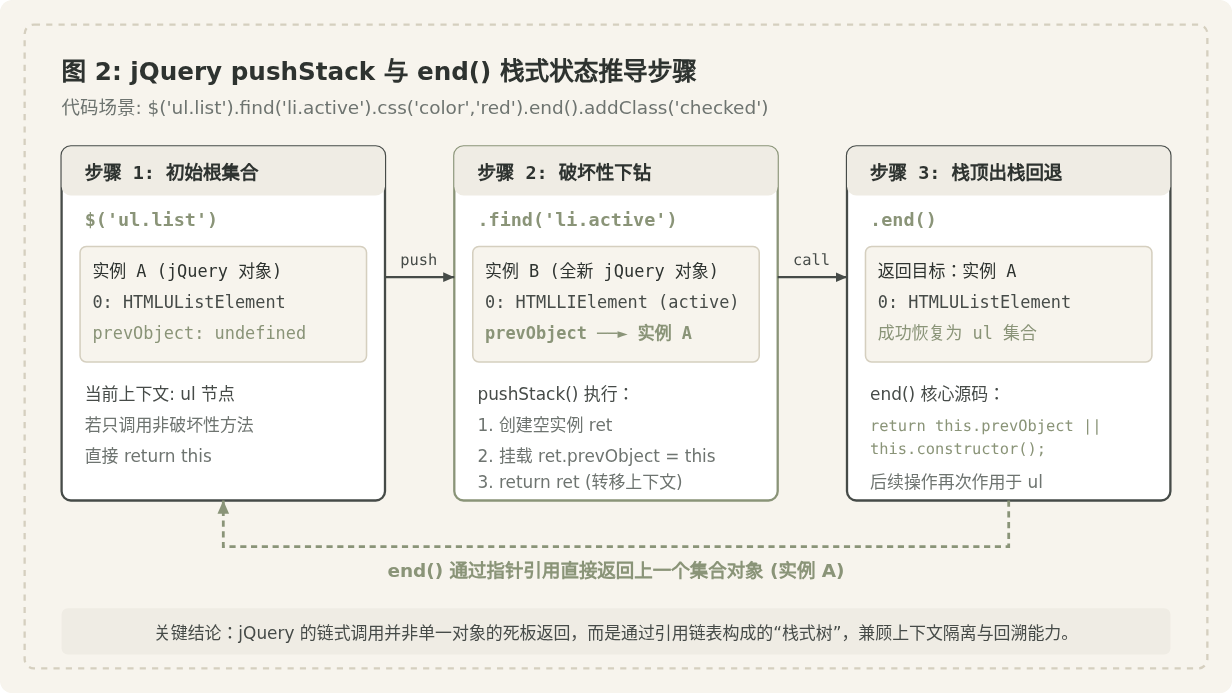
内存与垃圾回收注意点
由于每个派生出来的 jQuery 对象都通过 prevObject 持有着上一层对象的强引用,如果在大型 SPA 中长时间在全局变量或闭包中保留一个深度下钻的 jQuery 实例,整个调用链上所有历史 DOM 节点集合都无法被 V8 引擎垃圾回收。因此,避免长期缓存包含深度栈引用的局部 jQuery 结果。
四、Lodash 源码解析:包装器模式与显式/隐式链
与 jQuery 直接操作宿主 DOM 环境不同,Lodash 处理的是纯 JavaScript 数据。Lodash 的链式调用提供了两种风格:
- 隐式链式
_(value):当后续调用的方法返回非数组或复合值(如.sum()、.head())时,会自动进行“拆箱”(Unboxing),返回原始值;若返回集合,则继续保持链式。 - 显式链式
_.chain(value):无论执行什么操作,都强制保持在包装器中,必须在链末显式调用.value()才能获取计算后的原生数据。
Lodash 实现链式调用的核心载体是 LodashWrapper 构造函数。与 jQuery 类似,它也将原始输入包裹在实例属性中:
// Lodash 包装器简明源码模型
function LodashWrapper(value, chainAll) {
  this.__wrapped__ = value;   // 缓存原始输入数据
  this.__actions__ = [];      // 待执行操作队列(重点!)
  this.__chain__ = !!chainAll;// 显式链式标记
  this.__index__ = 0;
  this.__values__ = undefined;
}

// 显式链式入口
function chain(value) {
  var result = lodash(value);
  result.__chain__ = true; // 强制标记为显式链
  return result;
}
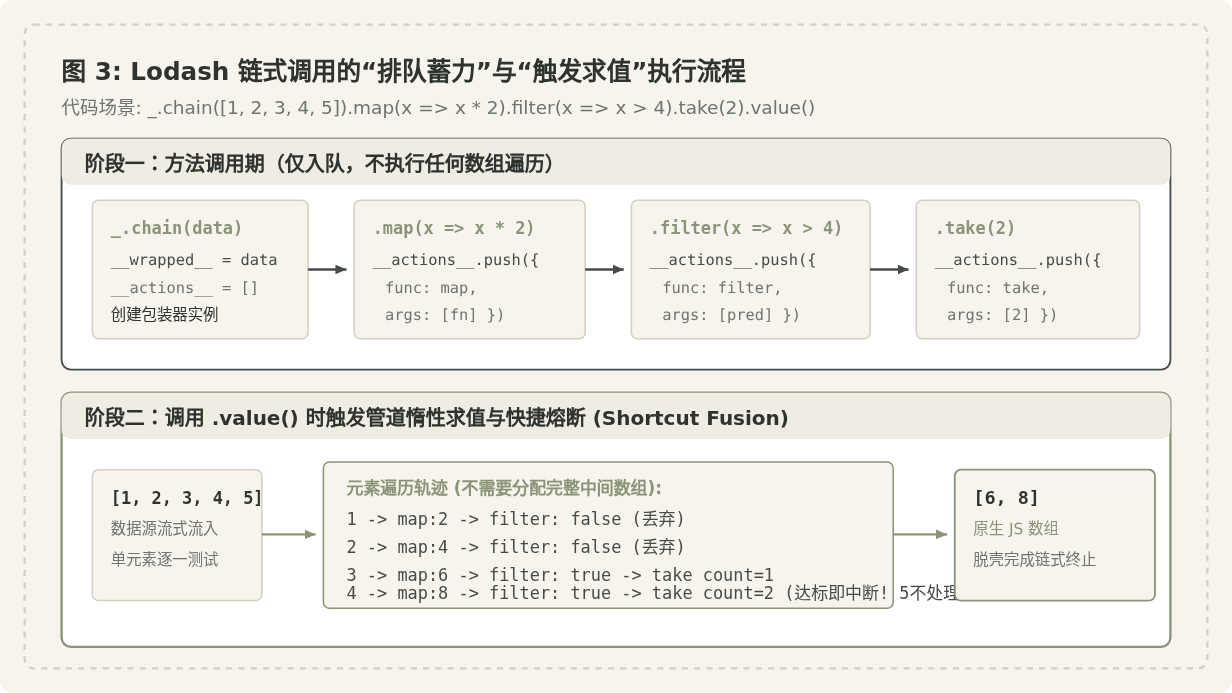
在这个数据结构中,最值得关注的是 __actions__。在 Lodash 中,当你链式调用 .map() 或 .filter() 时,它根本不会立即遍历你的数据!
五、Lodash 的惰性求值与快捷熔断(Shortcut Fusion)
为什么 Lodash 不在调用方法时立即计算?我们来看一个对比场景:
// 原生 Array 链式(即时执行,贪婪求值)
const result = bigArray
  .map(x => x * 2)       // 立即遍历产生中间数组 Array 1 (长度 N)
  .filter(x => x > 100)  // 立即遍历产生中间数组 Array 2 (长度 M)
  .slice(0, 5);          // 截取前 5 个元素
如果 bigArray 包含 100 万个元素,即使最终只需要 5 个结果,原生链式也会完整创建两次百万级长度的临时数组,产生极大的内存开销和 CPU 循环损耗。
Lodash 的链式模式则通过两个步骤解决这个问题:
1. 动作入队(Queueing)
当在链上调用方法时,Lodash 只是向 __actions__ 数组中推入一个描述该调用的任务元组:
// 链式方法挂载与动作拦截逻辑
LodashWrapper.prototype.filter = function(predicate) {
  // 并不进行实际循环过滤,而是克隆包装器并记录动作
  var result = this.clone();
  result.__actions__.push({
    func: arrayFilter,
    args: [predicate],
    thisArg: undefined
  });
  return result;
};
2. 惰性求值与快捷熔断(Shortcut Fusion)
只有当代码执行到末尾的 .value() 时,计算引擎才被激活。在 Lodash v4 内部,结合了 LazyWrapper 机制:
- 将
map、filter等操作管道化融合(Fusion); - 采用“单元素流动”替代“整数组遍历”。即:取第 1 个元素,先走
map,再走filter;通过测试则计数加一; - 一旦累计达到
take(5)所需的 5 个元素,遍历立即提前中断(Short-circuiting),后续 99 万多个元素根本不会被访问。
3. 手写极简 Lodash 惰性求值链
为了帮助透彻理解这一模式,下面实现一个不依赖任何外部代码的最小化惰性链式求值器:
class MiniChain {
  constructor(data) {
    this.__wrapped__ = data;
    this.__actions__ = [];
  }

  map(fn) {
    this.__actions__.push({ type: 'map', fn });
    return this; // 返回当前包装器以支持链式连续调用
  }

  filter(predicate) {
    this.__actions__.push({ type: 'filter', fn: predicate });
    return this;
  }

  take(limit) {
    this.__actions__.push({ type: 'take', limit });
    return this;
  }

  // 终结求值方法
  value() {
    const result = [];
    const source = this.__wrapped__;

    // 提取可能存在的截断上限
    let takeLimit = Infinity;
    for (const act of this.__actions__) {
      if (act.type === 'take') takeLimit = act.limit;
    }

    // 流式遍历每个元素,进行管道化过滤与变换
    for (let i = 0; i < source.length; i++) {
      let val = source[i];
      let pass = true;

      for (const act of this.__actions__) {
        if (act.type === 'map') {
          val = act.fn(val);
        } else if (act.type === 'filter') {
          if (!act.fn(val)) {
            pass = false;
            break; // 未通过过滤器,提前丢弃当前元素
          }
        }
      }

      if (pass) {
        result.push(val);
        if (result.length >= takeLimit) {
          break; // 满足 take 数量,彻底终止大数组遍历!
        }
      }
    }

    return result;
  }
}

// 验证运行效果
const stream = new MiniChain([1, 2, 3, 4, 5, 6, 7, 8, 9, 10]);
const output = stream
  .map(x => x * 2)
  .filter(x => x > 6)
  .take(2)
  .value();

console.log(output); // 输出: [8, 10]
六、横向深度对比与现代 JavaScript 架构演进
将 jQuery 与 Lodash 放在同一个架构坐标系中审视,可以清晰看到两者针对不同应用领域做出的不同工程取舍:
| 核心对比维度 | jQuery 链式调用 | Lodash 链式调用 |
|---|---|---|
| 核心操作对象 | DOM 元素集合伪数组(包含状态与副作用的宿主资源) | 纯 JavaScript 内存数据(数组、对象、标量) |
| 执行时机 | 即时贪婪执行(Eager),调用即操作 DOM | 惰性求值(Lazy),调用入队,.value() 时统一执行 |
| 状态管理机制 | 基于原型共享的双轨制,通过 prevObject 保留历史状态栈 |
基于包装器的动作排队流,单向向前传递操作元数据 |
| 回溯支持 | 原生提供 .end() 实现调用层级的弹栈回退 |
不支持中间回退,专注于单次高效流转 |
| 解包终止策略 | 隐式为主(链条长期存在),需要原生元素时使用 [index] 或 .get() |
显式为主,必须调用 .value() 进行拆箱,否则无法获取原生数据 |
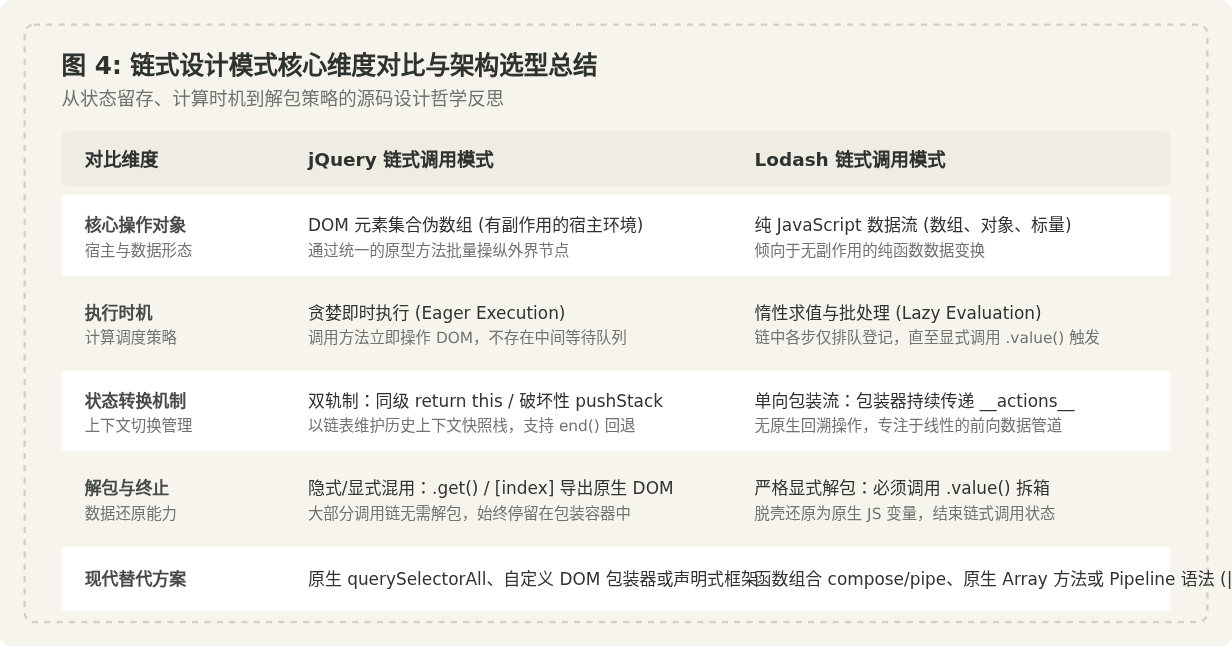
现代 JavaScript 的演进与链式模式的去中心化
随着 ECMAScript 规范的演进以及函数式编程在前端领域的深化,链式调用这种设计模式在现代架构中呈现出新的演变方向:
-
原型侵入性争议与 Tree-shaking 困境:无论是 jQuery 还是 Lodash 的链式模式,都要求在包装器原型上挂载所有候选方法。这导致在现代前端打包工具(Webpack、Vite、Rollup)中,链式调用极难进行细粒度的死代码消除(Tree-shaking)。哪怕你只在链中用了
map,整个LodashWrapper.prototype上的上百个方法也会被整体打包进生产包。这也是 Lodash 社区后来力推lodash/fp和单个函数导入的主要原因。 -
函数组合(Pipe / Compose)的普及:现代前端数据处理越来越倾向于使用纯函数组合来替代原型链包装:
// 纯函数组合风格(天然支持 Tree-shaking) import { pipe, map, filter, take } from 'remeda'; // 或自定义 pipe const result = pipe( data, map(x => x * 2), filter(x => x > 10), take(5) ); -
Pipeline 操作符(
|>)提案:ECMAScript 目前正在推进管道操作符提案。未来一旦落地,开发者将能够在不依赖任何包装器对象、不侵入原型链的前提下,享受如同链式调用般的流畅阅读体验:// 未来原生语法设想 const result = data |> (_ => map(_, x => x * 2)) |> (_ => filter(_, x => x > 10)) |> (_ => take(_, 5));
七、总结
通过解构 jQuery 与 Lodash 的源码可以发现,看似相似的“点操作符连续调用”,背后承载了完全不同的架构策略:
- jQuery 面对具有层级结构、需要反复操作宿主环境的 DOM 节点,通过巧妙的原型闭环(
init.prototype = jQuery.fn)抹平了实例化门槛,并通过pushStack与prevObject构建了单向链表回溯栈,解决了上下文切换与状态保持的问题。 - Lodash 面对可能极其庞大的内存数据集合,摒弃了即时创建中间态数组的做法,通过
LodashWrapper构建了一套动作队列系统,把计算时机严格推迟至.value()阶段,以惰性求值和快捷熔断换取极致的内存利用率。
在实际项目设计中,如果你需要设计一组针对特定宿主资源的操作集合,jQuery 的包装器与快照栈模型提供了极佳的状态隔离范例;而当你面对复杂的多步数据加工逻辑时,Lodash 的任务队列与惰性求值思路则是优化执行效率的重要手段。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章