
深入解析JavaScript中对象深合并的核心原理与工程实践,提供防范原型污染和循环引用的完整手写递归实现,并与Lodash的merge实现进行多维度对比及选型指导。

当前位置:首页 > JavaScript 对象与原型 > 正文
JS实现深合并对象:手写递归与Lodash对比
作者:半夏
时间:2026-11-03
浏览:318
文章目录
JavaScript 进阶
工程化最佳实践
阅读时长约 8 分钟
规范化教程
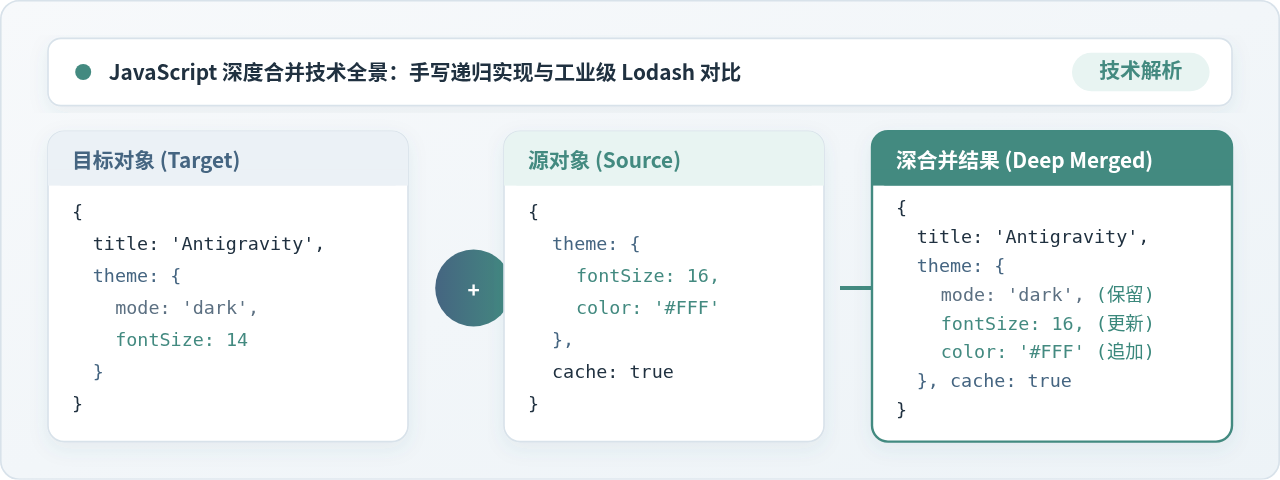
在 JavaScript 应用开发中,深合并(Deep Merge)是处理系统默认配置融合、前端组件状态更新以及服务端参数修补的关键操作。本文将直入核心,剖析原生浅合并在处理嵌套对象时的覆盖陷阱,手把手实现具备防范原型污染和支持循环引用的健壮递归函数,并与生产环境主流库 Lodash.merge 展开全方位对比,帮助你在不同业务场景中做出准确的技术选型。
一、浅合并的局限与深合并的核心问题
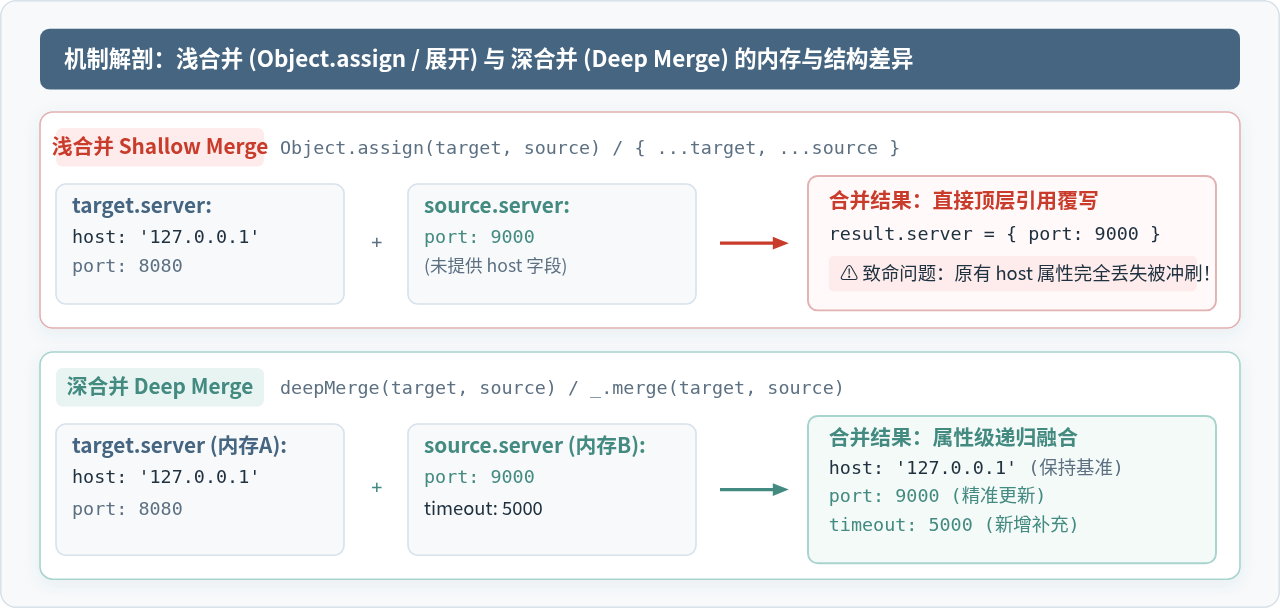
日常开发中最常见的对象合并方式是使用 Object.assign() 或 ES6 对象的展开运算符 ...。但这两种方式均属于浅合并(Shallow Merge):它们仅复制对象的第一层属性引用。一旦遇到嵌套的对象结构,新对象的嵌套属性会直接覆盖目标对象的整个子对象,造成嵌套数据的意外丢失。
// 浅合并导致的嵌套属性丢失示例
const defaultConfig = {
  appName: 'AdminPortal',
  server: {
    host: '127.0.0.1',
    port: 8080,
    timeout: 3000
  }
};

const userConfig = {
  server: {
    port: 9000 // 开发者仅期望修改端口号
  }
};

// 使用展开运算符合并
const merged = { ...defaultConfig, ...userConfig };

console.log(merged.server);
// 实际输出: { port: 9000 }
// 结果分析: 原有的 host 与 timeout 字段完全丢失!
在上述场景中,展开运算符将 userConfig.server 的引用直接赋给了 merged.server,原配置内部由默认值保障的 host 与 timeout 荡然无存,引发严重的运行时缺陷。深合并的目标,正是递归进入每一层嵌套对象中,在保留未修改字段的前提下完成局部属性的增量替换。
二、手写递归深合并的关键难点与考量
编写一个简单的递归合并函数并不复杂,但在生产代码中,必须充分考虑以下四个技术难点:
-
精准的普通对象判断(Plain Object):
不能简单使用
typeof obj === 'object',因为null、Array、Date、RegExp都会返回'object'。必须利用Object.prototype.toString.call(val) === '[object Object]'确保只有纯字面量对象才执行递归。 -
防范原型污染漏洞(Prototype Pollution):
合并不可信的外部输入(如 URL 参数或用户提交的 JSON)时,若包含
__proto__、constructor或prototype,会直接修改宿主环境的全局原型对象,造成注入风险。 -
循环引用检测(Circular Reference):
如果对象内部属性存在自引用(如
a.self = a),普通递归会因陷入死循环而导致Maximum call stack size exceeded。必须引入WeakMap记录已访问过的节点。 -
数组处理策略(Array Strategy):
业务中对于数组的期望差异极大:是直接替换数组、使用
concat追加去重,还是按相同索引逐项合并?手写时需明确固定策略或提供参数开关。
三、手写递归实现:逐步构建健壮的 deepMerge
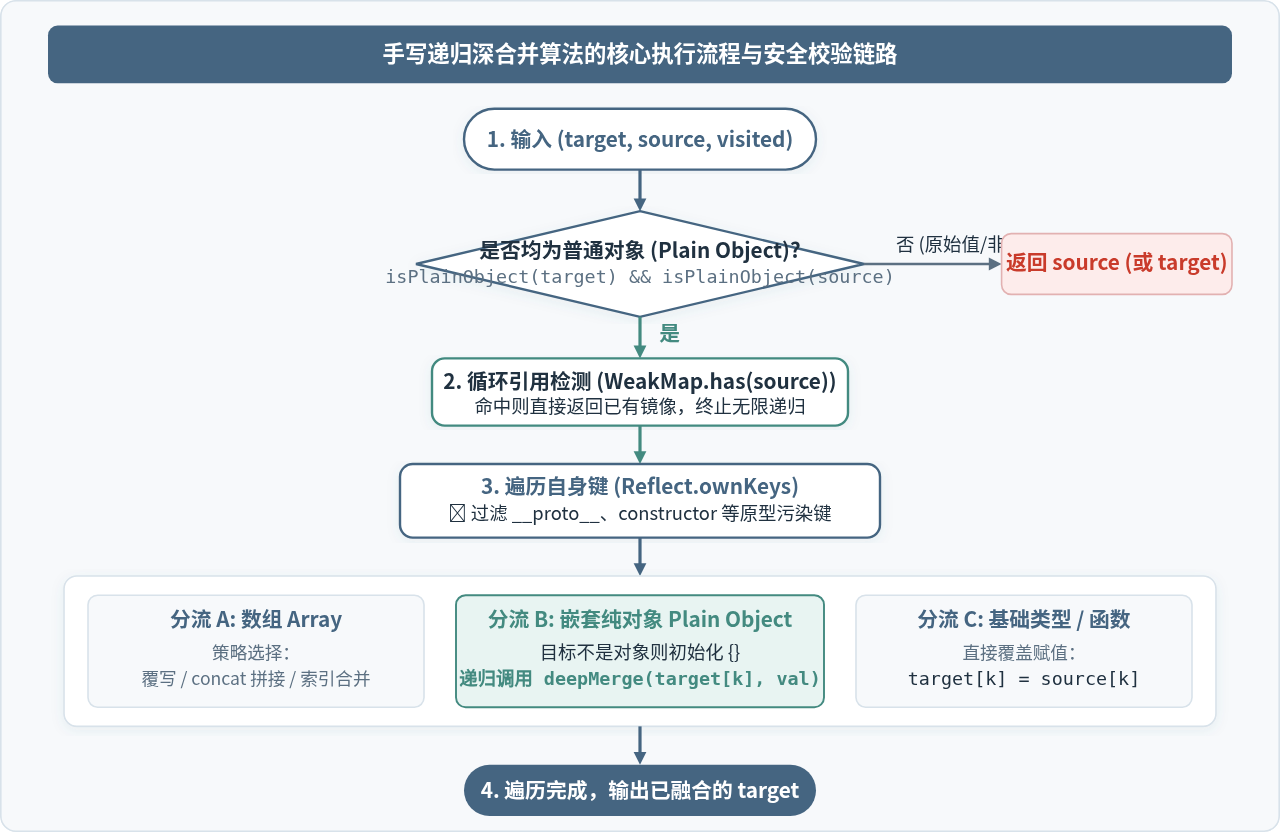
按照实际执行链路,我们将算法拆解为:前置类型校验、环引用捕获、安全键提取、多类型分流处理四个步骤。执行流程如下图所示:
下面是兼顾安全性、循环引用防护以及数组克隆策略的完整手写实现代码:
/**
 * 校验目标是否为纯字面量对象
 */
function isPlainObject(value) {
  if (typeof value !== 'object' || value === null) return false;
  return Object.prototype.toString.call(value) === '[object Object]';
}

/**
 * 健壮的对象深合并函数
 * @param {Object} target 目标对象
 * @param {Object} source 源对象
 * @param {WeakMap} visited 循环引用缓存表
 * @returns {Object} 合并后的目标对象
 */
function deepMerge(target, source, visited = new WeakMap()) {
  // 1. 若源对象不是普通对象,直接以非 undefined 的源数据为主
  if (!isPlainObject(source)) {
    return source !== undefined ? source : target;
  }

  // 2. 若目标不是对象,初始化为空对象以承接合并
  if (!isPlainObject(target)) {
    target = {};
  }

  // 3. 循环引用检测:若此源对象已合并过,直接复用其对应引用
  if (visited.has(source)) {
    return visited.get(source);
  }
  visited.set(source, target);

  // 4. 获取自身所有键(包括 Symbol 键)
  const keys = Reflect.ownKeys(source);

  for (const key of keys) {
    // 5. 关键安全防护:拦截原型污染键
    if (key === '__proto__' || key === 'constructor' || key === 'prototype') {
      continue;
    }

    const sourceVal = source[key];
    const targetVal = target[key];

    // 6. 分类型差异化处理
    if (Array.isArray(sourceVal)) {
      // 数组策略:克隆新数组避免引用共享;若目标也是数组,可根据业务选择覆盖或 concat
      target[key] = Array.isArray(targetVal)
        ? [...targetVal, ...sourceVal] // 此处演示数组追加策略
        : [...sourceVal];
    } else if (isPlainObject(sourceVal)) {
      // 嵌套纯对象:递归合并
      target[key] = deepMerge(targetVal, sourceVal, visited);
    } else if (sourceVal !== undefined) {
      // 基础类型或特殊对象(Date/RegExp/Function等):直接赋值
      target[key] = sourceVal;
    }
  }

  return target;
}
执行验证说明:运行上述代码后,若输入深层嵌套的配置项,嵌套对象将按属性深度融合;若输入包含
source.loop = source 的自引用结构,visited 表能立即阻断栈溢出;遇到恶意 JSON.parse('{ "__proto__": { "polluted": true } }') 时,防护逻辑会自动剔除该键,有效保障执行上下文安全。
四、Lodash 深度合并机制与进阶能力
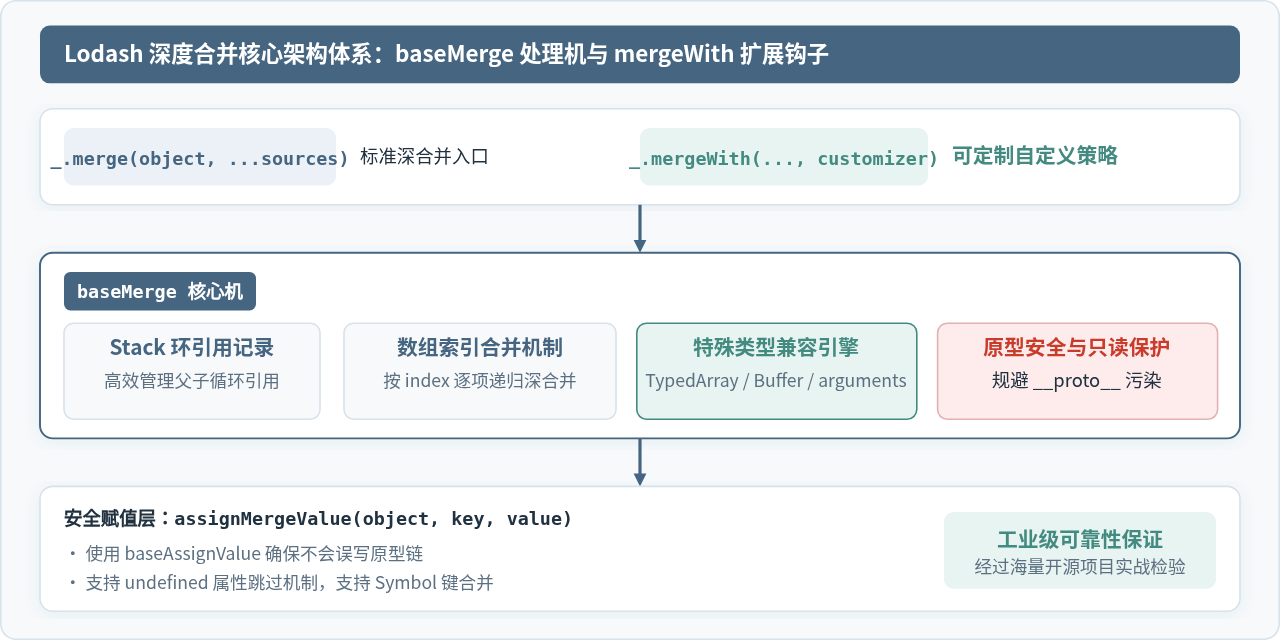
在成熟的工业级项目中,lodash/merge 是最广泛采用的标准工具。Lodash 的内部实现经过了数十万开源项目的验证,其体系结构比手写版本更加精密。
1. Lodash.merge 的默认合并行为
需要特别注意,lodash.merge 默认对于数组的处理方式与很多初学者的直觉不同:它是按数组索引(Index)逐项递归合并,而不是简单地替换或全部 concat。
import merge from 'lodash/merge';

const objA = { tags: ['javascript', 'web'] };
const objB = { tags: ['typescript'] };

const result = merge({}, objA, objB);
console.log(result.tags);
// 输出结果: ['typescript', 'web']
// 原因分析: 索引 0 处的 'javascript' 被 'typescript' 覆写,索引 1 处的 'web' 则被保留。
2. 使用 mergeWith 自定义数组或特定对象的合并规则
当默认的索引覆盖行为不满足业务场景时,Lodash 提供了强大的 mergeWith 接口,允许开发者通过 customizer 回调函数自由控制特定类型的合并方式:
import mergeWith from 'lodash/mergeWith';

const defaultSettings = {
  plugins: ['auth', 'logger'],
  timeout: 5000
};

const customSettings = {
  plugins: ['metrics']
};

// 自定义合并策略:遇到数组则直接执行去重拼接
function customizer(objValue, srcValue) {
  if (Array.isArray(objValue)) {
    return Array.from(new Set(objValue.concat(srcValue)));
  }
}

const finalConfig = mergeWith({}, defaultSettings, customSettings, customizer);
console.log(finalConfig.plugins);
// 输出: ['auth', 'logger', 'metrics'] (成功保留所有插件)
五、手写递归 vs Lodash 多维对比与选型指南
在进行技术选型时,团队往往在“减少外部依赖包袱”与“提高极端边界处理鲁棒性”之间做权衡。两者的具体对比如下表所示:
| 对比指标 | 手写递归实现 (Custom deepMerge) | Lodash 官方实现 (lodash/merge) |
|---|---|---|
| 产物体积 (Bundle Size) | 约 0.5KB ~ 1KB,零外部依赖 | 按需打包约 4KB ~ 8KB (Gzip 约 2KB) |
| 数组处理逻辑 | 完全由开发者自主定义(追加、覆写或去重) | 默认按索引逐项合并,需自定义时依赖 mergeWith |
| 安全与原型污染 | 需显式编写针对 __proto__ 的防御逻辑 |
内置 assignMergeValue,全面免疫原型污染 |
| 复杂类型兼容 | 通常只覆盖 Plain Object,其他类型视需求补充 | 全面支持 Buffer、TypedArray、Map/Set、arguments |
| 循环引用支持 | 使用 WeakMap 易于实现 |
内部使用定制的 Stack 缓存结构实现 |
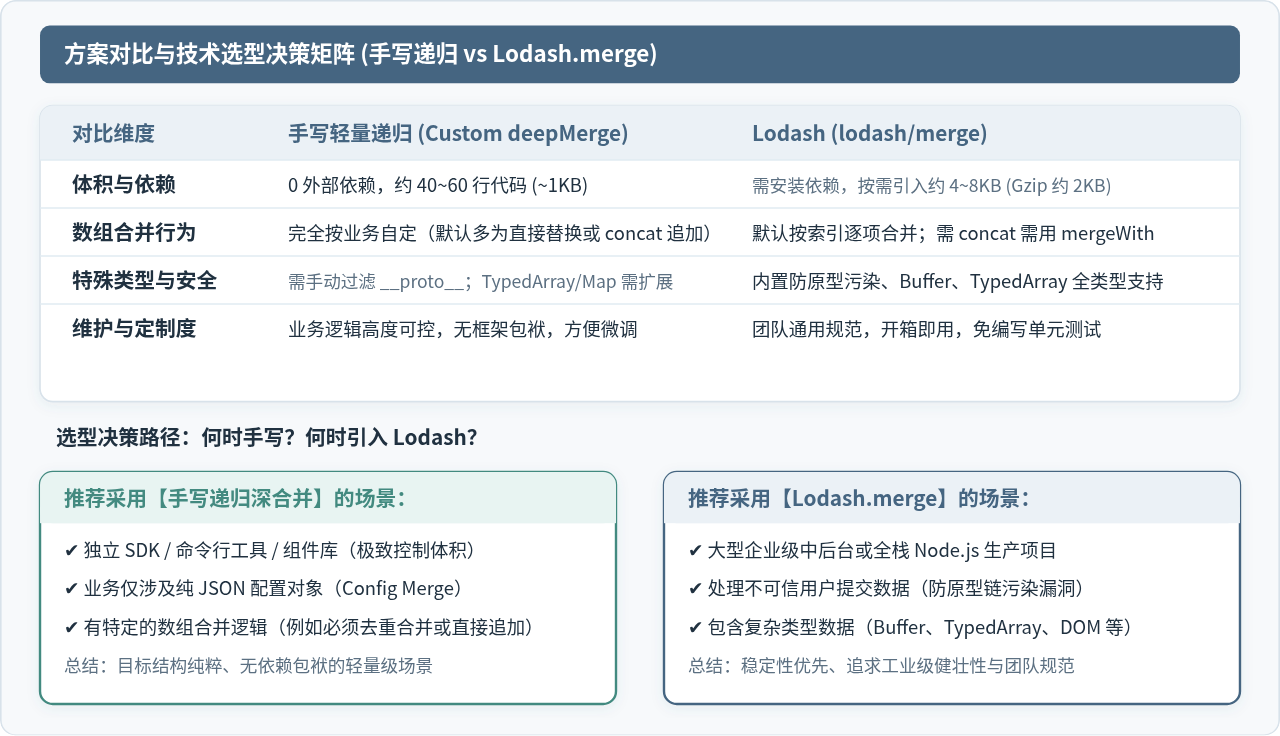
选型实践建议:
- 优先选用手写实现的场景: 正在开发体积敏感的轻量 SDK、无依赖的 NPM 微模块、CLI 命令行工具,或仅用于客户端本地纯 JSON 配置合并。此时手写 50 行包含原型防范与 WeakMap 的代码是性价比最高的选择。
- 必须选用 Lodash 的场景: 企业级全栈 Node.js 服务端应用(需解析来自网络不可信用户提交的多维结构)、涉及复杂二进制数据与 TypedArray 转换的图形处理系统,或者项目中已经整体引入了 Lodash 的中大型中后台系统。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章