
深入讲解在 JavaScript 中如何利用 ES6 Map 结构高效实现对象数组去重。详细分析 Set 去重对象的失效原因,提供保留首次出现、保留末次出现及多字段复合去重的完整代码方案,并通过 O(n) 与 O(n^2) 算法复杂度对比揭示性能优势。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JavaScript利用Map实现对象数组高效去重
作者:异步漫步
时间:2026-11-03
浏览:203
文章目录
JavaScript 性能工程
发布分类:前端架构与基础算法
适用运行环境:Node.js / 现代浏览器 (ES6+)
算法复杂度:O(n) 线性时间
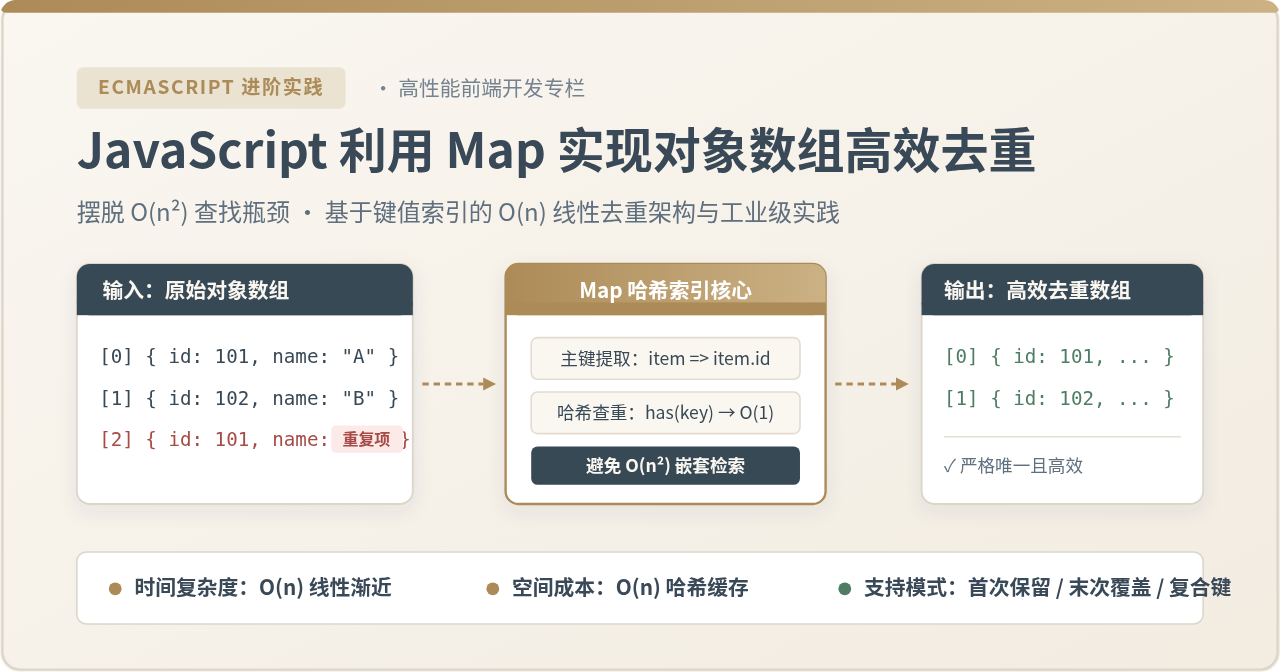
在处理前后端交互接口、分页数据追加合并或本地缓存清洗时,根据某个唯一业务主键(例如
id 或组合业务标识)去除重复对象是高频基础需求。直接使用 new Set(arr) 对对象数组无法生效,因为 Set 比较的是对象的内存指针引用;而使用常规的 filter 配合 findIndex 会因双层嵌套遍历陷入 O(n²) 的时间复杂度瓶颈,在数据量超过数千条时引发界面卡顿。最稳妥高效的方案是利用 ES6 的 Map 结构,提取对象的关键属性作为键建立单次哈希索引,在 O(n) 线性时间复杂度内完成去重。
一、为什么原生 Set 无法直接去重对象数组
许多开发者在处理原始类型(如数字、字符串数组)时习惯直接使用 [...new Set(arr)]。这种写法简洁高效,但在对象数组中会彻底失效。
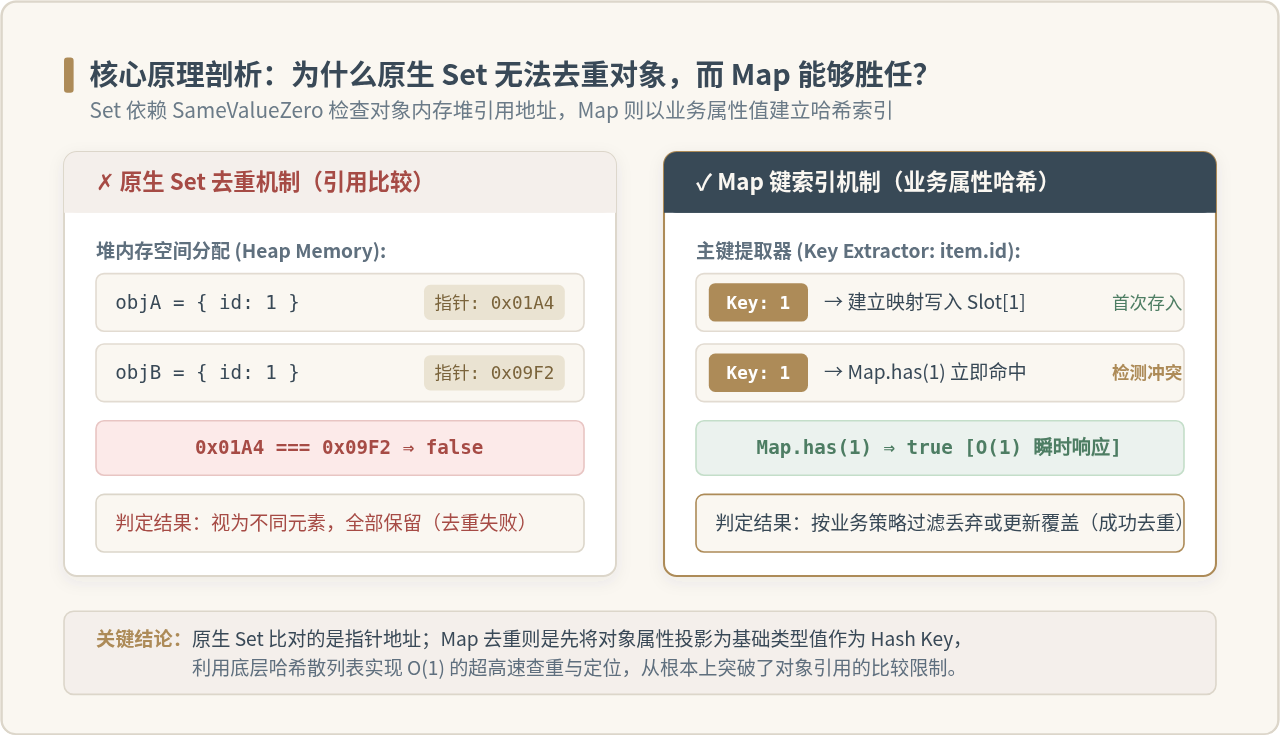
根本原因在于底层的数据比较规范:ES6 的 Set 内部使用 SameValueZero 比较算法。当集合存入对象时,比对的是对象在堆内存中的引用地址,而非对象内部包含的具体属性。即便两个对象的键名和键值完全一致,只要它们是由不同的字面量或对象创建语句分配的,其在内存中的堆地址就截然不同。
// 原生 Set 对比对象的现象示例
const list = [
  { id: 1, name: "张三" },
  { id: 1, name: "张三" }
];

const result = [...new Set(list)];
console.log(result.length); // 示例输出:2 (去重完全失效,两个对象均被保留)
为了解决这一问题,部分代码会采用 arr.filter((item, index) => arr.findIndex(el => el.id === item.id) === index)。虽然这种写法能正确保留唯一的 id,但 findIndex 会在每一次迭代中从头线性扫描数组。当数组长度为 $n$ 时,总比较次数接近 $rac{n(n-1)}{2}$。当数据量上升至数万条时,执行耗时将呈二次方暴增。
相对而言,Map 允许我们将对象内部提取出的基础属性值(如 item.id)作为键,利用哈希表的底层索引机制实现接近 O(1) 的瞬时查询与去重判断。
二、核心方法一:保留首次出现的元素(维持原序)
在常见业务场景中,例如分页列表追加加载或按时间从新到旧展示的数据流,往往需要以最早读取到的记录为准,后续出现的同主键项视为多余数据予以舍弃。这种需求强调“严格维持数据原有的相对位置”。
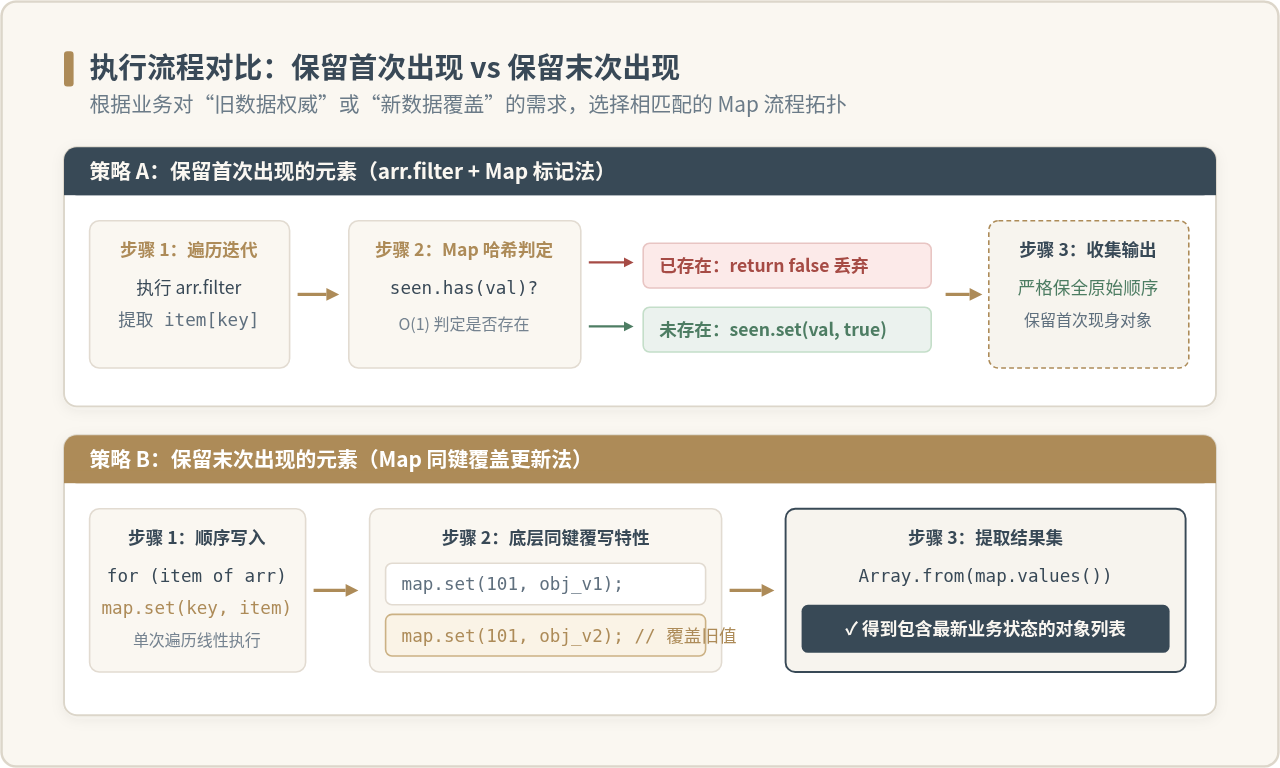
实现该逻辑的最高效途径是将 arr.filter() 与一个临时的 Map 实例结合。Map 充当去重哈希过滤器,记录已被选取的键。
完整代码实现
/**
 * 基于指定属性去重对象数组,保留首次出现的元素
 * @param {Array<Object>} arr - 待处理的对象数组
 * @param {string} key - 用于去重的对象主键属性名
 * @returns {Array<Object>} 去重后的新数组
 */
function deduplicateByFirst(arr, key) {
  if (!Array.isArray(arr) || !key) return [];

  const seen = new Map();

  return arr.filter(item => {
    if (!item || typeof item !== 'object') return false;
    const val = item[key];

    // 利用 Map 的 O(1) 查找能力检测键是否存在
    if (seen.has(val)) {
      return false; // 命中历史记录,舍弃当前项
    }

    seen.set(val, true); // 标记键已被占用
    return true;        // 首次出现,保留入选
  });
}

// 业务调用示例
const users = [
  { id: 101, name: "张三", role: "主管" },
  { id: 102, name: "李四", role: "开发" },
  { id: 101, name: "张三(旧)", role: "普通" }
];

const uniqueUsers = deduplicateByFirst(users, 'id');
console.log(uniqueUsers);
/* 示例输出:
[
  { id: 101, name: "张三", role: "主管" },
  { id: 102, name: "李四", role: "开发" }
]
*/
实现细节解析:
在该模式中,
seen.set(val, true) 仅需存入布尔值作为占位标记,内存占用极小。整个处理过程只对输入数组进行了一次线性扫描,总时间复杂度严格受控于 O(n)。同时 filter 回调保证了未重复项在输出数组中的相对索引顺序与原数组完全一致。
三、核心方法二:保留末次出现的元素(覆盖更新)
另一类常见的场景是数据同步与状态合并。例如:从服务端拉取了一份基础名单,随后接收到了一批增量变更推送;当两份数据合并时,后出现的记录代表数据的最新快照,需要直接替换掉先前出现的旧对象。
由于 ES6 的 Map.prototype.set(key, value) 原生具备“若键已存在则用新值覆写旧值”的特性,保留末次出现的去重逻辑可以写得更加自然洗练。
完整代码实现
/**
 * 基于指定属性去重对象数组,保留末次出现的元素(新值覆盖旧值)
 * @param {Array<Object>} arr - 待处理的对象数组
 * @param {string} key - 用于去重的对象主键属性名
 * @returns {Array<Object>} 去重后的新数组
 */
function deduplicateByLast(arr, key) {
  if (!Array.isArray(arr) || !key) return [];

  const map = new Map();

  // 遍历所有元素,后进入的对象自然覆盖先进入的
  for (const item of arr) {
    if (item && typeof item === 'object') {
      map.set(item[key], item);
    }
  }

  // 提取全部最后写入的实体对象
  return Array.from(map.values());
}

// 业务调用示例
const orders = [
  { orderId: "A001", status: "pending" },
  { orderId: "A002", status: "shipped" },
  { orderId: "A001", status: "paid" } // 最新状态
];

const latestOrders = deduplicateByLast(orders, 'orderId');
console.log(latestOrders);
/* 示例输出:
[
  { orderId: "A001", status: "paid" },
  { orderId: "A002", status: "shipped" }
]
*/
一行代码快速写法:在不考虑空值防护的简易函数式场景中,可以借助数组展开简化为:
const dedupe = (arr, key) => Array.from(new Map(arr.map(i => [i[key], i])).values());。但需要注意,此写法会先行生成一个中间二维数组,当数组规模达数十万级别时,for...of 的内存表现更为优越。
四、进阶场景:基于多字段的复合条件去重
在实际生产开发中,经常会遇到“单一属性无法唯一定义记录”的情况。例如:
- 电商系统中按照
spuId与colorCode共同确定一款规格商品; - 多租户系统中按
tenantId(租户编号)与accountName(账号名称)联合界定唯一用户; - 报表汇总中根据
year、quarter与region三重维度进行聚合去重。
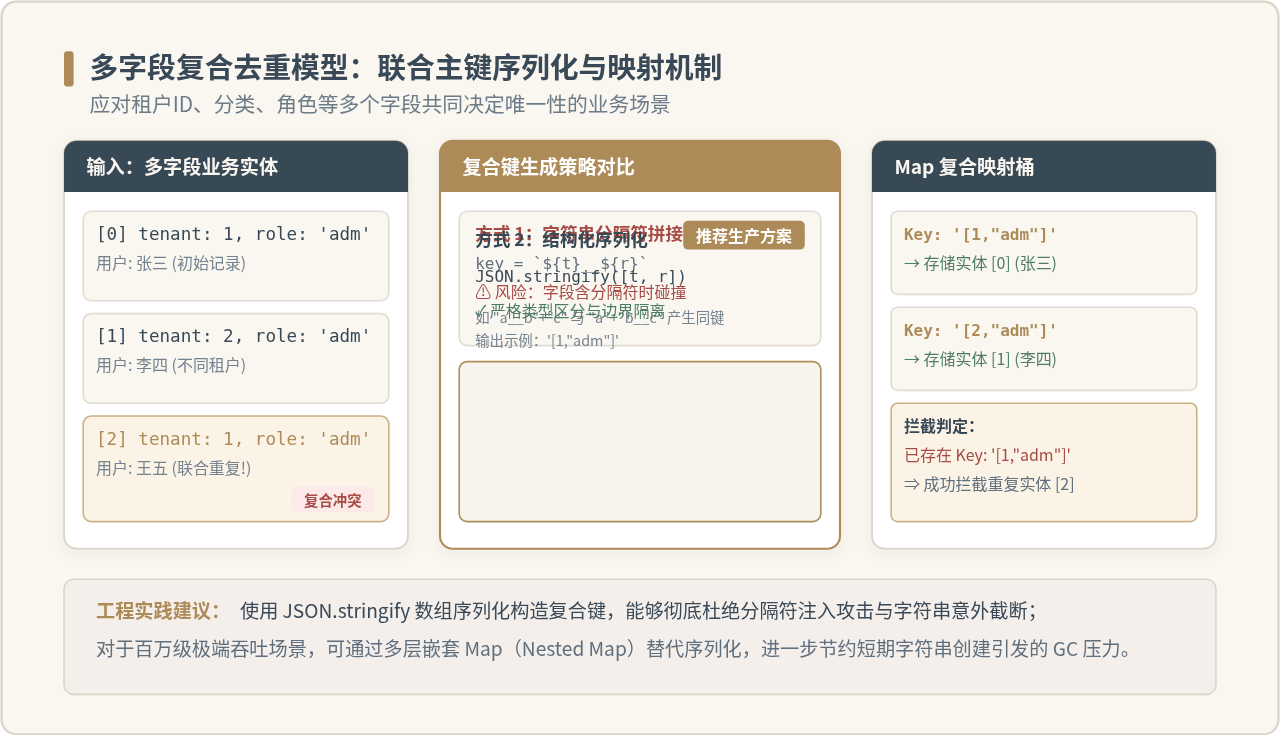
因为 JavaScript 的对象键不能直接接受非原始结构(如果传入两个内容相同的普通对象作为 Map 键,依然会因为引用不一致而失效),必须将多维度的字段特征收敛为稳定、唯一的键标量。
常见方案辨析与工业级推荐
-
字符串分隔符拼接(如
`${a}__${b}`):虽然书写直观,但如果字段内容自身恰好包含分隔符(例如某个字段值为"user__name"),就会破坏边界,造成不同维度数据的键碰撞。 -
结构化序列化(
JSON.stringify([a, b]),推荐):将所有关联字段放入一个定长数组并执行序列化。JSON 序列化会为字符串添加界定引号并保留类型标记,从机制上彻底阻断字符注入和拼接歧义。
多字段复合去重通用代码
/**
 * 支持多字段联合主键的对象数组高效去重
 * @param {Array<Object>} arr - 待去重的对象数组
 * @param {Array<string>} keys - 组成联合主键的属性名数组
 * @returns {Array<Object>} 去重后的对象数组
 */
function deduplicateByCompositeKeys(arr, keys) {
  if (!Array.isArray(arr) || !Array.isArray(keys) || keys.length === 0) {
    return Array.isArray(arr) ? arr : [];
  }

  const seen = new Map();

  return arr.filter(item => {
    if (!item || typeof item !== 'object') return false;

    // 将联合字段按指定顺序抽取并执行紧凑序列化
    const compositeKey = JSON.stringify(keys.map(k => item[k]));

    if (seen.has(compositeKey)) {
      return false;
    }

    seen.set(compositeKey, true);
    return true;
  });
}

// 业务调用示例
const permissions = [
  { tenantId: 1, role: "admin", user: "张三" },
  { tenantId: 2, role: "admin", user: "李四" },
  { tenantId: 1, role: "admin", user: "王五" } // 租户+角色与首条重复
];

const uniquePerms = deduplicateByCompositeKeys(permissions, ['tenantId', 'role']);
console.log(uniquePerms);
/* 示例输出:
[
  { tenantId: 1, role: "admin", user: "张三" },
  { tenantId: 2, role: "admin", user: "李四" }
]
*/
五、算法性能对比与复杂度量化
为了深入理解 Map 去重所带来的性能优势,我们将其与常见的前端去重算法进行理论复杂度与实测趋势的综合横向对比。
| 实现方案 | 时间复杂度 | 空间复杂度 | 对象去重能力 | 顺序保持性 | 适用规模 |
|---|---|---|---|---|---|
| 原生 new Set(arr) | O(n) | O(n) | 无效(比对引用) | 保持原序 | 仅限基础类型 |
| filter + findIndex | O(n²) | O(1) | 支持单字段 | 保持原序 | 极小规模 (< 500) |
| reduce + some/find | O(n²) | O(n) | 支持单/多字段 | 保持原序 | 极小规模 (< 500) |
| Map 标记查找 (本文) | O(n) | O(n) | 支持单/多字段 | 可选保留首位或末位 | 工业级通用 (100k+) |
在单线程事件循环机制的 JavaScript 运行时(如 V8)中,执行时间超过 50ms 的脚本就会被浏览器标记为长任务(Long Task),直接引起页面的丢帧与输入卡顿。
当数组规模为 1,000 条时,findIndex 耗时在现代机器上大约仅需 1.8 毫秒,容易掩盖性能缺陷;但在数据扩充至 20,000 条时,findIndex 的两层循环需要比对近 2 亿次,主线程将被阻塞超 800 毫秒;若数据达到 100,000 条,计算耗时将飙升至数十秒以上。而基于 Map 的方案将全部项的查重耗时均匀平摊在单次循环中,十万级数据仍能稳定在 30 毫秒以内完成。
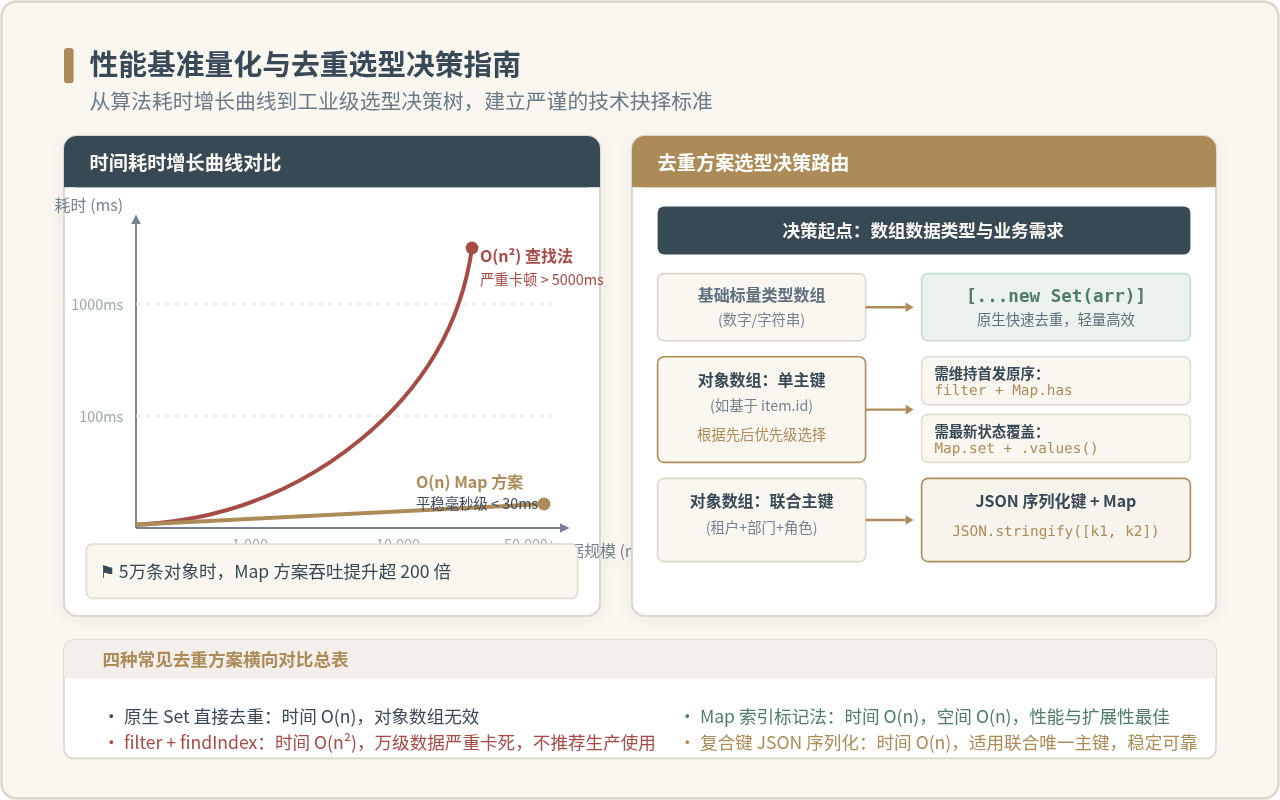
六、生产环境中的边界情况与避坑建议
在业务代码中部署 Map 去重函数时,需对以下四类边界细节进行严谨处理,以防发生非预期的数据过滤:
1. 关键属性为 undefined 或 null 的情况
如果数组中存在若干个缺失了去重属性的对象(例如某些对象没有 id 属性),在默认逻辑下,这些项的 item[key] 均为 undefined。Map 会将它们归为同一个键,从而仅保留其中一个对象,其余无键对象将被静默丢弃。
处理对策:若业务要求“缺失主键的对象不参与去重、一律保留”,应在检查时进行显式旁路放行:
// 旁路缺失键的健壮性保护示例
const val = item[key];
if (val === undefined || val === null) {
  return true; // 主键缺失时无从判定重复,直接放行保留
}
2. 数据源弱类型的隐式转换陷阱
JavaScript 的 Map 区分严格键类型(例如 1 !== '1')。在前后端数据交互中,可能会因不同微服务接口返回格式差异,导致部分数据的 id 为数字 1001,而另一些则为字符串 "1001"。如果直接存入 Map,两者将被视作不同键而无法去重。
处理对策:根据业务主键的定义,在提取键时统一执行归一化格式化,如 const val = String(item[key]);。
3. 对象的深拷贝与副作用隔离
无论是 deduplicateByFirst 还是 deduplicateByLast,输出数组中包含的对象依然是原数组中对象的引用。如果在去重后直接修改了输出数组中某个对象的属性,原数组对应的对象也会同步改变。若业务存在严格的不可变数据流要求(如 React / Redux 状态管理),可在返回时通过浅拷贝({ ...item })阻断后续属性污染。
4. 内存开销与垃圾回收(GC)
Map 作为去重函数内的局部变量创建,在函数执行结束并返回数组后,局部变量 seen 或 map 失去强引用,V8 引擎的垃圾回收器(Garbage Collector)会快速将其占用的内存回收。但如果将 Map 声明在模块顶层或闭包中用作全局长久缓存,必须警惕大数组处理后未清理引用导致的内存泄漏。
技术要点精要提炼
- 核心机制:通过业务键将对象实体投影为标量键,利用 Map 底层散列算法在
O(1)内拦截重复项,将整体复杂度由O(n²)压缩至O(n)。 - 策略选型:需要保留数据首次出现顺序时,采用
filter + Map.has;需要最新状态覆盖时,采用for...of + Map.set后提取.values()。 - 复合条件:联合多属性去重时,推荐
JSON.stringify数组序列化,杜绝普通字符串拼接的分隔符穿透风险。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章