
深入讲解JavaScript对象数组去重的核心原理与实用方案,涵盖基于唯一属性键(Map/filter)、全属性深度比较、保留首项或末项策略,并分析时间复杂度与性能优化避坑指南。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS对象数组怎么去重?
作者:拾光
时间:2026-11-03
浏览:298
文章目录
在 JavaScript 中对对象数组去重,最实用且高效的方案是使用 Map 结合 filter 提取唯一键(例如 id),能在 O(n) 时间复杂度内保留首项;如果需要按所有属性完全一致进行深度去重,则需在对象键名排序后通过 JSON 序列化生成稳定签名比对。
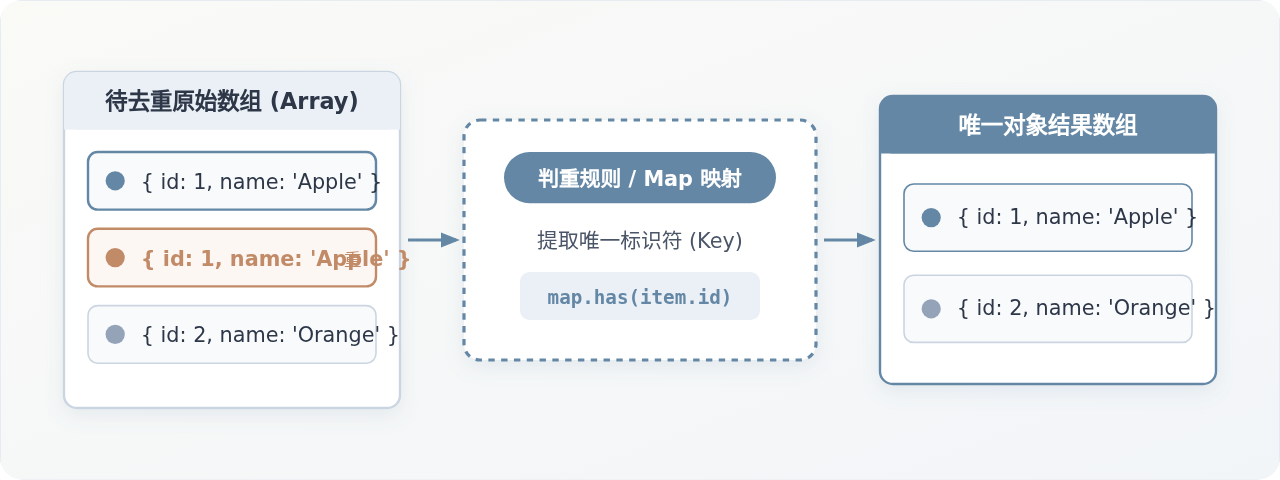
一、为什么常规的 Set 无法直接对对象数组去重?
处理基础类型(如数字、字符串)数组时,我们通常使用 Array.from(new Set(arr)) 快速去重。但在处理对象数组时,这种做法会彻底失效:
const list = [
  { id: 1, name: 'Alice' },
  { id: 1, name: 'Alice' }
];

const result = Array.from(new Set(list));
console.log(result.length); // 输出依然是 2,去重失败!
这是因为 JavaScript 中的对象属于引用类型。Set 在做唯一性判断时,采用的是类似严格全等(===)的 SameValueZero 算法。尽管两个字面量对象拥有完全相同的属性和值,它们在内存中依然是两个独立的堆内存地址。比较两个不同的内存指针时,结果永远为 false。
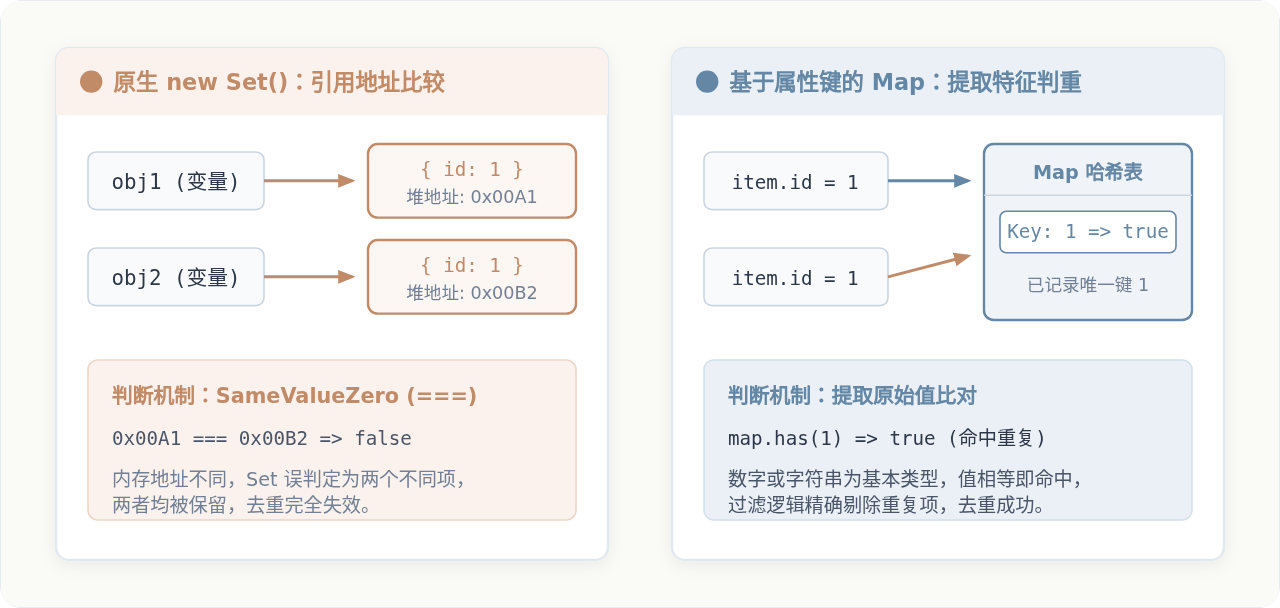
因此,对象数组去重的本质不是比较对象引用本身,而是将对象映射为可比对的原始值(特征键),或者逐项比对对象的每一个具体字段。
二、基于唯一属性(如 ID)去重的三种常用方案
在绝大部分实际业务(如接口数据去重、列表渲染合并)中,对象往往包含唯一的业务主键(例如 id、code 或 userId)。基于唯一键去重是最常见的场景。
方案 1:Map + filter(推荐,保留首个出现项)
通过 Map 记录已经遍历过的唯一键。利用 filter 遍历数组,若 Map 中不存在当前键,则写入该键并保留当前项;若已存在,则予以剔除。
function deduplicateByMap(arr, key) {
  const seen = new Map();
  return arr.filter(item => {
    const val = item[key];
    if (!seen.has(val)) {
      seen.set(val, true);
      return true;
    }
    return false;
  });
}

// 示例数据
const users = [
  { id: 101, name: '张三', role: 'Dev' },
  { id: 102, name: '李四', role: 'QA' },
  { id: 101, name: '张三(旧)', role: 'Dev' },
  { id: 103, name: '王五', role: 'PM' }
];

const uniqueUsers = deduplicateByMap(users, 'id');
// 结果输出:只保留了前三条记录,第二个 id=101 被成功剔除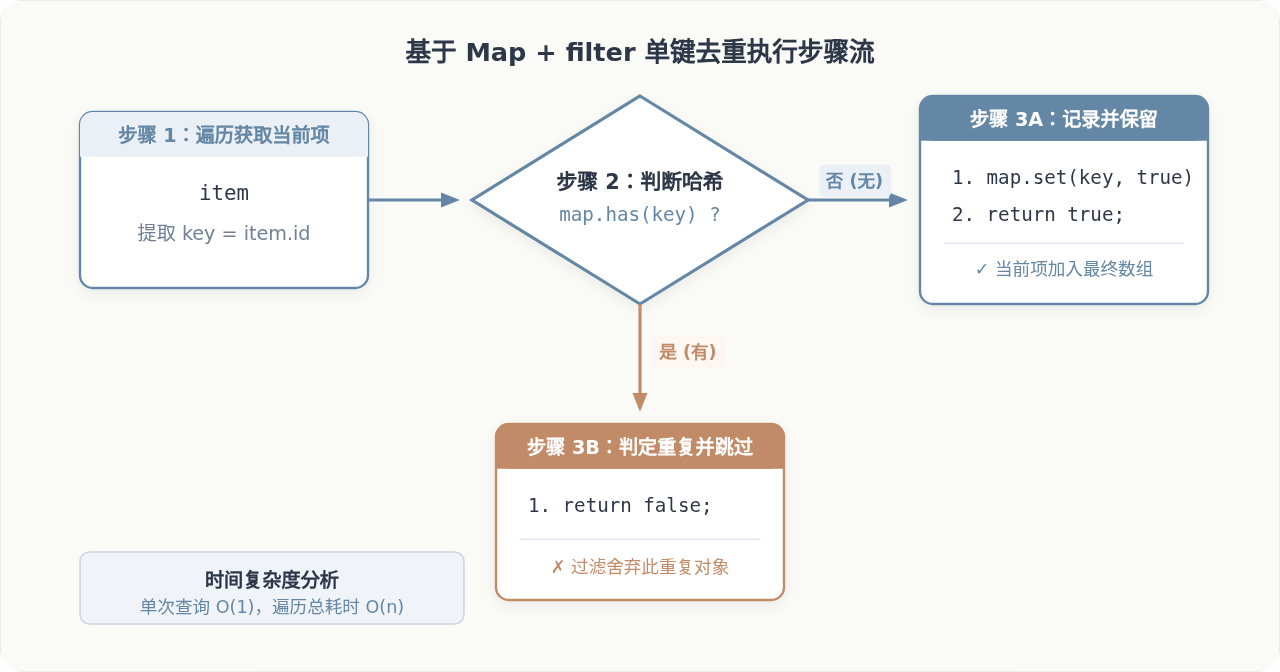
为什么该方案最优?
Map.prototype.has 和 Map.prototype.set 的单次操作时间复杂度为 O(1)。遍历长度为 n 的数组整体耗时为 O(n),同时完全保留原数组的相对顺序。
方案 2:利用 Map.set 键覆写(保留最后出现项)
有些业务场景要求在遇到重复数据时,以最新到达的数据覆盖历史旧数据(即“保留末项”)。此时可以直接利用 Map 相同键会自动覆盖对应值的特性:
function deduplicateKeepLast(arr, key) {
  const map = new Map();
  for (const item of arr) {
    // 后面的元素会覆盖前面的元素
    map.set(item[key], item);
  }
  return Array.from(map.values());
}

const latestUsers = deduplicateKeepLast(users, 'id');
// 结果中 id=101 的记录为 { id: 101, name: '张三(旧)', role: 'Dev' }
方案 3:多字段联合唯一键去重
如果数据中没有单一主键,而是由两个或多个字段共同决定唯一性(例如 type 与 id 联合唯一),只需将提取键的逻辑修改为拼接字符串即可:
function deduplicateByCompositeKey(arr, getKey) {
  const seen = new Set();
  return arr.filter(item => {
    const compositeKey = getKey(item);
    if (seen.has(compositeKey)) {
      return false;
    }
    seen.add(compositeKey);
    return true;
  });
}

// 使用示例:根据 category 和 sku 联合去重
const products = [
  { category: 'Phone', sku: 'A1', price: 3000 },
  { category: 'Phone', sku: 'A1', price: 3100 },
  { category: 'Pad', sku: 'A1', price: 4000 }
];

const uniqueProducts = deduplicateByCompositeKey(
  products,
  item => `${item.category}__${item.sku}`
);
三、警惕常见的性能陷阱:filter + findIndex
很多开发者在初学时喜欢使用双重循环遍历去重:
// ⚠️ 慎用:容易造成性能问题
function badDeduplicate(arr, key) {
  return arr.filter((item, index) =>
    arr.findIndex(target => target[key] === item[key]) === index
  );
}
性能分析:
filter 自身循环 n 次,内部每次调用 findIndex 又会从头查找数组,平均需循环 n/2 次。整体时间复杂度达到 O(n²)。当数组长度为 10,000 时,比对操作将高达约 5000 万次,会导致浏览器主线程显著卡顿或页面崩溃。在数据量可能增长的场景下,应严格禁止使用该写法。
四、全属性完全一致的深度去重
若对象没有固定的唯一主键,要求“所有字段及其对应的值完全相同才判定为重复”,此时需要对对象内部数据进行深度比对。
1. 简单对象的属性排序与 JSON 序列化
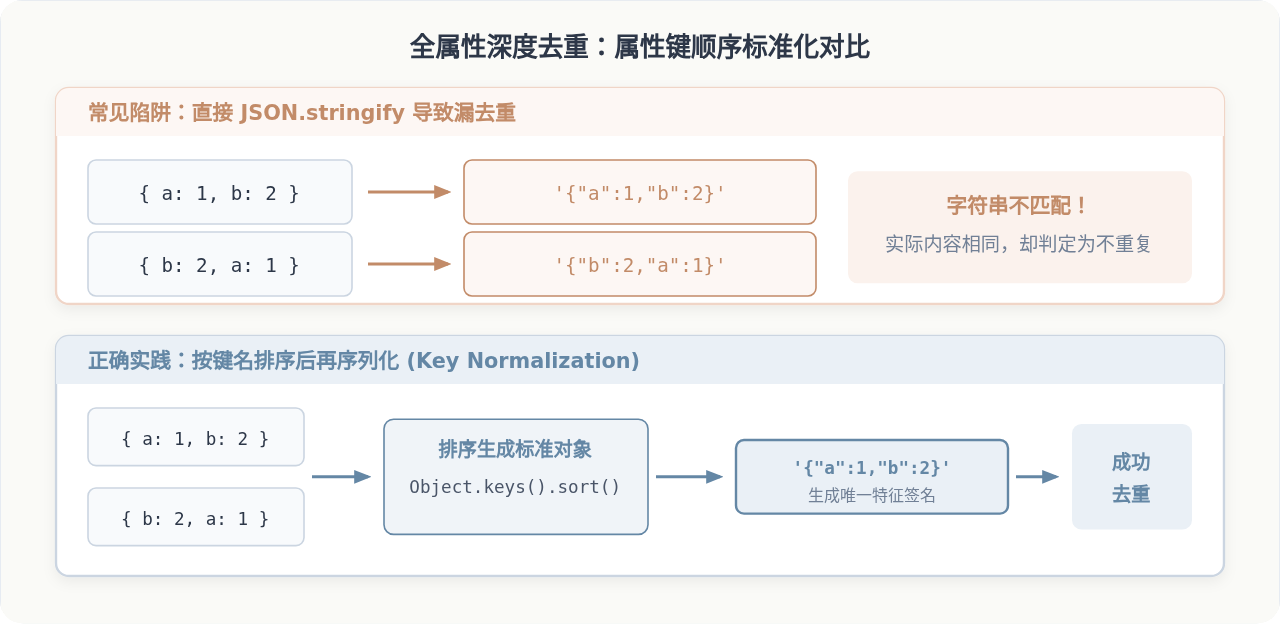
最直观的方法是将对象转为 JSON 字符串作为 Set 的键。但是单纯调用 JSON.stringify(obj) 存在致命缺陷:对象属性的定义顺序会影响序列化结果。例如 JSON.stringify({ a: 1, b: 2 }) 与 JSON.stringify({ b: 2, a: 1 }) 并不相等。
正确的做法是先将对象的键名按字母排序,生成结构一致的中间对象,再进行序列化:
// 对对象键名递归排序,标准化为稳定字符串
function serializeObject(obj) {
  if (obj === null || typeof obj !== 'object') {
    return obj;
  }
  // 处理数组
  if (Array.isArray(obj)) {
    return obj.map(serializeObject);
  }
  // 提取并排序键名
  const sortedKeys = Object.keys(obj).sort();
  const sortedObj = {};
  for (const key of sortedKeys) {
    sortedObj[key] = serializeObject(obj[key]);
  }
  return JSON.stringify(sortedObj);
}

function deduplicateEntireObject(arr) {
  const seen = new Set();
  return arr.filter(item => {
    const signature = serializeObject(item);
    if (seen.has(signature)) {
      return false;
    }
    seen.add(signature);
    return true;
  });
}
边界注意事项: 此方法适用于纯数据对象(Plain Object)。如果对象内部包含 undefined、函数、Symbol 或循环引用,JSON 序列化会丢失对应字段或直接报错。复杂深层结构建议结合成熟工具库(如 lodash.isEqual)进行定制比对。
五、各方案选型对比与总结
为了在实际开发中快速选用最合适的方法,下表汇总了常见去重方式的特性差异:
| 方案类型 | 适用场景 | 时间复杂度 | 空间复杂度 | 保留规则 |
|---|---|---|---|---|
| Map + filter | 按单字段去重(最常用) | O(n) | O(n) | 保留首次出现项 |
| Map 遍历覆写 | 需要最新状态/后入为主 | O(n) | O(n) | 保留最后出现项 |
| 复合键 Set 缓存 | 多字段联合唯一定位 | O(n) | O(n) | 保留首次出现项 |
| 键排序 JSON 序列化 | 所有属性完全一致比对 | O(n · k log k) | O(n) | 保留首次出现项 |
| filter + findIndex | 仅建议极微量数据(<20项)简写 | O(n²) | O(1) | 保留首次出现项 |
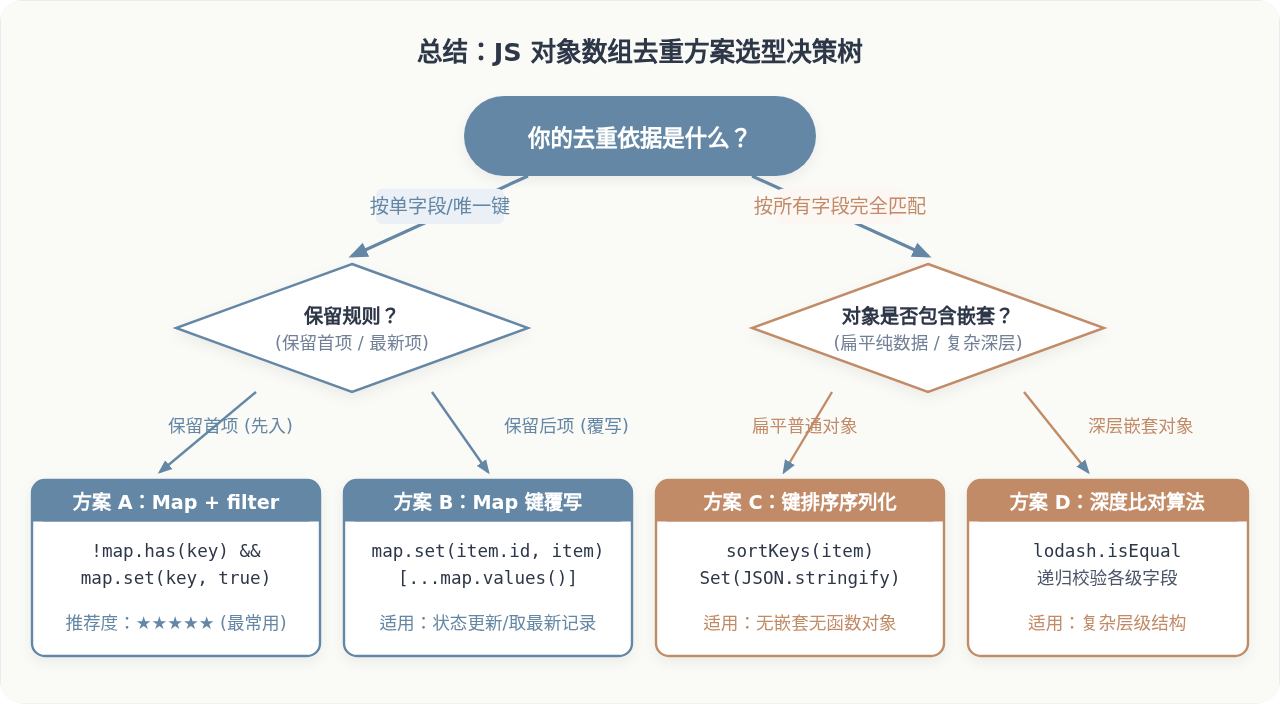
总结而言,日常业务开发中 95% 以上的需求均可归结为基于特定字段去重,直接采用 Map + filter 即可在可读性、代码量与性能之间取得最佳平衡;仅当无任何标识符且必须全字段完全匹配时,才引入键排序序列化方案。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章