

深入解析 Next.js (App Router) 下的 SEO 优化与元数据管理最佳实践,涵盖静态与动态元数据配置、OpenGraph 社交卡片、Sitemap 与 Robots 文件生成、JSON-LD 结构化数据注入及上线校验流程。
Next.js 应用 SEO 优化与元数据管理最佳实践
作者:沉舟
时间:2026-11-03
浏览:255
文章目录
Next.js App Router 架构实战
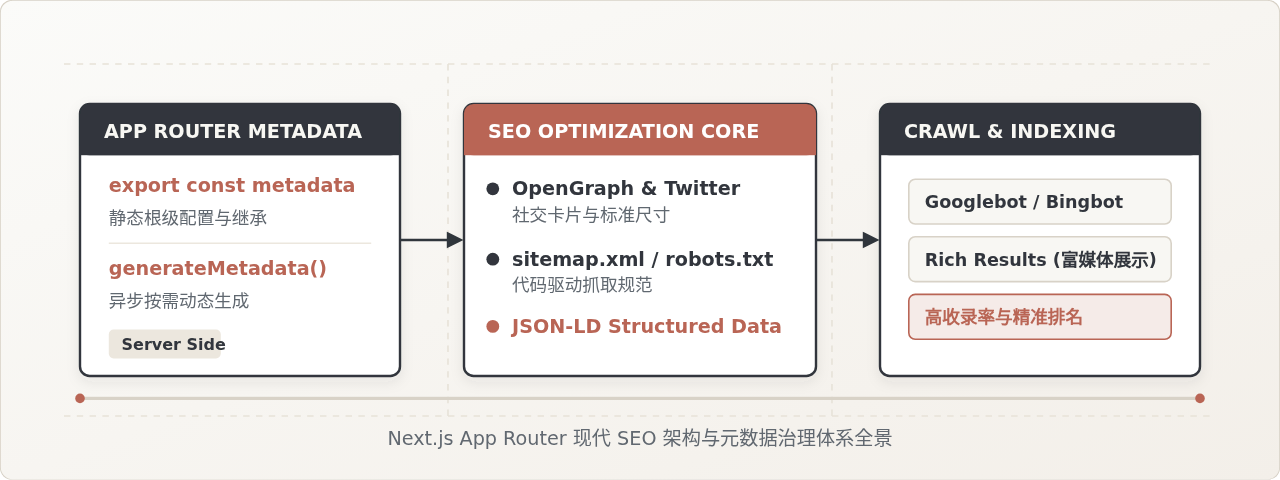
在 Next.js App Router 架构下,SEO 的核心是利用服务端组件的渲染能力,把标准的 HTML 标签、语义化 OpenGraph 协议、结构化数据以及爬虫调度配置在首字节响应中直接输出给搜索引擎。本文面向生产环境,完整拆解静态与动态元数据管理、权威链接(Canonical URL)、站点地图生成及 JSON-LD 注入的标准实现,帮助读者建立稳定、规范且易维护的工程化 SEO 体系。
一、Next.js App Router 元数据系统的运行机制
在早期的 Next.js Pages Router 中,页面元数据通常通过 next/head 组件以客户端虚拟 DOM 挂载的方式管理。这种方式在发生客户端路由切换或异步数据等待时,容易出现头部信息闪烁、标签覆盖混乱甚至爬虫抓取不到完整头部的问题。
App Router 彻底改变了这一设计,引入了基于声明式与服务端运行的 Metadata API。所有元数据(包括标题、描述、关键词、OpenGraph、Twitter 卡片、Robots 标签)均在服务端独立求值,并直接嵌入到首批返回的流式 HTML <head> 中,爬虫即使不执行任何客户端 JavaScript,也能直接解析全部元数据。
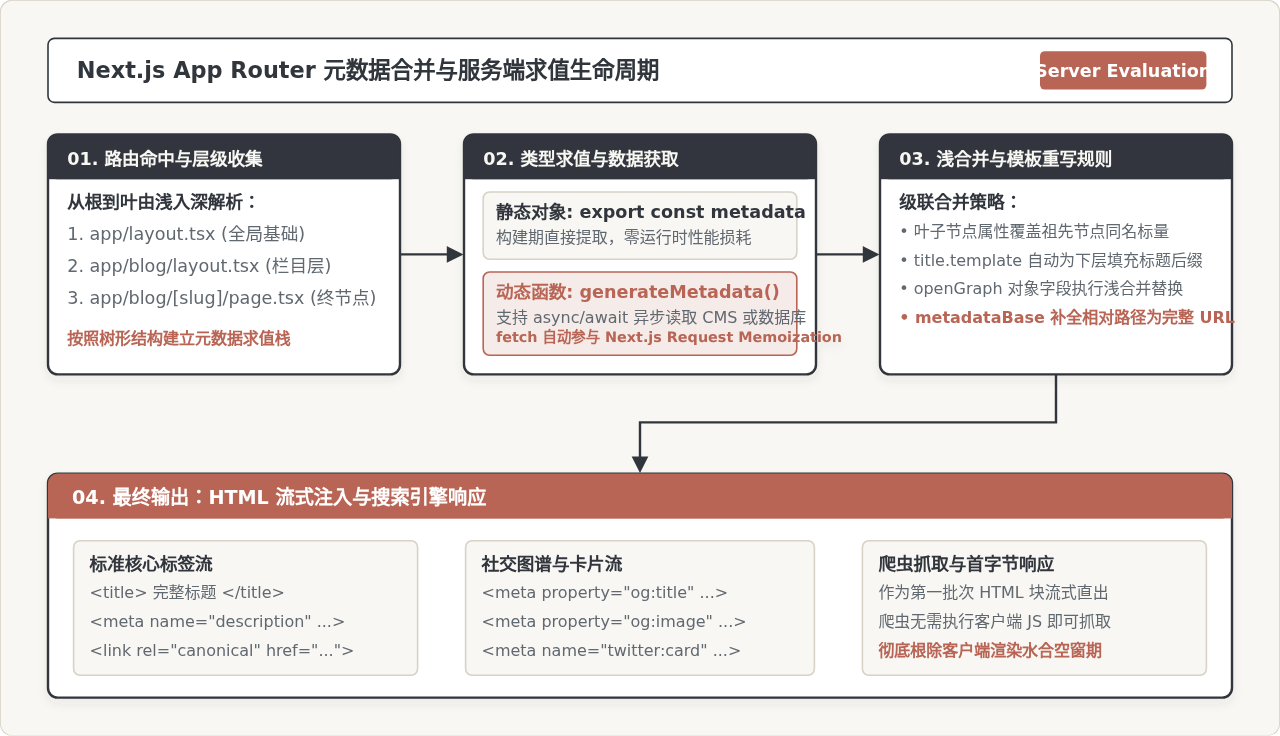
Next.js 在处理页面请求时,遵循从根向下的层级解析与浅合并策略:
- 树形层级收集:引擎自顶向下依次遍历
app/layout.tsx、各个嵌套目录的layout.tsx,最终到达目标路由的page.tsx。 - 浅合并与标量重写:子路由定义的标量字段(如
title、description)直接覆盖祖先层级的配置;对象型字段(如openGraph)进行浅合并(Shallow Merge)。 - 自动请求去重(Request Memoization):若在
generateMetadata()与页面组件Page()中调用了相同的fetch接口,Next.js 会自动共享该响应结果,绝不发生重复网络请求。
二、核心元数据规范实现:静态对象与动态生成
在具体编码中,Next.js 提供了两种元数据声明方式:用于固定内容的 export const metadata 静态对象,以及用于参数化路由的 generateMetadata() 异步函数。
1. 根布局配置:建立全站基准(metadataBase 与 title.template)
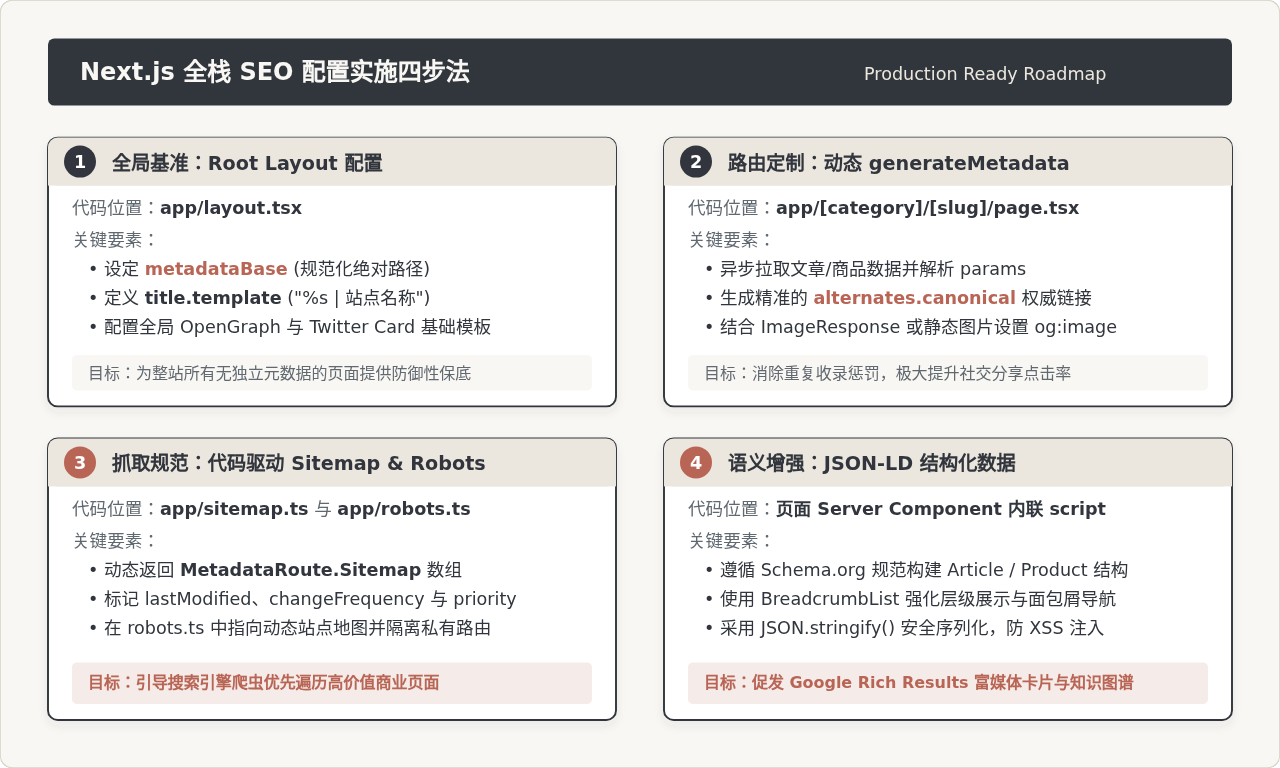
全站的基准元数据必须在 app/layout.tsx 中定义。其中最重要的两个配置项是 metadataBase 与 title.template。没有配置 metadataBase 时,所有相对路径的社交图片或规范网址都会触发构建警告,并在不同域名解析时出现混乱。
// app/layout.tsx
import type { Metadata } from 'next';

export const metadata: Metadata = {
  // 核心基准域名:所有相对路径的图片与 canonical 均基于此补全绝对 URL
  metadataBase: new URL(
    process.env.NEXT_PUBLIC_SITE_URL || 'https://www.example.com'
  ),
  title: {
    default: '技术极客周刊 - 探索前端与分布式系统',
    template: '%s | 技术极客周刊',
  },
  description: '面向高级工程师的深度技术沉淀平台,分享 Next.js、React 及全栈架构最佳实践。',
  robots: {
    index: true,
    follow: true,
    googleBot: {
      index: true,
      follow: true,
      'max-video-preview': -1,
      'max-image-preview': 'large',
      'max-snippet': -1,
    },
  },
  openGraph: {
    siteName: '技术极客周刊',
    locale: 'zh_CN',
    type: 'website',
  },
};

export default function RootLayout({
  children,
}: {
  children: React.ReactNode;
}) {
  return (
    <html lang="zh-CN">
      <body>{children}</body>
    </html>
  );
}
2. 动态路由元数据:利用 generateMetadata 提取动态内容
对于包含动态参数的详情页(如 app/posts/[slug]/page.tsx),需要使用 generateMetadata 函数根据入参异步计算元数据。
// app/posts/[slug]/page.tsx
import type { Metadata, ResolvingMetadata } from 'next';
import { notFound } from 'next/navigation';

interface Props {
  params: Promise<{ slug: string }>;
  searchParams: Promise<{ [key: string]: string | string[] | undefined }>;
}

// 模拟数据接口,实际场景中通常连接 CMS 或微服务
async function getPost(slug: string) {
  const res = await fetch(`https://api.example.com/posts/${slug}`, {
    next: { revalidate: 3600 }, // 配合 ISR 缓存 1 小时
  });
  if (!res.ok) return null;
  return res.json();
}

export async function generateMetadata(
  props: Props,
  parent: ResolvingMetadata
): Promise {
  const params = await props.params;
  const post = await getPost(params.slug);

  if (!post) {
    return {
      title: '内容未找到',
      robots: { index: false, follow: false },
    };
  }

  // 继承父级定义的图片或基础配置
  const previousImages = (await parent).openGraph?.images || [];

  return {
    title: post.title, // 将由 title.template 自动包装为:文章标题 | 技术极客周刊
    description: post.summary,
    alternates: {
      canonical: `/posts/${params.slug}`, // 自动由 metadataBase 拼接为完整绝对 URL
    },
    openGraph: {
      title: post.title,
      description: post.summary,
      url: `/posts/${params.slug}`,
      type: 'article',
      publishedTime: post.publishedAt,
      modifiedTime: post.updatedAt,
      authors: [post.authorName],
      images: [
        post.coverImage || '/images/default-post-cover.jpg',
        ...previousImages,
      ],
    },
    twitter: {
      card: 'summary_large_image',
      title: post.title,
      description: post.summary,
      images: [post.coverImage || '/images/default-post-cover.jpg'],
    },
  };
}

export default async function PostPage(props: Props) {
  const params = await props.params;
  const post = await getPost(params.slug);
  if (!post) notFound();

  return (
    <article>
      <h1>{post.title}</h1>
      <div>{post.content}</div>
    </article>
  );
}
关键注意:避免重度 await parent
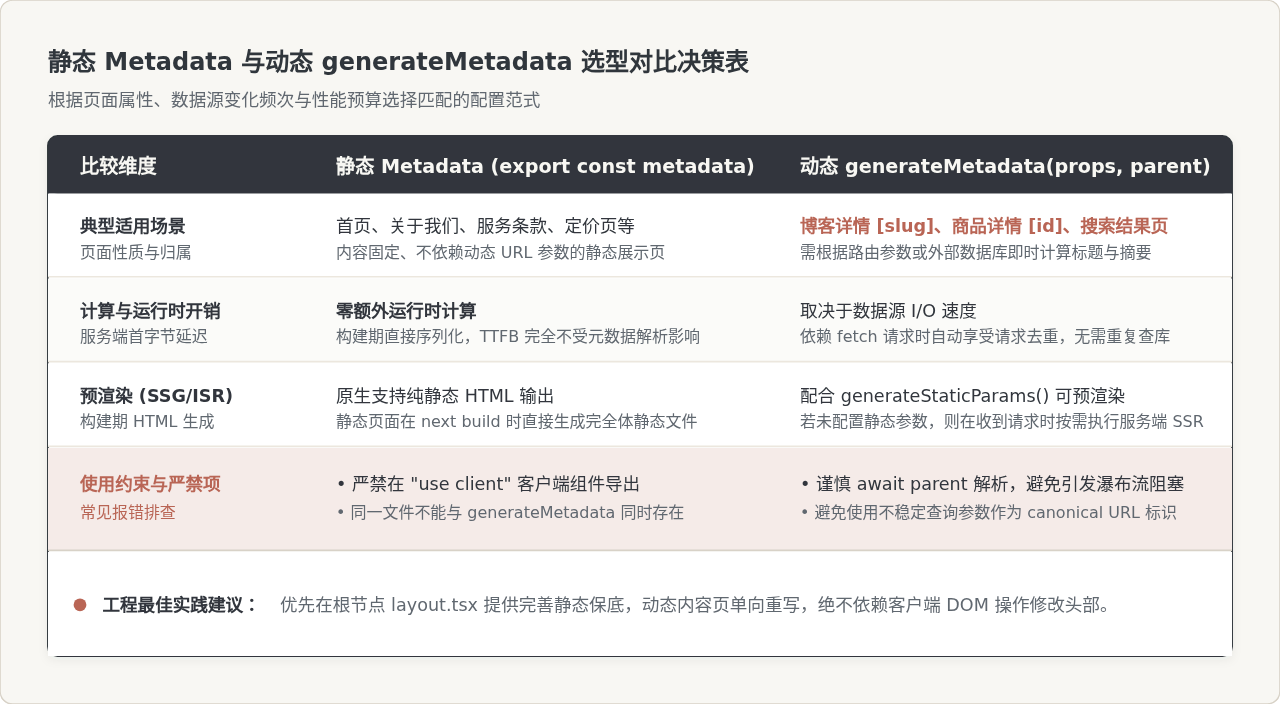
在 generateMetadata 中,parent 参数返回解析后的父级元数据 Promise。如果当前页面并不需要合并父级字段,请不要调用 await parent,否则会人为创建串行的服务端解析瀑布流,增加页面的 TTFB(首字节到达时间)。
三、全栈 SEO 配置实施路径
成熟的生产环境 SEO 并不仅仅依赖单一页面的标题填充,而是需要构建从全局基准、动态重写、爬虫索引分发到语义结构增强的四步闭环。
3. 代码驱动的 Sitemap 与 Robots 自动化生成
传统的静态 sitemap.xml 在内容频繁更新的中大型应用中极难维护。Next.js 允许在 app/sitemap.ts 和 app/robots.ts 中使用纯 TypeScript 代码按需生成。
// app/sitemap.ts
import type { MetadataRoute } from 'next';

export default async function sitemap(): Promise {
  const baseUrl = process.env.NEXT_PUBLIC_SITE_URL || 'https://www.example.com';

  // 1. 获取所有动态文章的标识与更新时间
  const postsRes = await fetch('https://api.example.com/posts/slugs', {
    next: { revalidate: 3600 },
  });
  const posts: Array<{ slug: string; updatedAt: string }> = await postsRes.json();

  const postEntries: MetadataRoute.Sitemap = posts.map((post) => ({
    url: `${baseUrl}/posts/${post.slug}`,
    lastModified: new Date(post.updatedAt),
    changeFrequency: 'weekly',
    priority: 0.8,
  }));

  // 2. 静态核心页面
  const staticRoutes: MetadataRoute.Sitemap = [
    {
      url: baseUrl,
      lastModified: new Date(),
      changeFrequency: 'daily',
      priority: 1.0,
    },
    {
      url: `${baseUrl}/about`,
      lastModified: new Date(),
      changeFrequency: 'monthly',
      priority: 0.5,
    },
  ];

  return [...staticRoutes, ...postEntries];
}
与此同时,配置规范的 robots.ts 引导合规爬虫并隔离内部接口:
// app/robots.ts
import type { MetadataRoute } from 'next';

export default function robots(): MetadataRoute.Robots {
  const baseUrl = process.env.NEXT_PUBLIC_SITE_URL || 'https://www.example.com';

  return {
    rules: [
      {
        userAgent: '*',
        allow: '/',
        disallow: ['/api/', '/admin/', '/auth/'],
      },
    ],
    sitemap: `${baseUrl}/sitemap.xml`,
  };
}
4. 语义化增强:JSON-LD 结构化数据注入
为了在 Google 和 Bing 中获得 Rich Results(如文章发布日期、作者头像、评分星星、面包屑层级),应当在页面 Server Component 中直接内联 JSON-LD。请使用 dangerouslySetInnerHTML 配合 JSON.stringify 进行格式化,由于数据由服务端直接组装,天然隔绝客户端 XSS 风险:
// app/posts/[slug]/page.tsx 内增加的结构化数据组件
export function ArticleJsonLd({ post }: { post: PostData }) {
  const jsonLd = {
    '@context': 'https://schema.org',
    '@type': 'TechArticle',
    headline: post.title,
    description: post.summary,
    image: post.coverImage,
    datePublished: post.publishedAt,
    dateModified: post.updatedAt,
    author: {
      '@type': 'Person',
      name: post.authorName,
      url: 'https://www.example.com/authors/' + post.authorSlug,
    },
    publisher: {
      '@type': 'Organization',
      name: '技术极客周刊',
      logo: {
        '@type': 'ImageObject',
        url: 'https://www.example.com/logo.png',
      },
    },
    mainEntityOfPage: {
      '@type': 'WebPage',
      '@id': `https://www.example.com/posts/${post.slug}`,
    },
  };

  return (
    <script
      type="application/ld+json"
      dangerouslySetInnerHTML={{ __html: JSON.stringify(jsonLd) }}
    />
  );
}
四、静态与动态元数据选型对比决策
在实际项目重构与搭建过程中,团队常在“到底该用静态对象还是动态函数”之间产生混淆。下表梳理了两者的核心差异、运行时代价及限制边界:
五、生产环境上线前 SEO 质量验收工作流
在正式部署上线前,必须执行系统化排查,防止配置疏漏导致收录异常。推荐按照四阶段推进验收:
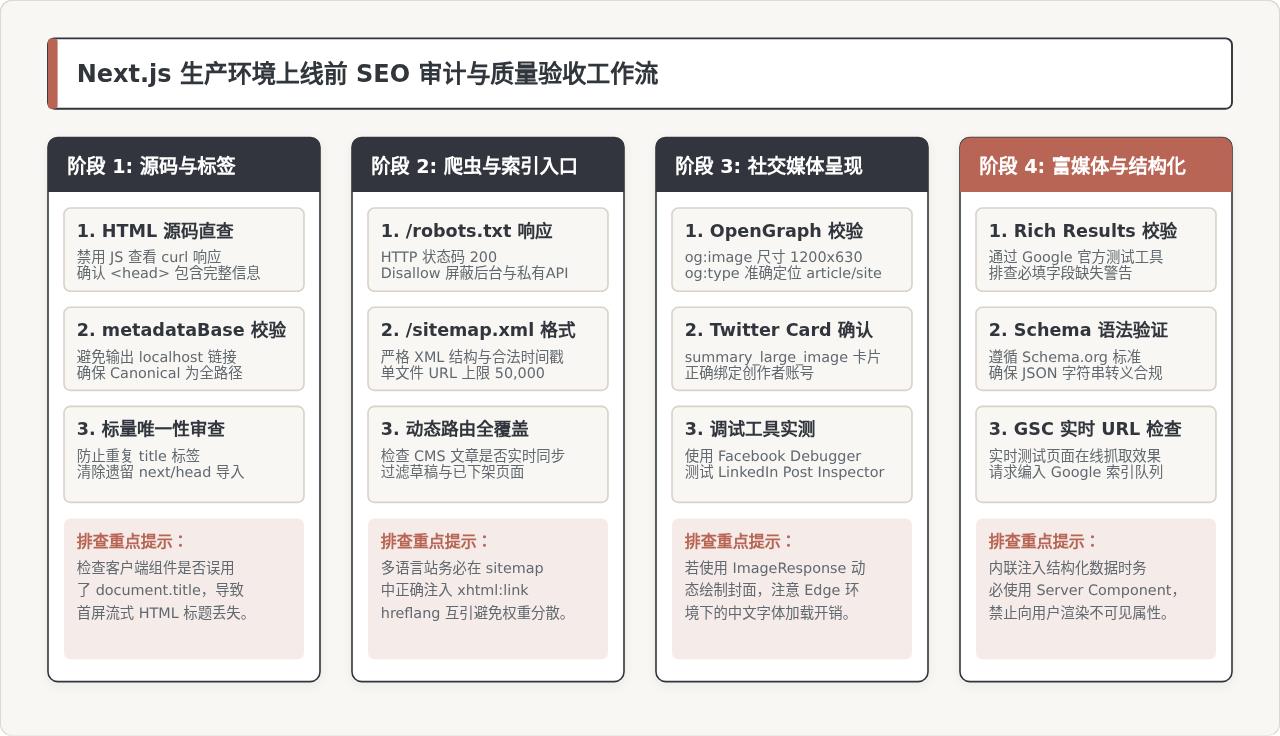
-
阶段一:直查 HTML 响应源码
使用终端执行curl -I -A "Googlebot" https://yourdomain.com/posts/test-slug检查响应头,再执行curl https://yourdomain.com/posts/test-slug | grep -E "title|canonical|og:"确认关键标量完整输出,避免因客户端组件重载而导致首屏元数据缺失。 -
阶段二:爬虫入口校验
直接浏览器访问/robots.txt与/sitemap.xml。确认 Sitemap 返回的 Content-Type 为application/xml,XML 节点标签闭合且时间戳为标准 ISO 格式。 -
阶段三:社交卡片调试器实测
将页面 URL 填入 Facebook Sharing Debugger 与 Twitter Card Validator,确认 og:image 能在 2 秒内加载成功,且尺寸达到推荐的 1200×630 像素。 -
阶段四:富媒体与结构化数据测试
使用 Google 官方的 Rich Results Test(富媒体结果测试)工具粘贴目标页面 URL,校验 JSON-LD 是否存在必要属性缺失警告,确保达到收录资格。
总结
Next.js App Router 将元数据管理提升到了服务端框架级优先地位。实现高质量 SEO 的核心原则可概括为:根级严守 metadataBase,动态路由按需 generateMetadata,Sitemap 与 Robots 由代码动态输出,页面底层植入 JSON-LD 结构化语义。只要严格遵循这一模式,应用即可在保证开发体验与渲染性能的同时,获得卓越的搜索引擎收录与社交传播表现。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章