
全面解析使用JavaScript递归实现数组扁平化的核心逻辑与四种主流方案,深入剖析调用栈推导、深度控制、Generator惰性迭代,并提供防循环引用与栈溢出的防御式编程规范。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
使用JavaScript递归实现数组扁平化的多种方法
作者:拾光
时间:2026-11-03
浏览:400
文章目录
技术精析
阅读时长:约 10 分钟
运行环境:Node.js / 现代浏览器 (ES6+)
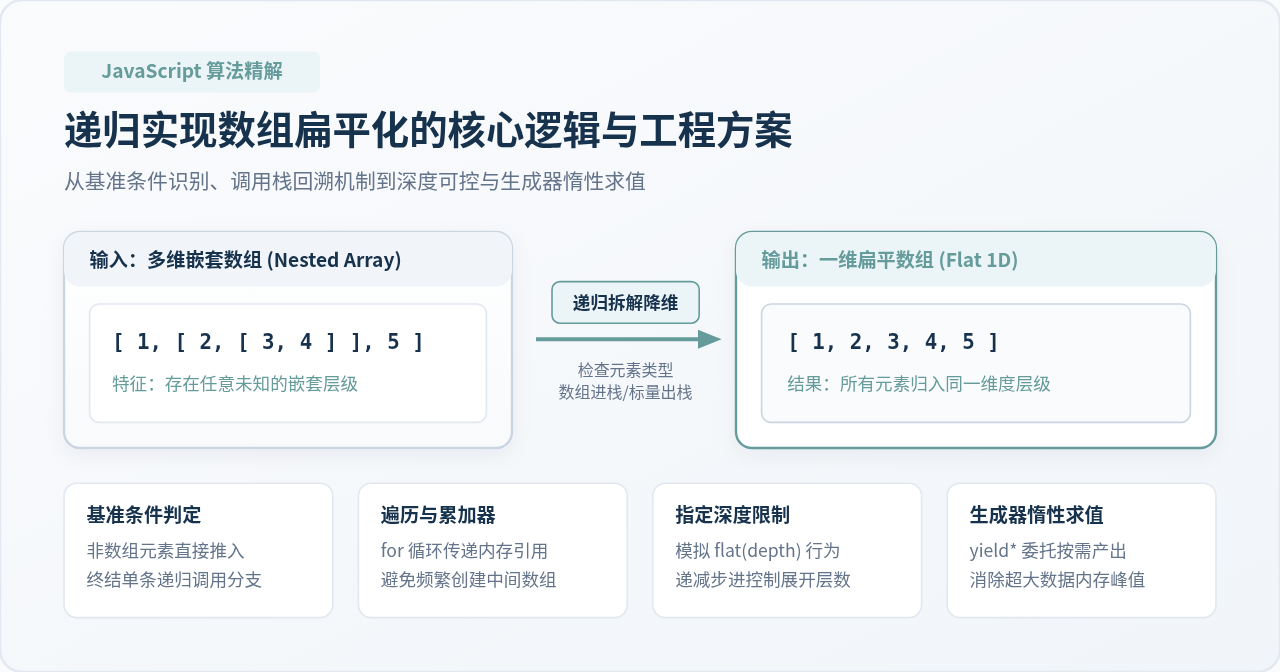
数组扁平化是指将多维嵌套数组结构逐层拆解,最终汇聚为无嵌套的一维数组。在处理树形层级数据、表单多维参数解析及报表汇总等业务场景中,扁平化是常见的基础操作。递归是解决多维结构最自然且普适的算法思维:遇到基础数据项则直接收集,遇到数组子项则建立子调用栈继续展开。本文将系统讲解普通循环、函数式 reduce、指定展开层数的深度控制,以及面向海量数据的 Generator 惰性生成器四种递归方案,并深入分析调用栈流动机制与生产级异常防御。
一、递归扁平化的核心逻辑与推导机制
在深入编码前,需要先理清递归算法的两个核心支柱:基准条件(Base Case)与递归步(Recursive Step)。数组扁平化的本质是对数组各节点进行深度优先遍历(DFS):
- 基准条件:检查遍历到的当前元素是否为数组类型。若
!Array.isArray(item),说明到达叶子节点,终止该分支的递归调用,直接将该项追加至结果集。 - 递归步:若当前项是数组(
Array.isArray(item) === true),说明仍存在下一层嵌套维度,将该子数组作为独立参数传入扁平化函数自身,启动新的调用栈帧。
以输入 [1, [2, [3]], 4] 为例,程序首先读取元素 1,命中基准条件推入结果;接着遇到 [2, [3]],触发第二层调用栈遍历;在第二层中遇到 [3],再次压入第三层调用栈;当第三层完成对 3 的收集后,栈帧逐级回溯并释放内存,最后处理顶层的 4,完成整组数据的降维。
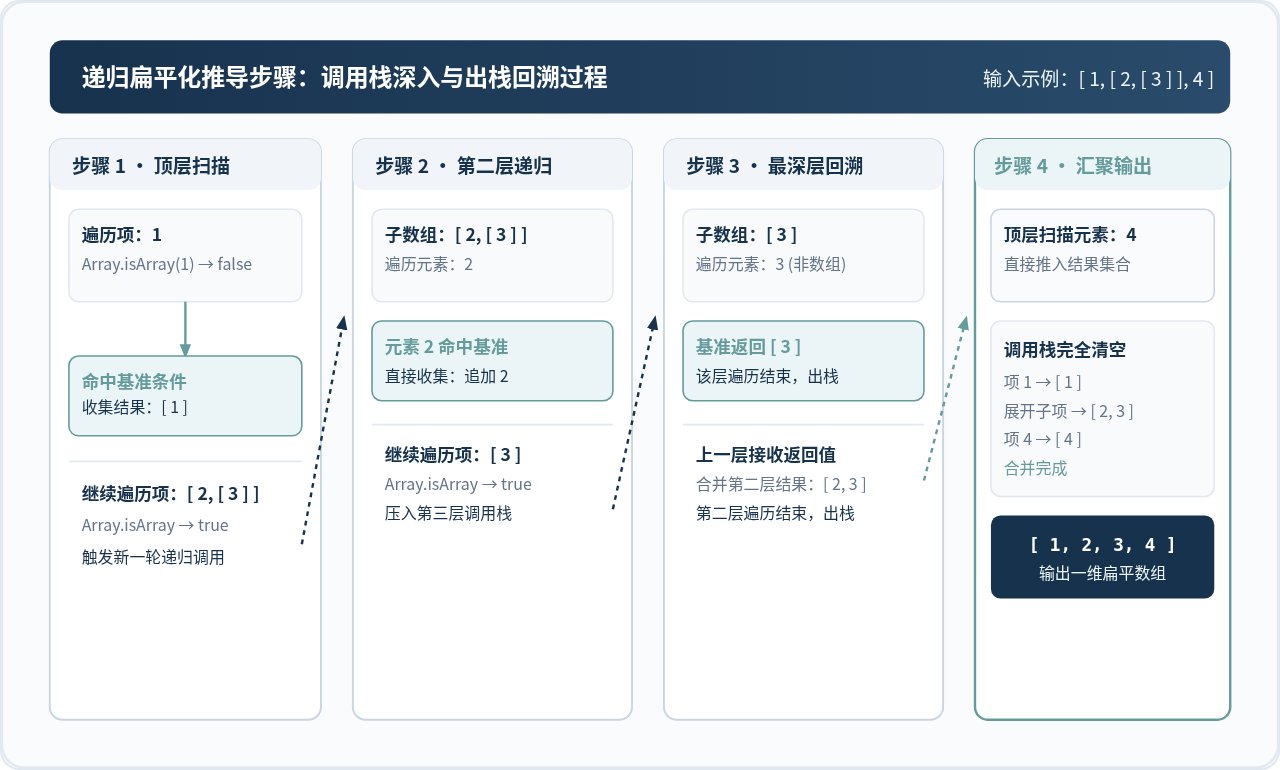
理解了调用栈的压入与出栈回溯流程后,我们可以根据工程中的性能考量、函数纯度要求以及数据规模,选择不同的递归实现方式。
二、方法一:基础循环遍历与递归推入(纯函数实现)
基础循环配合局部结果数组是工程中最实用、执行效率最高的一种递归写法。它通过函数内部维护的独立容器收集元素,既保证了函数的无副作用纯度,又消除了全局变量或外部状态污染的风险。
代码实现
/**
 * 使用 for...of 循环与递归实现全量数组扁平化
 * @param {Array} arr - 待扁平化的多维嵌套数组
 * @returns {Array} 展开后的一维数组
 */
function flattenByLoop(arr) {
  // 防御性校验:若输入非数组则直接返回空数组
  if (!Array.isArray(arr)) {
    return [];
  }

  const result = [];

  for (const item of arr) {
    if (Array.isArray(item)) {
      // 遇到嵌套数组,递归调用并将返回的一维结果解构推入当前容器
      result.push(...flattenByLoop(item));
    } else {
      // 命中基准条件:基础类型直接推入
      result.push(item);
    }
  }

  return result;
}
控制台运行与示例输出
const nestedData = [1, [2, 3], [4, [5, 6]], 7];
console.log(flattenByLoop(nestedData));
// 示例输出: [ 1, 2, 3, 4, 5, 6, 7 ]
console.log(flattenByLoop(nestedData));
// 示例输出: [ 1, 2, 3, 4, 5, 6, 7 ]
性能优化提示:上述实现中的
result.push(...flattenByLoop(item)) 在每一层子数组返回时会创建一个临时中间数组。若需要追求极致执行速度,可以通过内部辅助函数直接传递一个贯穿始终的 result 引用(形如 helper(arr, result)),直接在同一个数组尾部进行 push,将额外内存分配降至最低。
三、方法二:函数式编程 reduce 与递归拼接
在偏好函数式编程(Functional Programming)的团队中,利用 Array.prototype.reduce 配合递归是极为经典的声明式写法。它把累加器(accumulator)作为收集容器,将数组元素逐一折叠展开。
代码实现
/**
 * 使用 Array.prototype.reduce 与递归实现数组扁平化
 * @param {Array} arr - 待扁平化数组
 * @returns {Array} 扁平化后的一维数组
 */
function flattenByReduce(arr) {
  if (!Array.isArray(arr)) {
    return [];
  }

  return arr.reduce((accumulator, currentItem) => {
    return accumulator.concat(
      Array.isArray(currentItem) ? flattenByReduce(currentItem) : currentItem
    );
  }, []);
}
控制台运行与示例输出
const nestedData = ['a', ['b', ['c', 'd']], 'e'];
console.log(flattenByReduce(nestedData));
// 示例输出: [ 'a', 'b', 'c', 'd', 'e' ]
console.log(flattenByReduce(nestedData));
// 示例输出: [ 'a', 'b', 'c', 'd', 'e' ]
深层机制与性能警示:虽然
reduce + concat 代码优雅简洁,但 Array.prototype.concat 在底层执行时会创建并返回一个全新的数组浅拷贝。这意味着在深层嵌套或拥有数万个元素的数据集上,每次迭代都会产生大量短生命周期的临时数组,导致时间复杂度退化至近似 \(O(N^2)\),并对 V8 垃圾回收器(GC)带来显著停顿开销。因此该方案推荐在小规模数据或轻量工具函数中使用。
四、方法三:带深度控制的递归扁平化(模拟原生 flat(depth))
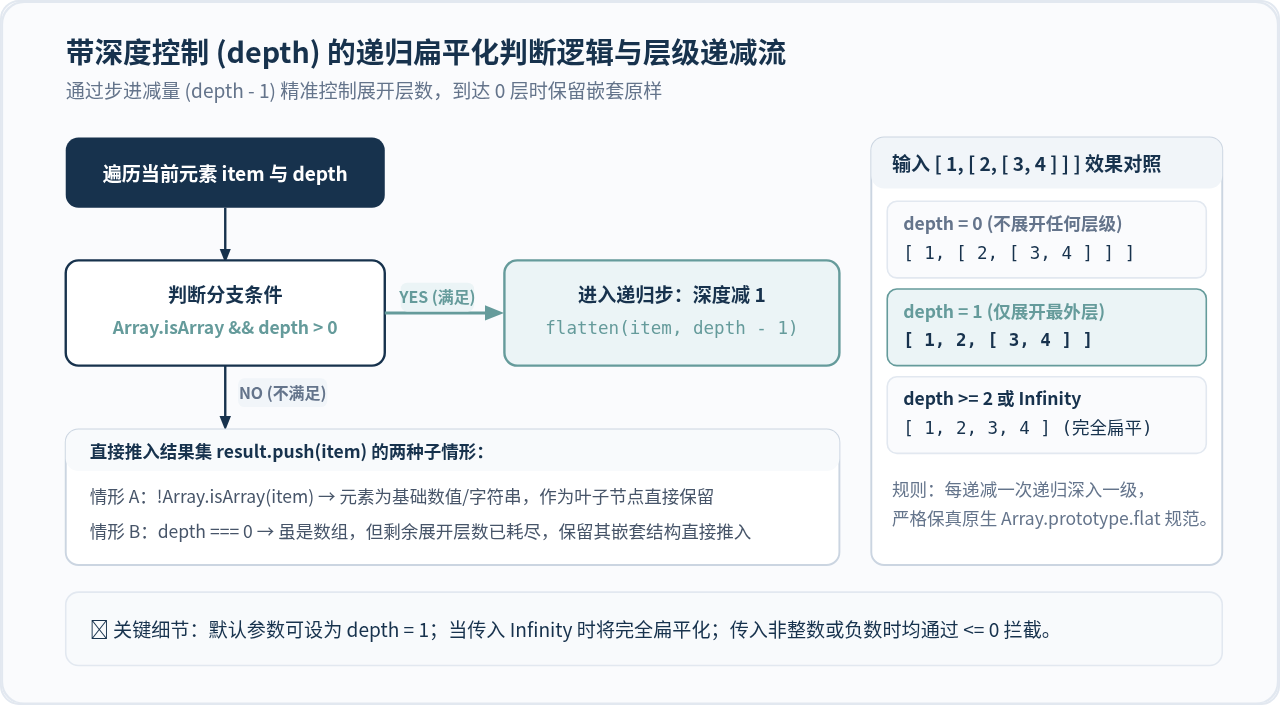
在实际业务开发中,开发者并不总是希望将数组“完全拍平”。例如,对于商品的多级类目结构,常常只需要将第一级或前两级子项打平,而保留底层的分类阵列。原生 ECMAScript 2019 引入的 Array.prototype.flat(depth) 正是基于这种诉求。
要实现可控深度的递归,关键在于引入一个 depth 计数器。每次进入递归分支时将其递减 1(depth - 1),一旦 depth <= 0,即使当前项仍然是嵌套数组,也将视同叶子节点直接推入,不再继续向下解构。
代码实现
/**
 * 支持自定义展开深度的递归扁平化实现
 * @param {Array} arr - 目标数组
 * @param {number} depth - 允许展开的最大层级,默认为 1
 * @returns {Array} 对应层级扁平化后的数组
 */
function flattenWithDepth(arr, depth = 1) {
  if (!Array.isArray(arr)) {
    return [];
  }

  // 深度小于等于 0 时,无需继续解构,返回原数组浅拷贝
  if (depth <= 0) {
    return arr.slice();
  }

  const result = [];

  for (const item of arr) {
    // 只有同时满足是数组且剩余展开深度大于 0 时才递归深入
    if (Array.isArray(item) && depth > 0) {
      result.push(...flattenWithDepth(item, depth - 1));
    } else {
      result.push(item);
    }
  }

  return result;
}
控制台运行与示例输出
const tree = [1, [2, [3, [4]]]];
console.log(flattenWithDepth(tree, 0));
// 示例输出 (depth=0): [ 1, [ 2, [ 3, [ 4 ] ] ] ]
console.log(flattenWithDepth(tree, 1));
// 示例输出 (depth=1): [ 1, 2, [ 3, [ 4 ] ] ]
console.log(flattenWithDepth(tree, 2));
// 示例输出 (depth=2): [ 1, 2, 3, [ 4 ] ]
console.log(flattenWithDepth(tree, Infinity));
// 示例输出 (完全展开): [ 1, 2, 3, 4 ]
console.log(flattenWithDepth(tree, 0));
// 示例输出 (depth=0): [ 1, [ 2, [ 3, [ 4 ] ] ] ]
console.log(flattenWithDepth(tree, 1));
// 示例输出 (depth=1): [ 1, 2, [ 3, [ 4 ] ] ]
console.log(flattenWithDepth(tree, 2));
// 示例输出 (depth=2): [ 1, 2, 3, [ 4 ] ]
console.log(flattenWithDepth(tree, Infinity));
// 示例输出 (完全展开): [ 1, 2, 3, 4 ]
由于传入 Infinity 时,Infinity - 1 依然为 Infinity,条件 depth > 0 将始终保持成立,因此该函数天然无缝支持传入 Infinity 进行无限制深度扁平化,行为与原生 Array.prototype.flat 高度吻合。
五、方法四:Generator 生成器与 yield* 递归(惰性求值)
传统递归方法无论如何优化,在调用结束之前都必须在内存中构建出完整的扁平数组。如果嵌套数组包含十万、百万级数据项,或者数据源本身是动态分页流,一次性全量递归可能直接导致页面卡顿或进程内存溢出(OOM)。
ES6 提供的 Generator(生成器函数)为这一问题提供了优雅的解法。结合 yield* 关键字,生成器可以递归地将迭代权委托给子生成器,实现按需产生数据(Lazy Evaluation)。
代码实现
/**
 * 使用 Generator 生成器与 yield* 递归实现惰性数组扁平化
 * @param {Array} arr - 待遍历的多维数组
 * @yields {*} 逐一产出的一维元素
 */
function* flattenGenerator(arr) {
  if (!Array.isArray(arr)) {
    return;
  }

  for (const item of arr) {
    if (Array.isArray(item)) {
      // 利用 yield* 递归委托给新的生成器实例
      yield* flattenGenerator(item);
    } else {
      // 命中基准条件:按需向外产出单个元素
      yield item;
    }
  }
}
控制台运行与示例输出
const bigTree = [10, [20, [30, 40]], 50];
// 1. 按需消费:随时可以 break 终止后续递归遍历,无需构建全量数组
for (const val of flattenGenerator(bigTree)) { console.log('消费元素:', val); if (val === 20) break; // 提前退出,后续子数组完全不产生多余递归与计算 }
// 示例输出:
// 消费元素: 10
// 消费元素: 20
// 2. 一次性获取全量数组:配合解构或 Array.from
const flatArray = [...flattenGenerator(bigTree)];
console.log(flatArray);
// 示例输出: [ 10, 20, 30, 40, 50 ]
// 1. 按需消费:随时可以 break 终止后续递归遍历,无需构建全量数组
for (const val of flattenGenerator(bigTree)) { console.log('消费元素:', val); if (val === 20) break; // 提前退出,后续子数组完全不产生多余递归与计算 }
// 示例输出:
// 消费元素: 10
// 消费元素: 20
// 2. 一次性获取全量数组:配合解构或 Array.from
const flatArray = [...flattenGenerator(bigTree)];
console.log(flatArray);
// 示例输出: [ 10, 20, 30, 40, 50 ]
Generator 方案的核心优势在于空间复杂度从 \(O(N)\) 降低至 \(O(D)\)(\(D\) 为嵌套深度)。对于只消费前几个满足条件元素的场景,其效率相比全量递归有着数量级的提升。
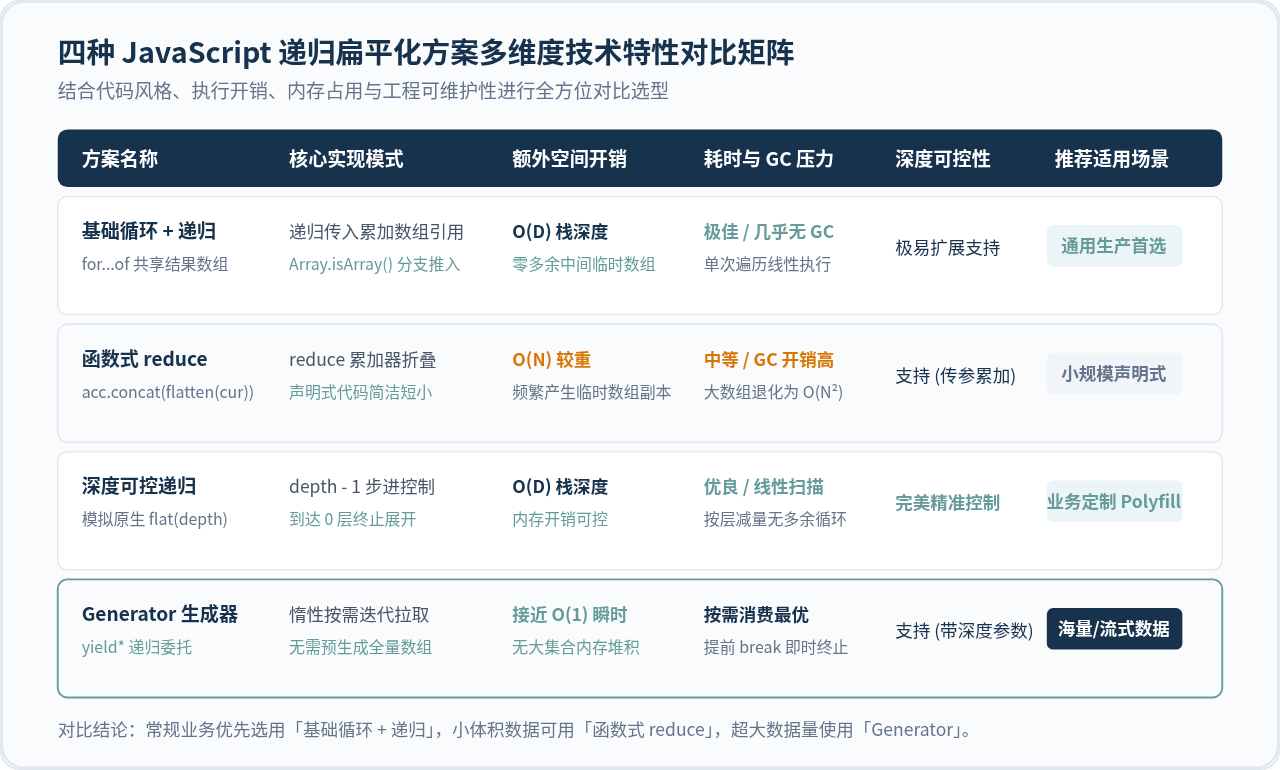
六、四种递归方案多维度技术特性对比
为了帮助开发者在技术选型时权衡利弊,下表与矩阵图综合对比了四种方案的语法特点、时空复杂度及适用工程环境。
| 方案分类 | 时间复杂度 | 额外内存开销 | 深度控制 | 核心优势与适用场景 |
|---|---|---|---|---|
| 循环 + 递归 (for...of) | \(O(N)\) | 极低 (仅单次结果集与调用栈) | 易于拓展 | 执行性能最好,适合生产级基础通用函数库。 |
| 函数式 reduce | \(O(N^2)\) | 高 (大量临时中间数组) | 支持 | 代码短小精炼,适合处理层级浅、体量小的临时数据。 |
| 带深度控制递归 | \(O(N)\) | 低 | 原生级精准 | 完美模拟 flat(depth),适用于需要向后兼容但只部分降维的业务。 |
| Generator 生成器 | \(O(K)\) (按需消费 \(K\) 项) | \(O(D)\) 栈开销 | 支持 | 按需拉取,支持提前 break,适合海量数据流或长列表按需渲染。 |
七、生产环境中的边界陷阱与防御式编程
在生产级工程代码中,输入数据往往充满不确定性。直接编写简易递归函数极易遭遇以下三类经典边界问题:
1. 循环引用风险(Circular Reference)
当复杂对象中的数组引用了自身或父级数组时,普通递归将陷入死循环,迅速触发 RangeError: Maximum call stack size exceeded。通过 WeakSet 记录已经访问过的数组引用,可以在进入递归前进行碰撞检测。
/**
 * 具备防循环引用机制的安全扁平化函数
 */
function safeFlatten(arr, depth = Infinity, seen = new WeakSet()) {
  if (!Array.isArray(arr)) return [];
  if (depth <= 0) return arr.slice();

  // 若当前数组已被访问过,立即跳过以避免死循环
  if (seen.has(arr)) {
    return [];
  }
  seen.add(arr);

  const result = [];
  for (const item of arr) {
    if (Array.isArray(item)) {
      result.push(...safeFlatten(item, depth - 1, seen));
    } else {
      result.push(item);
    }
  }
  return result;
}
2. 稀疏数组(Sparse Arrays)与空槽处理
JavaScript 允许创建稀疏数组,例如 [1, , 3] 中索引 1 处为空槽(empty slot)。原生 flat() 会自动过滤掉空槽,但使用 for...of 遍历时,空槽会被读取为 undefined 并推入结果中。若需完全贴合原生行为,可使用 0 in arr 检查或改用 forEach 进行跳过。
3. 最大调用栈溢出(Call Stack Overflow)
V8 引擎通常对函数调用栈深度限制在约 10,000 层左右。如果面对深度超过数万层的极端嵌套结构,任何纯函数式递归都会面临栈溢出。对于这种极限场景,需要通过人工显式维护一个堆栈数组(模拟系统栈)将其重构成迭代(Iterative)展开算法。
八、总结与技术选型决策路径
递归是解构多层嵌套数据最贴切的算法范式。在项目落地时,无需盲目照搬某一种单一实现,而应遵循清晰的决策路径:
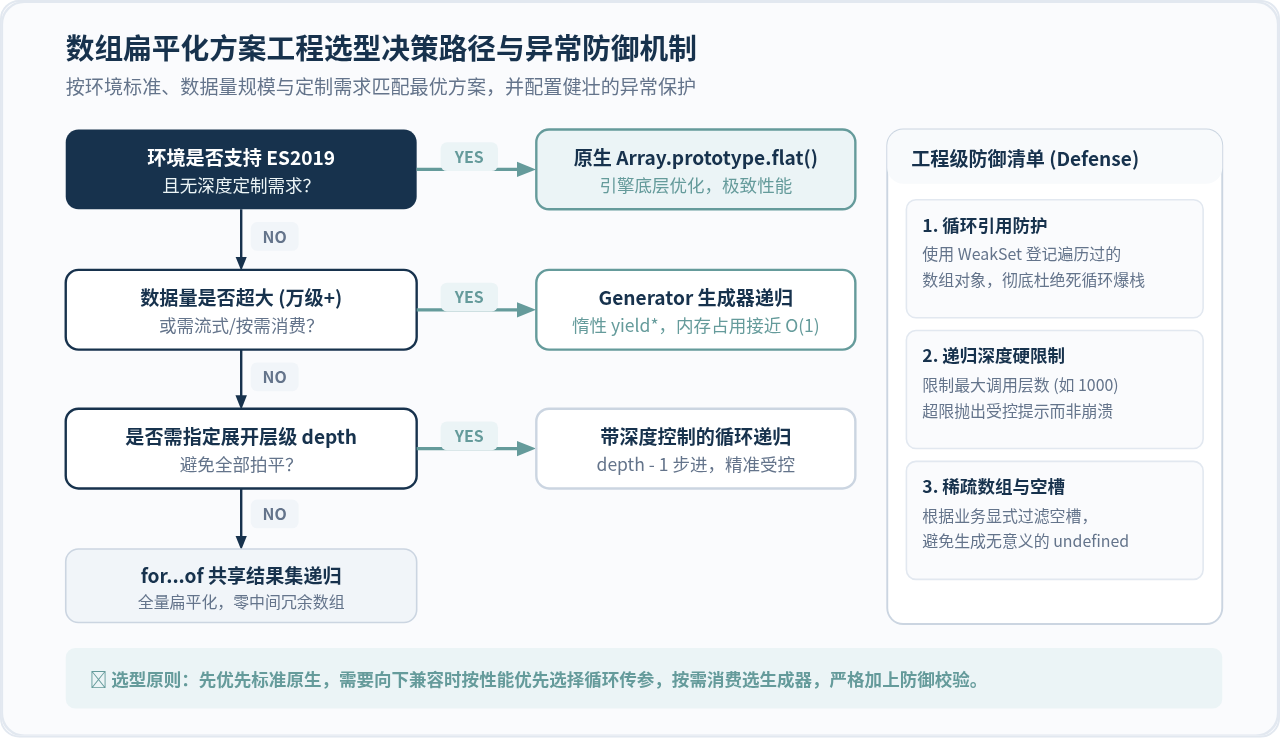
具体建议总结如下:
- 优先使用原生标准:在现代浏览器与 Node.js 生产环境中,优先选用原生的
Array.prototype.flat(depth)。原生方法由底层 C++ 编写,且针对 V8 内部数组类型(Fast Elements)做了针对性内联优化,性能显著优于任何 JavaScript 模拟实现。 - 向下兼容与自研 Polyfill:若需兼容不支持该特性的旧运行环境或进行客制化拦截,推荐采用基础循环 + 结果集引用的递归方案,兼具高执行效率与适中的代码复杂度。
- 超大数据与无限流:当数据量达到万级以上或需要分页、流式逐步消费时,果断采用 Generator + yield* 生成器方案,最大程度减少瞬时内存堆积。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章