
深入解析利用JavaScript闭包实现函数柯里化(Currying)的核心步骤与底层原理。从形参探测、闭包作用域参数持久化到递归分流判定,全面拆解通用柯里化函数的构建过程与边界陷阱。

当前位置:首页 > JavaScript 函数与作用域 > 正文
JS闭包实现函数柯里化(Currying)的步骤解析
作者:小括号
时间:2026-11-02
浏览:460
文章目录
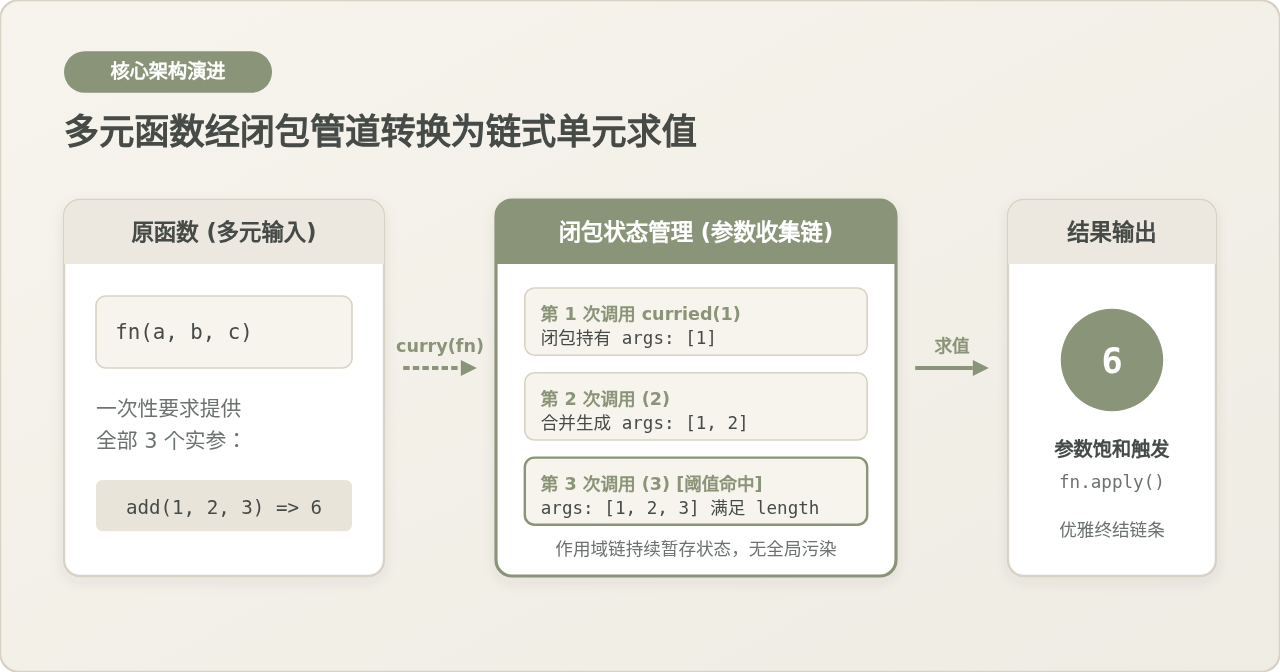
函数柯里化(Currying)指的是将一个接收多个参数的函数,转化为一系列分别接收单个(或部分)参数并返回新函数的技术。在 JavaScript 中,实现柯里化的核心基石是「闭包」(Closure):通过函数嵌套形成的词法作用域链,在各级函数执行出栈后,仍将先前传入的参数持久保存在堆内存中,直到累计收集的参数数量达到目标函数的形参长度,最终触发原函数求值。掌握这一过程不仅能编写出灵活的柯里化包装器,更能帮助开发者透彻理解 JavaScript 内存模型中调用栈与词法环境的协同机制。
一、闭包在柯里化中的工作机制与内存视角
在通常的 JavaScript 函数执行中,函数的局部变量分配在当前执行上下文的栈帧(Stack Frame)中。一旦函数执行完毕并返回,该栈帧随即出栈销毁,局部变量的生命周期也宣告结束。例如常规调用 add(1, 2, 3) 时,三个参数被一次性传入并在单个执行帧内直接计算完成。
而在柯里化模式下,调用形态转变为 curriedAdd(1)(2)(3)。每一次括号调用都是一个独立的函数执行过程:
- 第一次调用
curriedAdd(1)执行完毕后,栈帧弹出;但它返回了一个新的内部函数。该内部函数的内部隐藏属性[[Scopes]]引用了外层函数的词法环境(Lexical Environment)。 - 由于存在这个跨层级的外部引用,JavaScript 垃圾回收器(GC)不会回收包含参数
1的词法环境,该作用域被转移到堆内存(Heap)中作为闭包持久留存。 - 第二次调用
(2)时,返回的函数从闭包中读取之前的参数[1],与当前参数2合并为[1, 2],再次封装进新的闭包环境并返回下一层函数。 - 第三次调用
(3)时,累计参数达到三个,已满足原函数执行条件,此时直接调用底层函数完成计算并返回结果,整条闭包链的使命随之达成。
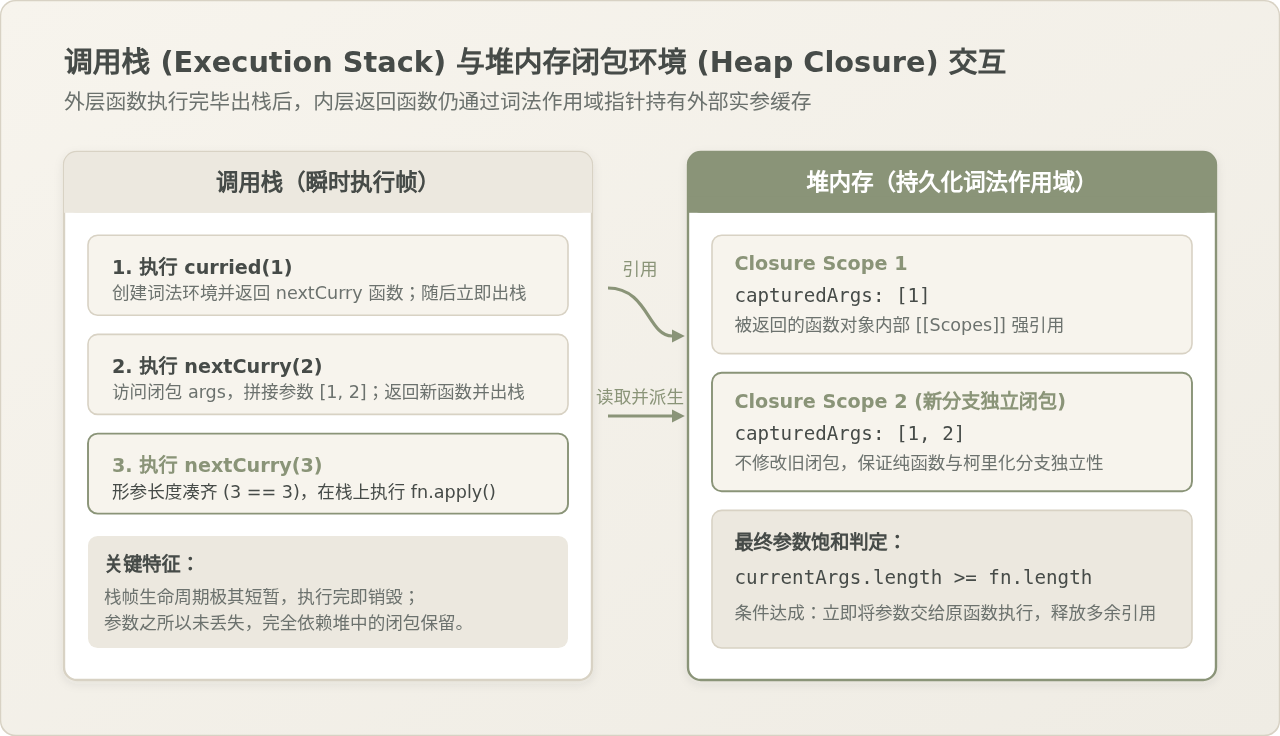
理解这一点的关键在于:闭包承担了“参数状态暂存池”的角色。它替代了可能造成全局污染的外部全局数组,为每次柯里化衍生出独立、互不干扰的参数记忆通道。
二、利用闭包实现通用柯里化的具体步骤拆解
构建一个通用的柯里化工具函数(通常命名为 curry),需要建立清晰的参数探测、闭包捕获、递归分流与上下文绑定机制。下面按照实际编码顺序分步剖析。
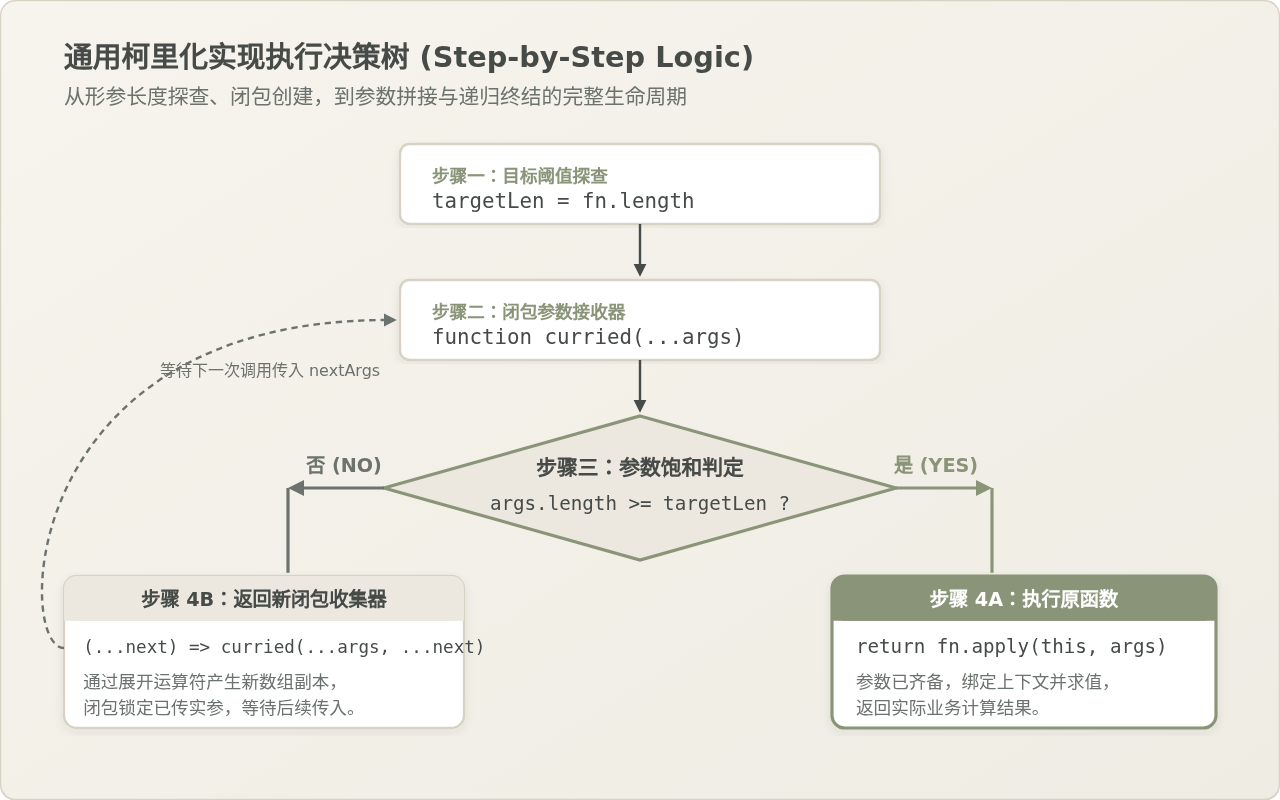
步骤一:明确原函数的目标形参长度
柯里化函数必须知道原函数到底期望接收多少个参数,以此作为递归何时结束的判断标准。在 JavaScript 中,可以通过访问函数对象的 length 属性(即 fn.length)来获取其声明的形参个数。
// 示例:探查形参长度
function add(a, b, c) {
  return a + b + c;
}
console.log(add.length); // 输出: 3 (表明原函数是 3 元函数)
步骤二:构建外层包装函数与闭包参数接收器
外层函数 curry(fn) 接收目标函数作为输入,其内部需要定义并返回一个执行收集任务的闭包函数(此处命名为 curried)。该函数利用 ES6 剩余参数(Rest Parameters)...args 动态接收当前调用所传入的实参。
function curry(fn) {
  // 闭包收集器
  return function curried(...args) {
    // 待补充判定与递归逻辑
  };
}
步骤三:设计参数饱和判定条件(递归出口)
在 curried 执行时,必须对比当前累计收集的参数数量 args.length 与目标函数的形参长度 fn.length。这里分为两种情况:
- 分支 A(参数已凑齐):若
args.length >= fn.length,说明所有必需参数均已就绪,立即终止递归,执行原函数。 - 分支 B(参数未凑齐):若
args.length < fn.length,说明参数尚有欠缺,必须返回一个新的函数,继续等待接收后续参数。
步骤四:分流处理——递归返回新闭包与上下文透传
当进入分支 B 时,返回的新函数在被调用时会接收下一批参数 ...nextArgs。此时的核心做法是通过数组拼接产生全新参数列表,并再次调用 curried:
// 分支 B: 未凑齐参数时,返回新闭包函数
return function(...nextArgs) {
  // 展开旧实参与新实参,组合成新数组传给下一次 curried 调用
  return curried.apply(this, args.concat(nextArgs));
};
关键细节:严禁使用原地修改操作(如 args.push)
在合并参数时,必须使用 args.concat(nextArgs) 或 [...args, ...nextArgs] 生成新的数组副本,绝不能执行 args.push(...nextArgs) 原地修改。如果直接修改原数组,当基于同一个柯里化中间函数派生多个子函数时(如 const add5 = curried(5); add5(1); add5(2);),后一次调用将污染前一次的闭包数组,破坏函数的纯度与复用性。
当进入分支 A(参数已满足)时,调用原函数。为了保证原函数如果依赖 this(例如作为对象方法时)能够正确解析上下文,必须通过 fn.apply(this, args) 进行调用,而不是直接裸调用 fn(...args)。
步骤五:整合完整通用柯里化代码与测试验证
将上述步骤组合,即可得到一个健壮、完备的通用柯里化函数实现。下面给出生产环境中常见的 ES6 标准实现以及验证代码:
/**
 * 通用柯里化包装函数
 * @param {Function} fn - 需要被柯里化的目标函数
 * @param {number} [arity=fn.length] - 目标形参长度(支持显式指定)
 * @returns {Function} 柯里化后的高阶函数
 */
function curry(fn, arity = fn.length) {
  return function curried(...args) {
    // 条件判定:已接收实参数量是否达到目标长度
    if (args.length >= arity) {
      // 达成条件:绑定上下文并执行原函数
      return fn.apply(this, args);
    } else {
      // 未达成条件:返回新闭包,捕获当前 args 并等待 nextArgs
      return function(...nextArgs) {
        return curried.apply(this, args.concat(nextArgs));
      };
    }
  };
}

// ================= 运行验证 =================
function sum(a, b, c) {
  return a + b + c;
}

const curriedSum = curry(sum);

// 验证方式 1:标准单参数链式调用
console.log(curriedSum(1)(2)(3)); // 输出: 6

// 验证方式 2:混合传参调用(一次传多个)
console.log(curriedSum(1, 2)(3)); // 输出: 6
console.log(curriedSum(1)(2, 3)); // 输出: 6

// 验证方式 3:分支复用独立性测试
const addTen = curriedSum(10);
console.log(addTen(1)(2)); // 输出: 13
console.log(addTen(5)(5)); // 输出: 20 (验证 addTen 未受前次调用影响)
三、容易混淆的概念辨析与边界陷阱
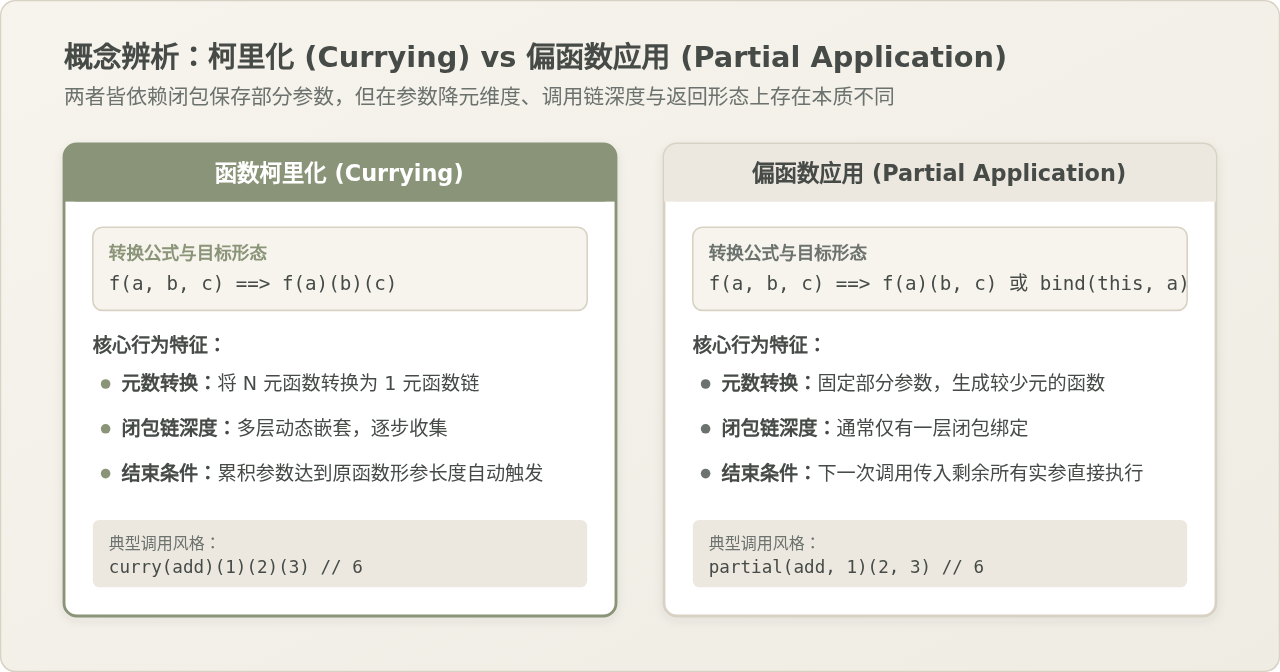
在学习和应用闭包柯里化的过程中,有两处非常容易产生理解偏差的地方:一是将柯里化与偏函数混为一谈;二是盲目依赖 fn.length 而忽略 ES6 语言规范的特殊边界。
辨析一:柯里化与偏函数应用(Partial Application)的区别
不少人常说:“给函数预先传入几个参数存到闭包里,之后再调就是柯里化。”这种说法在直觉上容易让人接受,因为它准确说出了闭包固定参数的作用,但在概念定义上是不严谨的。
- 函数柯里化(Currying):数学意义上的柯里化是将一个 $N$ 元函数严格转化为 $N$ 个互相嵌套的 $1$ 元函数序列(即 $f(a, b, c) o f(a)(b)(c)$)。在工程实现中,虽然允许一次传入多个参数,但它的本质目标是建立渐进式的参数求值链条,直到形参全部饱和。
- 偏函数应用(Partial Application):其核心意图是一次性固定原函数的某一部分参数,产生一个参数更少的新函数(例如 $f(a, b, c) o f'(b, c)$)。原生 JavaScript 中的
Function.prototype.bind就是典型的偏函数实现,它通常只经历一次参数预设和一次最终执行。
辨析二:fn.length 的边界陷阱与应对方案
柯里化依赖 fn.length 确定参数终止阈值,但在现代 JavaScript 中,fn.length 的取值规则有明确的规范限制:
| 参数定义形式 | 函数示例 | fn.length 计算结果 | 潜在影响与说明 |
|---|---|---|---|
| 标准普通形参 | function(a, b, c) {} |
3 |
符合预期,柯里化正常递归至 3 个参数。 |
| 带默认值的参数 | function(a, b = 1, c) {} |
1 |
length 遇到第一个具有默认值的形参即停止计数,导致后续参数无法被统计。 |
| 剩余参数 (...rest) | function(...args) {} |
0 |
剩余参数不计入形参长度,柯里化外层直接认为参数已满足并提前触发。 |
为了避免这一陷阱,通用的解决方案是在 curry 函数中提供第二个可选参数 arity(元数):当目标函数包含默认参数或剩余参数时,允许调用方显式指定期望的参数个数,如 curry(dynamicFn, 3)。
四、实战场景:闭包柯里化的实际应用价值
柯里化并非仅仅是面试中的学术题,在日常前端架构和工具库开发中,它能够显著提升代码的复用度与表现力。
场景一:基础工具函数的配置化与参数预设
假设系统中需要频繁验证不同类型的字符串(如手机号、邮箱、纯数字)。原生正则测试函数通常需要同时接收“正则表达式”和“目标文本”两个参数:
// 基础检验函数
const checkRegex = curry((regex, str) => regex.test(str));

// 通过柯里化预先固化规则,衍生出专用校验工具
const isPhoneNumber = checkRegex(/^1[3-9]\d{9}$/);
const isEmail = checkRegex(/^[\w.-]+@[\w.-]+\.\w+$/);

// 业务端使用时极其精炼,无需重复传递正则表达式
console.log(isPhoneNumber('13800138000')); // true
console.log(isEmail('service@example.com')); // true
在这里,闭包将配置项(正则表达式)安全地锁留在内层作用域中,业务调用方只需关心变化的数据(字符串),有效隔离了关注点。
场景二:函数组合(Compose / Pipe)中的单元适配
在纯函数管道(Pipeline)处理中,各环节函数通常只接受一个输入并产生一个输出(单参数函数)。柯里化能够将原本多元的数据处理操作(如数组查找、数据属性提取)适配为一元操作符,无缝融入管道流。
// 属性提取函数 (原本需要 obj, key 两个参数)
const getProp = curry((key, obj) => obj[key]);

// 配合数组原生方法 map 使用
const userList = [
  { id: 1, name: 'Alice' },
  { id: 2, name: 'Bob' }
];

// 直接作为回调传入,无需编写冗余箭头函数 user => user.name
const names = userList.map(getProp('name'));
console.log(names); // ['Alice', 'Bob']
五、柯里化实现要素与闭包检查清单
在实际编写或代码审查(Code Review)柯里化逻辑时,可以通过以下四个核心维度进行检查,确保逻辑的完备性与执行性能:
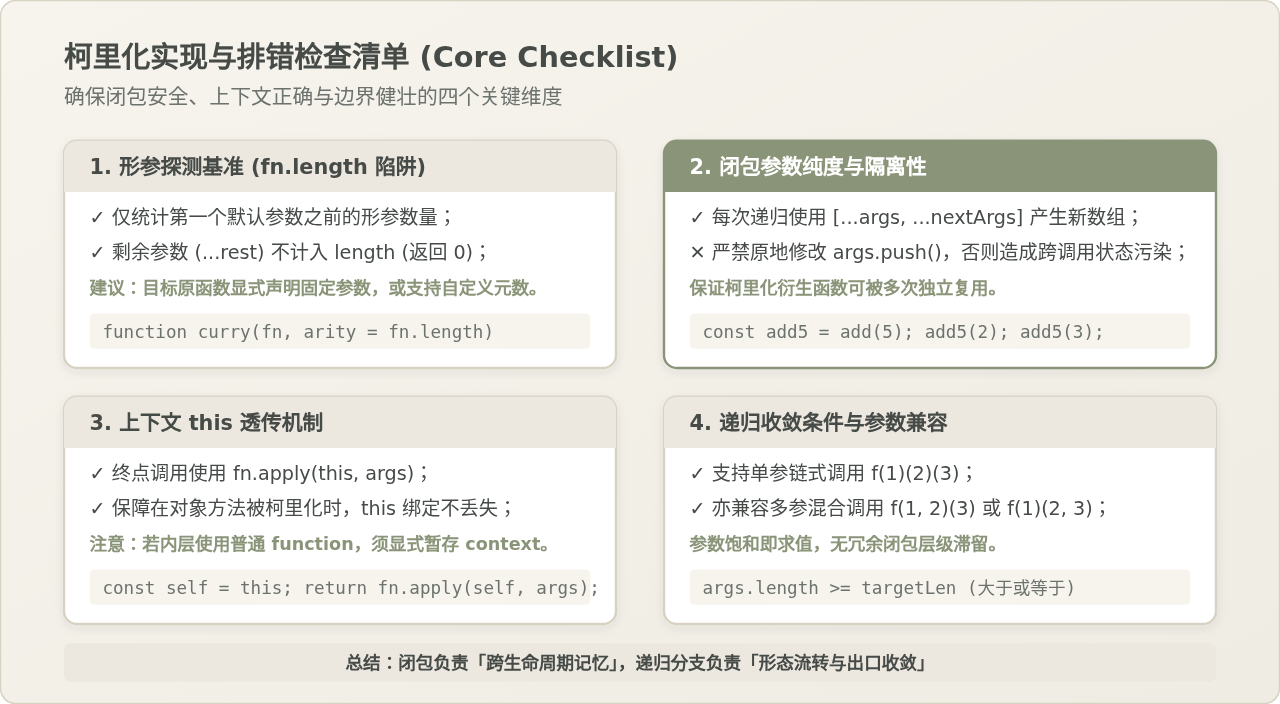
- 形参基准是否稳固:检查目标函数是否含有默认参数或 Rest 参数;若有,是否传入显式
arity参数。 - 闭包数组是否纯净:参数合并是否使用
concat或解构赋值生成新数组,杜绝原地push导致跨调用共享污染。 - 上下文是否完整传递:在执行原函数
fn时,是否使用apply(this, args)维持原宿主对象的绑定。 - 递归收敛是否无遗漏:判断条件应使用
>=而非===,以确保一次性传入多于所需参数时也能正常执行。
结语
JavaScript 闭包为函数赋予了“跨越调用生命周期的记忆能力”,而柯里化正是这种能力在函数式编程思想下的经典应用。通过五步解析——从获取 fn.length 确立目标、构建收集闭包、设置阈值分支、到利用纯数组合并递归推进并最终绑定上下文求值,柯里化的运作机制变得清晰明了。在实际开发中,合理运用柯里化可以极大减少模板代码,提升函数的组合性与模块复用价值。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章