
深入解析如何基于经典著作《JavaScript DOM编程艺术》构建扎实的Web标准基础,系统讲解结构与行为解耦、渐进增强、平稳退化、DOM核心API及在现代前端开发中的思想延续。

当前位置:首页 > JavaScript DOM 与事件 > 正文
怎么基于《JavaScript DOM编程艺术》构建Web标准基础
作者:像素猫
时间:2026-10-30
浏览:642
文章目录
构建扎实的 Web 标准基础,核心并不在于机械记忆繁多的 API 语法,而在于建立以“结构、表现与行为三层解耦”为支柱、以“渐进增强与平稳退化”为底线的规范化工程思维。《JavaScript DOM编程艺术》(DOM Scripting)作为 Web 开发领域的经典著作,其精髓正是系统化地阐明了这一底层逻辑。通过理解 W3C DOM 的树形本质、严格摒弃侵入式内联脚本、坚持特性检测与防御性编码,开发者能够从根本上摆脱对具体运行环境的脆弱依赖,为后续掌握现代前端框架与复杂工程架构筑牢底层基石。
一、确立三层分离架构:结构、表现与行为的明确解耦
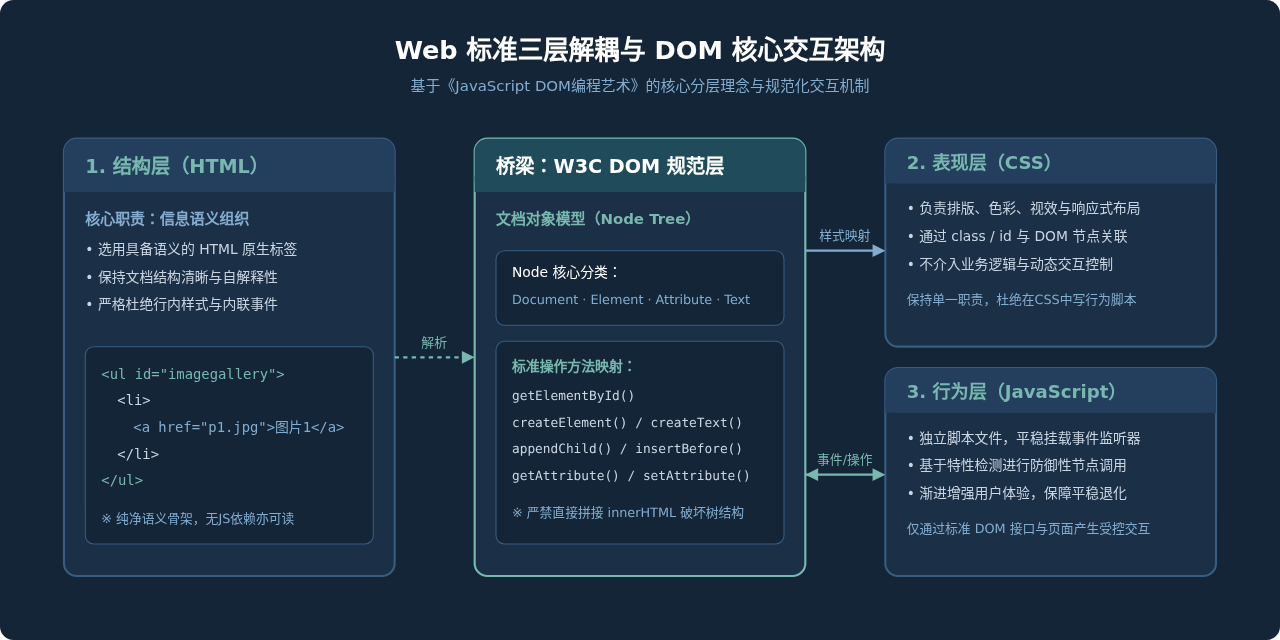
在早期的 Web 页面制作中,开发者常将呈现逻辑(如 <font> 标签)、交互逻辑(如 onclick="..." 行内属性)与文档内容混杂在 HTML 页面中。这种做法直接导致代码可读性极差、复用率低下,且任何一处的逻辑改动都极易造成页面布局或行为的崩溃。《JavaScript DOM编程艺术》开篇便确立了现代 Web 标准的最底层原则:三层职责分离。
- 结构层(HTML):负责承载文档的数据内容与信息层级。必须采用具备良好语义的 HTML 原生标签(如
<ul>、<p>、<h1>等),杜绝行内样式属性与内联 JavaScript 代码。 - 表现层(CSS):负责视觉样式、页面排版、色彩方案与跨终端响应式布局。通过样式表与 HTML 节点选择器建立映射,不干预文档核心数据与动态交互。
- 行为层(JavaScript):以独立脚本文件形式存在,负责监听用户交互事件并按需动态变更视图状态。行为层不应直接拼接大段带有内联属性的 HTML 字符串,而必须通过 W3C 规范的 DOM 接口操作节点树。
DOM(Document Object Model,文档对象模型)在此架构中扮演了核心桥梁的角色。浏览器解析 HTML 文本并将其构建为内存中的树状对象(Node Tree),包含 Document、Element、Attribute 与 Text 等节点。JavaScript 只能且必须通过规范的 DOM API 与节点树进行安全对话。
二、掌握平稳退化与渐进增强的核心思想
在前端交互设计中,很多开发者习惯假定用户处于理想的运行环境:最新的现代浏览器、高速网络、JavaScript 正常加载且未被拦截。然而实际情况是,弱网丢包、网络安全插件拦截、特定无障碍辅助设备(如屏幕阅读器)或企业内网限制,都可能导致脚本无法执行。《JavaScript DOM编程艺术》强调的两个互补概念正是解决这一痛点的关键:
- 平稳退化(Graceful Degradation):确保在不支持或未开启 JavaScript 的环境下,用户仍然能够顺利访问到网页的基础信息并完成最核心的功能操作,页面虽缺少高级动效,但内容绝不中断或损毁。
- 渐进增强(Progressive Enhancement):开发流程自底向上推进。首先使用结构良好的 HTML 标记完整呈现内容,再以 CSS 增添视觉美感,最后以 JavaScript 作为增强层提供平滑流畅的就地交互体验。
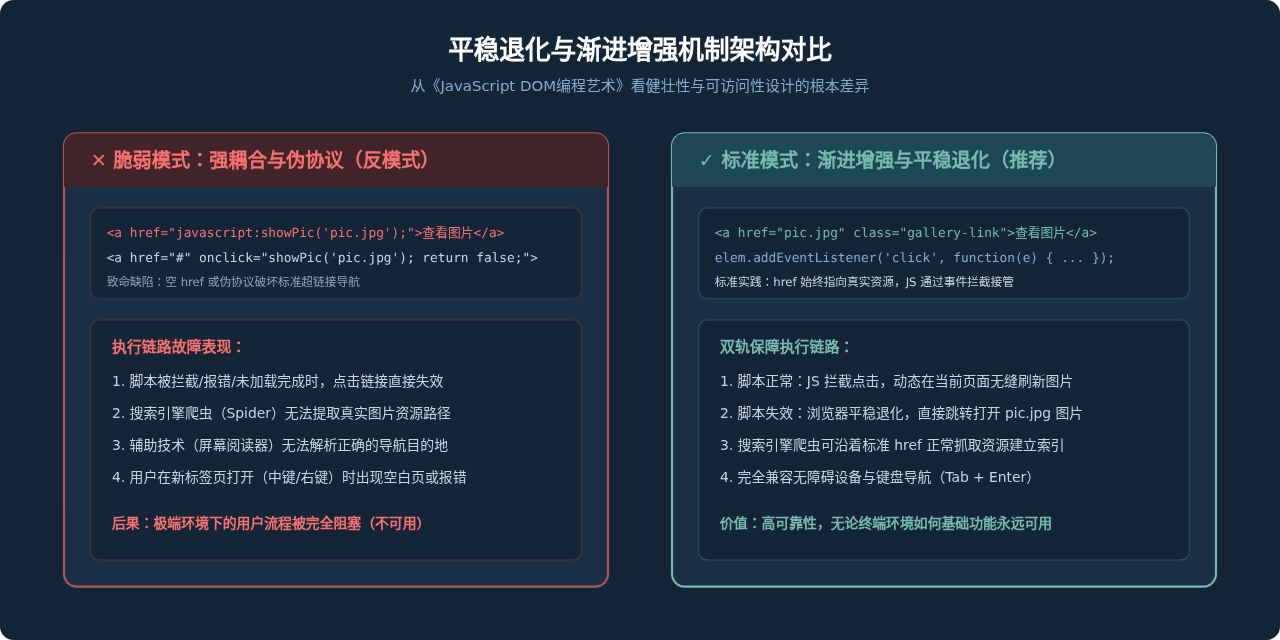
书中最典型的反模式就是使用 javascript: 伪协议或空锚点 href="#":
<!-- 错误做法:强依赖 JS,完全丧失平稳退化能力 -->
<a href="javascript:showPic('pic.jpg');">查看图片</a>
<a href="#" onclick="showPic('pic.jpg'); return false;">查看图片</a>

<!-- 标准做法:保证真实 href 资源路径有效,JS 仅作为渐进增强层拦截 -->
<a href="pic.jpg" class="gallery-link">查看图片</a>
在标准写法下,如果 JavaScript 环境正常,脚本将拦截点击事件并在当前页面通过 DOM 动态更新占位图;若用户关闭了脚本、中键在新标签打开链接,或是搜索引擎爬虫访问,浏览器则自动顺畅跳转到 pic.jpg。这种设计在任何情况下都确保了用户可访问性(Accessibility)。
三、落实无侵入式 JavaScript(Unobtrusive JavaScript)
所谓“无侵入式 JavaScript”,是指 JavaScript 脚本与 HTML 标记彻底分离。HTML 源码中不应出现任何内联事件属性(如 onload、onclick、onmouseover 等)。
要实现完全解耦的事件绑定,脚本必须在文档 DOM 树构建完毕后再行检索节点并挂载监听。书中介绍了非常著名的 addLoadEvent 队列函数,展示了在没有框架时如何优雅地协同多个脚本的初始化:
function addLoadEvent(func) {
  var oldonload = window.onload;
  if (typeof window.onload != 'function') {
    window.onload = func;
  } else {
    window.onload = function() {
      oldonload();
      func();
    };
  }
}
在现代 DOM 标准中,通常推荐使用 DOMContentLoaded 事件代替 window.onload,因为前者在 DOM 树解析完毕即可触发,无需等待外部大图及样式资源完全下载完毕:
document.addEventListener('DOMContentLoaded', function() {
  prepareGallery();
});
无侵入式的核心在于:遍历指定容器下的节点,通过代码将事件处理函数动态附加在元素上,并在事件函数内部决定是否拦截浏览器的默认行为。如果动态处理成功,则阻止默认行为;若出现异常,则放行默认跳转,形成自洽的闭环。
四、基于经典“图片库”(Image Gallery)案例的标准实践流程
《JavaScript DOM编程艺术》通篇围绕一个极具代表性的案例——“图片库”(Image Gallery)层层演进。通过这个案例,可以完整体验从原始标记到标准动态组件的四个关键步骤。
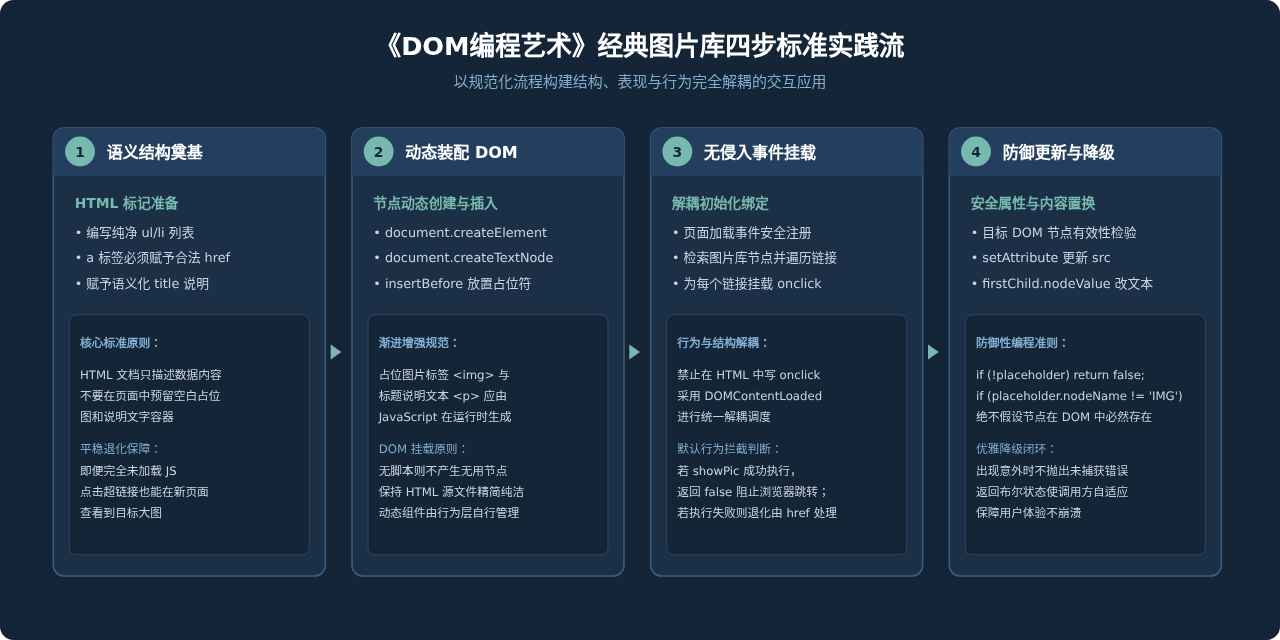
步骤一:编写纯语义化 HTML 列表
HTML 文件中只记录纯粹的图片清单,绝对不在 HTML 中预先硬编码空白的 <img id="placeholder">。因为在没有脚本支持的场景下,预留空白占位图毫无意义,只会破坏视觉版面。
<h2>风景图集</h2>
<ul id="imagegallery">
  <li><a href="images/mountain.jpg" title="雄伟的雪山风光">雪山</a></li>
  <li><a href="images/ocean.jpg" title="广袤的深蓝海洋">大海</a></li>
  <li><a href="images/forest.jpg" title="晨曦中的幽静森林">森林</a></li>
</ul>
步骤二:动态创建与插入 DOM 占位元素
利用原生 DOM API,在 JavaScript 确认当前环境支持必要方法后,动态生成大图容器及说明文字段落,并通过 insertBefore 插入到合适的位置:
function insertAfter(newElement, targetElement) {
  var parent = targetElement.parentNode;
  if (parent.lastChild === targetElement) {
    parent.appendChild(newElement);
  } else {
    parent.insertBefore(newElement, targetElement.nextSibling);
  }
}

function preparePlaceholder() {
  if (!document.createElement || !document.createTextNode || !document.getElementById) return false;
  var gallery = document.getElementById('imagegallery');
  if (!gallery) return false;

  var placeholder = document.createElement('img');
  placeholder.setAttribute('id', 'placeholder');
  placeholder.setAttribute('src', 'images/placeholder.jpg');
  placeholder.setAttribute('alt', '图片查看区');

  var description = document.createElement('p');
  description.setAttribute('id', 'description');
  var desctext = document.createTextNode('请选择上方图片进行预览');
  description.appendChild(desctext);

  insertAfter(placeholder, gallery);
  insertAfter(description, placeholder);
}
步骤三:解耦事件绑定与默认行为拦截
遍历图片链接,绑定点击事件。当 showPic 成功更新视图时返回 false(拦截默认页面跳转);若更新未成功则返回 true,让浏览器执行默认的 href 跳转:
function prepareGallery() {
  if (!document.getElementsByTagName || !document.getElementById) return false;
  var gallery = document.getElementById('imagegallery');
  if (!gallery) return false;

  var links = gallery.getElementsByTagName('a');
  for (var i = 0; i < links.length; i++) {
    links[i].onclick = function() {
      return showPic(this) ? false : true;
    };
  }
}
步骤四:防御性属性更新
核心更新函数 showPic 必须具备严格的容错性,在访问目标节点属性前进行类型与存在性判定:
function showPic(whichpic) {
  var placeholder = document.getElementById('placeholder');
  if (!placeholder || placeholder.nodeName !== 'IMG') return false;

  var source = whichpic.getAttribute('href');
  placeholder.setAttribute('src', source);

  var description = document.getElementById('description');
  if (description) {
    var text = whichpic.getAttribute('title') ? whichpic.getAttribute('title') : '';
    if (description.firstChild.nodeType === 3) { // 文本节点
      description.firstChild.nodeValue = text;
    }
  }
  return true;
}
五、严守防御性编程与特性检测(Feature Detection)
在跨浏览器开发中,最大的安全隐患之一是盲目假定 API 的可用性。《JavaScript DOM编程艺术》极力倡导“特性检测”(Feature Detection),坚决反对依赖 navigator.userAgent 的“浏览器嗅探”(Browser Sniffing)。
核心法则:永远不要根据浏览器名或版本号猜测其拥有的功能,而应在使用特定 API 前,直接检测该方法在当前上下文中是否存在。
// 严禁做法:基于 User-Agent 字符串猜测能力
if (navigator.userAgent.indexOf('MSIE') !== -1) {
  // 不可靠且极易被欺骗
}

// 标准做法:精准特性检测
if (!document.getElementById || !document.getElementsByTagName) {
  return false;
}
此外,防御性编程还体现在对 DOM 树结构的谦逊预期。DOM 结构随时可能因多方脚本变动、无序渲染或模板改动而发生变化。因此:
- 使用
getElementById或querySelector检索元素后,必须检查结果是否为null; - 操作
firstChild或childNodes时,必须意识到不同浏览器和格式化工具会产生空白文本节点(Whitespace Text Node),务必检查nodeType === 1(元素节点)或nodeType === 3(文本节点); - 获取属性值时(如
getAttribute('title')),需做好属性不存在返回null或空字符串的兼容兜底。
六、从传统 DOM 规范到现代前端架构的认知映射
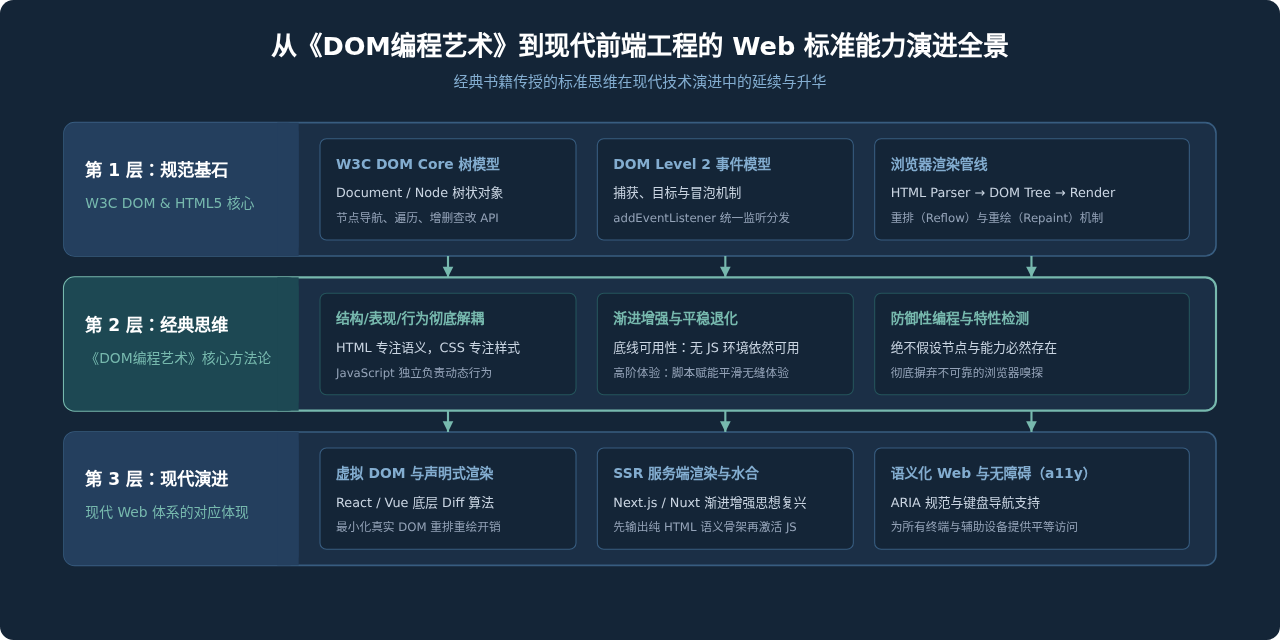
随着前端技术的演进,React、Vue、Svelte 等现代组件化框架广泛普及。很多初学者误以为直接操作 DOM 的经典方法论已经过时。然而事实恰恰相反——现代前端工程的方方面面,本质上都是《JavaScript DOM编程艺术》所阐述的 Web 标准思想在更宏大尺度上的工程化演进与升级。
1. 虚拟 DOM 与真实 DOM 的关系
现代框架引入的 Virtual DOM 并非否定了原生 DOM,而是为了解决高频全量操作原生 DOM 引发的重排(Reflow)与重绘(Repaint)性能瓶颈。理解了《DOM编程艺术》中对节点树结构的讲解,才能真正理解虚拟 DOM 的 Diff 算法本质上就是在纯内存树结构间进行最小差异比对,并批量映射回真实的 appendChild 与 replaceChild 调用。
2. 服务端渲染(SSR)与水合(Hydration)——渐进增强的现代复兴
在单页应用(SPA)盛行一段时间后,社区遭遇了严重的白屏时间(FCP 缓慢)和搜索引擎索引困难(SEO 缺陷)。现代解决方案 Next.js、Nuxt.js、Remix 等主推的 SSR/SSG 架构,本质上正是《DOM编程艺术》中“渐进增强”思想的工程级复兴:服务端先吐出拥有完整语义和内容的基础 HTML 骨架,确保弱网或首屏秒级可见;随后客户端脚本静默下载并完成“水合”(Hydration),将事件监听器解耦挂载到对应 DOM 节点上。这一完整链路与书中推导的思路完全吻合。
3. Web 标准基础检验清单
| 检验维度 | 《DOM编程艺术》经典标准准则 | 现代前端项目对应检查点 |
|---|---|---|
| 结构解耦 | HTML 源码不含内联样式与 inline 事件 | 组件模板无行内脚本,样式模块化或独立管理 |
| 降级保障 | 超链接 href 始终指向可用资源路径 |
路由使用标准 <a> 链接,具备 SSR/预渲染兜底能力 |
| DOM操作 | 严格使用标准节点 API,不破坏树模型 | 声明式驱动视图,避免直接越权污染底层节点 |
| 防御编程 | 执行操作前检测方法与节点有效性 | 可选链操作符(?.)、空值合并、状态判空校验 |
| 无障碍访问 | 支持键盘导航与屏幕阅读器友好解析 | 遵循 WCAG 标准,具备完备的 ARIA 标签与焦点管理 |
七、总结
基于《JavaScript DOM编程艺术》构建 Web 标准基础,其真正目的不是将开发者局限在十多年前的手写原生脚本时代,而是通过洗练、严谨的经典案例,建立起对底层 Web 运行规律的深刻敬畏与洞察。当脱离框架外壳、深入面对浏览器渲染管线与事件循环机制时,这种对“结构语义、优雅退化、渐进增强、防御稳健”的深刻理解,将成为每一位前端工程师最具生命力的专业护城河。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章