

深入讲解现代浏览器中使用JavaScript实现纯前端文件下载的核心技术:Blob对象的构建、URL.createObjectURL映射原理、标准触发步骤、多类型数据导出实战以及内存回收与编码避坑要点。
浏览器JavaScript实现前端数据下载:Blob与URL.createObjectURL用法
作者:小圆点
时间:2026-10-30
浏览:519
文章目录
在现代Web开发中,纯前端生成并导出文件的需求十分普遍,例如将表格数据导出为CSV、将用户配置导出为JSON或将Canvas绘制的内容保存为图片。借助浏览器原生的 Blob 对象和 URL.createObjectURL() 接口,我们无需依赖服务器中转,就能把运行时的内存数据转化为可供用户直接点击下载的文件。本文将详细讲解这一技术的底层逻辑、标准代码步骤、不同类型数据的具体写法,以及不可忽视的内存释放与编码陷阱。
一、纯前端数据下载的工作原理与对象关系
传统的文件下载通常由服务器端提供一个HTTP下载接口,浏览器通过请求该接口并在响应头中包含 Content-Disposition: attachment; filename="..." 来弹出下载对话框。而在纯前端场景下,数据产生于浏览器运行内存中(例如用户刚刚编辑完的表格、前端图表绘制的图像数据等),数据并未上传至服务器。
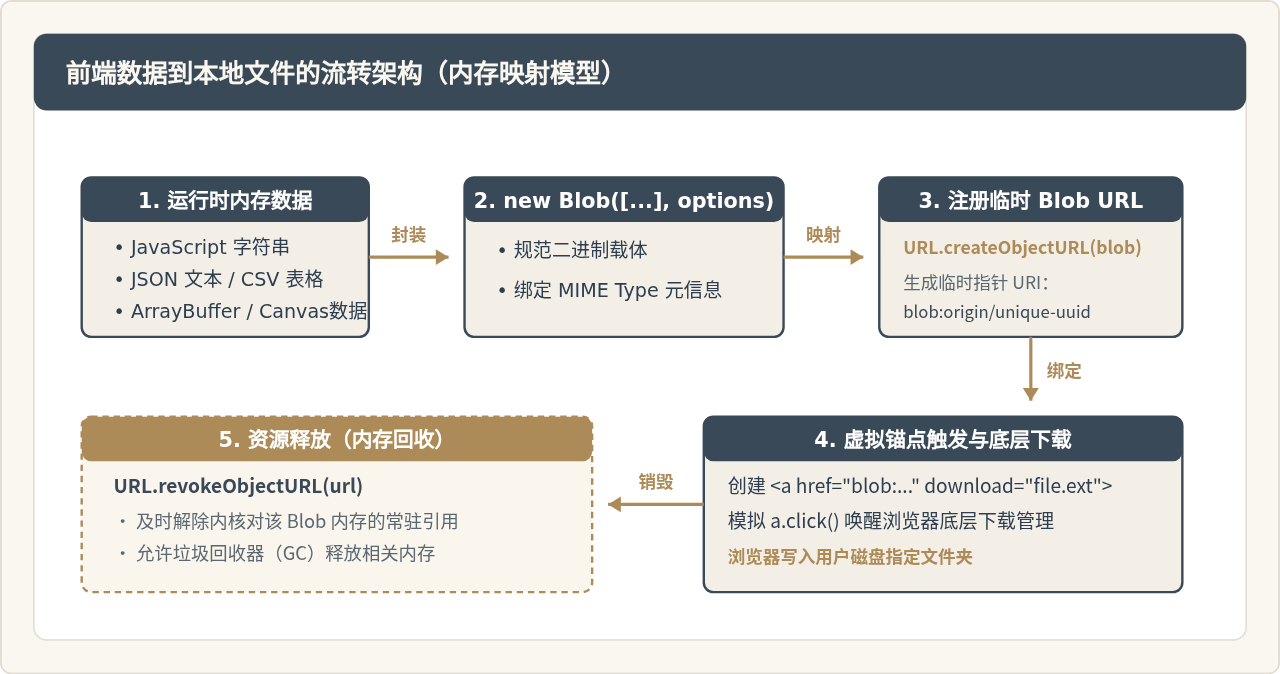
为了让浏览器识别并下载这些内存数据,前端利用了两大原生技术枢纽:
- Blob(Binary Large Object):用于将零散的字符串、JSON文本、类型化数组(TypedArray)或二进制缓冲区(ArrayBuffer)封装成一个结构固定的不可变原始数据对象,并附带明确的媒体类型(MIME Type)。
- URL.createObjectURL():在浏览器内核内部为指定的 Blob 或 File 对象注册一个临时的特殊 URL(协议形如
blob:http://localhost:3000/uuid)。该 URL 扮演了内存数据引用的角色,浏览器可以像访问普通网络资源一样访问该 URL。
结合 HTML5 <a> 元素的 download 属性,JavaScript 可以模拟用户点击行为,驱动浏览器的本地文件保存管线。完成下载后,再通过 URL.revokeObjectURL() 显式切断引用并释放内存。
二、实现前端文件下载的标准 5 步代码范式
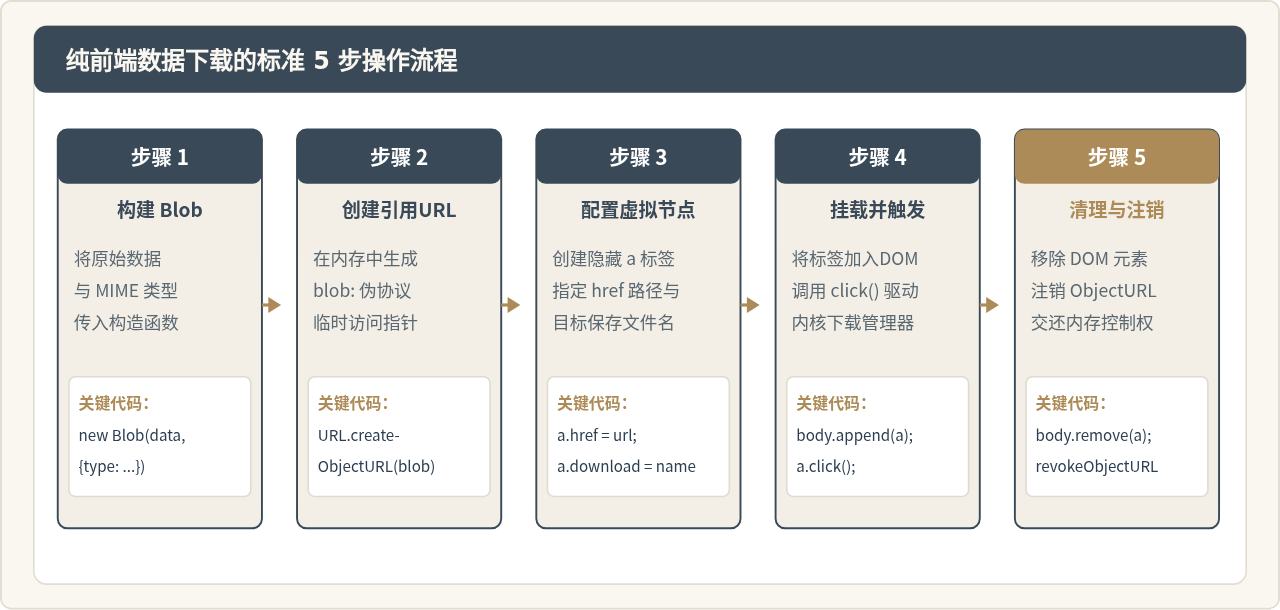
在纯前端触发下载的完整生命周期中,有固定的操作顺序。以下是生产环境通用的标准 5 步实现:
- 组装数据与构建 Blob 实例:将需要导出的数据传入
Blob构造函数,并指定正确的type(MIME类型)。 - 生成临时引用 URL:通过
URL.createObjectURL(blob)创建指向该 Blob 的专属临时 URL。 - 构建虚拟锚点标签:创建不可见的
<a>元素,将其href设为该临时 URL,并设置download属性为目标文件名。 - 挂载并模拟点击:将
<a>标签挂载到 DOM 树并执行click(),触发浏览器内置下载弹窗。 - 移除标签与释放引用:从 DOM 中移除该临时标签,并调用
URL.revokeObjectURL()释放映射,避免内存泄漏。
以下为一个通用封装函数:
/**
 * 纯前端触发文件下载的核心工具函数
 * @param {BlobPart[]} parts - 放入 Blob 的内容数组 (如字符串、TypedArray 等)
 * @param {string} filename - 保存至本地的文件名 (带后缀)
 * @param {string} mimeType - 数据的 MIME 格式
 */
function downloadBlob(parts, filename, mimeType = 'application/octet-stream') {
  // 第 1 步:构造 Blob 实例
  const blob = new Blob(parts, { type: mimeType });

  // 第 2 步:为 Blob 对象创建内存映射 URL
  const objectUrl = URL.createObjectURL(blob);

  // 第 3 步:动态创建隐藏的 a 标签并配置下载参数
  const anchor = document.createElement('a');
  anchor.href = objectUrl;
  anchor.download = filename;
  anchor.style.display = 'none';

  // 第 4 步:挂载至文档流并模拟用户触发点击
  document.body.appendChild(anchor);
  anchor.click();

  // 第 5 步:清理 DOM 节点并在事件队列中安全释放内存引用
  document.body.removeChild(anchor);
  setTimeout(() => {
    URL.revokeObjectURL(objectUrl);
  }, 100);
}
三、常见场景与多种数据类型的导出实战
虽然下载的触发管线是固定的,但针对不同类型的数据格式,在构造 Blob 时对字符编码和 MIME Type 的处理各不相同。
1. 导出 JSON 配置文件
前端对象可以通过 JSON.stringify() 序列化后导出。为了保证文本编辑器打开时的可读性,建议传入缩进参数 null, 2。
function exportJsonFile(dataObject, filename = 'config.json') {
  // 格式化为易读的 JSON 字符串
  const jsonString = JSON.stringify(dataObject, null, 2);

  // 必须明确 UTF-8 字符集以防止非英文字符解析错误
  downloadBlob([jsonString], filename, 'application/json;charset=utf-8');
}

// 调用示例
exportJsonFile({ id: 101, name: "开发环境配置", enabled: true }, "app-settings.json");
2. 导出 CSV 表格与 UTF-8 BOM 乱码处理
这是前端导出最容易出现问题的场景。当用户导出的 CSV 表格包含中文字符,并且使用 Windows 上的 Microsoft Excel 直接双击打开时,常常会显示为一堆乱码。
原因解释:Excel 在打开未明确标记编码的 CSV 文件时,默认使用系统当前的代码页(在中文 Windows 上通常是 GBK),而前端生成的字符串默认是 UTF-8 编码。解决该问题的标准做法是在数据最前端添加 UTF-8 BOM(Byte Order Mark),即 Unicode 字符 \uFEFF。Excel 读取到该字符前缀时,就会自动切换至 UTF-8 解码。
function exportCsvFile(rows, filename = 'data.csv') {
  // 将二维数组拼接为标准 CSV 格式行
  const csvContent = rows
    .map(row => row.map(item => `"${String(item).replace(/"/g, '""')}"`).join(','))
    .join('\r\n');

  // 关键:在内容数组前插入 \uFEFF (UTF-8 BOM),避免 Excel 预览中文乱码
  downloadBlob(['\uFEFF', csvContent], filename, 'text/csv;charset=utf-8');
}

// 调用示例
const tableData = [
  ["用户ID", "姓名", "所属部门", "入职时间"],
  [1001, "张三", "技术架构部", "2024-03-15"],
  [1002, "李四", "产品运营部", "2024-06-01"]
];
exportCsvFile(tableData, "部门成员表.csv");
3. 导出 Canvas 图形或二进制字节流
对于 HTML5 <canvas> 生成的图像,建议直接使用其原生的 canvas.toBlob() 异步方法,而无需先转化为巨大的 Base64 字符串。这能极大降低内存峰值消耗。
function exportCanvasImage(canvasElement, filename = 'screenshot.png') {
  canvasElement.toBlob((blob) => {
    if (!blob) {
      console.error('Canvas 转换为 Blob 失败');
      return;
    }
    const url = URL.createObjectURL(blob);
    const a = document.createElement('a');
    a.href = url;
    a.download = filename;
    document.body.appendChild(a);
    a.click();
    document.body.removeChild(a);
    setTimeout(() => URL.revokeObjectURL(url), 100);
  }, 'image/png');
}
四、Blob URL 生命周期与内存回收机制
理解 URL.createObjectURL() 的生命周期机制是编写高质量前端应用的关键。
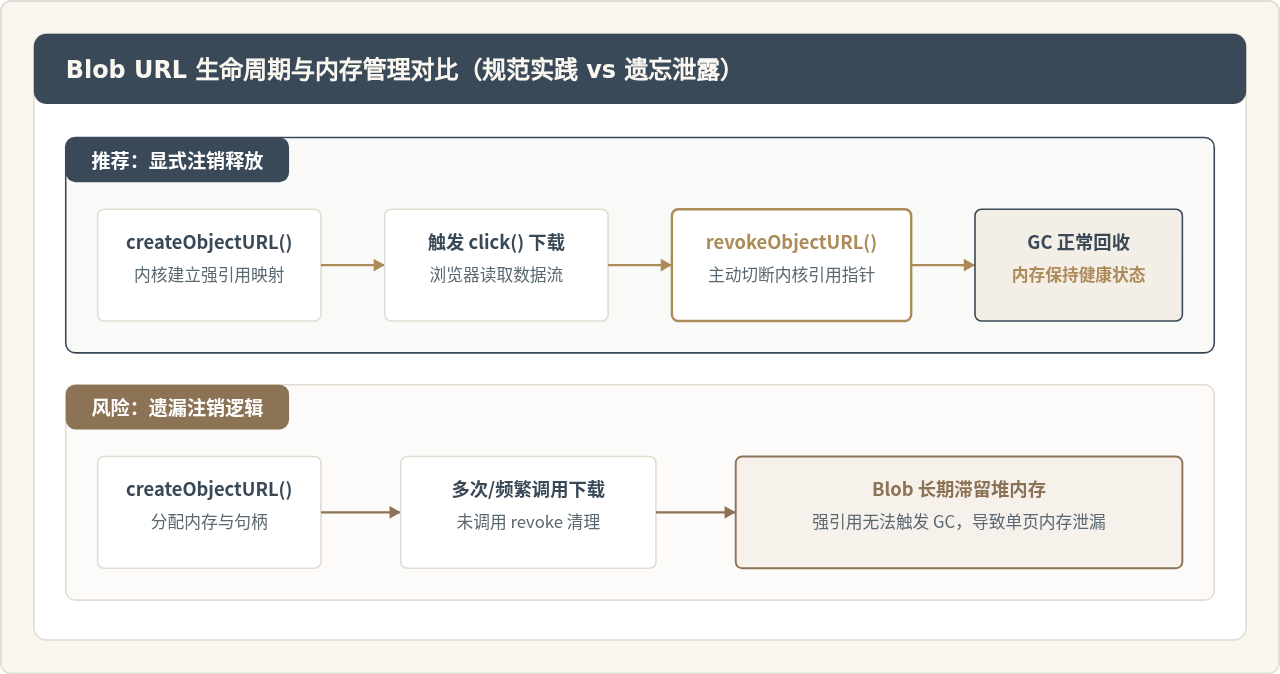
每当调用一次 URL.createObjectURL(blob),浏览器内部便会维护一个映射表项,建立此 URL 与堆内存中 Blob 数据的强引用。只要该页面不被关闭或刷新,哪怕页面上的所有变量都已经离开作用域,浏览器内核也不会对该 Blob 进行垃圾回收(GC)。
如果在单页应用(SPA)中频繁触发数据下载而忘记调用 URL.revokeObjectURL(),随着使用时间的增长,内存中堆积的废弃 Blob 将造成显著的内存泄漏,最终导致页面卡顿甚至崩溃。
为什么推荐使用 setTimeout 延迟释放?
在调用 anchor.click() 后,浏览器底层的下载动作是异步排队执行的。在部分老版本浏览器或特定平台中,如果紧接着同步执行 URL.revokeObjectURL(url),可能会在底层下载进程尚未读取数据前就注销了该地址,导致下载失败或保存为空文件。因此,推荐使用 setTimeout(() => URL.revokeObjectURL(url), 100) 将注销操作放入下一个宏任务队列中执行。
五、适用边界与关键避坑指南
虽然 Blob + URL.createObjectURL 是目前最兼容、最简洁的前端导出方式,但在实际工业级项目中,还需要注意以下限制条件与边界:
| 考虑维度 | 表现特征与限制 | 应对与解决方案 |
|---|---|---|
| 文件容量上限 | 受限于浏览器可用堆内存,通常超过 500MB~1GB 的数据在内存中构造 Blob 会引发 Out of Memory 崩溃。 |
超过几百MB的大文件推荐采用服务端分块流式传输;纯前端超大导出可考虑 StreamSaver.js 或现代 File System Access API(showSaveFilePicker)。 |
| 跨域与 download 属性 | 如果 <a> 标签的 href 指向不同源(跨域)的真实网络地址,download 属性会被浏览器安全策略忽略,转为新标签页打开。 |
纯前端 blob: 协议的源与当前页面同源,因此不受跨域下载属性限制;但如果是网络跨域图片,需先 fetch 转为本地 Blob。 |
| 用户手势拦截 | 现代浏览器普遍限制无手势的自动下载行为。若在没有用户直接点击(如长定时器或接口回调深层嵌套)中触发 click(),可能被视作弹窗骚扰而被拦截。 |
确保导出动作由明确的用户交互事件(如点击“导出报告”按钮)直接驱动。 |
| 中文文件名支持 | 直接将中文赋值给 anchor.download 属性在现代浏览器中均已良好支持,无需像服务端响应头那样进行 encodeURIComponent 转义。 |
直接写入 anchor.download = "统计报表.xlsx" 即可,反转义或重复编码反而可能导致保存出的文件名带有百分号编码。 |
六、总结
纯前端实现数据下载是一项门槛低但细节丰富的核心技能。通过 Blob 将业务数据包装为包含 MIME 元信息的不可变数据块,通过 URL.createObjectURL() 在浏览器内核生成高效的本地虚地址,再通过动态 <a> 标签的 download 属性触发保存,即可形成完整的闭环。
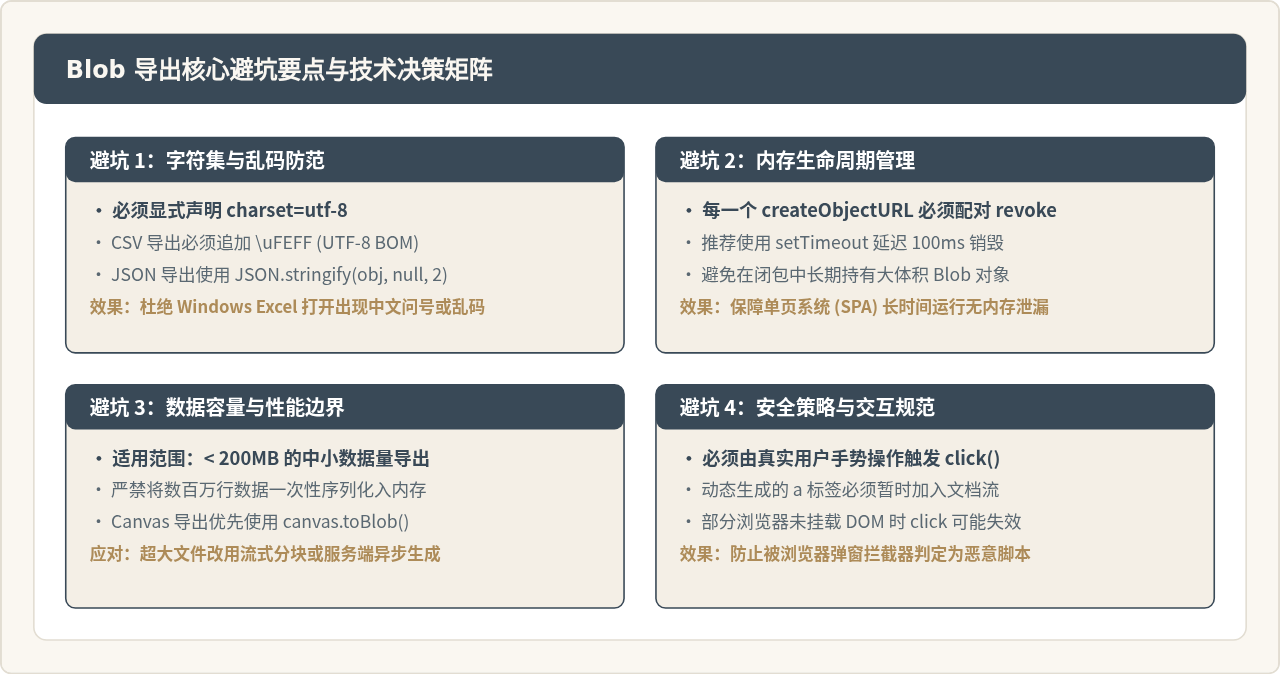
在实际落地时,务必坚持两项工程纪律:一是针对中文文本和表格添加明确的 UTF-8 编码与 BOM 标识,避免平台间兼容性问题;二是确保在下载触发后配对调用 URL.revokeObjectURL(),让应用在高效提供导出功能的同时保持纯净健康的内存状态。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章