

本文总结了前端实现文件下载的几种常见方法,包括直接修改location.href、使用window.open、利用a标签的download属性以及处理后端返回的文件流。重点对比了通过URL.createObjectURL和FileReader.readAsDataURL两种Blob处理方式的性能、内存管理及适用场景,帮助开发者根据请求方式(GET/POST)和文件类型选择最优方案。
本文梳理了前端开发中处理文件下载的几种主流方案,旨在提供实用参考,欢迎交流指正。
一、location.href
针对浏览器无法直接解析的文件格式,直接在地址栏输入URL可触发下载行为。该方法适用于单个文件下载;若用于多文件连续下载,快速点击可能导致前序请求被重置。
适用场景:
- GET请求
- 单文件下载
window.location.href = url;
二、window.open
其原理与location.href类似,均依赖浏览器对URL的直接响应。
window.open(url);
三、a标签
该方式仅对浏览器无法识别的文件格式直接触发下载。对于HTML、图片(jpg/png)或PDF等可解析格式,浏览器会直接渲染而非下载。此时可通过a标签的download属性指定文件名。此法适用于单文件下载,多文件快速点击同样存在请求重置风险。
适用场景:
- GET请求
- 单文件下载
- 需自定义文件名
//写法1
const download = (filename, url) => {
    let a = document.createElement('a');
    a.style = 'display: none'; // 创建一个隐藏的a标签
    a.download = filename;
    a.href = url;
    document.body.appendChild(a);
    a.click(); // 触发a标签的click事件
    document.body.removeChild(a);
}
// 写法2
<a href="/images/download.jpg" rel="external nofollow"  download="myFileName">
注意:若需强制下载浏览器可识别格式,可通过设置响应头Content-Disposition为attachment,并指定文件名,以此告知浏览器该链接为附件下载。
Content-Disposition: attachment; filename="filename.xls"
四、文件流
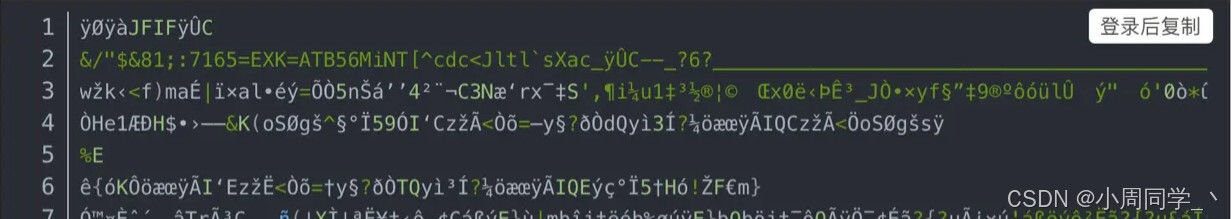
当后端以POST请求返回二进制文件流时,前端需将流转换为可下载链接。二进制数据大致结构如下:
适用场景:
- POST请求
- GET请求
- 多文件下载
1.请求方式
注意:jQuery不支持处理blob类型数据,因此不可使用jQuery发起此类请求。
原生JS写法
const req = new XMLHttpRequest();
req.open('POST', '/download/excel', true);
req.responseType = 'blob'; //如果不指定,下载后文件会打不开
req.setRequestHeader('Content-Type', 'application/json');
req.onload = function() {
    var content = req.getResponseHeader("Content-Disposition") ;
    // 文件名最好用后端返的Content-disposition
    // 需要后端设置 Access-Control-Expose-Headers: Content-disposition 使得浏览器将该字段暴露给前端
    var name = content && content.split(';')[1].split('filename=')[1];
    var fileName = decodeURIComponent(name)
    downloadFile(req.response,fileName)
};
req.send( JSON.stringify(params));
Axios写法
axios({
  method: 'post',
  headers: {
    'Content-Type': 'application/json; charset=utf-8'
  },
  url: '/robot/strategyManagement/analysisExcel',
  responseType: 'blob',
  headers: { //如果需要权限下载的话,加在这里
        Authorization: '123456'
    }
  data: JSON.stringify(params),
}).then(function(res){
   var content = res.headers['content-disposition'];
   var name = content && content.split(';')[1].split('filename=')[1];
   var fileName = decodeURIComponent(name)
   downloadFile(res.data,fileName)
})
2.文件下载实现方式
通过URL.createObjectURL()下载
URL.createObjectURL()是一个静态方法,用于生成一个表示参数中对象的DOMString URL。该URL的生命周期与创建它的窗口document绑定。
downloadFile:function(data,fileName){
    // data为blob格式
    var blob = new Blob([data]);
    var downloadElement = document.createElement('a');
    var href = window.URL.createObjectURL(blob);
    downloadElement.href = href;
    downloadElement.download = fileName;
    document.body.appendChild(downloadElement);
    downloadElement.click();
    document.body.removeChild(downloadElement);
    window.URL.revokeObjectURL(href);
}
通过FileReader.readAsDataURL()下载
readAsDataURL()方法用于读取指定的Blob或File对象。该操作为异步过程,读取完成后,可通过onload回调中的result属性获取data:URL格式的字符串(即base64编码内容),该字符串可作为a标签的href属性值。
downloadFile:function(data,fileName){
   const reader = new FileReader()
   // 传入被读取的blob对象
   reader.readAsDataURL(data)
   // 读取完成的回调事件
   reader.onload = (e) => {
       let a = document.createElement('a')
       a.download = fileName
       a.style.display = 'none'
       // 生成的base64编码
       let url = reader.result
       a.href = url
       document.body.appendChild(a)
       a.click()
       document.body.removeChild(a)
   }
}
两者的区别
- 返回值差异:FileReader.readAsDataURL(blob)返回base64字符串;URL.createObjectURL(blob)返回当前文件的内存
URL。 - 内存管理:FileReader.readAsDataURL(blob)随JS垃圾回收机制自动清理;URL.createObjectURL(blob)存在于当前document中,需通过revokeObjectURL()手动释放。
- 执行机制:FileReader.readAsDataURL(blob)通过回调函数异步返回;URL.createObjectURL(blob)同步直接返回。
- 多文件处理:FileReader.readAsDataURL(blob)处理多文件时需为每个文件创建独立的FileReader对象;URL.createObjectURL(blob)依次返回,互不影响。
- 优势对比:URL.createObjectURL(blob)生成本地内存容器的
URL地址,便于预览且性能优异,但需注意手动释放内存;FileReader.readAsDataURL(blob)可直接转为base64格式,便于直接用于业务场景。
总结
至此,本文介绍了前端实现文件下载的几种常见方法。更多相关技术细节可参考本站往期文章或继续浏览后续内容,感谢支持。