

本文深入分析了npm脚本启动缓慢的原因,通过性能剖析发现npm CLI加载了大量不必要的模块。通过实施按需加载、简化字符串排序算法以及移除无关代码,将npm run命令的执行时间从约400毫秒优化至22毫秒,提升了18倍。文章探讨了JS生态系统中模块加载的通用痛点及解决方案。
引言
简而言之:npm 脚本由全球范围内的 JavaScript 开发者和持续集成(CI)系统频繁执行。尽管使用率极高,但其性能并未得到充分优化,每次执行大约增加 400 毫秒的开销。在本文中,我们将展示如何将其优化至约 22 毫秒。
本期《前端翻译计划》分享的是“加速 JS 生态系统系列博客”,内容涵盖但不限于:
- PostCSS,SVGO 等等
- 模块解析
- 使用 eslint
- npm 脚本
- draft-js emoji 插件
- polyfill 暴走
- 桶装文件崩溃
- Tailwind CSS
npm 脚本
本期分享的是第 4 篇博客 —— npm 脚本。
如果您使用 JavaScript,您可能曾在 package.json 的 "scripts" 字段中为项目配置常见任务。这些脚本可以通过终端使用 npm run 命令执行。我倾向于直接调用底层命令,而非调用 npm run,主要原因在于后者明显更慢。那么,究竟是什么导致它们如此缓慢?是时候进行性能分析了!
仅按需加载代码
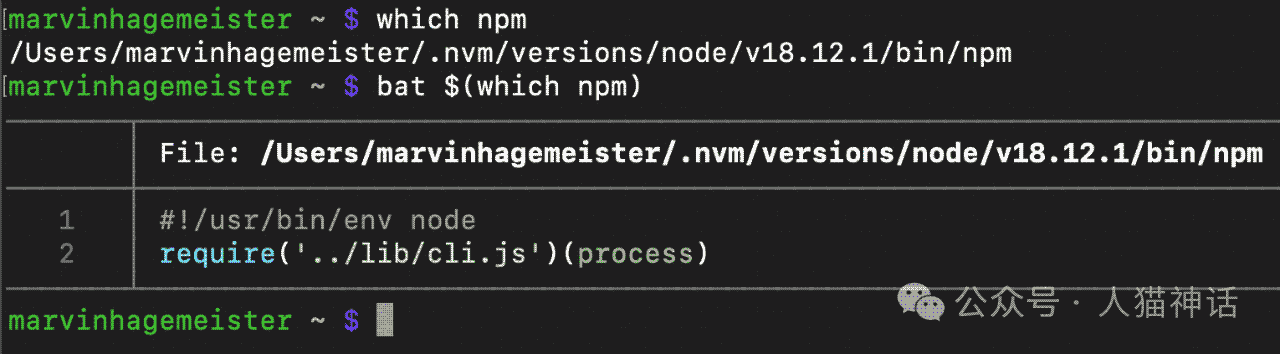
许多开发者不知道的是,npm CLI 实际上是一个标准的 JavaScript 文件,可以像其他 .js 文件一样执行。在 macOS 和 Linux 系统上,您可以通过运行 which npm 命令获取 npm CLI 的完整路径。将该文件内容输出到终端,会发现它只是一个普通的 .js 文件。唯一的特殊之处在于首行代码,它指定了用于执行当前文件的解释器,因为这是一个由 node 运行的 JavaScript 文件。
既然它只是一个 .js 文件,我们就可以利用所有常用的性能分析工具。我最喜欢的是 Node 的 --cpu-prof 参数。结合这些知识,我们可以通过执行 node --cpu-prof $(which npm) run myscript 命令来生成配置文件。将该配置文件加载到 speedscope 中,可以揭示大量关于 npm 内部结构的信息。
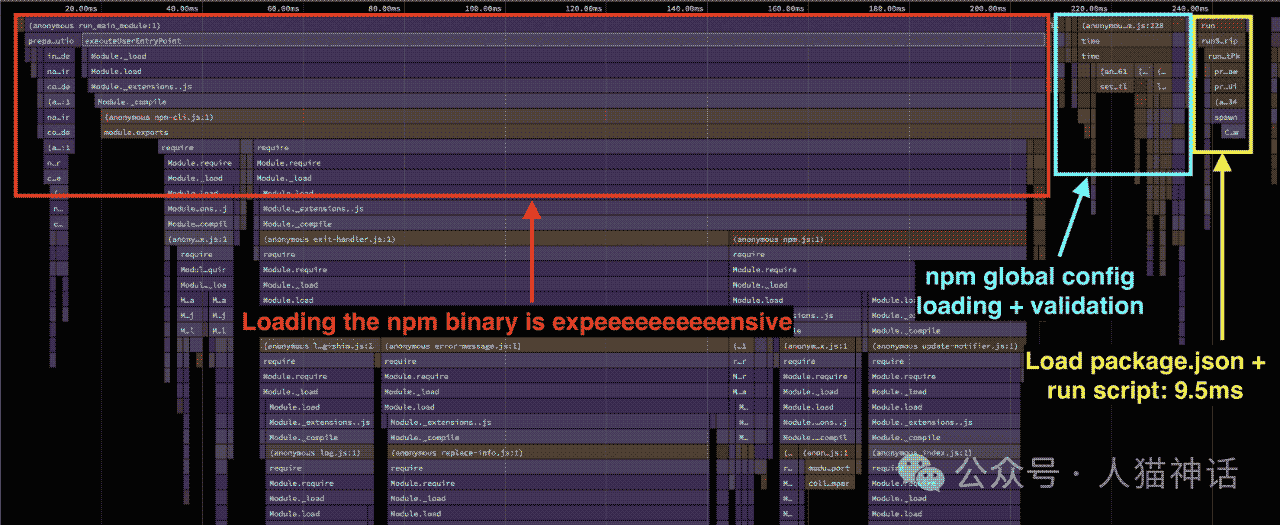
大部分时间都花费在加载构成 npm CLI 的所有模块上。相比之下,我们实际运行的脚本所占时间微乎其微。我们看到大量文件,似乎只有在满足特定条件时才需要。例如,格式化错误消息的代码,仅在发生错误时才被调用。
npm 中存在这种情况,exit 句柄无条件地 require。让我们改为仅在需要时 require 该模块。
  // exit-handler.js
  const log = require('./log-shim.js')
- const errorMessage = require('./error-message.js')
- const replaceInfo = require('./replace-info.js')

  const exitHandler = err => {
    //...
    if (err) {
+     const replaceInfo = require('./replace-info.js');
+     const errorMessage = require('./error-message.js')
      //...
    }
  };
将更改后的配置文件与未更改的配置文件进行比较,并未显示总时间存在差异。这是因为我们在此处更改为延迟加载的模块在其他地方被饿汉式 require。为了正确地实现延迟加载,我们需要更改所有 require 的地方。
接下来我注意到,加载了一堆与 npm 审计功能相关的代码。这看起来很奇怪,因为我没有运行任何审计相关的操作。不幸的是,对我们而言,这并不像移动某些 require 调用那么容易。
万能类
各种 JavaScript 工具中反复出现的一个问题是,它们由一大坨类组成,这些类包含所有内容,而不仅仅是我们需要的代码。这些类总是从小规模开始,并有良好的精简意图,但不知何故,它们变得越来越臃肿。确保按需加载代码越来越难。这让我想起 Joe Armstrong(Erlang 之父)的这句名言:
“您只想要一根香蕉,但您得到的是一只大猩猩拿着香蕉和整个丛林。”
npm 内部有一个 Arborist 类,它引入了一大坨仅特定命令所需的内容。它引入了与修改 node_modules 中的布局和包、审核包版本以及 npm run 命令不需要的其他一大坨相关内容。如果我们想优化 npm run,我们需要将它们从无脑加载的模块列表中剔除。
const mixins = [
  require('../tracker.js'),
  require('./pruner.js'),
  require('./deduper.js'),
  require('./audit.js'),
  require('./build-ideal-tree.js'),
  require('./load-workspaces.js'),
  require('./load-actual.js'),
  require('./load-virtual.js'),
  require('./rebuild.js'),
  require('./reify.js'),
  require('./isolated-reifier.js')
]

const Base = mixins.reduce((a, b) => b(a), require('events'))
class Arborist extends Base {
  //...
}
出于我们的目的,所有加载到 mixins 数组中的模块(Arborist 类稍后在其上扩展)都不需要。我们可以一键清空回收站。这一更改优化了大约 20 毫秒,这可能看似九牛一毛,但积少成多。和以前一样,我们需要检查 require 这些模块的其他地方,确保我们确实只按需加载它。
减小模块图大小
对随处可见的一大坨 require 语句进行修改很好,但不会显著影响性能。更大的问题在于依赖,它通常有一个主入口文件,该文件提取所述模块的所有代码。最终问题在于,当引擎瞄到一大坨顶层 import 或 require 语句时,它会饿汉式解析并加载这些模块。无一例外。但这正是我们想要避免的。
一个具体的例子是,从 npm-registry-fetch 包导入的 cleanUrl 函数。顾名思义,该包主要关于网络方面。但运行脚本时,我们不会在 npm run 中执行任何类型的网络请求。这又优化了 20 毫秒。我们也不需要显示进度条,因此我们也可以删除其代码。npm CLI 使用的一大坨其他依赖也是举一反三。
对于这些场景而言,加载的模块数量是一个非常现实的问题。见怪不怪,对于启动时间兹事体大的库已转向打包器,将其所有代码合并到更少的文件中。引擎非常适合加载 JS 大型 blob。我们如此关心网络上文件大小的主要原因在于,通过网络传输那些字节的成本。
不过,此方案也有权衡。文件越大,解析时间就越长,因此存在有一个阈值,超过该阈值后,单个大文件的解析成本会高于将其拆分。与往常一样:测量将告诉,您是否达到了这种均衡。另一件需要考虑的事情是,打包器无法像 ESM 代码那样高效地打包 CommonJS 模块系统的代码。通常,它们会在 CommonJS 模块周围引入一大坨包装代码,这首先抵消了打包代码的大部分福利。
排序所有字符串
随着模块图的逐次递减,配置文件的干扰越来越小,并揭露了其他可以优化的地方。对 collaterCompare 函数的特定调用引起了我的注意。
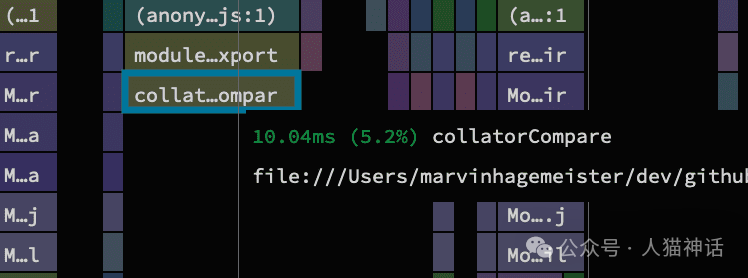
您可能会认为,10 毫秒的优化性价比太低,但在此配置文件中,它更像是“勿以善小而不为”。没有任何银弹可以让一切加速。因此,优化小型的调用位置非常值得。collatorCompare 函数的有趣之处在于,其预期目的是以区域设置感知的方式排序字符串。该实现分为两部分:初始化函数及其返回的实际比较的函数。
// @isaacs/string-locale-compare 中代码的简化示例
const collatorCompare = (locale, opts) => {
  const collator = new Intl.Collator(locale, opts)
  // 始终返回一个需要从零开始优化的函数
  return (a, b) => collator.compare(a, b)
}
const cache = new Map()
module.exports = (locale, options = {}) => {
  const key = `${locale}\n${JSON.stringify(options)}`
  if (cache.has(key)) return cache.get(key)
  const compare = collatorCompare(locale, opts)
  cache.set(key, compare)
  return compare
}
如果我们查看该模块加载的所有位置,可以看到我们只对排序英文字符串感兴趣,并且从不传递除语言环境之外的任何其他选项。但由于该模块的结构化方式,每个新的 require 调用都会促使我们创建一个需要再次优化的全新比较函数。
// 每个 require 调用立即使用 en 调用默认导出
const localeCompare = require('@isaacs/string-locale-compare')('en')
但理想情况下,我们希望大家都使用相同的比较函数。考虑到这一点,我们可以用两行代码替换,其中我们创建了一次 Intl.Collator,并且也只创建一次 localeCompare 函数。
// 我们只需构造一次 Collator 类的实例
const collator = new Intl.Collator('en')
const localeCompare = (a, b) => collator.compare(a, b)
在某个特定位置,npm 保存可用命令的排序列表。该列表是硬编码的,并且在运行时永远不变。它仅由 ascii 字符串组成,因此我们可以使用普通的原有 .sort(),而不是我们的区域设置感知函数。
  // 此数组仅包含 ASCII 字符串
  const commands = [
    'access',
    'adduser',
    'audit',
    'bugs',
    'cache',
    'ci',
    // ...
- ].sort(localeCompare)
+ ].sort()
通过此优化,调用该函数的时间趋近 0 毫秒。这又优化了 10 毫秒,因为此乃最后一个饿汉式加载该模块的地方。
粉丝请注意,此时我们已经将 npm run 的速度提高了一倍。我们现在从开始时的约 400 毫秒减少到约 200 毫秒。
设置 process.title 的成本很高
另一个跳出的函数调用是对神秘 title 属性的 setter 的调用。设置属性 20ms 似乎很昂贵。
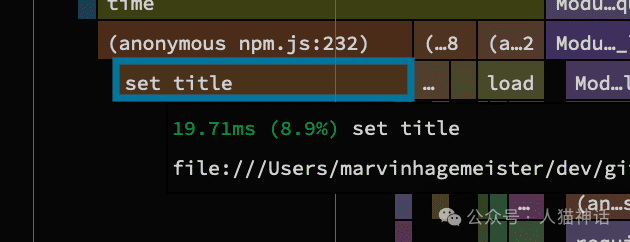
该 setter 的实现非常简单:
class Npm extends EventEmitter {
  // ...
  set title(t) {
    // 这行代码是罪魁祸首
    process.title = t
    this.#title = t
  }
}
更改当前正在运行的进程的标题似乎是一个相当昂贵的操作。不过,此功能确实颇有用处,因为当您同时运行多个 npm 进程时,它可以更轻松地在任务管理器中发现特定的 npm 进程。尽管如此,私以为可能值得深究是什么导致了如此昂贵的成本。
全局日志文件
配置文件中引起我注意的另一个入口是,对 glob 模块内另一个字符串排序函数的调用。很奇怪的是,当我们只想运行 npm 脚本时,我们甚至在这里进行通配符。glob 模块用于在文件系统中抓取与用户定义模式匹配的文件,但为什么我们需要它呢?讽刺的是,大部分时间似乎不是花在搜索文件系统上,而是花在字符串排序上。
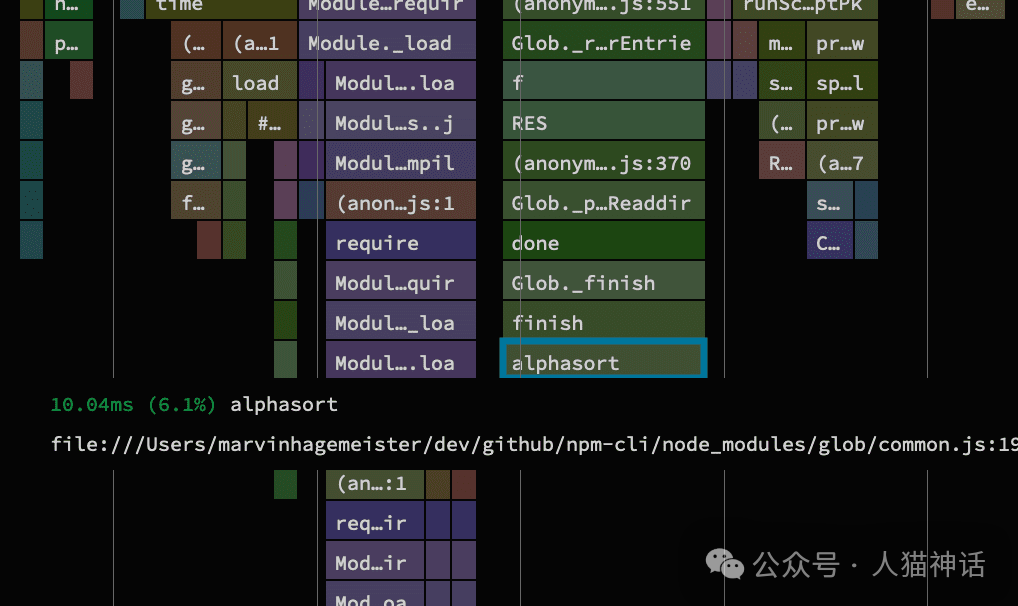
该函数仅使用包含 11 个字符串的简单数组调用一次,并且排序应该是即时的。奇怪的是,配置文件显示这花了大约 10 毫秒。
// 以某种方式排序此数组需要 10ms
;[
  '/Users/marvinhagemeister/.npm/_logs/2023-03-18T20_06_53_324Z-debug-0.log',
  '/Users/marvinhagemeister/.npm/_logs/2023-03-18T20_07_35_219Z-debug-0.log',
  '/Users/marvinhagemeister/.npm/_logs/2023-03-18T20_07_36_674Z-debug-0.log',
  '/Users/marvinhagemeister/.npm/_logs/2023-03-18T20_08_11_985Z-debug-0.log',
  '/Users/marvinhagemeister/.npm/_logs/2023-03-18T20_09_23_766Z-debug-0.log',
  '/Users/marvinhagemeister/.npm/_logs/2023-03-18T20_11_30_959Z-debug-0.log',
  '/Users/marvinhagemeister/.npm/_logs/2023-03-18T20_11_42_726Z-debug-0.log',
  '/Users/marvinhagemeister/.npm/_logs/2023-03-18T20_12_53_575Z-debug-0.log',
  '/Users/marvinhagemeister/.npm/_logs/2023-03-18T20_17_08_421Z-debug-0.log',
  '/Users/marvinhagemeister/.npm/_logs/2023-03-18T20_21_52_813Z-debug-0.log',
  '/Users/marvinhagemeister/.npm/_logs/2023-03-18T20_24_02_611Z-debug-0.log'
]
该实现看起来也人畜无害。
function alphasort(a, b) {
  return a.localeCompare(b, 'en')
}
但也许我们可以使用 Intl.Collator 对象来代替之前用来比较这些字符串的对象。
const collator = Intl.Collator('en')
function alphasort(a, b) {
  return collator.compare(a, b)
}
这就码到功成了。我不完全确定为什么 String.prototype.localeCompare 相比之下更慢。这听起来确实很可疑。但我可以可靠地验证我这边的速度差异。对于此特定调用,Intl.Collator 方法始终更快。
更大的问题是,在文件系统中搜索日志文件似乎与我们的意图不符。如果命令成功,日志文件会被写入并清除,这非常有用,但是如果我们是最初创建这些文件的人,我们难道不应该知道我们写入的文件的名称吗?
此时,我们已从最初的约 400 毫秒降至约 138 毫秒。尽管这已经是一个相当不错的优化,但我们还可以更进一步。
删除所有东西
私以为我需要更加积极地删除或取消注释与运行 npm 脚本无关的代码。目前为止,我们已经尽职尽责,我们可以渐进增强,但我很好奇我们应该争取的预期时间是多少。基本目标是按需加载执行 npm 脚本的代码。其他一切都只是开销和时间浪费。
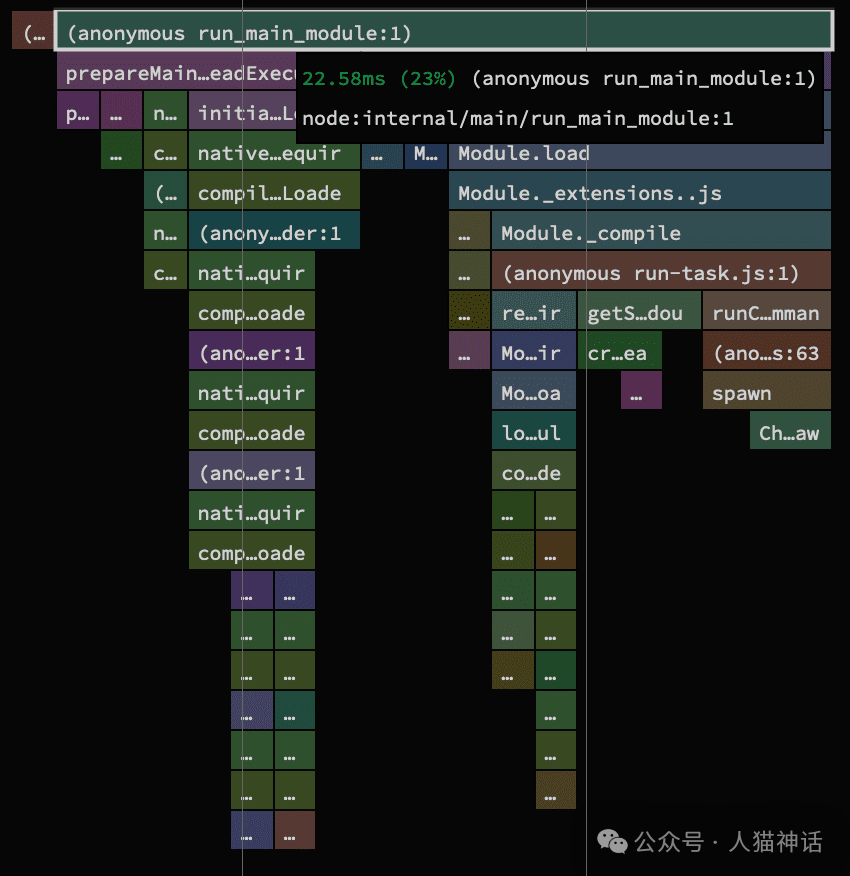
所以我写了一个简短的脚本,它只执行运行 npm 脚本所需的最低限度的工作。最后我把它降低到了大约 22 毫秒,这比我们开始时的 400 毫秒快了大约 18 倍。我对此非常满意,尽管与它的实际效果相比,22 毫秒仍然感觉很长。相比之下,Rust 等其他语言无疑更擅长这一点。无论如何,有一点需要指出的是,22 毫秒目前已经足够快了。
完结撒花
表面上看,我们花了那么多时间使 npm run 命令快了大约 380 毫秒,这似乎事倍功半。虽然但是,如果您考虑一下整颗地球的开发者执行该命令的频率,以及在 CI 内执行该命令的频率,这些优化滚雪球惊人。对于本地开发而言,拥有更快速的 npm 脚本也很棒,所以肯定存在个人利益的角度。
但房间里的大大象仍然存在:没有简单的方法来短路模块图。目前为止,我见过的所有 JS 工具都存在此痛点。有些工具的影响更为明显,而另一些工具则影响较小。解析和加载一堆模块的开销非常真实。我不确定这个问题的长期解决方案是什么,或者 JS 引擎本身是否可以解决此问题。
在找到合适的解决方案之前,我们今天可以应用的一个可行的解决方案是,在将代码发布到 npm 时将其打包。我私下希望这不是唯一可行的不二法门,并且所有运行时都在这方面得到优化。我们需要处理的工具越少,我们作为一个生态系统对初学者就越友好。
免责声明
本文属于是语冰的直男翻译了属于是,略有删改,仅供粉丝参考
本文属于是语冰的直男翻译了属于是,略有删改,仅供粉丝参考,英文原味版请传送 Speeding up the JavaScript ecosystem - npm scripts[1]。
以上就是JS生态系统加速npm脚本优化及性能分析探索的详细内容,更多关于JS npm脚本的资料请关注本站其它相关文章!