

本文深入解析JavaScript中哈希表的实现原理,涵盖哈希函数设计、冲突处理策略(链地址法与开放地址法)及扩容机制。通过链地址法封装完整的哈希表类,详细演示插入、查询、删除及扩容操作的具体代码实现与测试过程。
一、哈希表原理
哈希表是一种极其重要的数据结构,在绝大多数编程语言中都有直接或间接的应用。它通常基于数组构建,但相较于普通数组,它具备更显著的优势:
- 它能够支持极快的插入、删除和查找操作。
- 哈希表的访问速度远超普通数组,基本可以实现瞬间定位目标元素。
- 相比数组,哈希表的编码实现要简单得多。
然而,哈希表相较于数组也存在一些局限性:
- 哈希表内部的数组元素没有固定的顺序,因此无法以特定方式(如从小到大)进行遍历。
- 通常情况下,哈希表中的键(key)不允许重复,不能放置相同的key来保存不同的元素。
那么,哈希表究竟是什么?
它的底层结构是数组,但其精妙之处在于对下标值进行了一种变换,这种变换被称为哈希函数,通过它可以计算出HashCode。
接下来,我们可以通过一个例子来理解:
假设我们需要使用一种数据结构来存储单词信息,例如50000个单词,每个单词对应具体的应用场景。我们应该如何处理?
或许我们可以尝试将字母转化为合适的下标。但如何将字符转化为数组的下标值呢?是否存在一种方案,能将单词直接转化为数组下标?如果单词能转化为下标,查找时只需一步即可访问目标元素。那么,如何将字符串转化为下标值?
计算机中有很多编码方案是用数字代替单词的字符,即字符编码。我们可以设计自己的编码系统,例如a是1,b是2,c是3等。但有了编码系统后,如何将一个单词转化为数字?
在这里,我们有两种方案:
方案一:数字相加
一种转换单词的简便方法是将单词每个字符的编码求和。
例如单词cats转化为数字:3+1+20+19=43,那么43就作为cats单词的下标存储在数组中。
但是按照这种方案有一个很明显的问题,就是很多单词最终的下标可能都是43。
我们知道数组中一个下标值位置只能存储一个数据,如果存入后来的数据,必然会造成数据覆盖,因此,一个下标存储这么多单词显然是不合理的。
方案二:幂的连乘
其实我们平时用的大于10的数字,就可以用幂的连乘来表示其唯一性,例如:6543 = 6 *10³+5 *10²+4 *10 + 4。
我们的单词也可以使用这种方案来表示,例如cats = 3 * 27³+1 * 27² + 20 * 27+17 = 60337。
这样得到的数字可以基本保证其唯一性,不会和别的单词重复。
但是存在一个问题,如果一个单词是zzzzzzzzzz,那么得到的数字超过7000000000000。数组不一定能够表示这么大的下标值,就算能够创建这么大的数组,事实上有很多的无效单词,并没有意义。
两种方案总结:
第一种方案(把数字相加求和)产生的数组下标太少,第二种方案(与27的幂相乘求和)产生的数组下标又太多。
所以现在需要一种压缩方法,把幂的连乘方案系统中得到的巨大整数范围压缩到可接收的数组范围中。有一种简单的方法就是使用取余操作符,它的作用是得到一个数被另一个数整除后的余数。
取余操作的实现:(0-199之间的数字)
假设把从0-199的数字,(large),压缩为0-9的数字(small)。
下标的结果index = large % small。
当一个数被10整除时,余数一定在0-9之间。
例如16%10 = 6,23%10 = 3。
这中间还是会有重复,不过重复的数量明显小了,比如说在0-199中间取5个数字,放在一个长度为10的数组,也会重复,但是重复的概率非常小。
二、哈希表的概念
了解了哈希化的原理,我们就可以来看几个概念:
哈希化:将大数字转化为数组范围内下标的过程,就称之为哈希化。
哈希函数:例如将单词转化为大数字,大数字在进行哈希化的代码实现放在一个函数中,这个函数就是哈希函数。
哈希表:最终将数据插入到这个数组,对整个结构的封装,就可以称之为一个哈希表。
三、哈希化冲突问题
前面提到了,通过哈希化的下标值依然可能会重复,就会导致冲突,比如说我们将0-199的数字选取5个放在长度为10的单元格里,如果我们随机选出来的是33,45,27,86,92,那么最终他们的位置会是3-5-7-6-2,没有发生冲突,但是其中如果还有一个86,一个66呢?此时就会发生冲突。该如何解决这个问题呢?
常用的解决方案有两种:
1、链地址法
链地址法是一种比较常见的解决冲突的方案(也称拉链法)。
如下图所示:
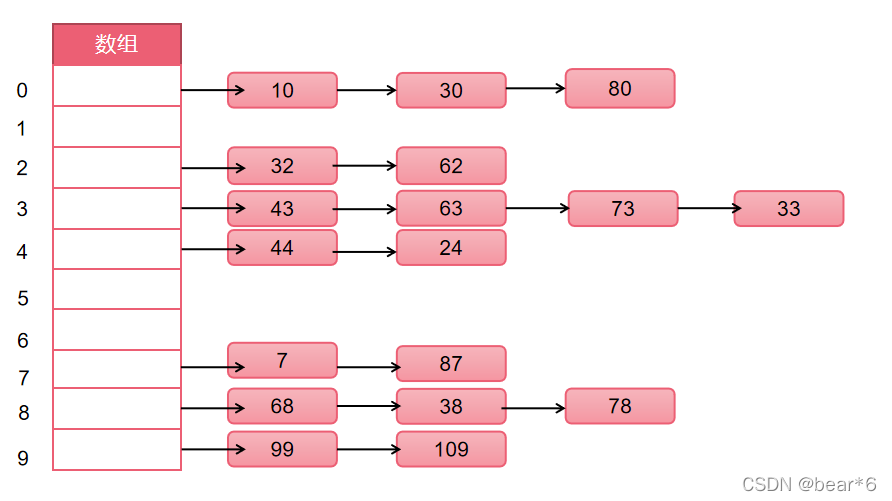
创建了一个内存为10的数组,现在,需要将一些数字存到数组内部,这些数字哈希化后可能会重复,将下标值相同的数通过链表或者数组链接起来的方法叫做链地址法。当我们要查找某值的时候,就可以先根据其下标找到对应的链表或者数组再在其内部寻找。
从图片中,我们可以看出,链地址法解决冲突的办法是每个数组单元中存储的不再是单个数据而是一个链条,这个链条常用的结构是数组或者链条。那在具体应用中应该采用哪一种方式呢?其实这两种方法都可以,效率上也差不多,当然在某些实现中,会将新插入的数据放在数组或者链表的最前面,这种情况最好用链表。因为数组再首位插入数据是需要所有其他项后移的的,而链表就没有这样的问题。
2、开放地址法
开放地址法的主要工作方式是寻找空白的单元格来添加重复的数据。如下图所示:
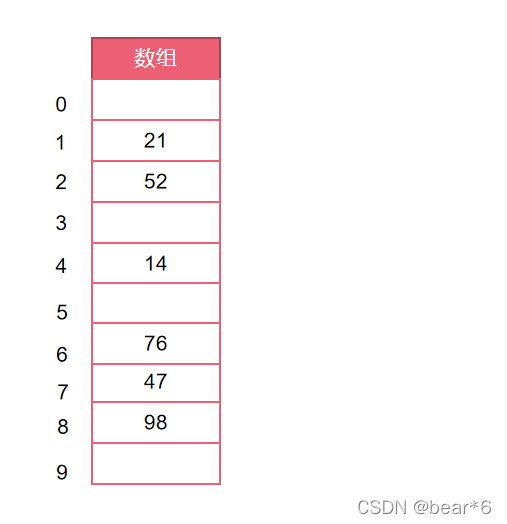
如果有一个数字32,现在要将其插入到数组中,我们的解决方案为:
- 新插入的32本来应该插入到52的位置,但是该位置已经包含数据,
- 可以发现3、5、9的位置是没有任何内容的
- 这个时候就可以寻找对应的空白位置来放这个数据
但是探索这个位置的方式不同,有三种方式:
1、线性探索
即线性的查找空白单元
插入32
- 经过哈希化得到的index=2,但是在插入的时候,发现该位置已经有52
- 此时就从index+1的位置开始一点点查找合适的位置来放置32
- 探测到的第一个空的位置就是该值插入的位置
查询32
- 首先经过哈希化得到index= 2,比较2的位置结果和查询的数值是否相同,相同则直接返回
- 不相同则线性查找,从index位置+1查找和32一样的。
需要注意的是:如果32的位置之前没有插入,并不需要将整个哈希表查询一遍来确定该值是否存在,而是如果查询到空位置,就停止。因为32之前不可能跳过空位置去其他的位置。
线性探测也有一个问题就是:如果之前插入的数据是连续插入的,则新插入的数据就需要很长的探测距离。
2、二次探索
二次探索就在线性探索的基础上进行了优化。
线性探测,我们可以看做是步长为1的探测,比如从下标值x开始,从x+1,x+2,x+3依次探测。
二次探测对步长做了优化,比如从下标值x开始,x+1²,x+2²,x+3²依次探测。
但是二次探测依然存在问题:比如我们连续插入的是32-112-82-42-52,那么他们依次累加的时候步长是相同的,也就是这种情况下会造成步长不一的一种聚集,还是会影响效率,怎样解决这个问题呢?来看看再哈希法。
3、再哈希法
再哈希法的做法就是:把关键字用另一个哈希函数在做一次哈希化,用这次哈希化的结果作为步长,对于指定的关键字,步长在整个探测中是不变的,不同的关键字使用不同的步长。
第二次哈希化需要具备以下特点:
和第一个哈希函数不同
不能输出为0(否则,将没有步长,每次叹词都是原地踏步,算法进入死循环)
而计算机专家已经设计好了一种工作很好的哈希函数。
stepSize = constant - (key % constant)
其中constant是质数,且小于数组的容量,key是第一次哈希化得到的值。
例如:stepSize = 5-(key%5),满足需求,并且结果不可能为0。
四、哈希函数的实现
哈希表的主要优点在于它的速度,提高速度的一个方法就是让哈希函数中有尽量少的乘法和除法,设计好的哈希函数需要具备以下优点:
(1)快速的计算
(2)均匀的分布
来具体实现一下:
首先我们所实现的哈希函数最主要的操作是:将字符创转化为比较大的数字和将大的数字压缩到数组范围之内。如下所示:
 function hashFunc(str,size){
            //定义hashCode变量
            var hashCode = 0;
            //根据霍纳算法,计算hashCode的值
            //先将字符串转化为数字编码
            for(var i =0;i<str.length;i++){
                hashCode = 37*hashCode + str.charCodeAt(i)
            }
            //取余操作
            var index = hashCode % size;
            return index;
        }
代码测试:
 console.log( hashFunc('abc',7));
       console.log( hashFunc('cba',7));
       console.log( hashFunc('nba',7));
       console.log( hashFunc('rgt',7));
测试结果为:
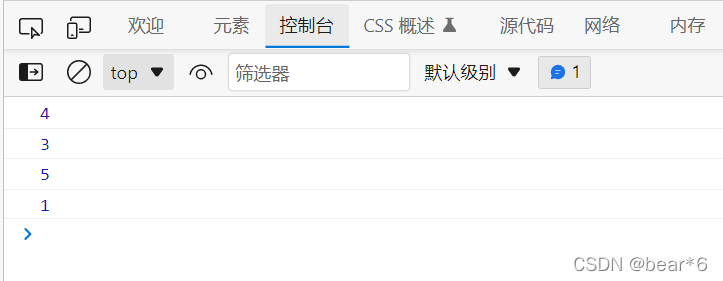
可以发现我们得到的字符串对应的下标值分布还是很均匀的。
五、封装哈希表
这里我将采用链地址法来实现哈希表:
其中定义了三个属性:
- storage:作为数组,存放相关元素
- count:记录当前已存放的数据量
- -limit:标记数组中一共可以存放多少数据
实现的哈希表(基于storage的数组)每个index对应的是一个数组(bucket),bucket里面存放的是(key和value),最终哈希表的数据格式是:[[[k,v],[k,v],[k,v],[[k,v],[k,v]],[k,v]]
如下图所示:
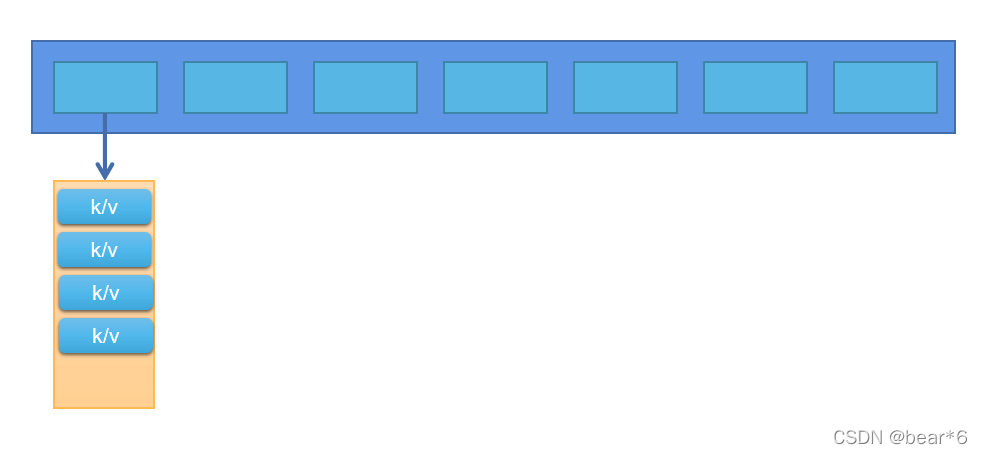
代码如下:
function HashTable(){
     // 定义属性
     this.storage = [];
     this.count = 0;
     this.limit = 8;
 }
在将我们前面封装好的哈希函数通过原型添加进去:
function HashTable(){
   // 定义属性
    this.storage = [];
    this.count = 0;
    this.limit = 8;

 HashTable.prototype.hashFunc = function(str,size){
      //定义hashCode变量
       var hashCode = 0;
       //先将字符串转化为数字编码
       for(var i =0;i<str.length;i++){
           hashCode = 37*hashCode + str.charCodeAt(i)
       }
       //取余操作
       var index = hashCode % size;
       return index;
   }
}
六、哈希表操作
1、插入&修改操作
哈希表的插入和修改操作是同一个函数,因为当使用者传入一个<key,value>时,如果原来不存在该key,那么就是插入操作,如果已经存在该key,对应的就是修改操作。
具体实现思路为:先根据传入的key获取对应的hashCode,即数组的index,接着从哈希表的Index位置中取出另一个数组(bucket),查看上一步的bucket是否为空,如果为空的话,表示之前在该位置没有放置过任何的内容,则新建一个数组[];再查看是否之前已经放置过key对应的value,如果放置过,那么就是依次替换操作,而不是插入新的数据,如果不是修改操作的话,那么插入新的数据,并且让数据项加1。
实现代码为:
 //插入和修改操作
        HashTable.prototype.put = function(key,value){
            //根据key获取对应的index
            var index = this.hashFunc(str,this.limit);
            //根据index取出对应的bucket
            var bucket = this.storage[index];
            //如果值为空,给bucket赋值一个数组
            if(bucket === null){
                bucket = [];
                this.storage[index] = bucket;
            }
            //判断是否是修改数据
            for(let i =0;i<bucket.length;i++){
                var tuple = bucket[i];
                if(tuple[0] === key){
                    tuple[1] = value;
                    return;
                }
            }
            //进行添加操作
            bucket.push([key,value]);
            this.count += 1;
        }
测试代码:
 ht.put('a',12)
 ht.put('b',67)
 ht.put('c',88)
 ht.put('d',66)
 console.log('ht',ht);
打印结果为:
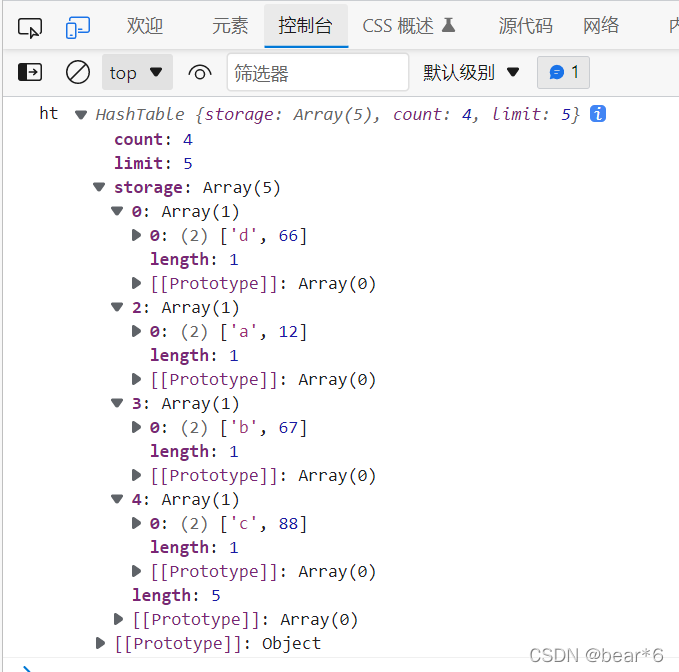
测试成功
2、获取操作
首先根据key获取对应的index,在根据对应的index获取对应的bucket;判断bucket是否为空,如果为空,返回null,否则,线性查找bucket中的key和传入的key是否相等,如果相等,直接返回对应的value值,否则,直接返回null。
实现代码为:
HashTable.prototype.get = function(key){
    //根据key获取对应的index
    var index = this.hashFunc(key,this.limit);
    //根据index获取对应的bucket
    var bucket = this.storage[index];
    //判断是否为空
    if(bucket == null){
        return null;
    }
    //线性查找
    for(let i = 0;i<bucket.length;i++){
        var tuple = bucket[i];
        if(tuple[0] === key){
            return tuple[1];
        }
    }
    return null;
}
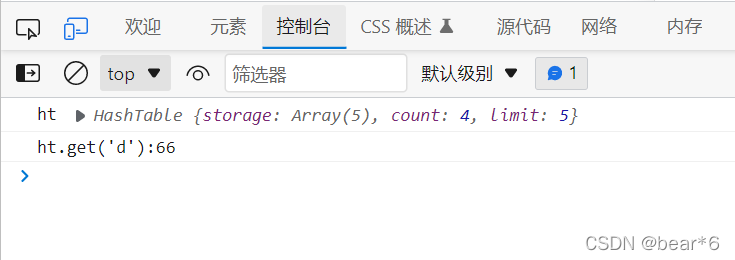
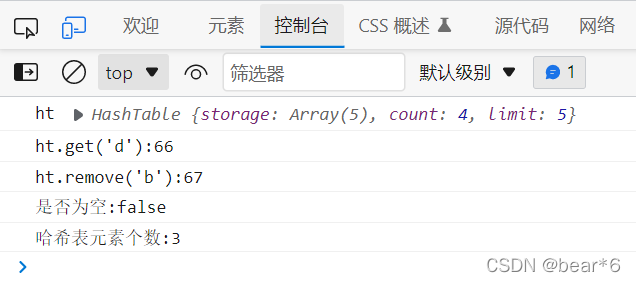
测试代码:比如回去key为d的元素的值
console.log("ht.get('d'):"+ht.get('d'));
3、删除操作
方法和获取操作的方法相似,首先根据key获取对应的index,在根据对应的index获取对应的bucket;判断bucket是否为空,如果为空,返回null,否则,线性查找bucket中的key和传入的key是否相等,如果相等,则进行删除,否则,直接返回null。
 HashTable.prototype.remove = function(key){
             //根据key获取对应的index
            var index = this.hashFunc(key,this.limit);
             //根据index获取对应的bucket
            var bucket = this.storage[index];
            //判断是否为空
            if(bucket == null){
                return null;
            }
            //线性查找并通过splice()删除
            for(let i =0;i<bucket.length;i++){
                var tuple = bucket[i];
                if(tuple[0] === key){
                    bucket.splice(i,1);
                    this.count -= 1;
                    return tuole[1];
                }
            }
            return null;
        }
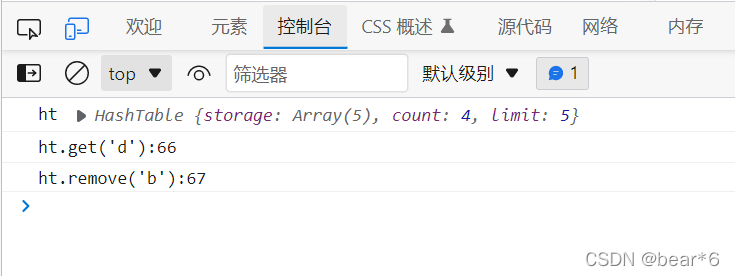
测试代码:删除key为b的元素
console.log("ht.remove('b'):"+ht.remove('b'));
4、判断哈希表是否为空
HashTable.prototype.isEmpty = function(){
            return this.count === 0;
        }
代码测试:
console.log("是否为空:"+ht.isEmpty());结果:
5、获取哈希表的元素个数
HashTable.prototype.size = function(){
            return this.count;
        }
代码测试:
console.log("哈希表元素个数:"+ht.size());结果:
七、哈希表扩容
1、哈希表扩容思想
上述代码的封装中,我们是将所有的数据项放在长度为5的数组中,因为我们使用的是链地址法,所以哈希表当前的数据量和总长度的比值可以大于1,这个哈希表可以无限制的插入新数据。但是,随着数据量的增多,每一个index对应的bucket会越来越长,也会造成效率的降低,所以,在合适的情况下对数组进行扩容是很有必要的。那应该如何进行扩容呢?扩容可以简单的将容量增大两倍,但是在这种情况下,所有的数据项一定要同时进行修改(重新调用哈希函数,获取到不同的位置)什么情况下扩容呢?比较常见的是:当哈希表当前的数据量和总长度的比值可以大于0.75的时候就可以进行扩容。
2、哈希表扩容实现
实现思路:首先,保存旧的数组内容,然后重置所有的属性,遍历保存的旧数组的内容,判断bucket是否为空,为空的话,进行跳过,否则,取出数据,重新插入,实现代码为:
HashTable.prototype.resize = function(newLimit){
            //保存旧数组的内容
            var oldStorge = this.storage;
            //重置所有属性
            this.storage = [];
            this.count = 0;
            this.limit = newLimit;
            //遍历旧数组的内容
            for(var i =0;i<oldStorge.length;i++){
                //取出对应的bucket
                var bucket = oldStorge[i];
                //判断backet是否为空
                if(bucket == null){
                    continue;
                }
                //取出数据重新插入
                for(var j =0;j<bucket.length;j++){
                    var tuple = bucket[j];
                    this.put(tuple[0],tuple[1]);
                }
            }
        }
封装完成后,每添加一个数据项的时候,就进行是否扩容判断,需要的话,在进行扩容,代码为:
if(this.count > this.limit*0.75){
   this.resize(this.limit*2);
     }
那么,有对应的扩大容量,就有对应的缩小容量,当我们删除数据项的时候,如果剩余的数据项很小,我们就可以进行缩小容量,代码如下:
if(this.limit > 5 && this.count < this.limit/2){
    this.resize(Math.floor(this.limit/2))
     }
八、完整代码
  function HashTable(){
   // 定义属性
       this.storage = [];
       this.count = 0;
       this.limit = 5;

       HashTable.prototype.hashFunc = function(str,size){
       //定义hashCode变量
       var hashCode = 0;
       //根据霍纳算法,计算hashCode的值
       //先将字符串转化为数字编码
       for(var i =0;i<str.length;i++){
           hashCode = 37*hashCode + str.charCodeAt(i)
       }
       //取余操作
       var index = hashCode % size;
       return index;
   }
   //插入和修改操作
   HashTable.prototype.put = function(key,value){
       //根据key获取对应的index
       var index = this.hashFunc(key,this.limit);
       //根据index取出对应的bucket
       var bucket = this.storage[index];
       //如果值为空,给bucket赋值一个数组
       if(bucket == null){
           bucket = [];
           this.storage[index] = bucket;
       }
       //判断是否是修改数据
       for(let i =0;i<bucket.length;i++){
           var tuple = bucket[i];
           if(tuple[0] === key){
               tuple[1] = value;
               return;
           }
       }
       //进行添加操作
       bucket.push([key,value]);
       this.count += 1;
       //进行扩容判断
       if(this.count > this.limit*0.75){
           this.resize(this.limit*2);
       }
   }

   //获取操作
   HashTable.prototype.get = function(key){
       //根据key获取对应的index
       var index = this.hashFunc(key,this.limit);
       //根据index获取对应的bucket
       var bucket = this.storage[index];
       //判断是否为空
       if(bucket == null){
           return null;
       }
       //线性查找
       for(let i = 0;i<bucket.length;i++){
           var tuple = bucket[i];
           if(tuple[0] === key){
               return tuple[1];
           }
       }
       return null;
   }
   //删除操作
   HashTable.prototype.remove = function(key){
        //根据key获取对应的index
       var index = this.hashFunc(key,this.limit);
        //根据index获取对应的bucket
       var bucket = this.storage[index];
       //判断是否为空
       if(bucket == null){
           return null;
       }
       //线性查找并通过splice()删除
       for(let i =0;i<bucket.length;i++){
           var tuple = bucket[i];
           if(tuple[0] === key){
               bucket.splice(i,1);
               this.count -= 1;
               return tuple[1];

               //缩小容量
               if(this.limit > 5 && this.count < this.limit/2){
                   this.resize(Math.floor(this.limit/2))
               }
           }
       }
       return null;
   }
   //扩容
   HashTable.prototype.resize = function(newLimit){
       //保存旧数组的内容
       var oldStorge = this.storage;
       //重置所有属性
       this.storage = [];
       this.count = 0;
       this.limit = newLimit;
       //遍历旧数组的内容
       for(var i =0;i<oldStorge.length;i++){
           //取出对应的bucket
           var bucket = oldStorge[i];
           //判断backet是否为空
           if(bucket == null){
               continue;
           }
           //取出数据重新插入
           for(var j =0;j<bucket.length;j++){
               var tuple = bucket[j];
               this.put(tuple[0],tuple[1]);
           }
       }
   }
   HashTable.prototype.isEmpty = function(){
       return this.count === 0;
   }
   HashTable.prototype.size = function(){
       return this.count;
   }
}
到此这篇关于详解JavaScript实现哈希表的文章就介绍到这了,更多相关JavaScript哈希表内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!