

本文详解JavaScript中宏的使用机制,对比Rust与JS的宏支持差异,分析为何在Create-React-App等工具链中优先使用宏而非直接编写Babel插件。通过实战编写importURL宏,展示如何利用babel-plugin-macros、同步请求及AST转换实现编译期代码拉取与替换,涵盖从环境配置到代码生成的完整流程。
在编程语言中,宏通常用于实现领域特定语言(DSL)。借助宏,开发者可以定义自定义的语言格式,例如实现类似 JSX 的语法。随着 WebAssembly(WASM)技术的成熟,使用其他语言编写网页已成为可能。以 Rust 语言为例,其强大的宏功能使得基于 Rust 的 Yew 框架无需依赖类似 Babel 的转换工具,仅凭语言本身的宏机制即可实现类 JSX 语法。以下是一个支持类 JSX 语法的 Yew 组件示例。
impl Component for MyComponent {
    // ...

    fn view(&self) -> Html {
        let onclick = self.link.callback(|_| Msg::Click);
        html! {
            <button onclick=onclick>{ self.props.button_text }</button>
        }
    }
}
JavaScript 宏的局限性
与 Rust 不同,JavaScript 原生不支持宏,因此整个工具链也未针对宏进行优化。虽然可以编写识别自定义语法的宏,但由于配套工具(如常见的 VSCode 和 TypeScript)不支持,会直接报出语法错误。同样,Babel 自身的解析器也不支持扩展语法,除非 Fork 修改 Babel 源码。因此,babel-plugin-macros 不支持自定义语法。不过,借助模板字符串函数,我们可以采取间接方式,至少获得部分自定义语法树的能力。以下是一个在 JavaScript 中直接编写 GraphQL 的示例。
import { gql } from 'graphql.macro';

const query = gql`
  query User {
    user(id: 5) {
      lastName
      ...UserEntry1
    }
  }
`;

//  在编译期会转换成 ↓ ↓ ↓ ↓ ↓ ↓

const query = {
  "kind": "Document",
  "definitions": [{
    ...
为什么要用宏而非 Babel 插件
Babel 插件的能力确实远超宏,且在某些场景下必须使用插件。宏相比 Babel 插件的优势在于其“开箱即用”的理念。使用 React 的开发者可能熟悉 Create-React-App(CRA),它封装了各种底层细节,让开发者专注于代码编写。然而,CRA 的封装过于严格,一旦需要自定义 Babel 插件,通常需执行 yarn react-scripts eject 暴露所有底层细节。相比之下,使用宏只需在项目的 Babel 配置中添加 babel-plugin-macros 插件,即可完美支持任何自定义 Babel 宏,无需下载多个独立插件。CRA 已内置 babel-plugin-macros,因此可在 CRA 项目中直接使用任意 Babel 宏。
如何写一个宏?
介绍
宏的编写方式与 Babel 插件非常相似,因此事先了解如何编写 Babel 插件非常有帮助。Babel 官方手册专门介绍了从零编写 Babel 插件的方法。在掌握 Babel 插件编写后,我们通过一个宏的使用示例,介绍 Babel 如何识别文件中的宏:是某种特殊语法,还是常用的 $ 符号?
import preval from 'preval.macro'

const one = preval`module.exports = 1 + 2 - 1 - 1`
这是一个非常常见的宏,其作用是在编译期间执行字符串中的 JavaScript 代码,并将执行结果替换到相应位置。上述代码在编译期会被展开为:
import preval from 'preval.macro'

const one = 1
从使用方式来看,唯一与识别宏相关的是 *.macro 字符,这确实也是 Babel 识别宏的方式。实际上,不仅对于 *.macro 形式,Babel 认为库名匹配正则 /[./]macro(\.c?js)?$/ 的库即为 Babel 宏。以下是一些匹配表达式的示例:
'my.macro'
'my.macro.js'
'my.macro.cjs'
'my/macro'
'my/macro.js'
'my/macro.cjs'
编写
接下来,我们将简单编写一个 importURL 宏,其作用是通过 URL 引入库,并在编译期间将这些库的代码预先拉取、处理后引入文件。虽然部分 Webpack 插件已支持从 URL 引入库,但这仍是一个很好的学习如何编写宏的例子,同时也展示了如何在 Node.js 中发起同步请求。
准备
首先创建一个名为 importURL 的文件夹,执行 npm init -y 快速创建项目。使用宏的用户需要安装 babel-plugin-macros,编写宏的用户同样需要安装此插件。在编写之前,还需提前安装一些辅助库:
- 在 package.json 中将 name 改为 import-url.macro,以符合 Babel 识别宏的格式
- 我们需要使用 Babel 提供的辅助方法来创建宏。执行 yarn add babel-plugin-macros
- yarn add fs-extra,一个更易于使用的替代 Node.js fs 模块的库
- yarn add find-root,编写宏的过程中,我们需要根据处理文件的路径找到其所在的工作目录,从而写入缓存,这是一个已封装好的库
示例
我们的目标是将如下代码转换为目标格式:
import importURL from 'importurl.macros';

const React = importURL('https://unpkg.com/react@17.0.1/umd/react.development.js');

// 编译成

import importURL from 'importurl.macros';

const React = require('../cache/pkg1.js');
我们将解析代码中 importURL 函数的第一个参数,将其视为远程库的地址,然后在编译期间通过 GET 请求同步拉取代码内容。接着将代码写入项目顶层文件夹下的 .cache 目录,并将相应的 importURL 语句替换为 require(...) 语句。路径...则是使用 importURL 的文件相对于 .cache 中文件的相对路径,以便 webpack 在最终打包时能找到对应代码。
开始
我们先看看最终的代码长什么样。
import { execSync } from 'child_process';
import findRoot from 'find-root';
import path from 'path';
import fse from 'fs-extra';

import { createMacro } from 'babel-plugin-macros';

const syncGet = (url) => {
  const data = execSync(`curl -L ${url}`).toString();
  if (data === '') {
    throw new Error('empty data');
  }
  return data;
}

let count = 0;
export const genUniqueName = () => `pkg${++count}.js`;

module.exports = createMacro((ctx) => {
  const {
    references, // 文件中所有对宏的引用
    babel: {
      types: t,
    }
  } = ctx;
  // babel 会把当前处理的文件路径设置到 ctx.state.filename
  const workspacePath = findRoot(ctx.state.filename);
  // 计算出缓存文件夹
  const cacheDirPath = path.join(workspacePath, '.cache');
  //
  const calls = references.default.map(path => path.findParent(path => path.node.type === 'CallExpression' ));
  calls.forEach(nodePath => {
    // 确定 astNode 的类型
    if (nodePath.node.type === 'CallExpression') {
      // 确定函数的第一个参数是纯字符串
      if (nodePath.node.arguments[0]?.type === 'StringLiteral') {
        // 获取一个参数,当做远程库的地址
        const url = nodePath.node.arguments[0].value;
        // 根据 url 拉取代码
        const codes = syncGet(url);
        // 生成一个唯一包名,防止冲突
        const pkgName = genUniqueName();
        // 确定最终要写入的文件路径
        const cahceFilename = path.join(cacheDirPath, pkgName);
        // 通过 fse 库,将内容写入, outputFileSync 会自动创建不存在的文件夹
        fse.outputFileSync(cahceFilename, codes);
        // 计算出相对路径
        const relativeFilename = path.relative(ctx.state.filename, cahceFilename);
        // 最终计算替换 importURL 语句
        nodePath.replaceWith(t.stringLiteral(`require('${relativeFilename}')`))
      }
    }
  });
});
创建一个宏
我们通过 createMacro 函数来创建宏,createMacro 接受我们编写的函数作为参数来生成宏。实际上,我们并不关心 createMacro 的返回值是什么,因为我们的代码最终都会被自己替换掉,不会在运行期间执行。我们编写的函数的第一个参数是 Babel 传递给我们的一些状态,我们可以大致查看其类型。
function createMacro(handler: MacroHandler, options?: Options): any;
interface MacroParams {
      references: { default: Babel.NodePath[] } & References;
      state: Babel.PluginPass;
      babel: typeof Babel;
      config?: { [key: string]: any };
  }
export interface PluginPass {
    file: BabelFile;
    key: string;
    opts: PluginOptions;
    cwd: string;
    filename: string;
    [key: string]: unknown;
}
可视化 AST
我们可以通过 astexplorer 观察将要处理代码的语法树。对于如下代码:
import importURL from 'importurl.macros';

const React = importURL('https://unpkg.com/react@17.0.1/umd/react.development.js');
会生成如下语法树:
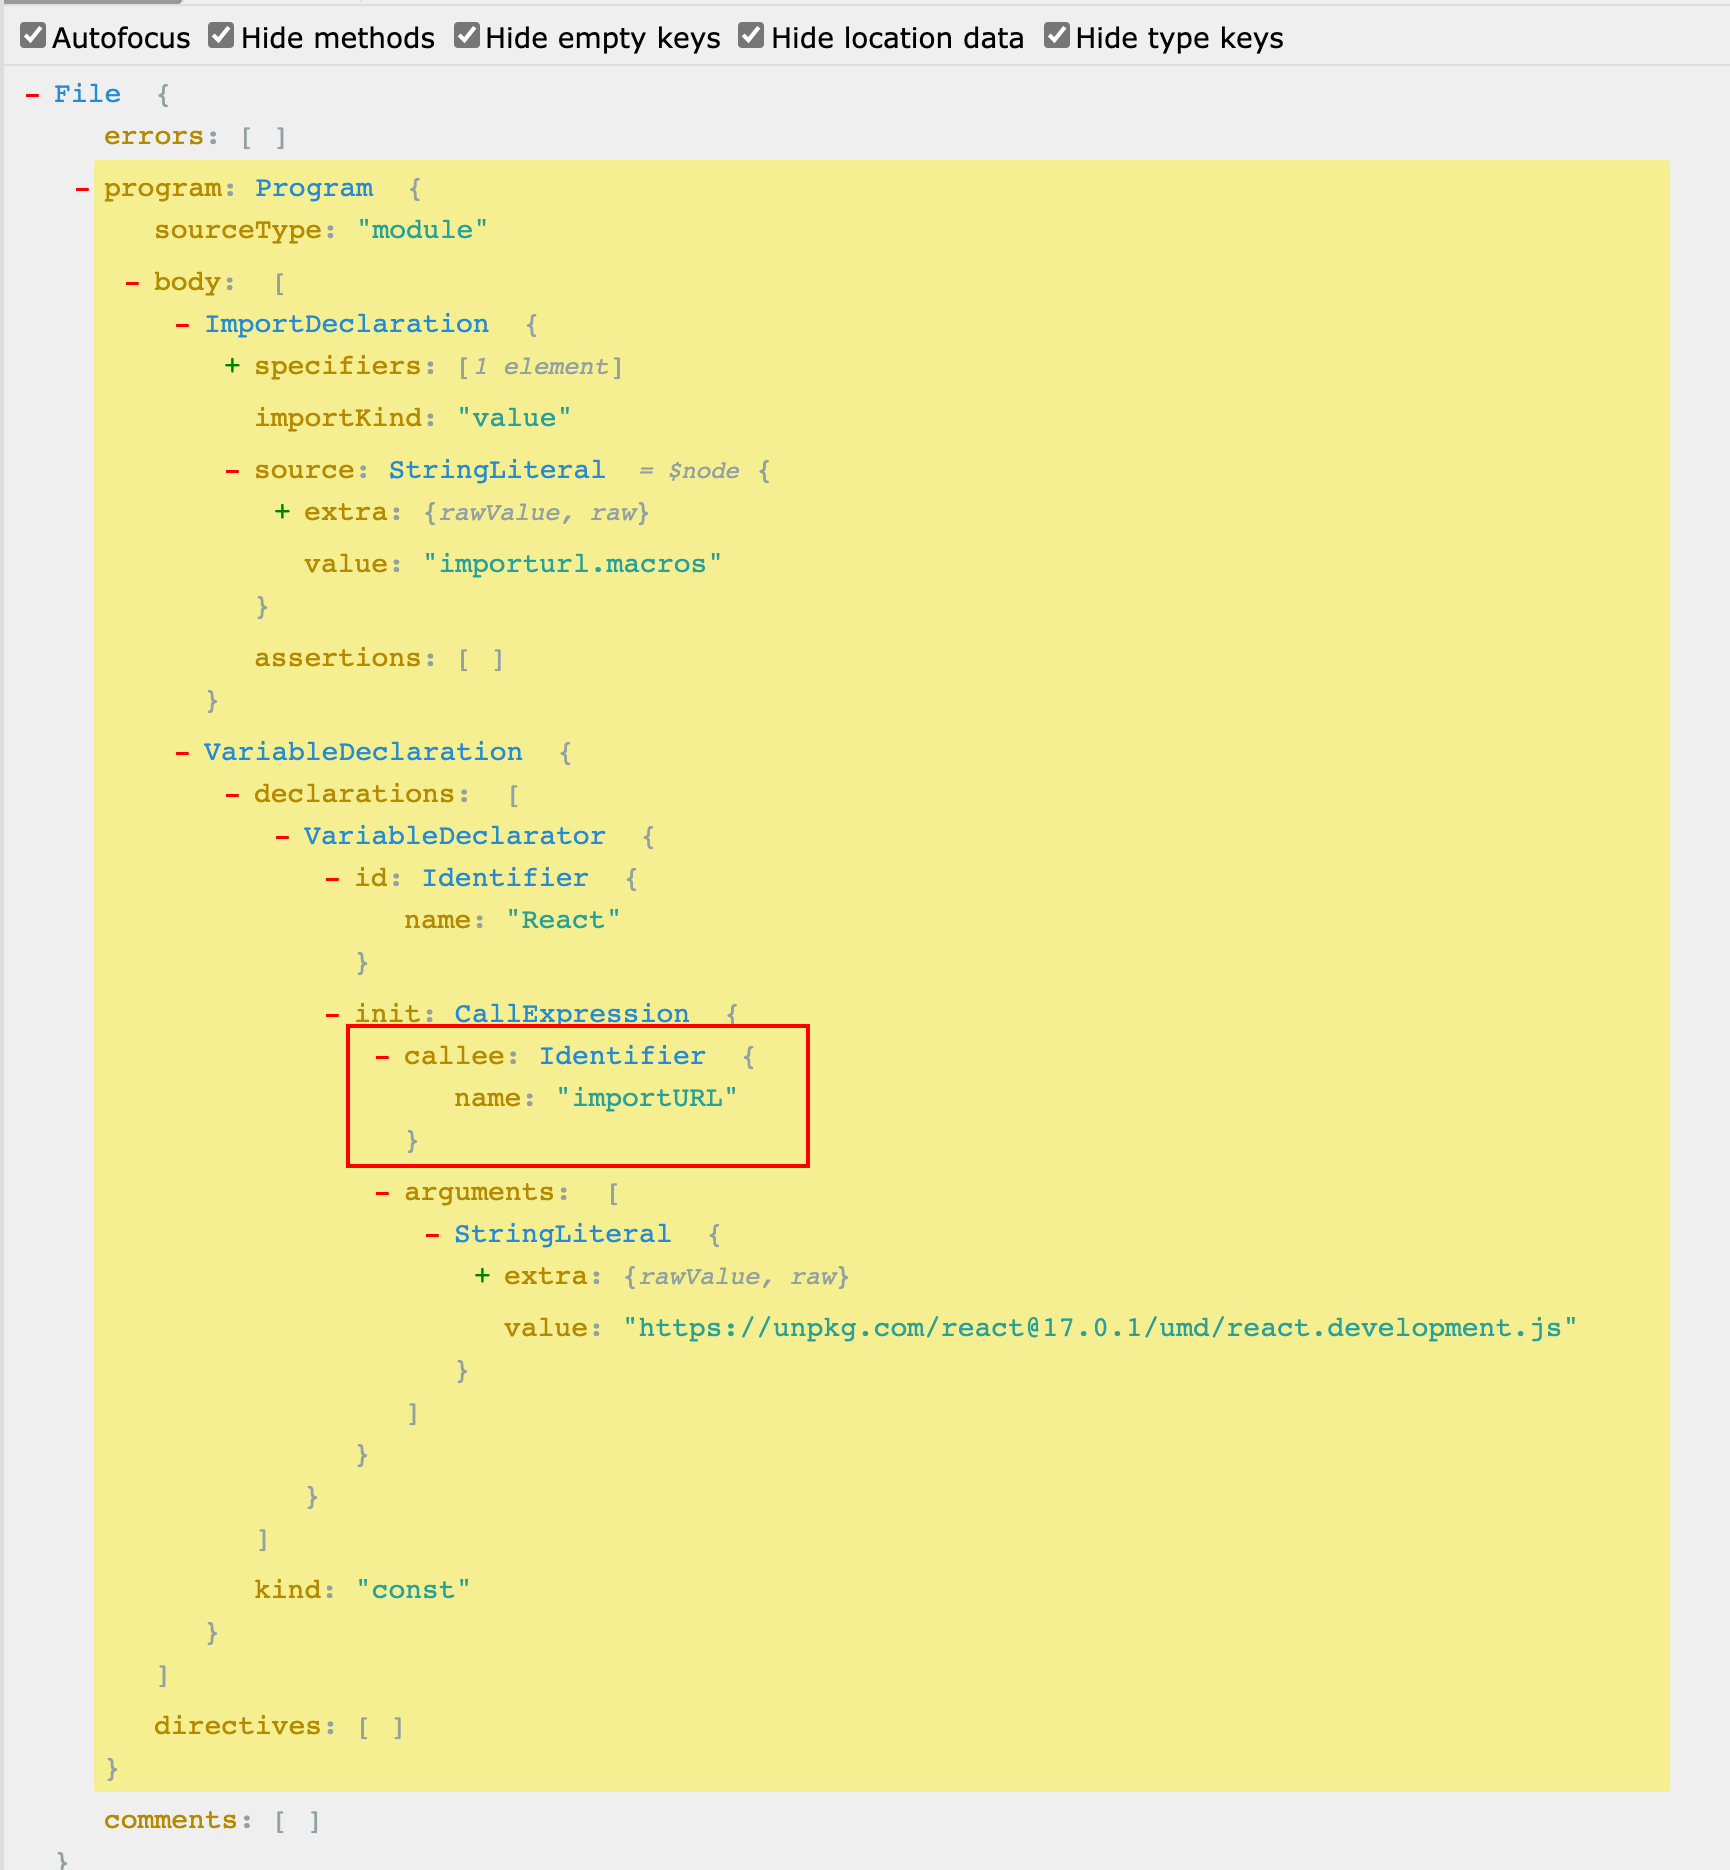
红色标红的语法树节点,就是 Babel 会通过 ctx.references 传递给我们的。因此,我们需要通过 .findParent() 方法向上找到父节点 CallExpression,才能获取 arguments 属性下的参数,从而拿到远程库的 URL 地址。
同步请求
这里的一个难点在于,Babel 不支持异步转换,所有转换操作都是同步的,因此在发起请求时也必须是同步请求。我原本以为这很简单,Node.js 会提供类似 sync: true 的选项,但实际上并没有。Node.js 确实不支持任何同步请求,除非采用下面这种较怪异的方式:
const syncGet = (url) => {
  const data = execSync(`curl -L ${url}`).toString();
  if (data === '') {
    throw new Error('empty data');
  }
  return data;
}
收尾
在拿到代码后,我们将代码写入到开始计算出的文件路径中。这里使用 fs-extra 的目的在于,fs-extra 在写入时如果遇到不存在的文件夹,不会像 fs 模块那样直接抛出错误,而是自动创建相应的文件夹。写入完成后,我们通过 Babel 提供的辅助方法 stringLiteral 创建字符串节点,随后替换掉我们的 importURL(...),自此整个转换流程结束。
最后
这个宏存在一些缺陷,有兴趣的同学可以继续完善:
没有识别同一 URL 的库进行复用,不过我想这些已经满足如何编写一个宏的目的了。
genUniqueName 在跨文件时会计算出重复包名,正确的算法应该是根据 URL 计算哈希值来作为唯一包名
到此这篇关于在JavaScript中如何使用宏的文章就介绍到这了,更多相关JavaScript使用宏内容请搜索本站以前的文章或继续浏览下面的相关文章,希望大家以后多多支持本站!