

最新中文多模态评测显示,国产模型首次整体反超海外主流模型。字节跳动豆包模型以90.66分居首,领先谷歌等国际产品。测评涵盖25项任务,国产模型在基础感知与数据解析方面平均分突破90,表现稳定,但在复杂推理及专业垂直领域仍有提升空间。此次超越体现了国产模型在中文理解、跨模态协
国产AI模型豆包反超海外 多模态技术实现突破
作者:技术拾光
时间:2026-08-13
浏览:503
文章目录
2026年4月,SuperCLUE-VLM中文多模态模型评测榜单正式发布。结果显示,国产模型阵营实现集体跃升,表现突出。其中,字节跳动旗下豆包模型Doubao-Seed-2.0-Pro-260215以90.66分的成绩位列榜首,领先于谷歌的Gemini-3.1-Pro-Preview模型。
国产多模态模型表现亮眼
本次评测涵盖了全球17款主流视觉语言模型。榜单清晰显示,国产模型整体表现优异。阿里通义千问Qwen3.5系列、商汤SenseNova、智谱GLM等国内主力模型均进入榜单前列。相比之下,OpenAI的GPT-5.4、X.AI的Grok等国际模型排名居中,整体上被国产模型反超。
评测体系与模型能力分析
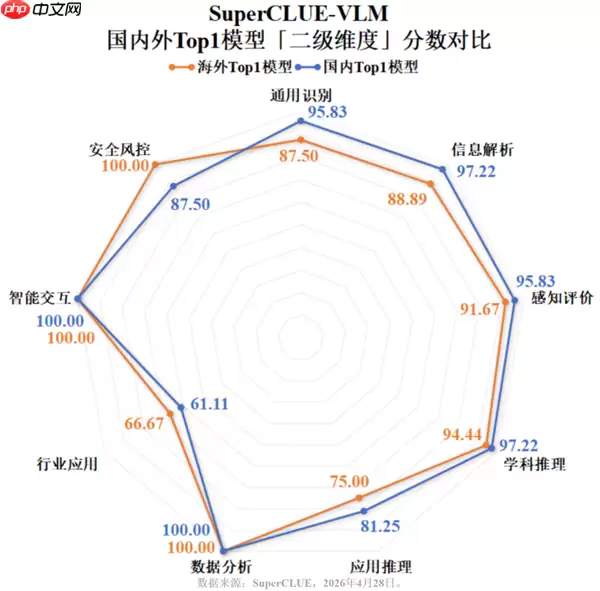
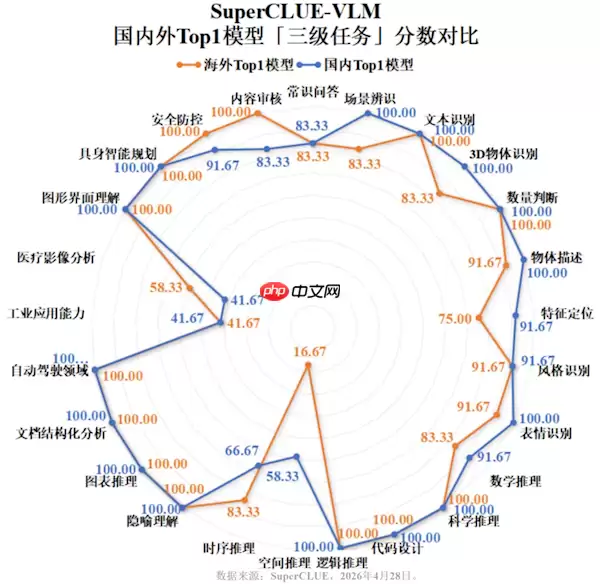
SuperCLUE-VLM评测体系主要考察模型的三大核心能力:基础认知、视觉逻辑推理以及视觉实际应用。评测具体覆盖了通用图像识别、图表分析、医学影像判读等25个细分任务。从得分来看,国产模型在基础感知与数据解析类任务上优势显著,平均得分超过90分,展现了良好的系统稳定性。然而,在复杂视觉推理、工业检测及临床辅助诊断等专业垂直领域,模型性能仍有提升空间。
中文多模态AI进入新发展阶段
总体而言,此次榜单标志着中文多模态AI发展进入新阶段。国产模型在中文语境理解深度、跨模态信息协同以及本土化任务适配方面,已展现出全面领先优势。这不仅是技术分数的超越,也体现了其技术路径与应用生态的成熟。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
相关文章