

趋境科技与清华大学联合开源的KTransformers高性能异构推理框架,已成为Qwen、Kimi等主流大模型的推荐推理引擎。其通过高效调度GPU、CPU等异构资源,显著降低大模型推理与微调成本,使单卡运行千亿模型成为可能。该框架技术获SOSP2025顶会认可,并与SGLang、LLaMA-Factory等深度集成,推动高性能、低门槛的AI部署,助力大模型能
KTransformers开源框架受青睐,Qwen、Kimi与智谱AI推荐单卡运行万亿模型
作者:技术拾光
时间:2026-08-12
浏览:575
文章目录
在AI技术快速迭代的今天,一个底层框架的实力如何,往往不看它自己怎么说,而看顶尖的玩家们怎么选。当Qwen、Kimi、智谱AI等主流大模型在发布首日,都不约而同地将KTransformers列为推荐推理引擎时,答案已经不言而喻。这款由趋境科技与清华大学联合开源的高性能异构推理框架,正凭借其卓越的工程实践与广泛的兼容性,成为从开发者、硬件厂商到开源社区共同信赖与复用的“基建”选择。
技术与生态双认可:成功入选 “计算机系统领域奥斯卡” SOSP 2025
KTransformers的核心使命很明确:高效榨干每一份算力。它专注于调度GPU、CPU、内存等多样化的异构资源,目标就是让动辄千亿参数的大模型,能在更低成本、更灵活的硬件上跑起来、反赌。这份技术硬实力,得到了全球顶级学术圈的盖章认证——其研究论文《KTransformers: Unleashing the Full Potential of CPU/GPU Hybrid Inference for MoE Models》成功入选了素有“计算机系统领域奥斯卡”之称的SOSP 2025。要知道,这个顶会的历史,几乎就是一部现代计算技术的编年史,虚拟化、分布式文件系统等里程碑都曾在此首次亮相。KTransformers的入选,无疑标志着其技术路线与创新价值获得了世界级的肯定。
技术认可很快转化为了市场敏捷性。就在月之暗面发布千亿级Kimi-K2-Thinking模型后,KTransformers迅速完成了全面适配。现在,用户凭借单张显卡就能完成推理,两张卡即可进行LoRA微调,部署和定制化的门槛被大幅拉低。更值得一提的是,趋境科技已经完成了该模型在昇腾NPU上的全栈适配,提供了一套完善的全国产化推理方案,这为其在更广阔、要求更严苛的应用场景中铺平了道路。
推理与微调双高效:KTransformers+SGLang实现高性能推理部署
在推理端,一场“1+1>2”的合作正在深化。今年10月,KTransformers与主流推理框架SGLang达成合作,双方架构已合入同一分支。效果是立竿见影的:面对Kimi-K2-1TB这样的巨量模型,用户现在只需简单安装SGLang和KTransformers的CPU内核,下载官方模型与量化权重,一条命令就能启动服务,而且硬件需求仅需单张消费级GPU搭配CPU。这背后,是GPU+CPU异构推理创新模式与全GPU传统模式的深度融合,它正推动大模型推理向着更高性能、更低成本的方向演进,为产业大规模落地扫清关键障碍。
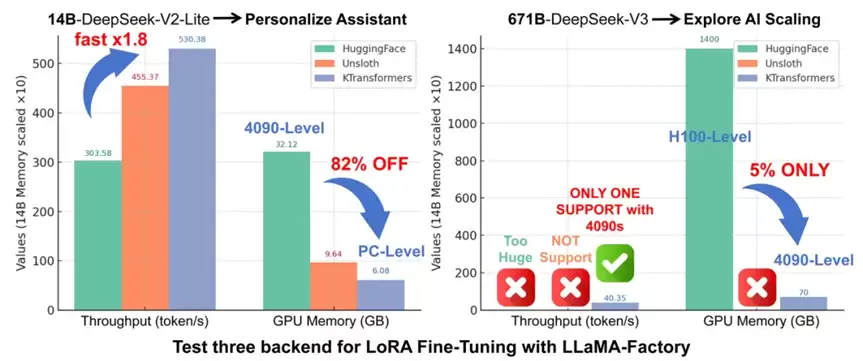
如果说推理是“用模型”,那么微调就是“养模型”,而后者的成本曾经高不可攀。KTransformers与LLaMA-Factory深度集成后,改变了游戏规则。它支持LoRA等轻量级微调方法,仅需约41GB显存和2T内存,就能实现46.55 token/s的微调吞吐量。传统方案微调千亿模型,成本可能高达数百万,而趋境的异构微调能力,将资源起点拉低到了单个消费级GPU(例如一块RTX 4090)。这意味着,高校实验室、中小型创业公司,甚至个人开发者,都有机会参与到超大模型的定制中来。在DeepSeek-14B模型上的测试显示,该方案吞吐量超过传统方案1.8倍,显存占用降低82%,堪称在消费级显卡上微调千亿级MoE模型的唯一可行路径。
从技术突破到生态共建,KTransformers承载的其实是“普惠”二字。大模型时代不能只有一条昂贵的技术路线,它需要更广谱、更易得的推理基础设施。为此,趋境科技已与多家国产CPU、GPU硬件平台展开合作,共同推进高性价比的全国产方案;同时,也为数十家行业伙伴提供了坚实的算力底座,让更多团队能够用得起、调得动大模型。可以说,今天的KTransformers,已经让大模型推理开始摆脱对高端算力的绝对依赖;而它的未来,在于持续推动AI能力下沉,让智能真正融入千行百业的毛细血管之中。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
相关文章