

斯坦福团队通过设计单一CUDA核心“Megakernel”,将Llama-1B模型的前向推理延迟压缩至不足1毫秒,显存带宽利用率提升至78%。该方法将整个计算流程融合进一个内核,消除了传统多内核架构的频繁切换与等待开销,实现了接近硬件极限的性能,尤其适用于对延迟极度敏感的实时AI场景。
斯坦福团队新作:Llama-1B实现毫秒级推理获Andrej Karpathy盛赞
作者:技术拾光
时间:2026-08-12
浏览:524
文章目录
在实时对话、人机交互等对响应速度要求极高的AI应用场景中,大语言模型的推理延迟即使仅降低几毫秒,用户体验也可能有显著提升。近期,斯坦福 Hazy Research 团队取得了一项突破性优化,将开源小模型 Llama-3.2-1B 的前向推理延迟推至新极限——通过将所有计算整合进一个名为“Megakernel”的单一CUDA核心,实现了接近理论极限的性能。
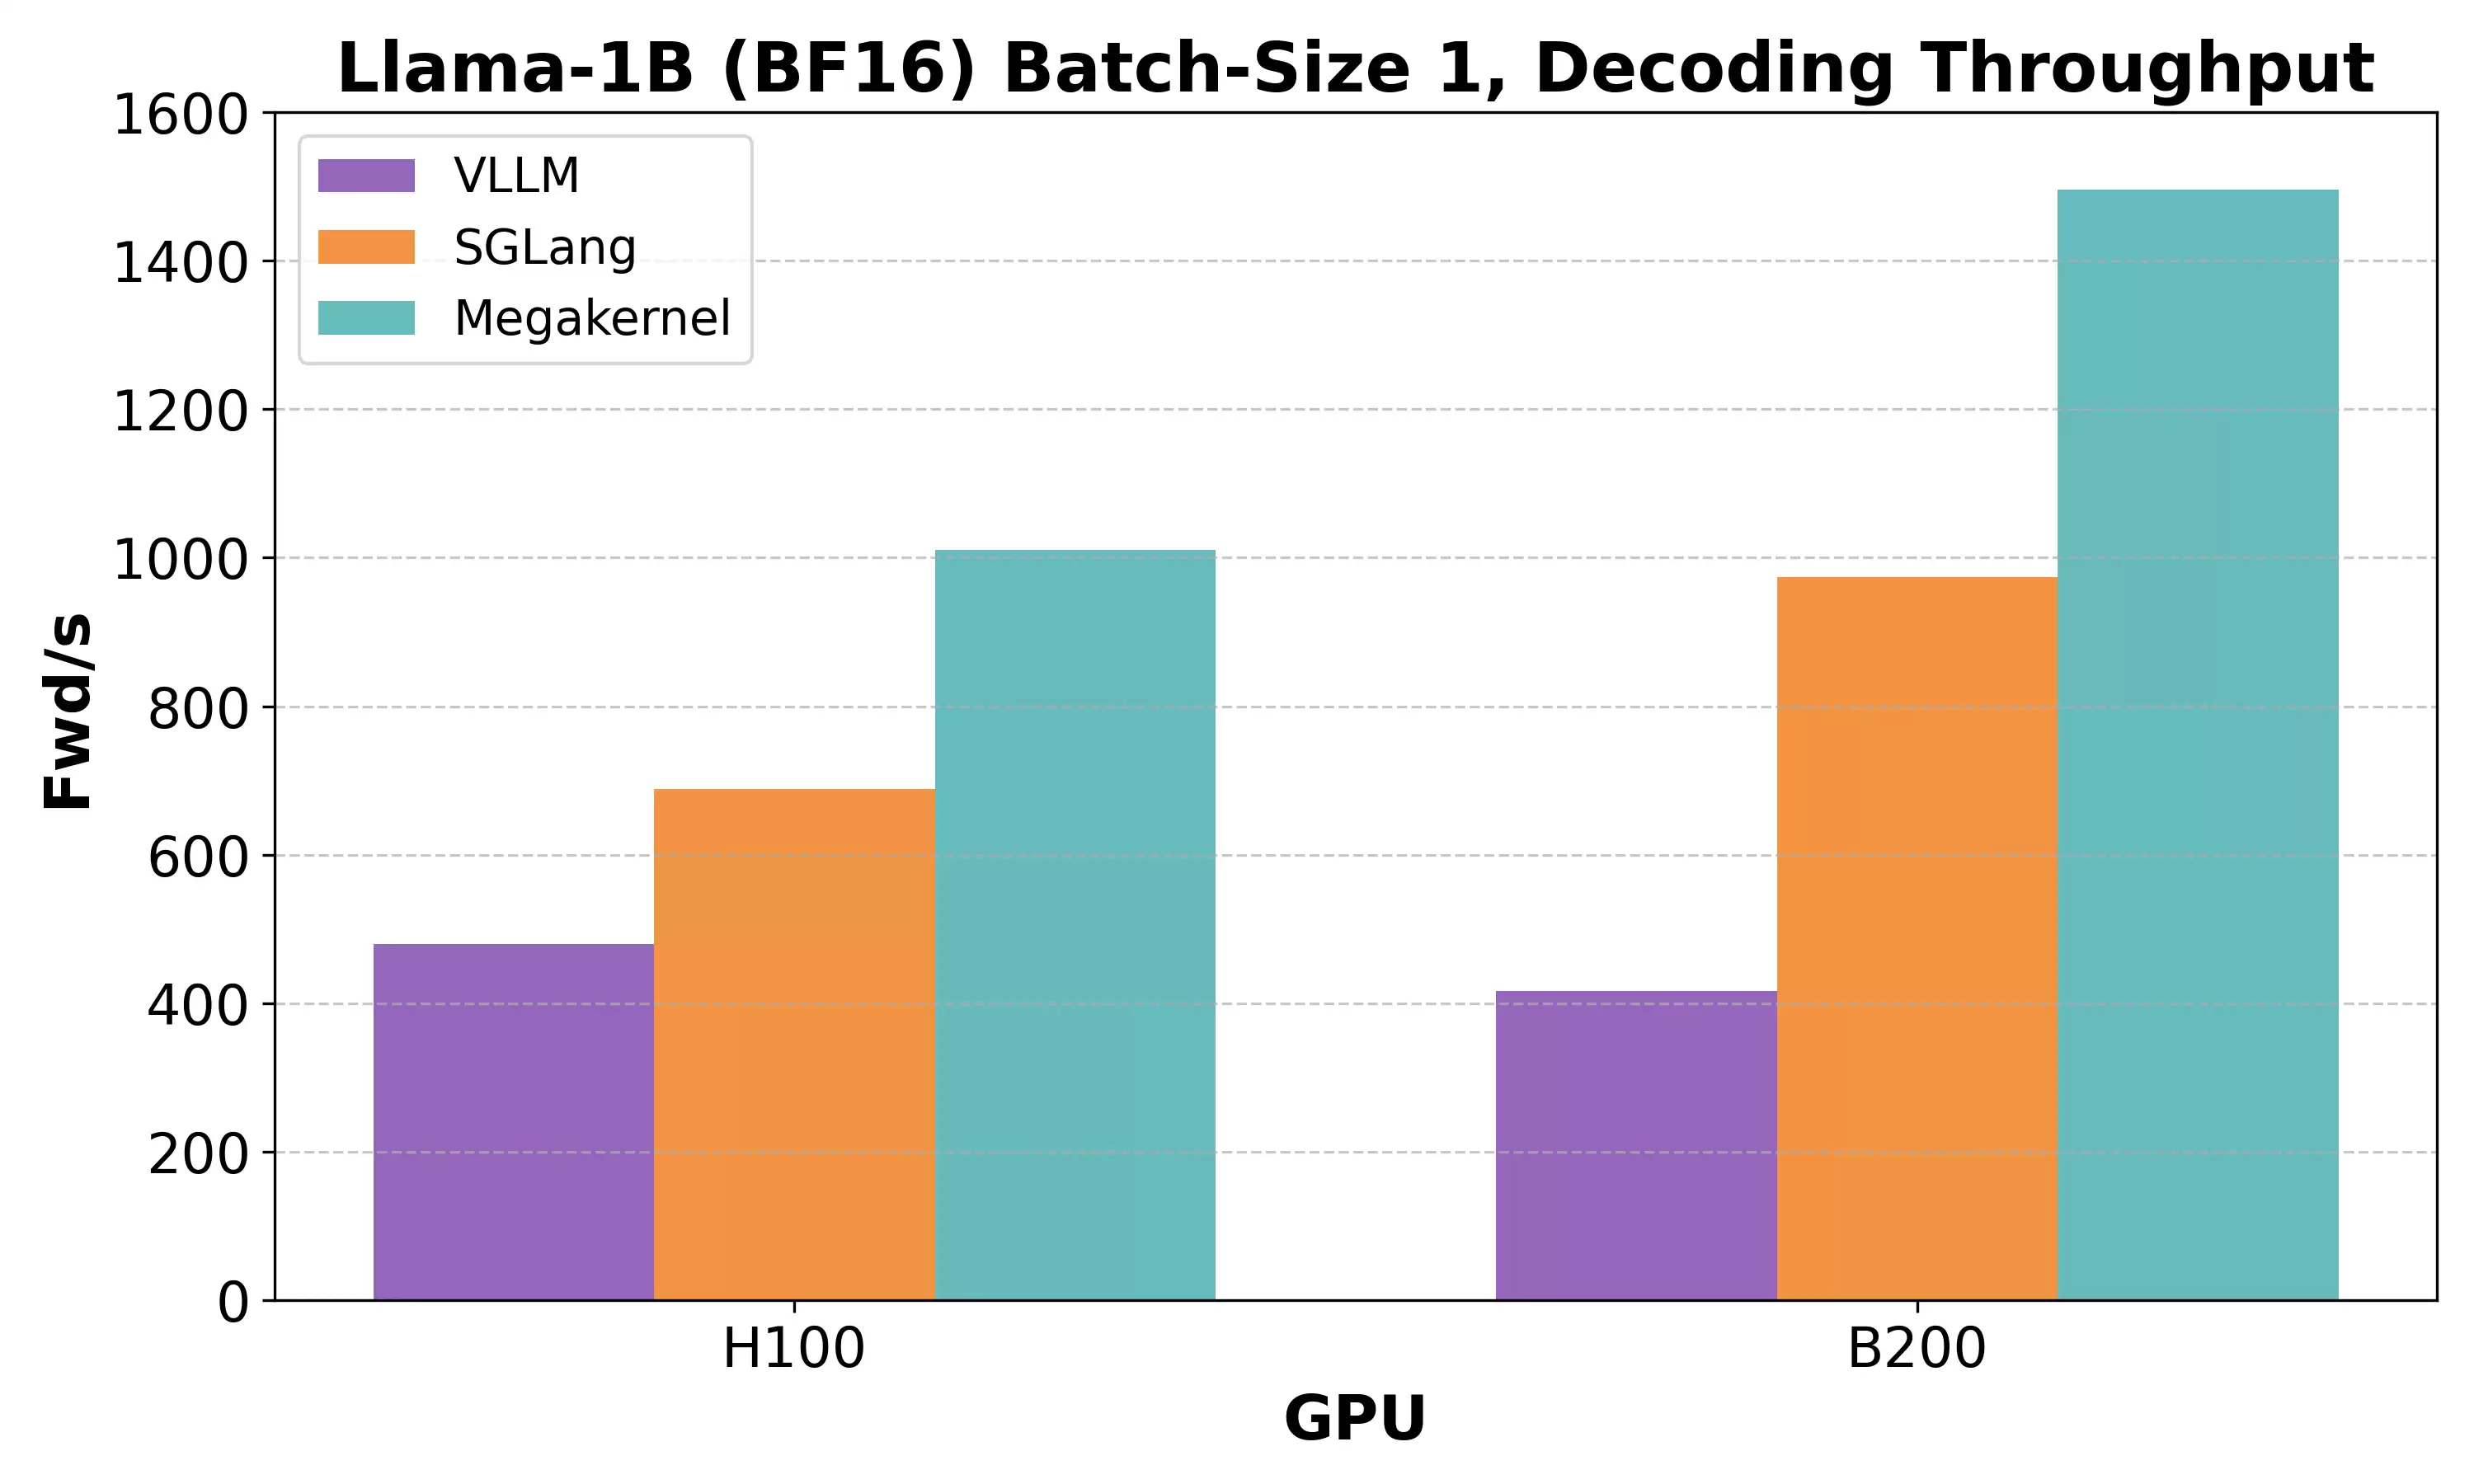
这项研究的出发点非常明确:团队发现,当前主流推理引擎在处理极低延迟的单序列生成任务时,效率并不理想。即使在H100这样的顶级GPU上,像vLLM、SGLang这类系统,其显存带宽利用率也常常低于50%。瓶颈并非计算本身,而在于“等待”。
传统方法通常将Transformer的每一层分解为几十甚至上百个细小的CUDA内核,分别处理RMSNorm、注意力计算、MLP等操作。这种“微内核”架构虽然模块清晰,却带来了大量的上下文切换和启动开销。尤其在生成单个token的短时任务中,这些内核需排队执行,后续计算无法提前加载数据,导致GPU的显存访问不连续,大量时间耗费在“空转”和“等待指令”上,而非实际运算。
Megakernel:从零设计的融合思路
那么,Hazy团队提出的方案效果如何?数据给出了有力证明。在H100上,他们的Megakernel将推理延迟压缩至不足1毫秒,显存带宽利用率提升至78%,相比vLLM提升了2.5倍,相比SGLang也提升了1.5倍。在更先进的B200平台上,延迟进一步降至600到680微秒,几乎触及硬件理论性能的天花板。
从一次完整推理的时间分解来看,计算本身(如矩阵向量乘法)仅占约200微秒,而数据加载与同步等“后勤”开销被控制在极低水平。可以说,通过精密的调度设计,Megakernel几乎榨干了硬件的每一分潜力。
实现这一效果的核心在于一个激进的设计:摒弃传统的多内核协作模式,将整个模型的前向传播过程,从头到尾整合进一个巨大的、单一的CUDA内核中。
具体是如何实现的?团队基于已有的ThunderMLA架构,开发了一个在GPU上运行的轻量级“指令解释器”。该系统会为每个流式多处理器预先分配一份“执行计划”,计划中按顺序排列着代表Transformer各结构单元的指令,例如融合了RMSNorm、QKV投影和RoPE的复合指令,或是处理注意力、MLP的专门指令。
每一条指令都基于统一模板构建,标准化了数据加载、计算和存储的流程。指令间的依赖关系在运行前由解释器静态安排妥当,避免了运行时动态判断的开销。为了进一步提升效率,团队还对GPU的共享内存进行了精细的分页管理,确保不同计算阶段能无缝衔接,下一阶段可尽早预加载权重,从而消除了计算流水线中的“气泡”(空闲期)。
当然,将所有计算整合进单一内核也带来了新挑战——传统的、隐式的内核间同步机制失效了。为此,团队引入了一套基于全局内存的计数器系统。每条指令完成后,会对相应计数器加一;若某条指令需等待前序步骤的结果,它会“监听”对应计数器,直至数值达标才会开始执行。这种显式的、细粒度的依赖控制,避免了粗粒度的全局屏障,使得计算能最大限度地并发进行。
研究过程中还有一些值得关注的发现。例如,即使在“已通过”状态下,CUDA的异步屏障操作本身也有约60纳秒的成本,这在追求纳秒级优化的场景下不可忽视。此外,在关键计算操作上,硬件架构差异的影响显著:在Hopper(H100)架构上,使用常规CUDA核心进行矩阵-向量乘法反而比使用张量核心更高效;而在更新的Blackwell架构上,张量核心则重新占据优势。这提示我们,极致的性能优化需要针对特定的硬件微架构进行量身定制。
传统推理方式效率低下的原因
在构建Megakernel之前,Hazy团队首先系统分析了现有方案为何在低延迟场景下“失灵”。结论指向一个系统性问题:过度分解。
像vLLM和SGLang这类系统,其设计初衷是为了灵活性与通用性,因此将模型前向过程拆分为大量细粒度的内核。这好比将一项复杂工作分派给几十名工人,每人只负责一道极简单的工序。然而,在只需生产一个“产品”(生成一个token)的情况下,频繁的工人交接、任务派发(即内核启动与销毁)所耗费的时间,反而超过了实际工作的时间。
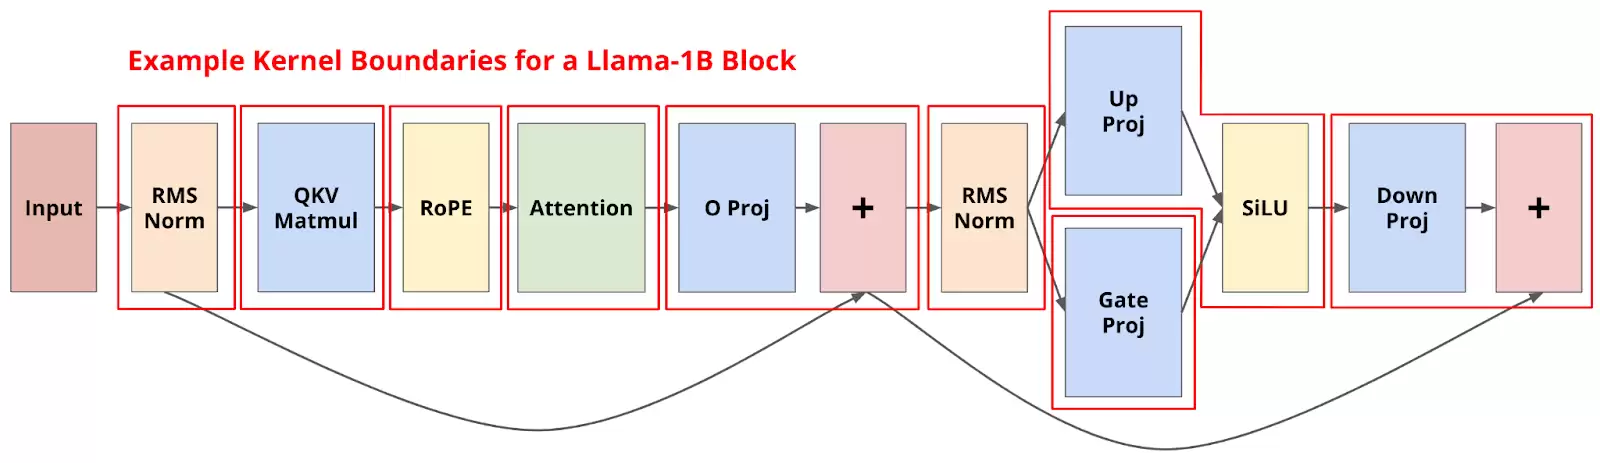
每个内核启动都有固定开销,即便利用CUDA Graph等技术优化,仍需1.3到2.1微秒。在此期间,GPU计算单元处于等待状态。更重要的是,这种串行执行模式导致数据加载无法流水线化。GPU计算完一个内核后,需等待下一个内核启动,才能加载新的权重和数据,这使得高带宽的显存长时间闲置,利用率自然低下。
这就形成了所谓的“内存流水线气泡”:计算单元和内存控制器都无法持续饱和工作,而是在忙碌与等待间反复切换。举例来说,从纯理论带宽计算,H100处理一次Llama-1B的前向传播可能极快,但由于需经历上百个内核的串行执行,每个内核带来的微小延迟累积起来,就会将实际性能拖慢数倍。
因此,问题的根源并非某个内核不够快,而是这种“微内核”架构本身在低延迟场景下带来了无法通过局部优化消除的系统性开销。Hazy团队的思路很清晰:要打破瓶颈,就必须彻底重构执行模型,减少甚至消除内核间的边界,让GPU能够连续、流畅地工作。这正是Megakernel设计哲学的核心——以全局的、融合的视角,取代局部的、割裂的优化。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
相关文章