

OpenPipe采用GRPO强化学习方法,在《时空谜题》推理任务上训练开源模型。结果显示,经过调优的Qwen模型性能显著提升,不仅缩小了与顶尖模型ClaudeSonnet3.7的差距,更实现了超过100倍的推理成本优化。这证明了强化学习能有效提升小型开源模型的复杂逻辑推理能力。
GRPO击败o1与o3-mini及R1于《时空谜题》
作者:技术拾光
时间:2026-08-12
浏览:219
文章目录
近日,海外大模型产品平台OpenPipe发布了一项引人注目的研究,详细阐述了其如何通过GRPO强化学习方法,在复杂的逻辑推理游戏《时空谜题》上,让开源模型的表现超越了DeepSeek R1、OpenAI o1、o3-mini等一众知名推理模型。这项研究由Ender Research的强化学习研究员Brad Hilton与OpenPipe创始人Kyle Corbitt共同完成。
研究结果显示,他们不仅将模型与当前顶尖的Claude Sonnet 3.7之间的性能差距缩小到了个位数百分比,更关键的是,实现了超过100倍的推理成本优化。报告还分享了从任务设计到超参数调整的宝贵经验,并公开了基于torchtune框架构建的完整训练方案。
背景介绍:推理模型的挑战与机遇
自OpenAI去年推出具有突破性的o系列推理模型以来,采用强化学习技术训练的大语言模型迎来了爆发式增长。从谷歌DeepMind、阿里巴巴、DeepSeek到Anthropic,各大厂商相继推出了支持长“思维链”推理的先进模型。通过在可验证问题上实施强化学习训练,传统基准测试的性能天花板正被不断逼近。
然而,尽管进展显著,逻辑演绎能力依然是顶尖模型共同的“阿喀琉斯之踵”。当前的大语言模型普遍存在几个核心缺陷:难以稳定追踪所有相关细节、无法保持逻辑严密的推演过程,以及多步衔接的可靠性不足。即便顶尖模型生成长度超出10-100倍的输出,其中仍频繁出现人类可以轻易识别的低级错误。
这引发了一个有趣的探索:小型开源模型能否借助前沿的强化学习技术,突破演绎推理的边界?研究团队正是从这个疑问出发,从性能相对较弱的模型开始,在一项全新的推理任务上进行迭代训练。随着时间推移,模型的推理能力呈现出明显的提升轨迹,最终甚至达到了超越某些先进专有模型的水平。
基准测试框架:时空谜题的设定与评估
要开展实验,首先必须确定一个具有明确可验证答案、且具备足够挑战性的推理任务。恰巧,研究团队中的一位作者之前创建了一个完全符合要求的谜题集——“时空谜题”。这个谜题集不仅满足事实真相清晰可验证的标准,还能根据需要灵活生成新的谜题。
“时空谜题”的灵感来源于经典桌游《Clue》(又名《Cluedo》)。在原游戏中,玩家们竞相推理是谁在Boddy先生的豪宅中谋杀了他。而“时空谜题”将其转变为一个单人逻辑谜题,在保留“凶手、凶器、地点”这三个经典要素的基础上,额外增加了“作案时间”和“作案动机”两个推理维度。谜题由算法随机生成,并利用OR-Tools的CP-SAT求解器进行线索挑选,确保了逻辑的严密性与多样性。
基准测试的任务,就是让模型扮演侦探,从一段充满线索的叙事中找出真相。为了明确这项推理任务的“天花板”在哪里,研究团队对多个当前火热的推理模型进行了基准测试,包括DeepSeek R1、OpenAI的o1和o3-mini,以及Anthropic的Claude Sonnet 3.7。同时,他们也测试了14B和32B参数的Qwen模型作为基线。测试结果预览如下:
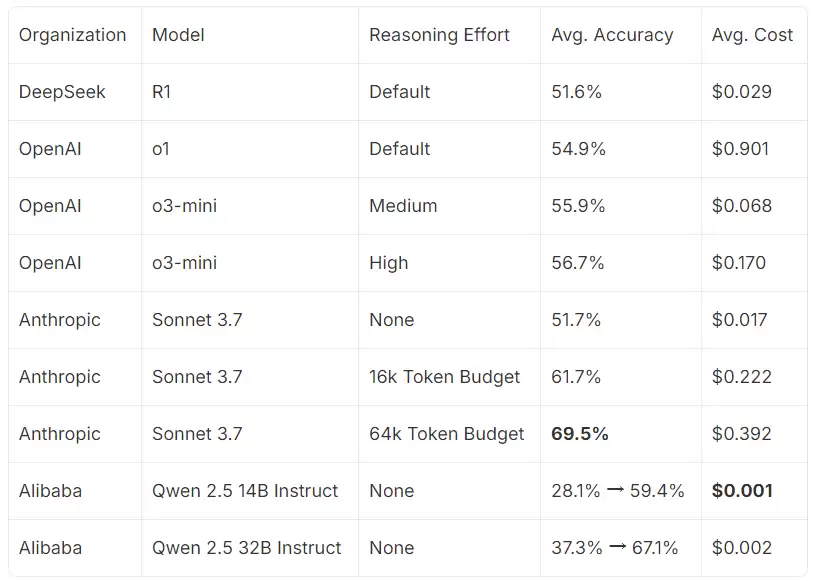
测试发现,在设定6.4万个token的上下文条件下,Claude Sonnet 3.7表现最佳。DeepSeek R1的表现则与OpenAI的o1和o3-mini不相上下。相比之下,未经调优的Qwen 2.5 Instruct模型则显得逊色不少。
于是,核心问题浮出水面:我们能否将这些较小型的、开放权重的模型,训练到前沿水平?答案是肯定的,关键在于方法。
训练方法与过程:GRPO强化学习的实施细节
为了训练出具备前沿水平的推理模型,研究团队采用了强化学习方法。其核心思路是:让大语言模型针对每个谜题生成多个回复,以此探索解题的各种可能性路径。对于得出正确答案的推理过程,给予正向强化;而对于将模型引入歧途的推理,则进行惩罚。
在众多强化学习算法中,团队选用了DeepSeek模型所采用的GRPO算法。与PPO等传统方法相比,GRPO不仅表现出了卓越的性能,还显著简化了训练流程。
从宏观来看,整个训练遵循以下几个基本步骤:
- 针对谜题任务,使用当前模型生成多个回复。
- 对这些回复进行评分,并为每组对话回复估算一个“优势值”,用以衡量该回复优于平均水平的程度。
- 利用这些优势值,通过结果引导的裁剪策略梯度对模型进行微调。
- 使用新的谜题和更新后的模型版本,重复上述步骤,直至模型性能达到最佳。
在生成回复环节,团队使用了流行的vLLM推理引擎,并对参数进行了精细调优。他们发现,向vLLM发送过多并发请求会导致正在处理的请求被抢占。为了解决这个问题,团队使用了一个经过调优的信号量来限制请求数量,从而在保持较高键值缓存利用率的同时,尽量减少上下文切换的开销。
采样完成后,使用HuggingFace Transformers的AutoTokenizer对回复进行处理。其聊天模板功能可以将消息对象渲染为提示字符串,并生成一个“助手掩码”,用于标识哪些标记是由大语言模型生成的。团队发现这些模型的默认模板中缺少必要的“生成”标签,因此在token化步骤中对模板进行了修改。最终得到的助手掩码被整合进用于调优的张量字典中,以明确哪些位置需要计算损失。
获得助手掩码后,便开始对数据进行“打包”以便高效调优。除了在每个打包序列中包含多个提示和回复外,团队还识别出共享的提示标记,为每个标记分配一个“父ID”,并附上标准的“组ID”。对于像“时空谜题”这样平均每个谜题超过1000个标记的任务,为每个任务生成多个回复并高效打包张量,能显著减少冗余。一旦所有必要信息打包完毕,训练数据集便能以二维形式直观呈现,每一行都是一个可能包含多个提示和回复的标记序列。
数据准备就绪,调优正式开始。模型本身已经完成了预训练和指令微调,具备了一定的基础智能。虽然它们还无法稳定地解决谜题,但偶尔也能成功。训练的目标,就是通过提高正确推理路径的概率,逐步引导模型向“神探”的水平迈进。在计算损失和调整权重时,采用的是策略梯度方法。
在训练基础设施方面,团队使用了PyTorch团队提供的Torchtune库。该库支持Llama、Gemma、Phi等热门模型架构。除了Qwen模型,团队也用80亿参数和700亿参数的Llama模型进行了实验。Torchtune还提供了一系列节省内存和提升性能的工具,包括:激活检查点、激活卸载、量化,以及参数高效微调技术(如LoRA)。此外,它支持多设备和多节点训练,可以结合全分片数据并行(FSDP)和张量并行(TP)。团队基于其提供的十多个训练配方进行修改,定制后的完整微调配方案支持多设备/单设备训练、参考模型加载与权重交换(用于计算KL散度)、使用组ID和父ID进行高级因果掩码计算,以及GRPO损失的集成与组件日志记录。
强化学习训练绕不开超参数的选择。在训练过程中,团队测试了多种配置,最终确定了以下核心参数组合:
- 模型: Qwen 2.5 Instruct 14B和32B版本。
- 每次迭代的任务数: 32个。
- 每个任务的样本数: 50个。
- 每次迭代总样本数: 32 × 50 = 1600个。
- 学习率: 6×10。
- 微批次大小: 对于14B模型为4个序列,对于32B模型为8个序列。
- 批次大小: 可变,取决于序列数量。
批次大小之所以可变,是因为训练过程中回复长度不一致。每次迭代的序列打包效率会有波动,并且优势值为零的回复会被直接丢弃。团队曾尝试将学习率与批次大小动态地成反比调整,但这导致在小批次时学习率过高。经过上限处理后的版本,与使用恒定学习率相比并未显示出明显优势。不过,调整批次大小和学习率之间的关系,仍然是未来值得探索的方向。
团队还进行了一个简短实验:在保持每次迭代总样本数大致相等的前提下,反向调整每次迭代的任务数和每个任务的样本数(即一个增加,另一个减少)。在较短的训练周期内,这些变化没有产生明显差异,这表明训练配方对于任务数量与单任务样本量之间的不同配比具有强鲁棒性。
实验结果与分析:性能提升与成本优化
经过超过100次的迭代训练,模型成功达到了前沿级别的推理水平。
模型能够在准确率下降之前实现快速改进。在最佳状态下,14B参数、1.6万token上下文长度的模型,其性能已经非常接近于Claude Sonnet 3.7。而32B参数、6.4万token的模型,更是几乎追平了Sonnet的结果。
在训练期间,性能提升遵循幂律规律,在图表上呈现出清晰的线性关系(直到性能开始恶化前)。
团队还注意到训练期间输出长度呈现出的有趣规律:最初,模型的回复会变长;随后趋于稳定;在训练接近尾声时出现分化——14B模型的回复变得更长,而32B模型的回复长度反而缩短了(尤其是在达到最佳性能之后)。
为了从定性角度评估逻辑推理能力的提升,研究团队进行了一项有趣的测试:让当前最先进的模型Claude Sonnet 3.7,去识别并评估Qwen 32B模型(训练前后)所做出的推论的合理性。结果发现,Sonnet从基础模型中识别出6个推论,其中只有一个被判定为正确。相反,从经过训练的模型中识别出7个推论,除了一个被判定为错误外,其余均被认定为逻辑合理。
最后,在假设按需部署且拥有足够吞吐量的前提下,团队根据Fireworks AI的无服务器定价层级估算了Qwen模型的推理成本。他们绘制了准确性与推理成本的关系图,发现在未经调优的模型中存在一条清晰的线性帕累托前沿线。而经过训练后,模型极大地改善了成本与准确性之间的权衡关系,实现了显著的性价比提升。
结论与展望:开源模型推理能力的新突破
这项研究探索了小型开源语言模型通过强化学习实现前沿水平演绎推理能力的可能性。在对“时空谜题”进行训练时,团队通过精心设计的超参数和GRPO方法,对Qwen 14B和32B模型进行了调优,显著提升了其性能。这些改进使得开源模型在推理性能方面达到了最前沿的水平,同时大幅度降低了推理成本。研究结果凸显了强化学习在高效训练开源模型处理复杂演绎任务方面的巨大潜力。
此外,研究还有一个令人惊喜的发现:仅需16个训练样本,就能实现高达10-15%的性能提升。这意味着,进行有效的推理能力训练,可能并不需要海量的数据。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
相关文章