

海螺语音由MiniMax推出,其T2A-01系列模型在合成速度与稳定性上显著提升,支持17种语言、上百种音色,能精准表达情绪并流畅处理多语种混合输入。在绕口令等测试中表现优于ChatTTS,与ElevenLabs相当或部分领先。该模型还具备分段情绪控制、丰富音色库及细节微调功能,已服务近万企业用户。
海螺语音媲美ElevenLabs 实测表现强劲
作者:技术拾光
时间:2026-08-12
浏览:402
文章目录
想象这样一个职场场景:你刚接手一个香港客户的订单,却在交付环节意外耽搁了。现在,你需要通过线上会议向客户解释原委。如果不对下面这段音频进行说明,大多数人可能会以为,这段粤语夹杂英语的对话片段,要么是真实录音,要么是从某部TVB剧集里截取出来的。
但实际上,这是一段由AI生成的配音,背后的工具是海螺AI的语音合成功能。
今年1月,继MiniMax开源其基础语言大模型MiniMax-Text-01和视觉多模态模型MiniMax-VL-01之后,这家公司再次升级了其语音大模型,推出了T2A-01系列,并将其集成在海螺AI平台,开辟了独立的“海螺语音”板块。与旧版本相比,T2A-01系列在语音生成速度与稳定性上均有提升。其合成语音不仅音质清晰稳定、韵律自然,还能精准表达多种情绪,并支持包括中文、粤语、英语在内的17种语言,提供上百种预置音色供用户选择。
从开头的示例不难听出,海螺语音能够准确理解并流畅处理不同语种的混合输入,同时以接近真人、富有语气的方式表达出来。这代表了其无需反复“抽卡”试错,即可达到的稳定输出水准。那么,这种“稳定高水平输出”究竟意味着什么?我们通过一个对比测试来感受一下。
测试选用了终极难度的绕口令《施氏食狮史》,它通篇由发音相近的字词组成,是检验语音模型在处理大量同音字时清晰度与理解力的绝佳试金石。
首先来听由ChatTTS生成的结果:整体上,字与字之间的区分度不高,产生了强烈的粘连感,听起来更像是“石狮石狮石狮……”的循环,几乎无法辨识具体内容。
再来听ElevenLabs的版本:或许是模型出现了“幻觉”,其生成的声音中带有明显的、类似“呱呱”的杂音,即便调整语速也难以消除。不过,相比ChatTTS,其质量已有显著提升,字词能够被区分开,并且语音中包含了语调和情绪。
最后是MiniMax海螺语音的输出:首先,整段声音听起来更为自然,既没有ChatTTS那种全程单调的问题,也避免了ElevenLabs版本中明显的“呱”声瑕疵。当然,它并非完美无缺,部分词语的断句仍有改进空间。但在超过80%的短句处理上,其表现已足够惊艳——音调的起伏、词语的错落、节奏的把握以及断句的意图都能被清晰感知。这背后反映的,正是语音模型对文本的深层理解能力。在一众以生产力为导向的AI聊天机器人中,海螺AI是少数能为用户提供独立语音模型板块,并允许自定义生成音频的产品。
海螺语音:媲美ElevenLabs的多语言合成能力
在国内,无论是大型科技公司还是创业团队,在语音模型领域常将ElevenLabs视为对标对象。ElevenLabs凭借其高质量的语音合成、多语言支持、个性化语音生成以及强大的API,已成为该领域的标杆产品之一。而在T2A-01模型的支持下,海螺AI生成的语音在相似度、错误率和听感等多项评测中,表现已能媲美甚至部分领先于同类产品,具备了与ElevenLabs“掰手腕”的实力。
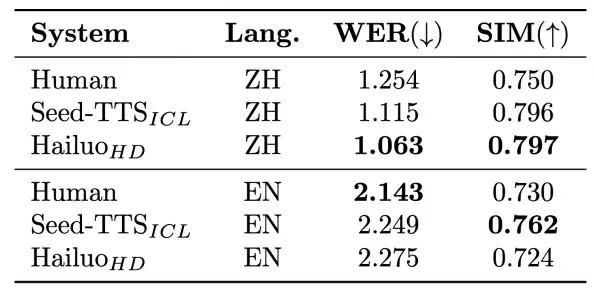
MiniMax团队采用了与Seed-TTS论文相同的评测集和工具,来计算海螺语音的字错率和声音相似度。结果显示,海螺语音在中文上的字错率和相似度表现最佳;而在英文上,其字错率和相似度已非常接近真实人声(Human)的水平。
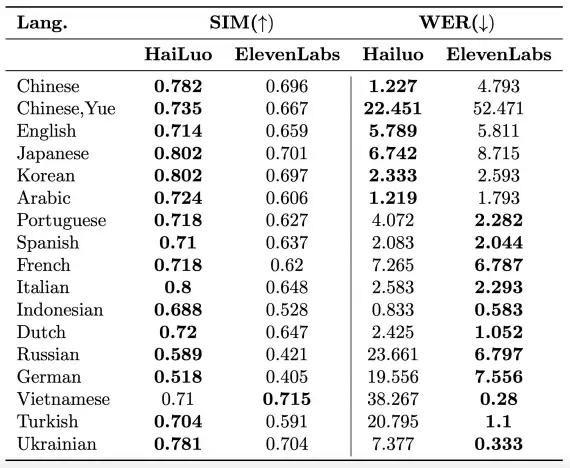
此外,团队还根据真实用户场景,建立了多语种评测集,对17种语言进行了客观评估。每种语言选取2-10个音色,生成超过50条音频进行测试。结果表明,海螺语音在声音相似度上整体占优,综合能力与ElevenLabs不相上下。尤其在中文、粤语、英语、日语、韩语和阿拉伯语等多个语种上,其在相似度和正确率方面的优势更为明显。
那么,T2A-01的实际多语种表现究竟如何?我们让它尝试用“嚣张小姐”的音色,带着开心的情绪,以正常语速,用九种语言说出杨幂的经典广告词:“你没事吧?”(包括中文、英语、日语、法语、德语、西班牙语、俄语、韩语、意大利语)。
不得不说,第一句中文出来时,还真有几分神似。后续的小语种发音清晰,也能从语流语调中感受到欢快的情绪。再看另一个示例视频,其配音采用德语,并在音效中选择了“空旷回声”,最终效果完全脱离了“AI味”,仿佛一位女政客在国会现场的慷慨陈词。
精准情绪控制与丰富音色库
对机器而言,准确表达情绪一直是个技术难点。语音模型的情感训练依赖于大量标注数据,但这些数据本身可能存在偏差——某些情感被过度强调,而另一些则被忽视,导致模型在处理被忽略的情感时不够准确。即便模型能够理解情感,其生成的情感表达也可能显得生硬或不自然,难以保持一致性,或模拟不出人类情感的细微变化。
为了让合成声音更加鲜活、情绪表达更加精准,MiniMax对超过千万小时的高质量音频数据进行了加工与训练,最终实现了高保真且情感丰富的声音效果。我们可以通过朗读古诗来初步感受:选取“惟觉时之枕席,失向来之烟霞。世间行乐亦如此,古来万事东流水”这段文本。由于粤语更接近古汉语,用其念诗往往更贴近古韵,对情感表达的要求也比白话文更高。因此,我们输入的提示词是这段诗的粤语版本。
市面上多数语音模型都能对此题进行稳定输出,但MiniMax的追求不止于此。最新发布的海螺语音具备情感理解能力,能够智能识别并重现语音中的细微情感差别。用户既可以让系统自动检测文本情绪,也可以明确指定“开心”、“难过”、“生气”、“害怕”、“厌恶”、“惊讶”或“中性”等情绪,从而生成能精准捕捉人类复杂情感的语音。
在日常对话或商业场景中,情绪往往是多变且富有层次的,这正是过去语音大模型难以攻克的痛点。海螺语音实现了突破,支持在同一段语音中进行分段情绪控制。例如,同样是表达一位老人“害怕”的情绪,若想进一步展现从“害怕”到“难过”再到“开心”的完整情绪变化,海螺AI给出了如下答案:
从老妇人发现怪老头冲自己喊叫时的紧张、惊慌、害怕,到认出对方竟是失散多年、落魄至此的堂哥时的声音低落与难过,再到重逢时刻音调明显上扬的开心,海螺AI不仅精准理解了输入的文字,其输出的声音也能做到层次分明,实现了精细的情绪控制。
除了精准的情绪控制,海螺语音的另一大优势在于其丰富的音色库。平台预置了超过300种涵盖不同语种的音色,用户可按语言、口音、性别和年龄进行筛选。音色风格多变,涵盖不羁、诙谐、慈祥等多种类型,适用于有声书、ASMR耳语、新闻播报等多样场景。
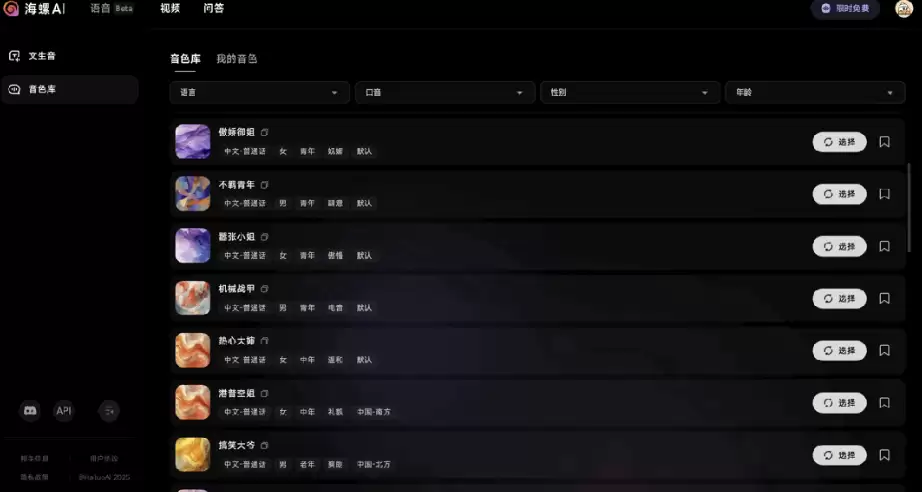
在平台给定音色的基础上,用户还可以根据个人偏好,对声音的“低沉/明亮”、“力量感/柔和”、“磁性/清脆”等细节进行微调,同时也能添加如“空旷回声”、“礼堂广播”、“电话失真”等场景化音效。
例如,选择“花甲奶奶”这一音色后,用户可以通过调试台对语速、声调和音量进行调节。
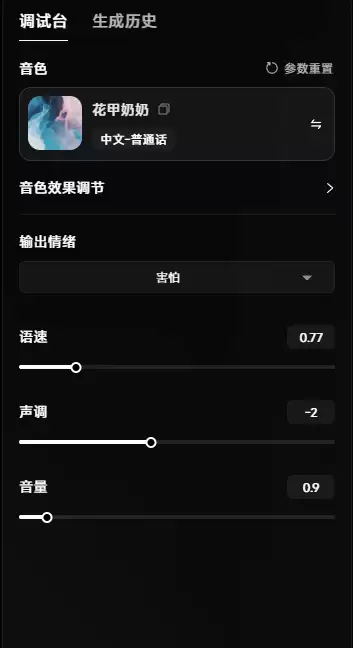
将花甲奶奶的语速和声调调低,情绪指定为“害怕”,就能获得一个非常适合讲述恐怖故事的、氛围感十足的说书人声音。
87版《红楼梦》中林黛玉的形象深入人心,这部文学经典在香港也有多个改编版本。如果为87版黛玉的经典台词“花谢花飞花满天,红消香断有谁怜”制作粤语配音,效果会如何?一起来感受一下由海螺语音完成的这个片段。可以切实体会到,海螺语音在情绪与音色控制方面的综合实力。将两者结合,几乎能随心所欲地生成想要的语音效果,这为影视作品引进、配音等潜在需求提供了强大支持。
MiniMax的多模态战略与AGI之路
在AI公司开发多模态能力的常规顺序中,音频处理往往很难排在文字、图片、视频之前,这给行业造成了一种“音频模型相对滞后”的印象。但事实上,语音大模型的开发难度与技术门槛都非常高。数据的稀缺性是制约模型能力的关键,从海量数据中剥离出纯净语音,再到对多语言、多口音、多情绪的语音进行标注,都需要高昂的成本。因此,在多模态公司的技术布局中,语音模型的开发通常需要在积累了一定的技术底蕴和资源后才逐步推进。
近半年来,国内多家大厂相继发布了语音模型。去年7月,阿里开源了语音大模型项目FunAudioLLM,包含SenseVoice(语音识别)和CosyVoice(语音生成)两个模型;今年1月,字节跳动上线了实时语音大模型,并基于此在全量豆包App中推出了实时语音通话功能。半年内,诸多大厂的跟进与取得的成果,正预示着语音大模型蕴藏着不小的发展潜力。
而在AI创业公司中,鲜有在语音能力上特别突出的,MiniMax是其中之一,甚至其对语音大模型的投入时间早于许多大厂。2023年11月,MiniMax就发布了初代语音大模型abab-speech系列,支持多角色音频生成、文本角色分类等功能。发布至今,其语音模型已服务阅文起点有声书、高途教育等近万家企业用户与个人开发者。
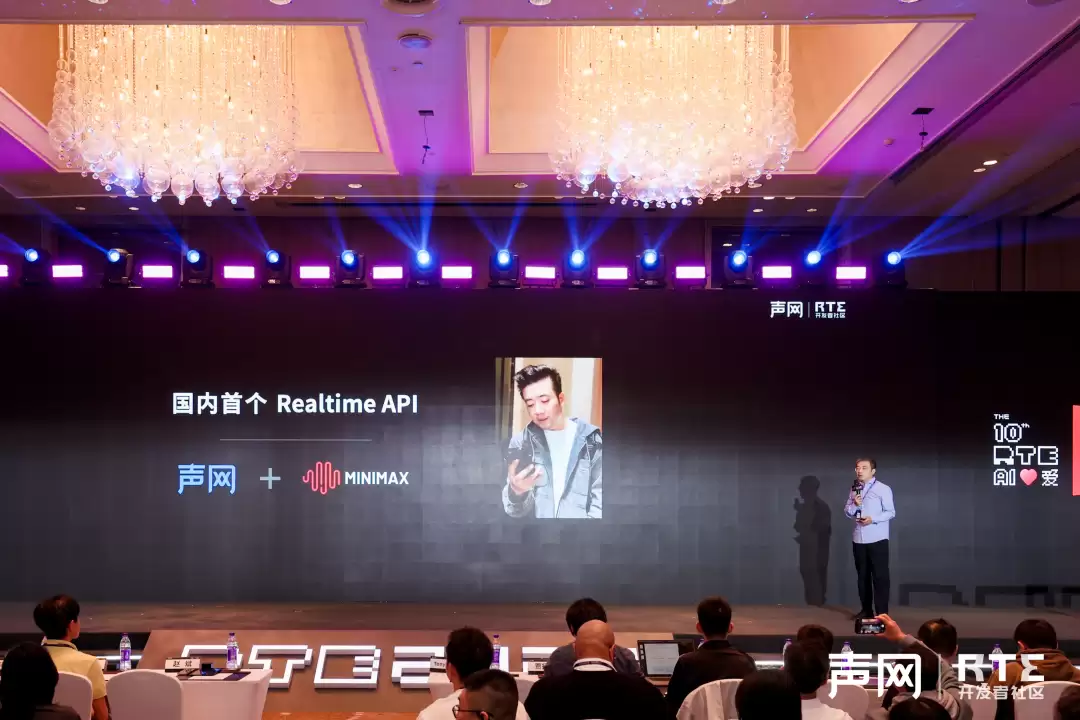
2024年10月,MiniMax的Realtime API在RTE 2024实时互联网大会上亮相,成为国内首个实时语音API。进入2025年,MiniMax依然保持着高昂的迭代节奏。在本次发布升级版语音模型之前,公司已接连发布了视频模型S2V-01,并在Github开源了新一代MiniMax-01模型,与DeepSeek等同行共同向传统的Transformer架构与高昂训练成本发起挑战。MiniMax创始人曾表示:“我们认为这有可能启发更多长上下文的研究和应用,从而更快促进AI Agent时代的到来。开源一方面可以倒逼我们提高算法创新效率,另一方面也能打造全球技术品牌。”
从文本、视频到语音能力的全面更新,可以说,MiniMax和海螺AI确实能带来惊喜——这也是其对多模态模型长期投入、持续发力的必然结果。其战略核心始终是面向通用人工智能(AGI)进行投入,而打造强大的多模态能力,正是现阶段最明晰的实现路径。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
相关文章