

马尔奖得主团队提出GenEx模型,赋予AI“想象力”。该模型包含动态生成三维环境的“想象世界”和与之互动的“具身智能体”,构成共生系统。仅凭单张图像,系统即可生成连贯三维环境,支持智能体自由探索与目标导航,并通过预测完善认知。研究还扩展至多智能体协作场景,致力于构建可交互的世界模型以。
陈杰能:世界与心智模型赋予具身智能想象力
作者:技术拾光
时间:2026-08-12
浏览:146
文章目录
近日,一项来自马尔奖得主、约翰霍普金斯大学Alan Yuille教授团队的研究,在具身智能领域引发了广泛关注。这项名为GenEx的工作,其核心在于赋予AI一种“想象力”——让智能体能够在一个由自己“想象”生成的世界中进行探索与学习。
受人类心智模型的启发,GenEx试图模拟大脑对世界的认知机制,旨在构建更智能、更灵活的人工智能系统。它包含两个关键组件:一个能动态生成三维环境的“想象世界”,以及一个能与该环境互动、以完善自身决策能力的“具身智能体”。二者构成共生系统,使AI能以近似人类认知的方式进行模拟与学习。
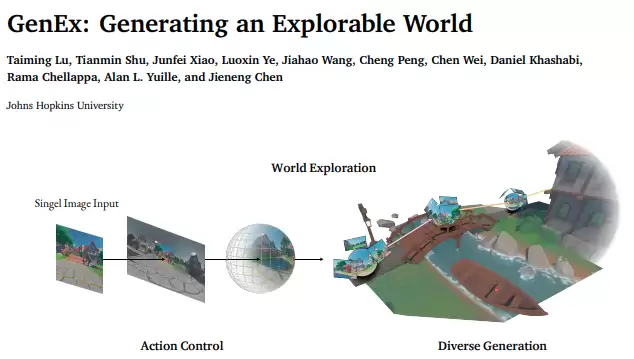
GenEx仅凭单张RGB图像,即可生成完整且三维连贯的虚拟环境,甚至能呈现为360度全景视频。在此生成式想象力的驱动下,智能体可执行复杂的具身任务,包括自由探索与目标导航。它们利用对未观测部分的预测来完善认知,通过潜在决策模拟不同结果,从而做出更优选择。此外,GenEx还支持多智能体场景:当一个智能体导航至其他智能体位置时,可依据后者“想象”出的认知来更新自身认知。
这项工作的核心作者是约翰霍普金斯大学即将毕业的中国博士生陈杰能。
在转向世界模型与空间智能研究前,陈杰能专注于医学图像分析。他本科毕业于同济大学计算机系,2020年赴约翰霍普金斯大学攻读博士学位,师从Alan Yuille。此前,他发表了首个融合Transformer与U-Net的网络模型TransUNet,引用量已超5000次。
自今年起,他的研究重心转向世界模型与空间智能,主要研究内容包括基于单张图像生成可交互的3D世界,并将其构建为具身智能体的“心智模型”,以助力智能体决策。从医疗图像到具身智能,陈杰能认为自己已较好地完成了上一阶段的使命,“接下来希望研究新的黄金问题,参与到前期探索中。”
当癌症筛查遇上AI
问:您读博前发布的TransUNet引用量已超5000,当时是如何构思这一创意的?
陈杰能:当时我正在做另一个项目,目标是建模物体边缘的语义,由此产生了序列建模的想法。Transformer虽擅长全局学习,却难以捕捉局部细节。2020年底,Transformer在分类任务中已证明有效,但能否胜任密集预测任务仍在探索中。为解决此问题,我想到结合Transformer和UNet的优势。实际效果表明,UNet擅长处理局部信息,Transformer擅长全局和上下文信息,二者组合能兼顾局部细节还原与长距离建模,从而支持多种任务。
后来,我将TransUNet扩展到3D层面,并进一步应用于多癌筛查。至今,TransUNet仍是一个经典架构,广泛应用于分割模型和扩散模型等任务中。
问:您是如何接触计算机视觉,并决定深耕医学影像领域的?
陈杰能:2017年下半年我在慕尼黑工业大学交换,3D视觉学者Daniel Cremers是授课老师之一,巧合的是,他也是我现在的导师Alan Yuille曾指导过的博士后。当时的计算机视觉课程内容偏几何和理论,我被前沿科研所吸引,回国后便决定参与视觉研究,在同济大学陈广老师的课题组研究车辆检测。
2019年暑期研究,我机缘巧合联系到Alan Yuille。他与约翰霍普金斯医院合作癌症早筛项目,项目中有像抑癌因子P53发现者这样的知名医生参与。他们虽非AI研究者,但也意识到了AI在医疗领域的潜力。这个领域既有规模化应用的机会,又能切实帮助普通人,这吸引我深入钻研医学影像。
问:所以您后来又加入了达摩院医疗AI团队实习。可以分享一下做CancerUniT的故事吗?
陈杰能:负责人吕乐是我在约翰霍普金斯计算机系的学长,他的导师Gregory D. Hager和我的导师本身就有合作,我们认识得比较早。
当时在医疗AI领域,大多数研究聚焦于单一病种,达摩院希望我能加入去做多癌筛查。具体来说,我们希望开发一个AI模型,能通过单次CT扫描筛查出八种癌症并诊断14种亚型。这八种癌症是国内发病率和致死率最高的,覆盖了接近80%的癌症患者。
医疗AI涉及众多方向,其中疾病筛查无疑是优先级最高的,尤其是针对癌症、阿尔茨海默症和慢性病等主要疾病。癌症因其高发病率和高死亡率,在我精力有限的情况下,被认定为一个更值得优先攻关的“黄金问题”。解决这个问题就像是攀登一座更高的山峰,如果能早一些解决,就能帮助到更多的人、使许多家庭受益。我很有热情,希望能贡献微薄之力加速这个进程。在推进工作的过程中,我和合作者一起明确了问题的定义,也搭建了一个高敏感性、高特异性的基础模型。现在,达摩院正在进一步扩展我当时开发的多癌模型,我期待这系列模型能尽早在社会中发挥实际作用。
从视觉基础模型到空间智能
问:后来您来到字节Seed团队做视觉基础模型,为什么会选择这个机会?
陈杰能:我的mentor Liang-Chieh Chen在谷歌时就曾邀请我去实习,不过我当时去了达摩院,就答应下一年再加入。后来字节成立了核心团队Seed,他加入并带领基础研究组,我也跟着来到了字节。
2023年业内研究的一大重点是多模态大模型。Liang-Chieh Chen在深度学习架构设计方面造诣很深且经验丰富,特别是在MobileNetv2和DeepLab上的贡献。我希望对大模型的视觉编码器进行一次彻底的设计,探索新的可能性、进一步打磨自己的技术能力,就此加入了。
问:第一次主导视觉编码器架构的设计,成功发表了ViTamin,感受如何?
陈杰能:其实在做ViTamin的过程中和完成后的感受都很深刻。
我负责基础架构设计,需要对多模态大模型里的视觉编码器架构进行规划并探索其扩展规律。由于耗费算力较大,通常只有一次训练模型的机会,所以设计时必须既谨慎又创新。
我们的视觉编码器在ImageNet零样本准确率上达到了83%的SOTA水平,也能有效地迁移到大模型中,我们探索出了一条合理的扩展路径。将模型性能优化至世界最佳的过程,充满挑战也极具成就感。
如果将多模态模型比作一个智能体,那么视觉编码器就是智能体的“眼睛”。随着今年年初业界研究者们普遍认识到大模型中视觉编码器的重要性,并开始进行针对性设计,我再次感受到这项工作的重要性。
此外,ViTamin最高分的模型参数量仅有4.36亿,不足0.5B,在追求大模型、大规模参数量的2023年算是非常小的。而在我们所能获取的最佳数据条件下,这个规模已经达到了扩展规律的极限。有趣的是,从今年开始,小模型也变得非常热门,现在多模态模型为了终端优化,也只会采用几百兆量级的视觉编码器。不难看出,扩展规律最终会逐步收敛到一个最佳设置。
问:为什么今年会从医学影像转向空间智能?空间智能的核心是什么?
陈杰能:我相信在工业界和医院的联合推动下,癌症筛查这一关键问题将在未来几年得以解决,而我以前的工作有助于其规模化推广,算是完成了自己的使命。如今我想探索新领域,而空间智能、具身智能等定义尚新,能参与前期探索颇具意义。
导师Alan在1990年就有研究三维物体的表面曲率,近年来实验室也一直关注3D视觉,我常受此熏陶而产生兴趣。我今年开始着手解决一两个“黄金问题”,希望能一起推进空间智能与具身智能。
今年空间智能备受关注,它涉及图片3D建模或视频4D建模,本质上是逆向图形学——从单张图重建三维结构并提取物体类别、位置和几何等信息。
举个例子,在虚拟游戏引擎或物理引擎中,通常会通过预设的场景配置文件给定3D模型,并渲染为2D图像,这是一个从场景到图像的正向渲染过程;而计算机视觉则是这一过程的逆向推理,即从2D图像中重建或推演出三维场景。如果能彻底解决这一挑战,计算机视觉可能会有较大的突破,比如提升GPT的空间推理能力,以及改善视频生成是否遵循视觉场景物理性的问题。因此,从图片中推演3D场景,是空间智能的一个核心。
我目前的工作聚焦于空间推演。不久前发布的Gemini 2也特别强调了空间推演能力,然而,我们最近开发的空间推理基准3DSRBench的结果显示,其准确率仅为50%,远低于人类的95%。结果发布后,DeepMind的相关人员也提供了代码库,共同推动大模型在空间推理上的进展。这表明在空间智能领域,尤其是空间推理方面,机器与人类的能力还存在较大差距。
问:那空间智能与医疗图像之间有何关联与差异呢?
陈杰能:空间智能与医疗图像都涉及图像处理及复杂场景建模。医疗图像的三维理解与空间智能的三维理解目标相近,都要将像素数据转化为对三维结构和语义关系的预测,并提取关键信息如物体位置和形态。在医疗影像中,这具体表现为对器官和病灶的位置、形态及其空间关系的精准解析。
二者也有不同:从数据上看,医疗图像是规则的三维数据,通常处于有限范围内(例如人体高度有限、器官形态相对规则),数据复杂度较低;而空间智能的数据更加复杂,包含大量不规则、有形变和带有关节活动的物体,数据复杂度明显更高。从优化目标上看,空间智能和具身智能强调实时性与泛化性,期望模型在不同环境中泛化良好,达到类似小孩的智商与感知力;医疗人工智能则强调专家性,旨在专项任务上达到医生专家水平,所以二者的优化目标迥异。
心智模型与具身智能的融合
问:您是从什么时候开始聚焦世界模型的?
陈杰能:我对世界模型的研究,是与空间智能和具身智能同期进行的。空间推理是具身智能体感知物理世界的起点,但仅依靠空间感知无法全面支持智能体对物理世界的交互理解。构建一个可预测、可交互的世界模型,将更好地帮助智能体在真实世界中进行有效决策。
虽然世界模型的定义本身仍百家争鸣,但在二三十年前就已应用于控制论了。它的一个本质定义是:给定当前的状态分布和动作输入,能否预测出未来下一个状态的分布。这在早年的控制论等领域中有一些实践,但早年对“状态”的定义较为简单。
我认为世界模型的本质是提供对世界变化的预测性分布,但“世界变化”不应是最初的低维状态,而可以是一个四维世界的状态,包括对目标物体的语义信息、纹理信息、三维几何结构、形态、形变、运动特性,以及物体之间空间关系的建模。
我关注的一个难点是,能否从图像观测中提取上述的三维空间表征,作为世界模型的状态。此外,我也关注世界模型在具身智能中的应用。
问:您不久前发布了“生成式世界探索者”,从单张图生成可交互3D世界,可以聊聊这个创意是怎么诞生的吗?
陈杰能:人类在现实生活中探索看不到的地方时,能够通过发挥想象力在大脑里构建出一个世界,然后在其中进行想象性的探索。这种能力使得我们无需物理移动就能探索到世界未知的地方,还能帮助更好地做出决策——让AI智能体具备此能力,就是我的初衷。
从实践的角度来看,基于当下看到的事物(无论是单张图还是单个观察),首先要从单张图中生成一个可交互的3D世界,下一步才能在这个3D世界中探索。
问:那具身智能的心智模型和世界模型又有何关联呢?
陈杰能:心智模型最早在心理学和认知科学领域被提出,是指存在于我们脑中的一种认知框架,用于表示对世界的理解。它相当于一种内部的现实模拟,帮助人类解读信息、做出决策,并根据以往的经验和知识预测结果。当然,世界模型也是根据过往的经验和知识,去对未来的状态分布做出预测。因此这两个模型的本质是相关联的。
心智模型的表征最早主要是关于语言和语义学特征,如今生成技术的发展使视觉表征成为可能。我的工作实际上是将心智模型提升到了一个表征上的新高度,即构造出具备空间想象力的心智模型,能想象三维世界中看不到的地方,比如只看到轮子能想象到一辆救护车,亦或者通过动作交互,探索到更远的、看不到的场景。
具身智能体基于此核心能力,无论走到哪里,都能通过对周围环境的观察来构造出一个可探索的三维世界,即生成式的三维世界。在这个生成的世界里,智能体通过探索发现未曾见过的观测,并将这些想象出来的观测加入到决策过程中——因此称之为“生成式世界探索者”。
将生成世界的观测融入决策的过程,可以看做是通过世界模型开发的一种全新策略。应用于具身智能时,其实是用在生成式世界中收集到的观测,来补充物理世界中的缺失观测,形成更完整的观测集,从而构建一个“想象力增强”的策略。
问:心智模型属于对常识的理解吗,比如知道横着拿纸杯水会洒出来?
陈杰能:心智模型作为一种认知框架,包含基于常识的理解。然而,“知道横着拿纸杯水会洒出来”,这仍然基于对纸杯和纸杯里水的完全观测。心智模型可以解决更有挑战性的部分观测和缺失观测的场景。它是通过已有的环境信息,去推演和想象那些未观测到的环境部分,比如一阵大风是缺失观测的,但人类的心智模型或许能推演出风吹后纸杯会倒下。
模拟这些未观测到的环境因素,有助于做出更精确的决策,从而提高决策模型的泛化能力。这一方向在未来会获得更多的关注。
问:这个方向在具身智能领域并不热门。
陈杰能:是的,领域内很多研究者聚焦于提升低层次策略的鲁棒性,而我目前的研究更侧重于高层次问题,旨在为具身智能体构建可交互的三维世界模型,以辅助其决策过程。
在高层次领域,除了心智模型,具身智能体对物理世界的空间理解仍有挑战。如果把上游的空间理解处理好,再加上三维心智模型,低层次问题会解决得更轻松,能让智能体走入真实世界,而非仅限于机械臂的环境里。当然,这两者最终可以结合起来形成多层次模型。
最后,我们开发的生成式世界探索者,不仅是具身智能体的重要组成部分,也已经初步证明能够辅助人类的认知决策。我希望在这个多学科交叉的领域贡献一点力量。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
相关文章