

腾讯混元大模型上线视频生成功能,用户可通过文字直接生成视频。该模型参数量达130亿并已开源,评测显示其在文本一致性、运动流畅度和画面质量上表现突出,能处理复杂场景与多视角切换。技术基于扩散Transformer架构并优化了文本编码与注意力机制,降低了应用门槛,加速行业创新。
腾讯混元大模型开源 全家桶再添新成员
作者:技术拾光
时间:2026-08-12
浏览:525
文章目录
就在刚刚,国内AI领域迎来一个重磅消息:腾讯混元大模型正式上线了视频生成能力。这标志着它在文生文、文生图、3D生成之后,又拿下了一个关键的技术高地。更引人注目的是,腾讯同步开源了这个参数量高达130亿的视频生成模型,这无疑是当前开源社区中规模最大的视频模型之一。
简单来说,用户只需输入一段文字描述,无论是中文还是英文,就能直接生成一段视频。目前,这项功能已经集成到腾讯元宝APP的“AI视频”板块,面向用户开放试用申请。而对于企业客户,相应的API接口也已通过腾讯云同步开启内测。
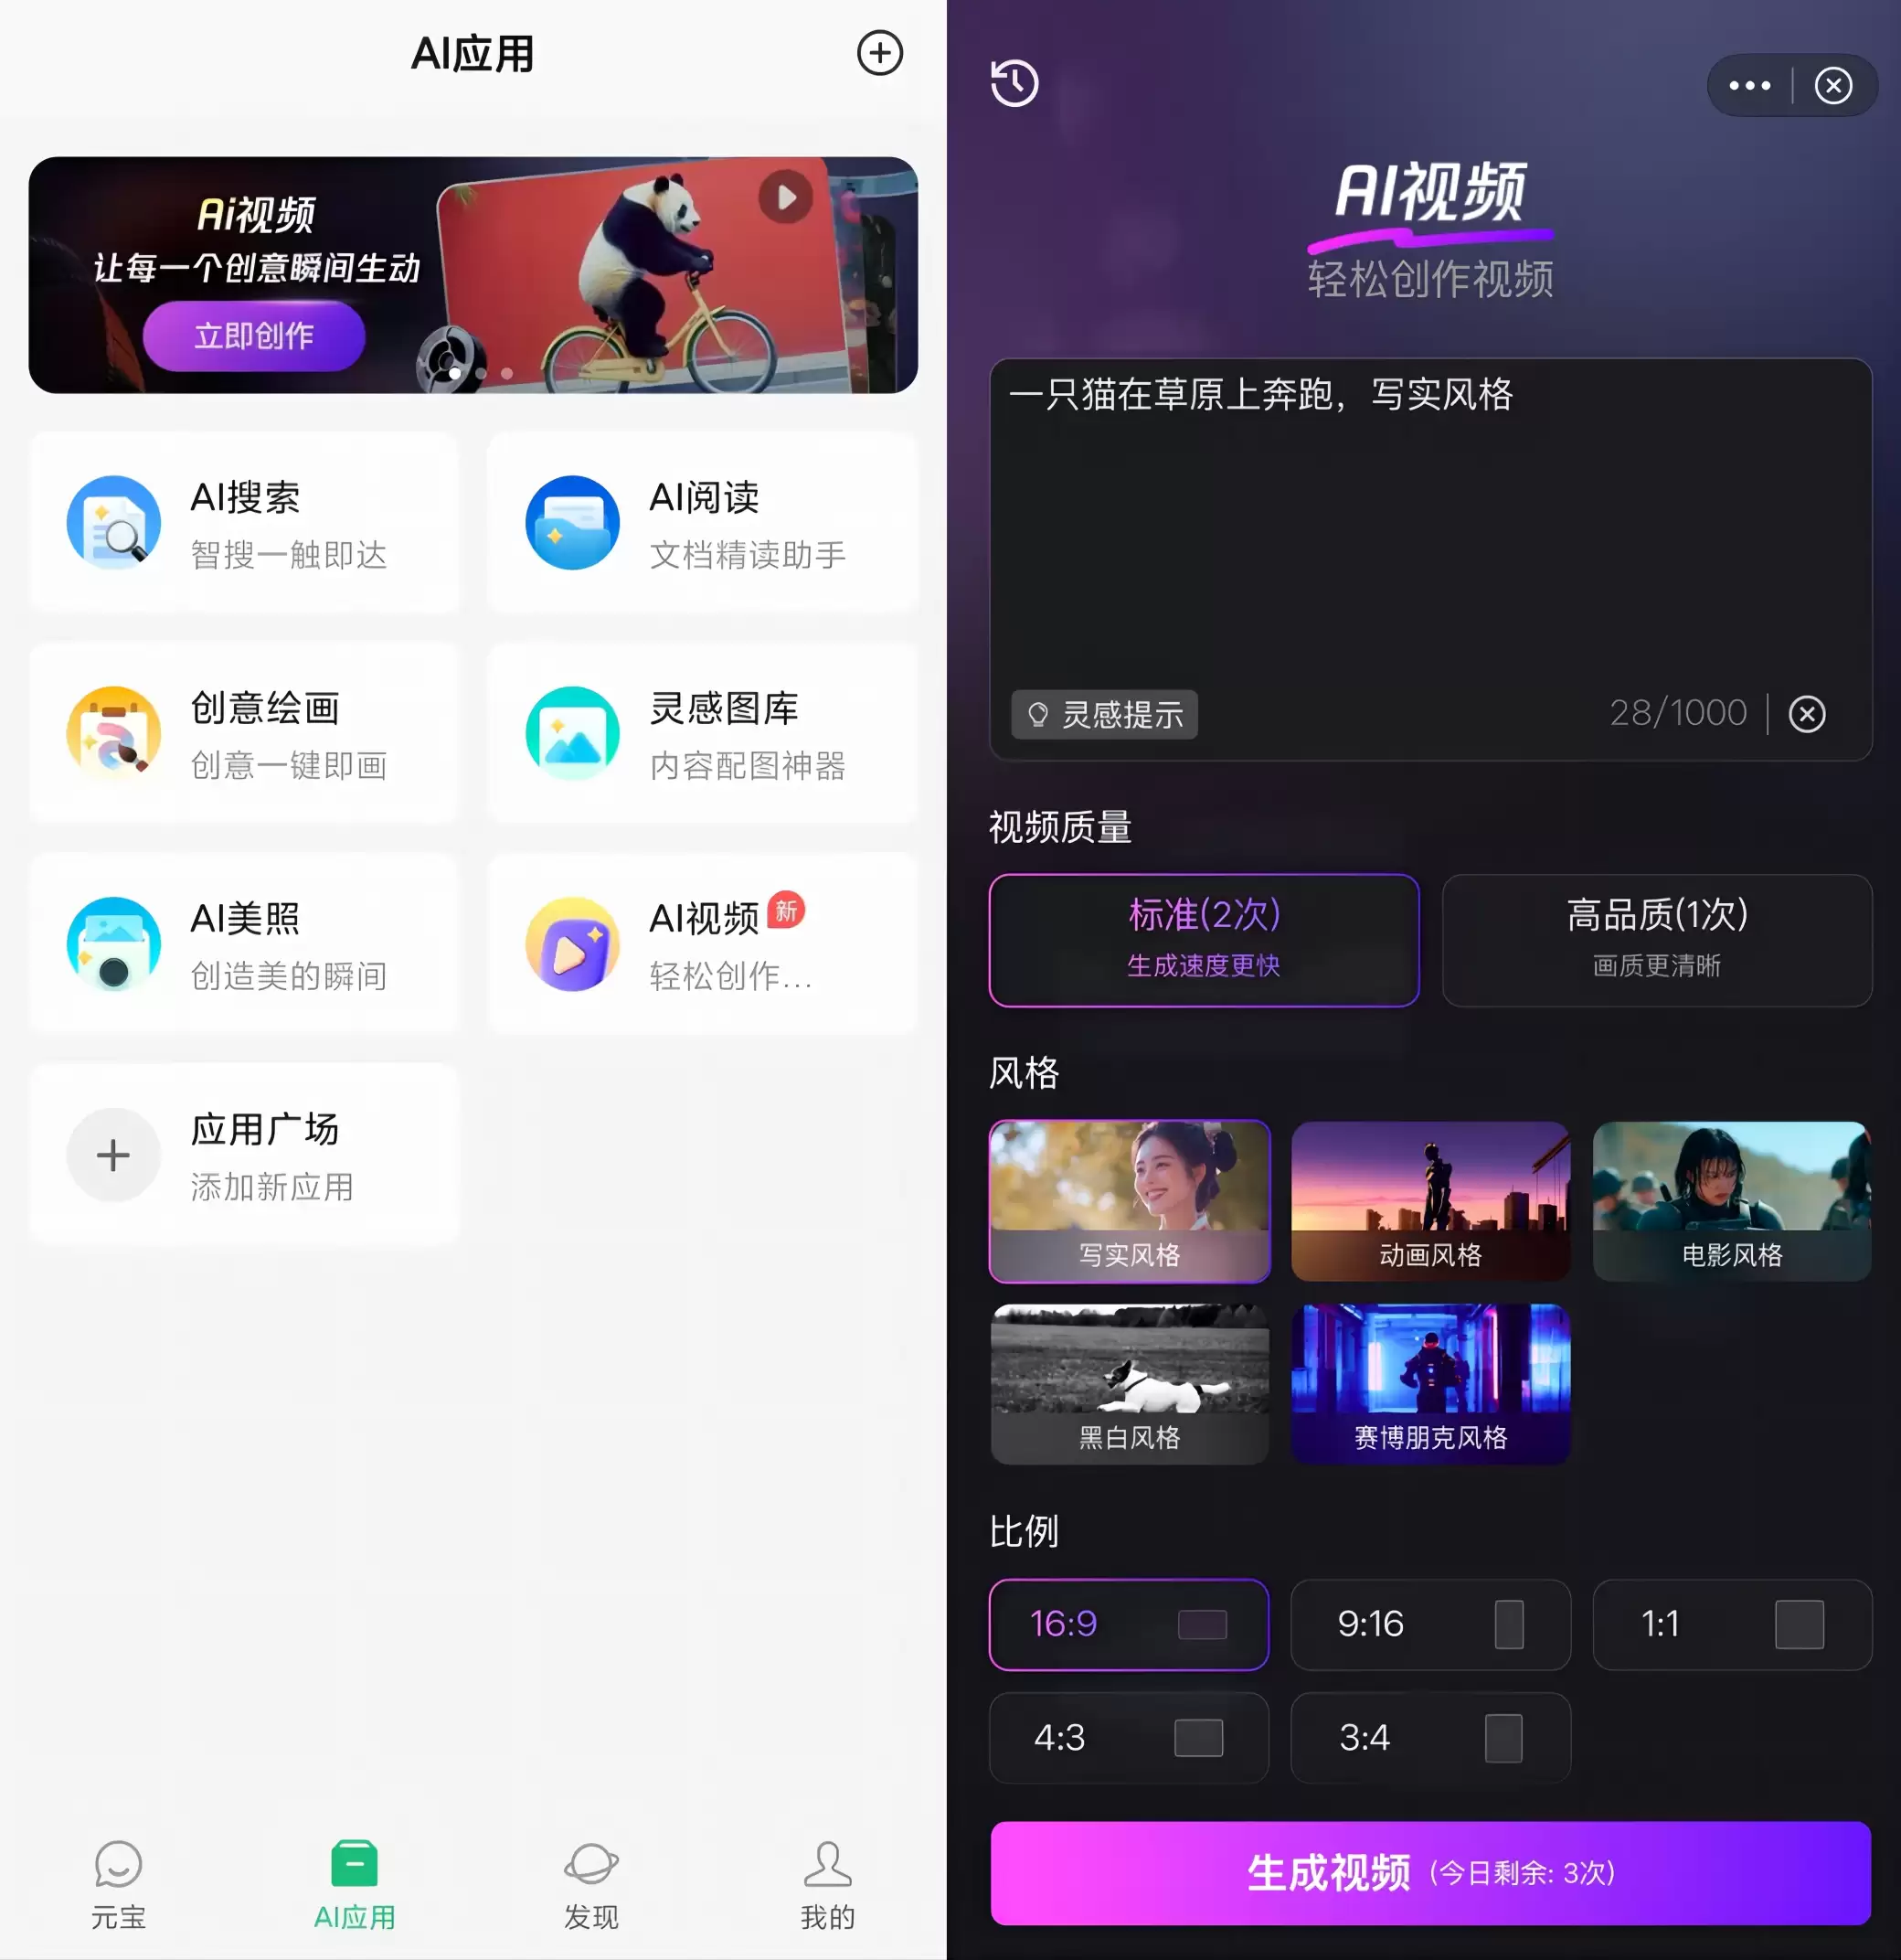
通过腾讯元宝APP-AI应用-AI视频即可使用该功能(前期需申请)
腾讯混元视频生成效果评测:多项指标领先
根据官方披露的评测结果,混元视频生成模型在文本与视频的一致性、运动流畅度以及画面质量等多个核心维度上,表现都相当亮眼,尤其在处理人物、建筑等复杂场景时优势明显。
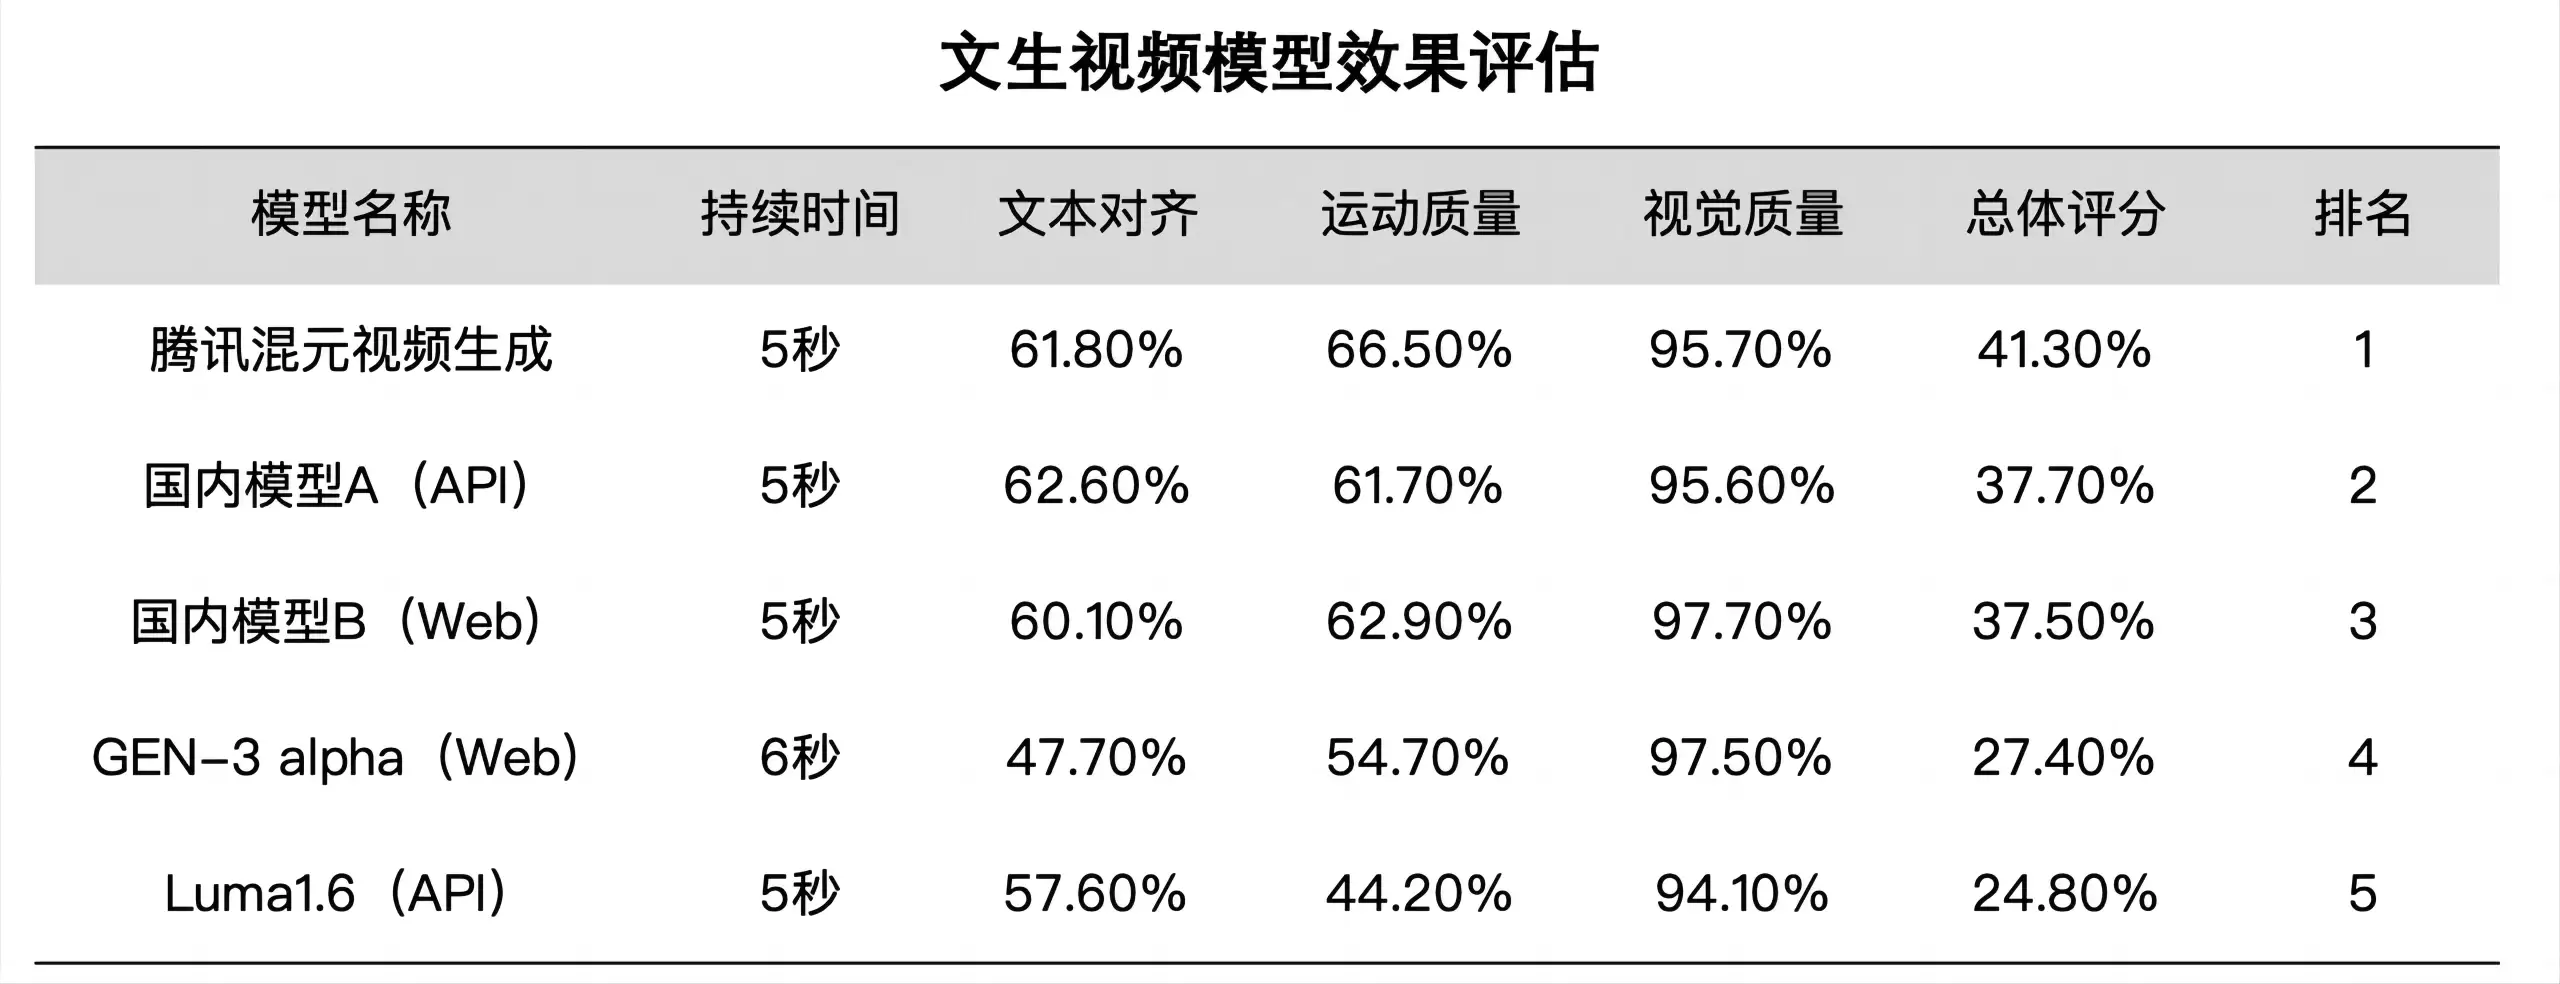
从实际生成的样片来看,画面的逼真度和对提示词的遵循程度都达到了很高水准。模型能有效控制物体形变,确保动作流畅,甚至面对emoji表情这种抽象提示,也能稳定输出合理的视频内容。
具体到一些挑战性场景:比如冲浪、舞蹈这类包含大幅度动作的画面,它能生成连贯合理的镜头;在处理镜面反射时,也能基本遵循物理规律,保持镜内外动作同步。更值得一提的是,它还能在主角不变的情况下实现镜头视角的自动切换,这个功能在当前模型中并不多见。
下面几个例子,可以直观感受其生成效果:
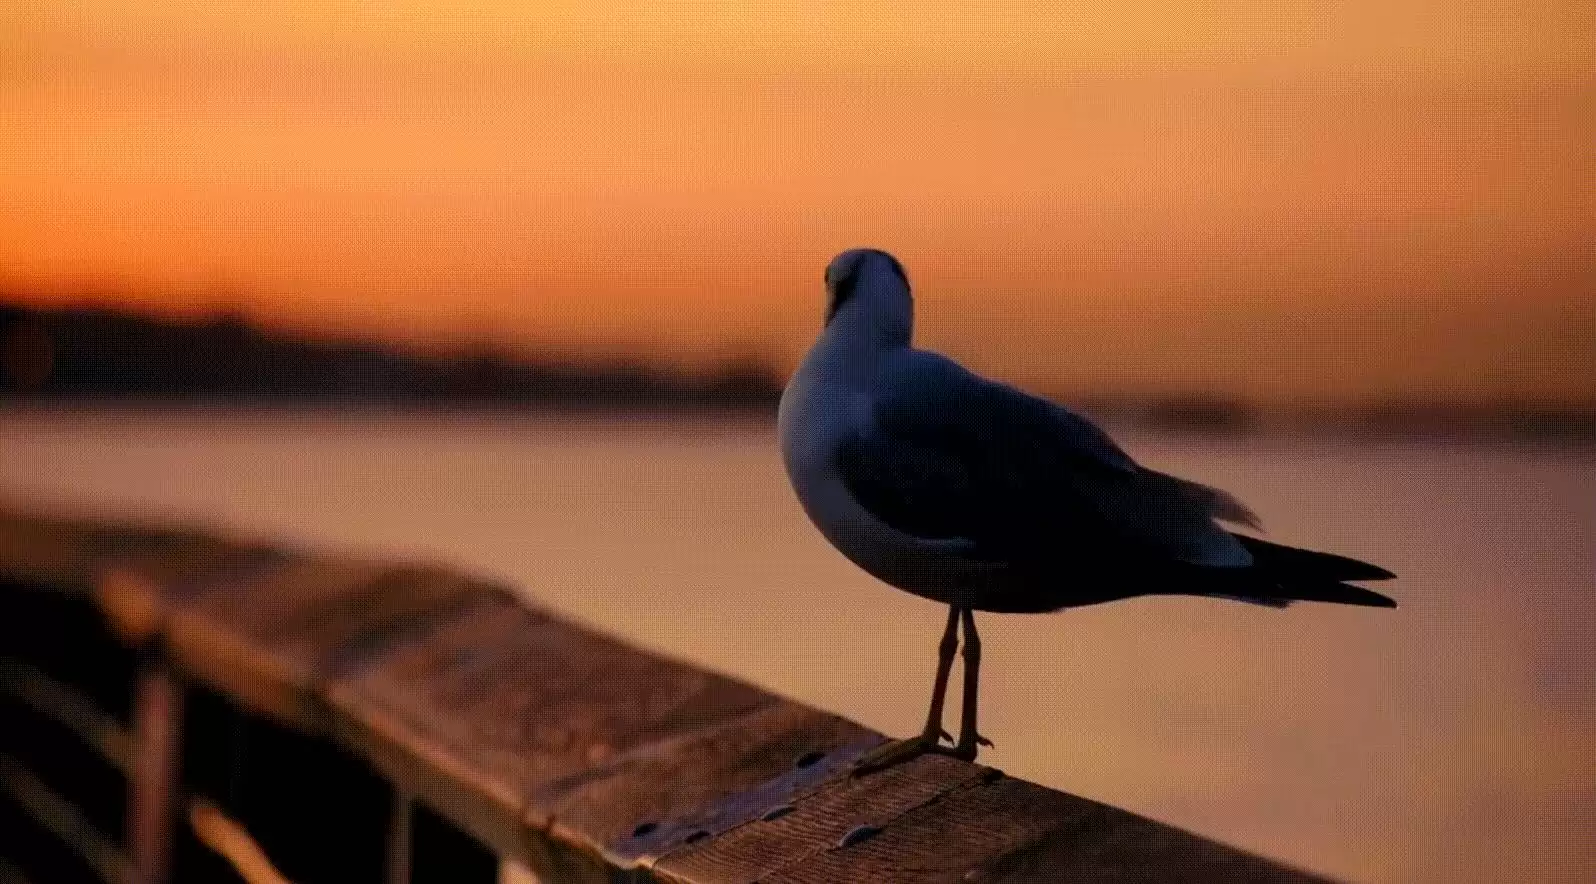
视频由腾讯混元视频生成,提示词:200mm长焦镜头,对准一只停在栏杆上的海鸥。羽毛的纹理清晰可辨,前景的木栏杆温柔虚化。远处的落日和海平面融化成金红色的光影
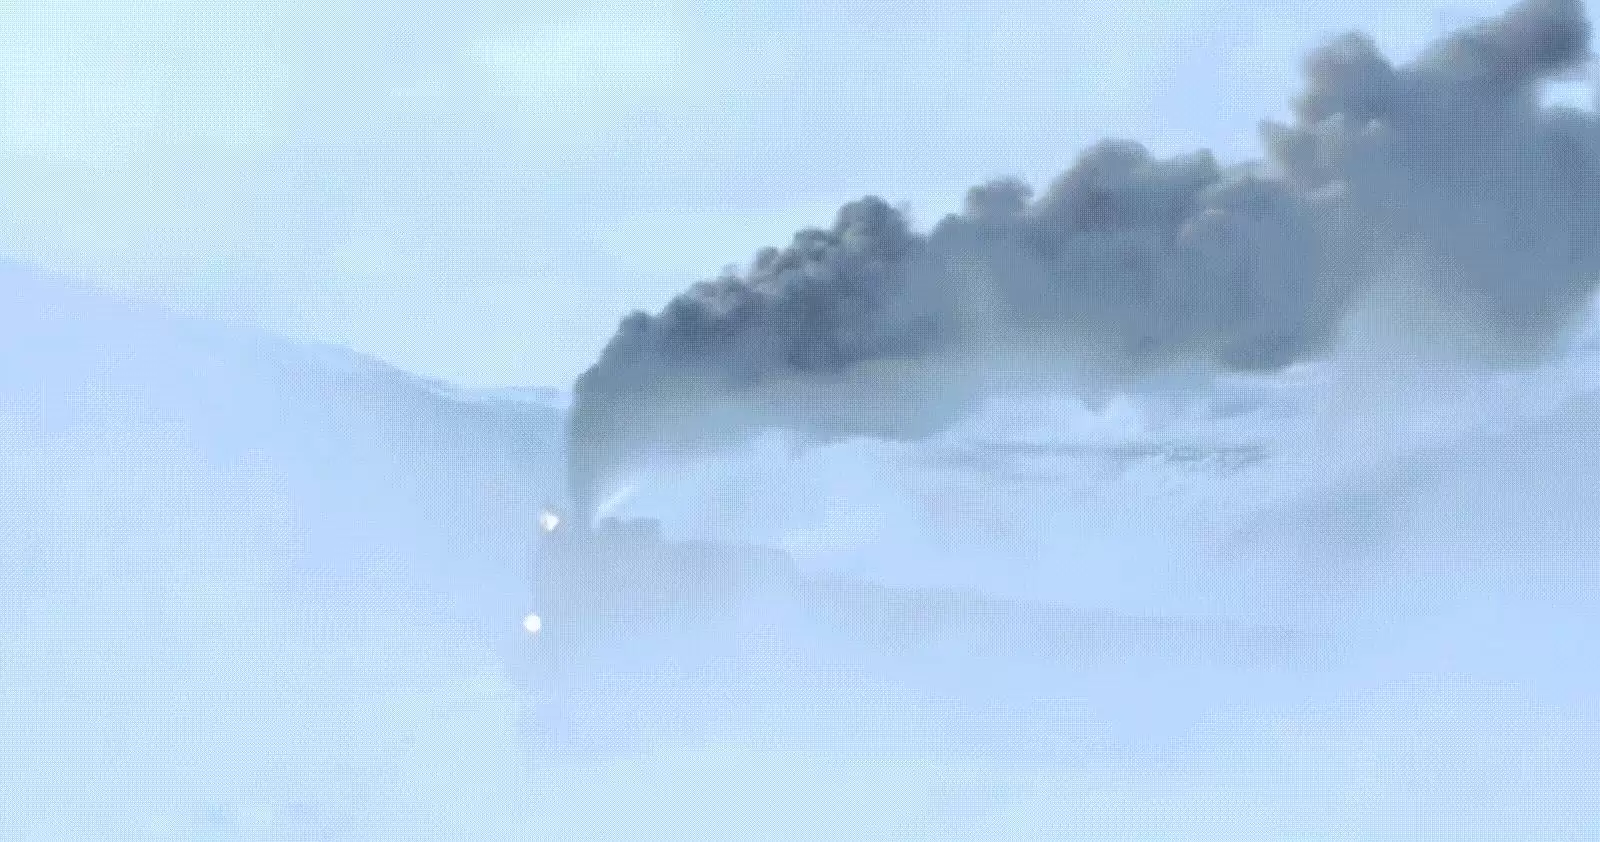
视频由腾讯混元视频生成,提示词:暴风雪中,一列蒸汽火车在崎岖山间穿行,黑烟从车头直冲云霄,车厢在皑皑白雪中留下深邃轨迹,镜头以侧面追踪,捕捉机械巨兽破开风雪的磅礴气势,白雾与蒸汽交织成壮丽画卷,电影氛围,远景
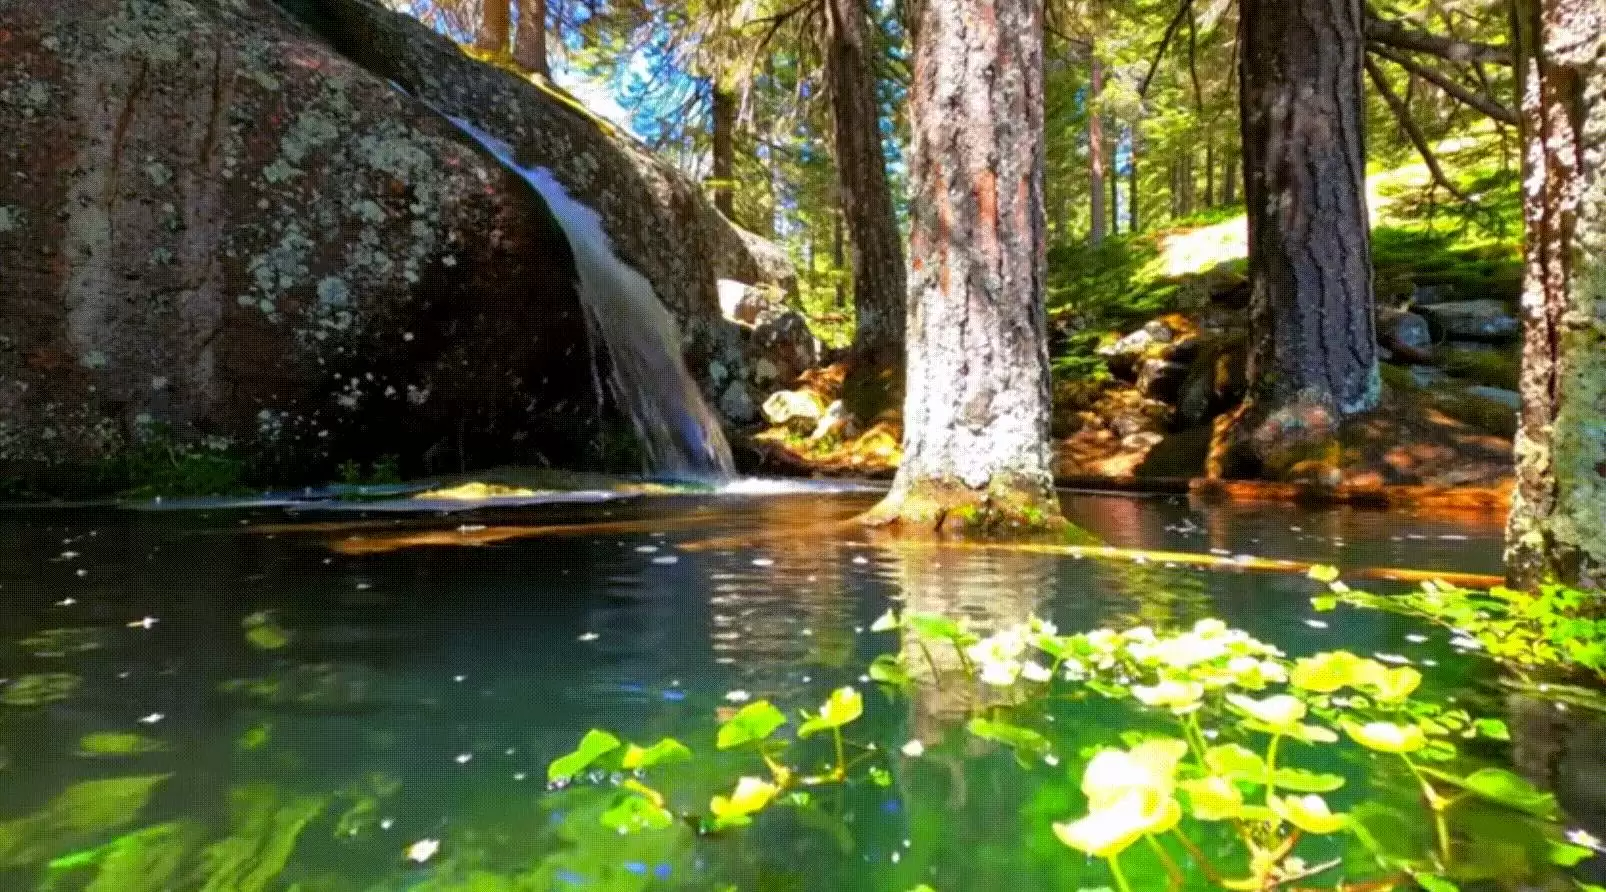
视频由腾讯混元视频生成,提示词:一个隐藏的瀑布流入清澈的池塘,周围是高大的树木和绿色植物。阳光穿过树叶,在下面的岩石和水面上形成斑点。逼真,茂密森林中的宁静瀑布,宁静、阳光明媚的日子,中景
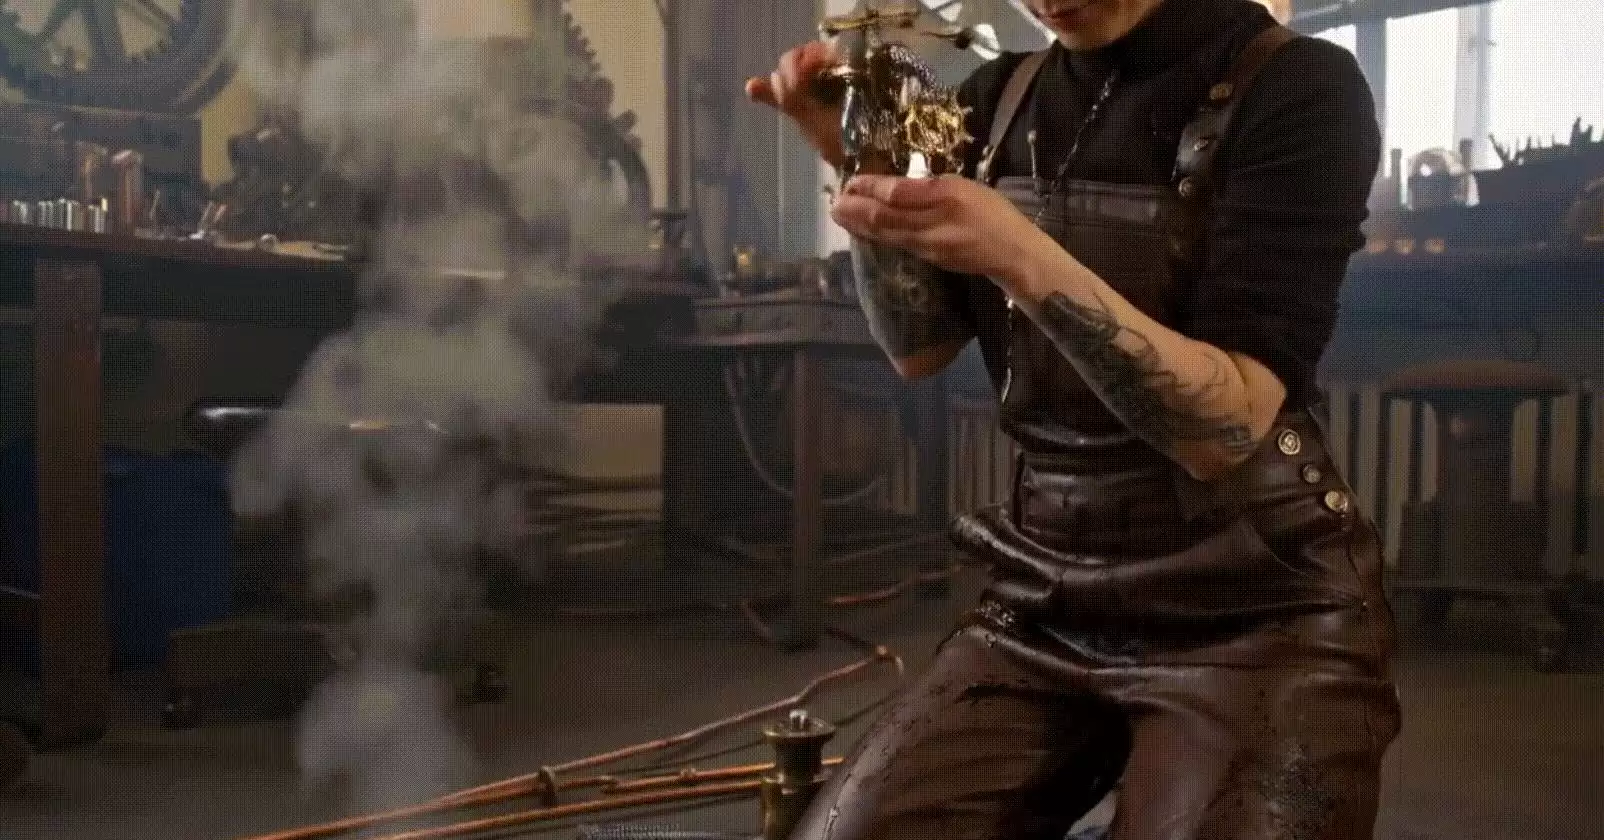
视频由腾讯混元视频生成,提示词:一位戴着复古飞行护目镜的机械师,半跪在蒸汽朋克风格的工作室里。她棕色卷发挽成发髻,零星的银色发丝闪着金属光泽。深棕色皮质工装背带裤上沾满机油污渍,袖口卷起露出布满齿轮纹身的手臂。特写她正用黄铜工具调试一只机械鸟,齿轮间冒出缕缕蒸汽,工作台上散落着铜管、发条和老式图纸。
腾讯混元视频生成技术架构:基于DiT的深度优化
能达到这样的效果,背后的技术架构是关键。混元视频生成模型采用了与Sora相似的扩散Transformer(DiT)架构,并在此基础上做了多项针对性优化。
首先,通过引入新一代文本编码器,模型对语义的理解和指令遵循能力显著增强,这让它在处理多主体、细节丰富的场景时更加得心应手。其次,采用统一的全注意力机制,不仅让视频帧间的过渡无比自然,还实现了在保持主体一致前提下的多视角切换。最后,在编码环节,其采用的图像视频混合VAE(3D变分编码器)技术,在捕捉细节上更进一步,特别是在处理人脸特写、快速运动等复杂镜头时,优势尤为突出。
腾讯混元视频模型全面开源,加速行业创新
此次开源的力度相当大。目前,模型的完整资源,包括权重、推理代码、算法细节等,均已发布在Hugging Face和Github平台上,供全球开发者免费使用与研究。
这意味着,开发者和企业无需从零开始耗费巨量算力和时间进行训练,可以直接基于这个强大的基础模型进行推理,甚至打造专属的行业应用和服务。这无疑将大幅降低视频生成技术的应用门槛,为整个行业的创新按下加速键。
回顾今年,腾讯混元模型的开源步伐明显在加快。从文生文、文生图到3D生成,再到如今的视频生成,至此,腾讯混元系列大模型已实现了全面的技术开源。这不仅仅是一次产品更新,更可能预示着AI大模型生态竞争进入了一个新的阶段。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
相关文章