

美团开源LongCat-Flash-Thinking-2601,完全开放权重、推理代码与在线体验。该模型在智能体搜索、工具调用与交互推理任务中刷新开源SOTA,工具调用泛化能力超越Claude,降低业务定制成本。首创开源“重思考模式”,通过并行8条推理路径再归纳迭代。编程、数学及智能体基准测试均居开源模型前列。
美团开源LongCat-Flash-Thinking-2601
作者:技术拾光
时间:2026-08-04
浏览:104
文章目录
对于关注开源大模型进展的人士来说,近期有一则消息值得关注:美团LongCat团队正式发布了新模型LongCat-Flash-Thinking-2601,并全面开源了模型权重、推理代码和在线体验。如此高的透明度在行业中较为少见。
据官方介绍,这不仅是此前LongCat-Flash-Thinking的全面升级版本,更在多个关键维度上显著抬升了开源模型的性能天花板。具体而言,在智能体驱动的搜索、智能体化的工具调用以及工具交互推理等评测任务上,该模型均刷新了开源模型的SOTA记录。
一个值得关注的亮点是其工具调用任务的出色表现。面对高度随机且结构复杂的工具依赖型任务时,其泛化能力已超过Claude。这意味着在实际业务场景中接入新工具时,所需的定制化训练成本将大幅降低。简而言之,模型不仅变得更智能,也变得更加“好用”。
此外,LongCat-Flash-Thinking-2601是行业内首个完全开源且支持在线免费体验“重思考模式”的模型。所谓“重思考模式”,即同时并行运转8个独立推理单元。简单理解就是,面对问题时模型不再只沿着一条路径思考,而是多条路径同时尝试,最终整合出最可靠的答案。
该核心推理机制分为两个明显阶段:
- 并行思考阶段:模型同步生成多条逻辑独立、视角各异的推理路径,模拟人类面对复杂问题时“多角度试错”的习惯,并有意增强路径多样性,避免陷入局部最优的思维陷阱;
- 总结归纳阶段:将前面生成的多条结果进行交叉验证、逻辑提炼和结构整合,再将优化后的中间结论重新注入推理流程,形成闭环迭代,不断自我修正并逼近最优解。
为实现这种多轮思考质量,团队专门针对“归纳总结能力”引入了强化学习训练策略。并非简单堆叠参数,而是训练模型如何整合信息、抽象提炼,最终生成靠谱策略——真正实现“先想清楚再动手”。
综合评测数据:四个维度全面领跑
从公开的综合评测来看,LongCat-Flash-Thinking-2601在编程理解、数学推演、智能体工具调用与智能体搜索四个大方向上,均稳居第一梯队。
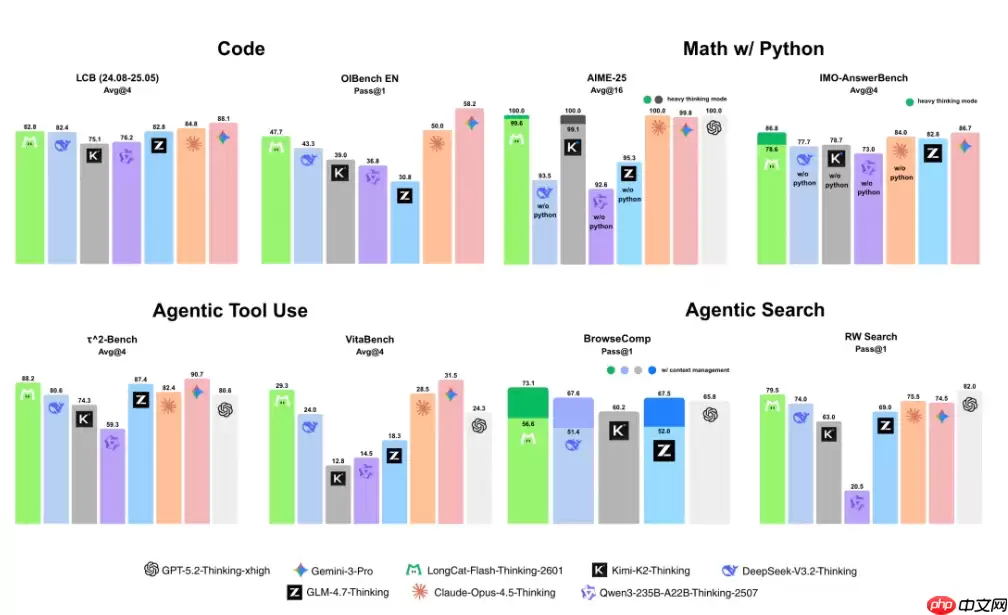
编程能力
在代码领域,LCB基准测试中该模型拿下82.8分,OIBench EN测试达到47.7分。这不仅是数字上的提升,更体现了代码生成质量与逻辑严谨性的双重优势。在开源模型中,它已是具备顶尖竞争力的之一。
数学推理能力
开启重思考模式后,数学优势尤为突出。AIME-25测评中直接获得满分100.0分,IMO-AnswerBench中取得86.8分,再次刷新开源模型成绩。这两个高含金量的数学推理测试共同证明其逻辑链条能够经受高压检验。
智能体工具调用能力
这是该模型最强且最独特的领域。τ-Bench得分88.2,VitaBench达29.3,两项指标均为目前开源模型中的最佳成绩。更重要的是,这些评测覆盖金融、医疗、运维等多个领域的工具链,并非实验室的玩具数据,而是具备真正可落地的实用能力。
智能体搜索能力
在BrowseComp任务中得分73.1,为全模型最高分;RW Search评测也收获79.5分。其展现的信息定位精度与跨场景泛化能力,在开源领域处于遥遥领先的地位。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。