

AI落地企业面临数据难题,Agent成为数据库新用户。OceanBase推出湖库一体AI数据库,整合结构化与非结构化数据、支持混合搜索及强一致性底座,降低TCO约30%-50%,赋能Agent生产场景。
数据库为Agent重写,OceanBase如何再造AI数据库?
作者:技术拾光
时间:2026-08-03
浏览:274
文章目录
过去三年,AI领域最受关注的话题几乎都被模型和算力占据。模型能力每周迭代,企业预算也纷纷流向大模型、GPU、训推平台以及各类Agent应用。表面热闹非凡,但当AI真正进入生产环境时,一个基础问题始终无法回避:模型买了,算力堆了,为什么许多AI项目就是无法产生实际价值?
答案其实不在于“模型还不够强”,真正的症结出在数据上。
OceanBase的CEO杨冰有句话说得很到位:“AI落地企业的最后一公里,本质上是一道数据难题。”模型再聪明,如果它无法理解业务、无法参与真实决策、无法跑通完整流程,那么它创造的价值就很有限。通用大模型与一家企业真正需要的AI之间,隔着的是一条“业务上下文”鸿沟。
那么,当Agent逐渐成为企业软件和数据系统的新使用者,数据库该如何面向AI进化?这是所有企业都必须面对的挑战,也是OceanBase必须回答的问题。
01 AI最后一公里,回到了数据库
进入Agent时代后,数据库的服务对象正在悄然发生改变。
以前的数据库服务于人。工程师写SQL,业务人员查看报表,系统按预设流程执行增删改查,数据库记录交易、订单、账户、库存、日志——这是企业运转后留下的事实系统。但AI大举进入生产环节后,尤其是Agent开始大量介入,这个流程发生了根本性变化。
Gartner的预测数据很能说明问题:到2028年,预计33%的企业级软件将整合自主型AI Agent,超过15%的日常工作决策将由Agent自主完成。Agent调用数据的方式与人类完全不同——它们可以7×24小时运行,能够高频并发地查询、推理、执行任务,还能在执行过程中不断生成新的记忆、状态和行动记录。
换句话说,数据库迎来了第一类非人类用户——Agent。
基于深度参与蚂蚁、阿里等大量数据密集型大客户Agent项目的经验,杨冰总结出AI给数据库带来的三个核心挑战:
第一,Agent规模呈指数级增长。vibe coding的火爆使一句话就能构建一个Agent成为现实,构建成本几乎趋近于零。以蚂蚁灵光为例,短短几个月内,承载的应用就超过3000万个。
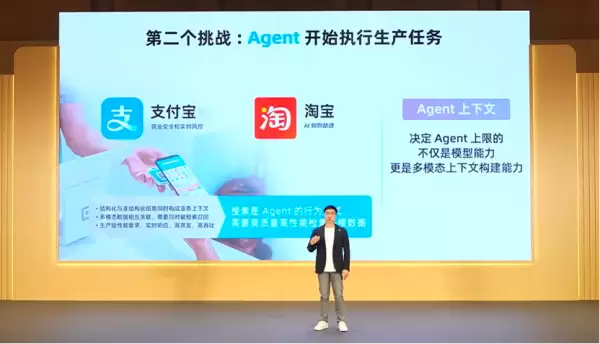
第二,Agent开始执行生产任务。企业落地Agent,不可能绕过核心业务数据。这些业务对准确性、一致性要求极高。在AI时代,越来越多的非结构化数据涌入核心系统,混合搜索成为以搜索为核心交互方式的Agent的刚需,数据库必须加上强大的搜索引擎能力。
第三,Agent长期运行的正确性和自我进化能力必须得到保障。Agent的进化本质上需要大量可以被毫秒级复制、试验、回滚的评测数据集。传统数据库并未针对Agent的大量试错和自我进化进行设计,无法支持生产级Agent的Harness工程——而这恰恰是AI数据库必备的能力。
传统数据库要应对这三大挑战,就需要重新构建一套面向Agent的AI原生数据库。
更重要的是,Agent所需的数据已经不再只是表格。一笔订单、一段客服录音、一张发片照片、一份合同文本、一次用户对话、一条风控规则——它们共同构成了企业业务的上下文。那些过去被归档、备份、沉睡的非结构化数据,在大模型出现后,第一次变成可理解、可计算、可调用的资产。
换句话说,AI时代的数据库不能只回答“数据在哪里”,还要能回答“这些数据是什么意思”、“能不能实时给Agent用”,以及“能不能在使用过程中反哺模型和业务”。
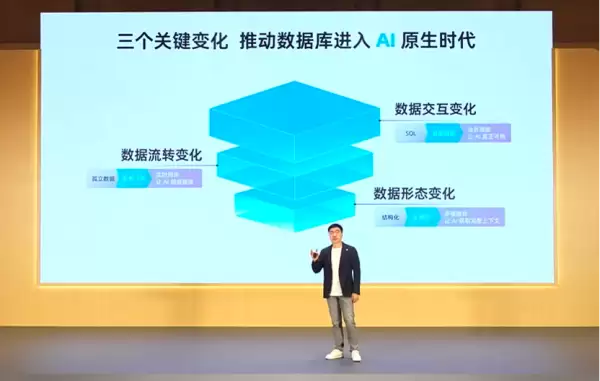
Agent每一次回答,本质上都是“上下文+模型调用”的体现。模型决定了能力上限,但数据和上下文决定了业务价值。企业Agent应用之间的差距,越来越不只是“谁的模型更强”,而是“谁能让AI真正读懂业务”。
数据库也因此被再次推到了舞台中央。在Agent不断涌入企业生产系统的这一年,它变成了AI落地的最后一公里。
02 只做AI检索不够,湖库一体是AI数据库的必然
如今一谈AI数据库,很多人容易理解为传统数据库加上一个向量检索插件,或者把搜索引擎、向量库、数据湖、交易库简单拼在一起。
但这并不是OceanBase眼中AI数据库该有的样子。
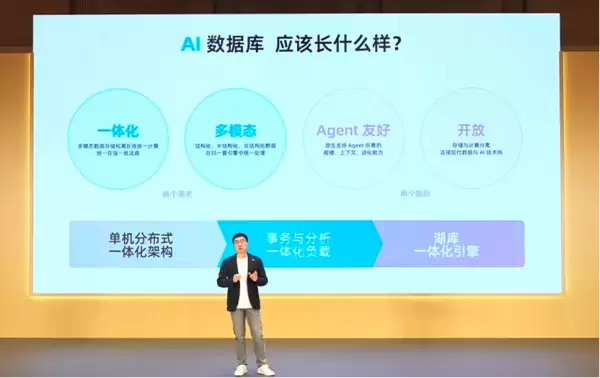
OceanBase CTO杨传辉把AI数据库称为“第四代数据库的基建”,在他看来,“湖库一体”是这代数据库最关键的特性。
为什么是湖库一体?
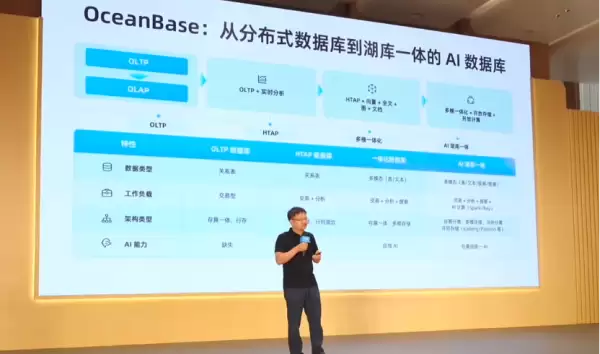
因为“湖”和“库”各自解决的问题不同。湖擅长开放、海量、多模态和多样化计算,库则擅长事务、一致性、实时性和可靠性。AI真正进入企业核心场景后,两者缺一不可。
如果结构化数据在交易库里,文档图片在对象存储里,向量在向量库里,搜索在搜索引擎里,离线加工又在另一套大数据系统里——Agent调用数据时就要面对多套系统、多套权限、多份元数据、多条链路。结果就是上下文不完整、数据不一致、权限难治理,延迟和运维复杂度都会上升。
在辅助问答场景里,这或许只是体验问题;但在风控、安全、金融、医疗场景里,慢一拍、错一条,就可能变成实实在在的业务事故。
所以,对于AI时代的数据库,湖库一体就是OceanBase给出的答案。
杨传辉用几个更具体的技术指标解释了这种改变:
第一,多模表。过去关系表主要承载整数、字符串、时间这类结构化字段,到了AI时代,一张表里还要能容纳文本列、向量列、LOB列、AI列等多模数据。用户看到的仍然是一张表,但这张表的背后可以同时管理结构化和非结构化数据。
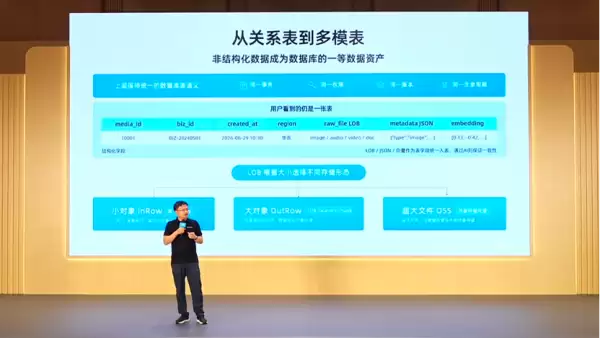
第二,AI列。它把模型能力引入数据库内部,可以对数据做embedding、打标、摘要等处理,同时保证这些AI加工和数据本身保持一致性。也就是说,非结构化数据不再只是“存下来的文件”,而是可以被搜索、计算、治理和调用的数据资产。
第三,混合搜索。AI数据库与原有关系型数据库最大的不同,就是能支持混合搜索。在同一张多模表里完成关系过滤、向量搜索、全文搜索、图搜索和AI计算,这比单纯的向量检索更接近真实业务的需要。因为Agent的搜索很少是单一模态的——它可能先用结构化条件缩小候选集,再用向量召回语义相近的内容,再结合全文、图关系和重排来获得结果。真正的上下文工程,天然需要混合搜索。
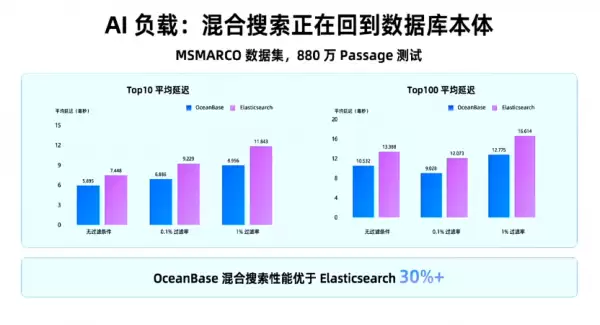
这也是OceanBase反复强调“一体化”的原因。AI数据库不是把几个系统粘在一起,而是要把多模态、在线事务、实时分析、开放计算和Agent上下文放到同一个强一致性底座上。为此,OceanBase必须重写AI时代的数据底座。
03 OceanBase如何再造AI数据库?
6月29日,OceanBase正式对外发布了面向AI时代的湖库一体AI数据库。核心思路是以湖库一体为架构,把数据湖的开放与海量存储能力、数据库的事务处理与分析能力,以及多模态数据处理能力,统一到一套强一致的数据底座上。
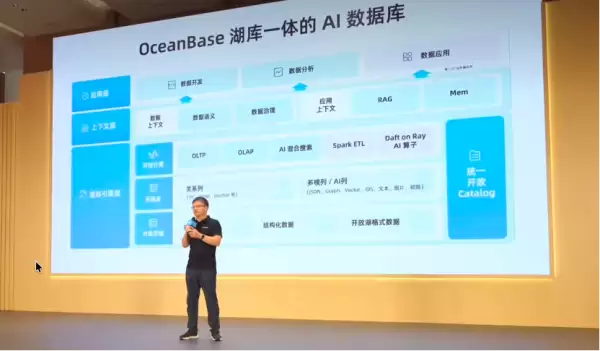
这套AI数据库以湖库一体的Lakebase为底层引擎,解决AI时代的数据底座问题。Lakebase面向结构化、非结构化、多模态数据,提供统一管理、加工、检索和调用能力。它可以独立部署,服务全新的AI业务场景,也可以作为智能叠加层,与企业已有的数据湖和数据系统并行运行。
在Lakebase之上,是OceanBase DataStudio,面向数据生产、治理与服务,覆盖数据集成、数据加工、数据治理、数据发布、资产管理等环节。DataStudio要解决的是企业如何把分散的数据资产变成可管理、可理解、可调用的数据服务。
再往上,是支撑各类数据应用快速落地的能力层,OceanBase DataPilot是其中的代表。OceanBase产品部总经理韩富晟把DataPilot定义为“更懂业务的数据智能Agent”,帮助业务人员通过自然语言完成经营指标查询、归因分析、洞察报告生成和监控看板搭建。DataPilot的目标不是让业务人员多一个报表工具,而是让数据从“看得见”走向“用得上、能决策”。
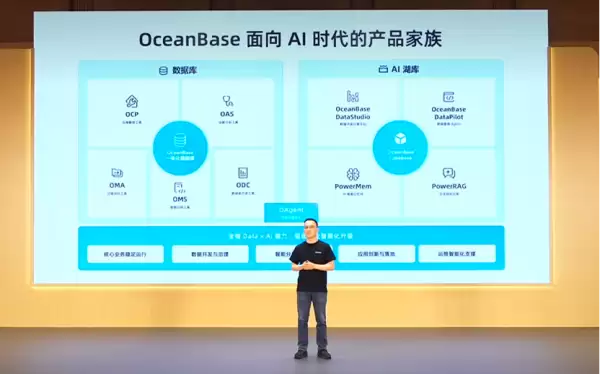
这套产品组合的逻辑很清楚:Lakebase作为底层引擎,DataStudio负责数据生产和治理,DataPilot作为业务智能入口,再结合PowerMem记忆智能体和PowerRAG企业知识库,OceanBase试图把AI应用落地所需的数据链路收敛到一套平台里面。
据悉,OceanBase AI数据库能够降低整体TCO约30%-50%。这一能力已在蚂蚁阿福、灵光等场景完成验证。其中,灵光累计生成了数千万个“闪应用”,验证了湖库一体架构在千万级Agent场景下的可行性。
十五年前,双十一这样的极限业务场景倒逼了OceanBase原生分布式数据库的诞生。今天,灵光、阿福,以及国内正在涌入各类生产场景的Agent,又在倒逼下一代AI数据库的出现。
作为已经服务超过400家金融机构、连续两年位居中国分布式数据库本地部署市场第一、也是迄今唯一同时登顶TPC-C和TPC-H两项国际权威测试的数据库,OceanBase的业务已覆盖全球多个国家和地区。
当数据库开始为Agent重写,AI数据库就不再是数据库行业的一个小分支,而是关乎AI应用能否真正进入企业核心业务的基础设施问题。正如杨冰所说:“下一个10年,OceanBase的目标就是再造一个AI时代的数据库。”这一次,他们选择从数据库内核出发,将长期在金融核心系统中验证的事务一致性、高可用与弹性能力,延伸至湖与多模态数据体系之上,使其具备统一支撑AI负载的能力。这不是在旧架构上做叠加修补,而是一次从底层出发的重构。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
相关文章