

英伟达开源60B参数双塔扩散语言模型Nemotron-Labs-TwoTower,采用冻结的自回归塔与可训练的去噪塔协同架构,每个塔激活3B参数并调度128个专家。综合测试结果显示,该模型保留原模型98.7%质量,生成吞吐量提升2.42倍。
英伟达开源TwoTower模型:AI生成提速2.42倍,保留98.7%质量
作者:技术拾光
时间:2026-08-02
浏览:524
文章目录
英伟达发布Nemotron-Labs-TwoTower模型:双塔架构提速2.42倍
昨天,英伟达发布了一篇博文,介绍了一款名为Nemotron-Labs-TwoTower的新模型。该模型的核心目标是解决大模型生成Token时的速度瓶颈。简单来说,这是一款基于预训练自回归骨干网络的离散扩散语言模型,专为提升生成速度而设计。
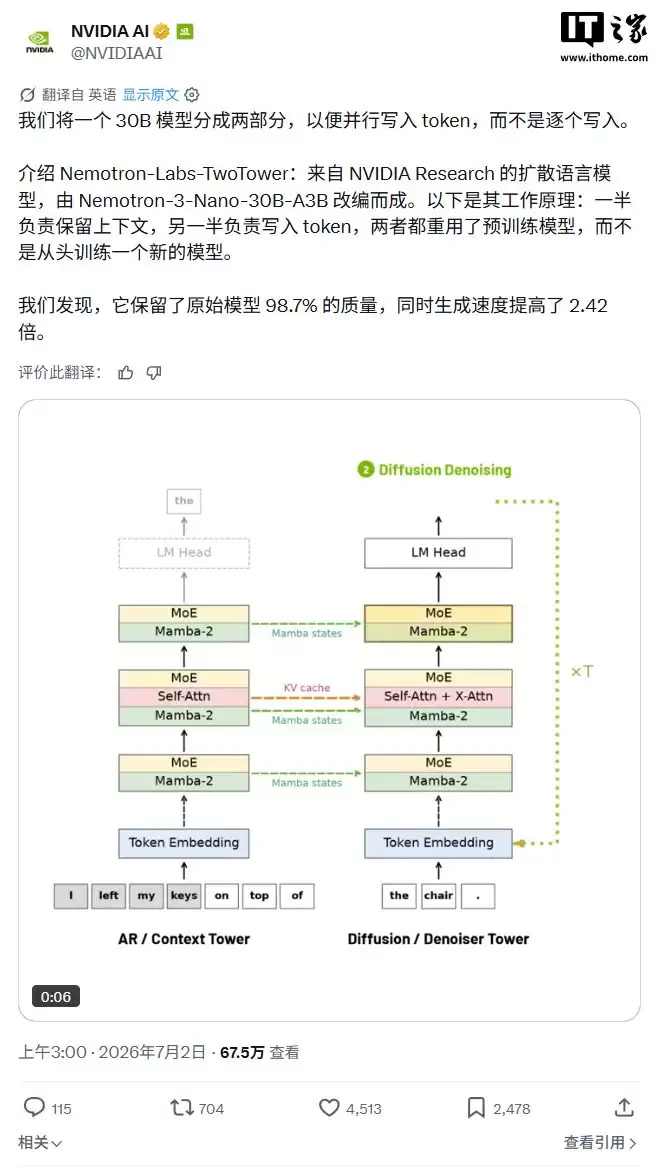
该模型采用开源形式发布,模型权重已在Huggingface上公开,授权协议为NVIDIA Nemotron Open Model License,开发者可以直接使用。
参数方面,总规模为60B,采用双塔架构——两个塔各占30B参数。具体结构为:一个称为自回归塔(AR/context Tower),另一个称为扩散/降噪塔。每个塔激活3B参数,并在128个可路由专家之间进行调度。这一设计思路与传统扩散语言模型不同:传统模型将所有任务混合处理,而TwoTower则将其拆分到两个独立的神经网络“塔”中。
其中,上下文塔(AR/context Tower)被冻结,专门负责维护文本的自回归上下文;去噪器塔(扩散/降噪塔)则负责训练,对噪声块进行去噪。两塔通过逐层交叉注意力连接协作。这种分离设计让专业任务各司其职——一个塔专注记忆上下文,另一个塔专注去除噪声,互不干扰。
性能数据表明,双塔架构保留了原模型98.7%的质量表现,但实际运行时的吞吐量提升了2.42倍。这意味着在几乎不损失精度的情况下,生成速度提升了两倍以上。以下为具体测试对比结果:
| 任务 | Nemotron-3-Nano-30B-A3B (AR) | Nemotron-Labs-TwoTower (diffusion) |
|---|---|---|
| MMLU (5-shot, acc) | 78.56 | 78.24 |
| MMLU-Pro (5-shot, CoT EM) | 62.59 | 60.93 |
| ARC-Challenge (25-shot, acc_norm) | 91.72 | 92.66 |
| WinoGrande (5-shot, acc) | 76.09 | 76.09 |
| RACE (0-shot, acc) | 88.90 | 88.90 |
| HumanEval (0-shot) | 79.27 | 75.58 |
| MBPP-Sanitized (3-shot) | 74.71 | 74.28 |
| GSM8K (8-shot, acc) | 92.49 | 90.14 |
| MATH-500 (4-shot) | 84.40 | 80.60 |
| MMLU Global Lite (5-shot) | 73.97 | 73.94 |
| MGSM (8-shot, avg acc) | 80.80 | 80.40 |
| Quality retained | 100% | 98.7% |
| Generation throughput (× AR) | 1.0× | 2.42× |
从表格可以看出,模型在数学推理任务(如MATH-500、GSM8K)上有所下降,但在常识推理任务(如ARC-Challenge)上反而略有提升。整体来看,用不到2%的精度代价换得2.42倍的速度提升,在实际部署场景中具有明显优势。具体效果仍需根据落地调优情况而定,但从架构思路和创新性来看,TwoTower模型值得关注。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
相关文章