

深入讲解在JavaScript数据表格中,如何在点击表头排序后精准保持当前筛选关键字和分页浏览位置。通过单一状态源、纯函数数据流水线与边界校准机制,彻底解决状态丢失与越界问题。
JavaScript表格排序后怎么保持分页与筛选状态
作者:代码拾荒
时间:2026-11-22
浏览:490
文章目录
JavaScript 前端开发
阅读时长约 8 分钟
模式:单一状态源流水线
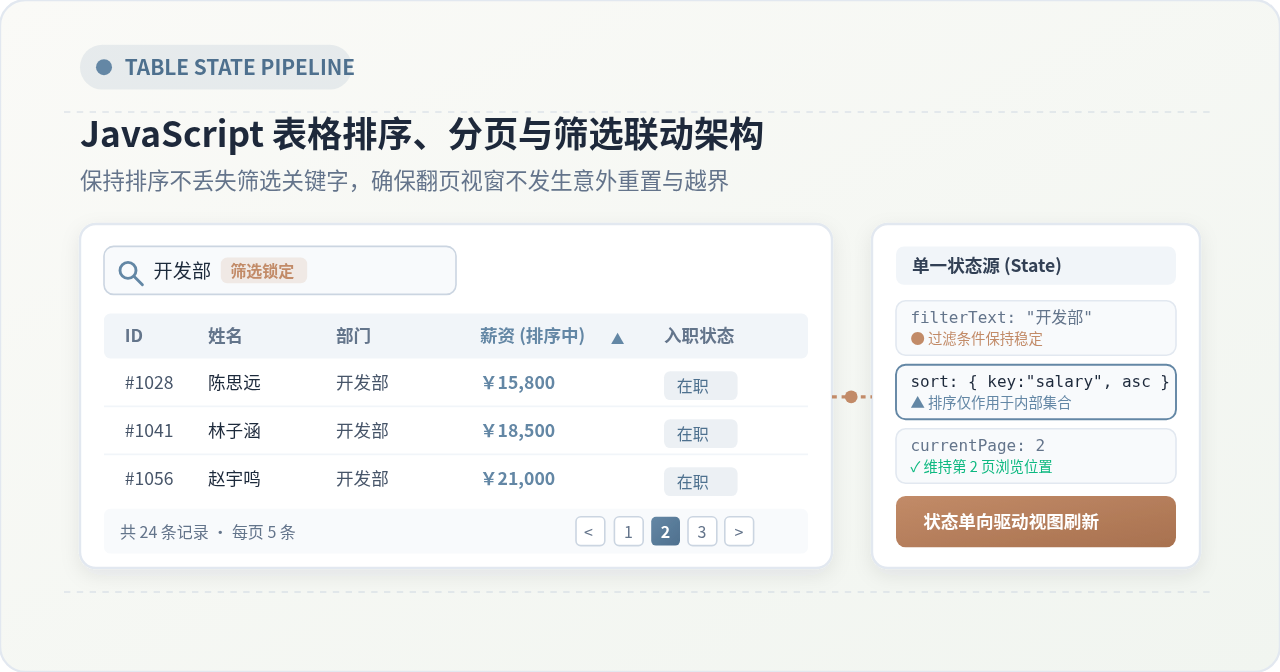
在前端数据表格开发中,当用户在已经筛选过的结果列表里翻到第 3 页并点击表头排序时,很多实现会出现搜索词丢失、表格被强制重置回第 1 页或数据混乱的现象。要彻底解决这一问题,核心方案是建立“单一状态源驱动的单向数据流水线”:将筛选条件、排序规则与当前页码统一收敛于同一个状态对象中;发生排序操作时仅变更排序规则,随后依照“原始数据 ➔ 关键字筛选 ➔ 全量排序 ➔ 当前页切片 ➔ DOM 视图”的严格次序重新计算,并结合最大页码边界校验,即可稳妥保持当前的筛选与翻页状态。
一、为什么表格排序容易导致分页与筛选失效?
在许多初学者或快速迭代的前端代码中,表格的搜索框、表头点击和分页器往往是由各自独立的事件监听器直接操作 DOM 元素来实现的。这种分散式的结构会导致三个典型问题:
-
局部切片排序错误:许多开发者直接对当前页渲染出来的 10 行数据(即已通过
slice()截断的切片)调用sort()。这不仅没有对全部符合筛选条件的数据进行排序,而且在用户翻到下一页时,前后页之间的数据大小关系是完全颠倒脱节的。 -
事件回调中暴力重置:由于担心排序后当前页码超出范围,部分代码在表头点击事件中写死了
currentPage = 1,或者重新调用了不带查询参数的初始化接口,这会直接粗暴打断用户在深层页面的查阅体验。 -
状态分散存储于 DOM:搜索词存放在
input.value,排序字段存放在表头的data-order属性,页码存放在分页按钮的active类名中。重新渲染表格时,一旦使用innerHTML = ''整体刷新,各处的临时状态就会相互覆盖或丢失。
二、核心模型:单一状态源与单向数据流水线
解决状态丢失的根本思想是状态与表现分离(State-driven View)。表格的界面展示永远只是当前状态的“纯函数映射输出”。
1. 集中定义状态对象
在内存中维护一个轻量的状态对象,作为全表唯一的真理来源(Single Source of Truth):
// 全局唯一的状态对象
const state = {
  filterText: '',      // 搜索/筛选关键字
  sortKey: 'id',       // 当前排序字段
  sortOrder: 'asc',    // 排序方向:'asc' 升序 | 'desc' 降序
  currentPage: 1,      // 当前所处页码
  pageSize: 10         // 每页展示条数
};
2. 建立不可逆的计算流水线
原始数据源 rawList 必须保持只读不可变,不可直接调用 rawList.sort() 破坏其原有序列。数据加工必须严格遵循单向流动管道:
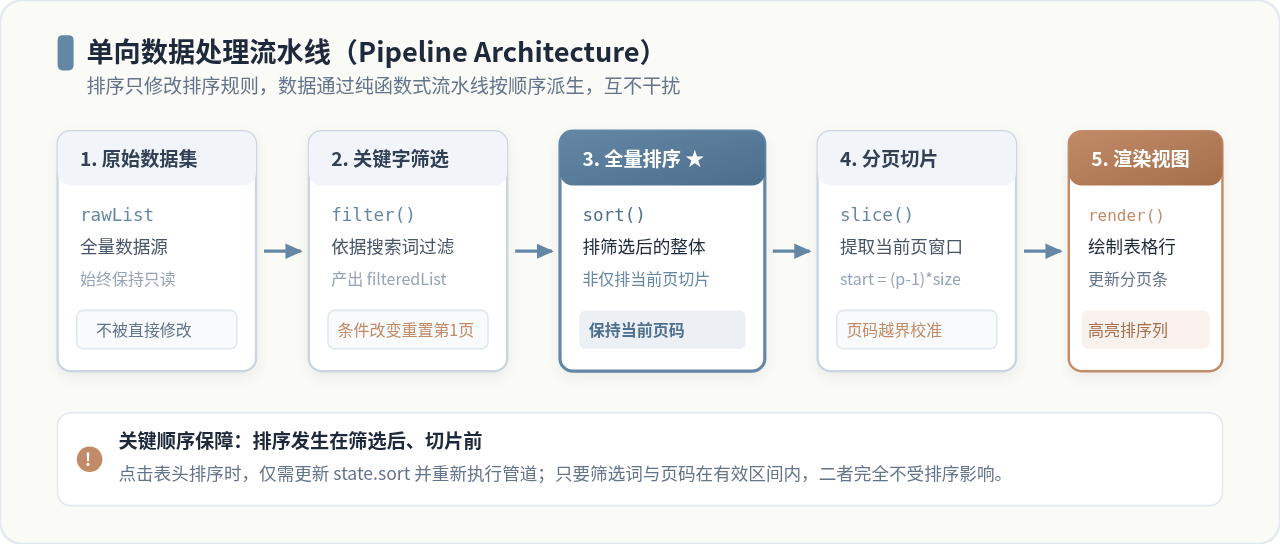
从图 1 可以清楚地看出关键所在:全量排序必须发生在筛选过滤之后、分页切片之前。
当用户点击表头排序时,只需要更新 state.sortKey 和 state.sortOrder,原有的 state.filterText 依然保留,随后全量排序直接作用于筛选后的数据集,最终按照当前的 state.currentPage 截取视窗,从而自然保持了筛选与分页的状态。
三、实现步骤:分步构建完整的状态保持机制
按照以下四个步骤,可以完整落地这一健壮的表格状态管理方案:
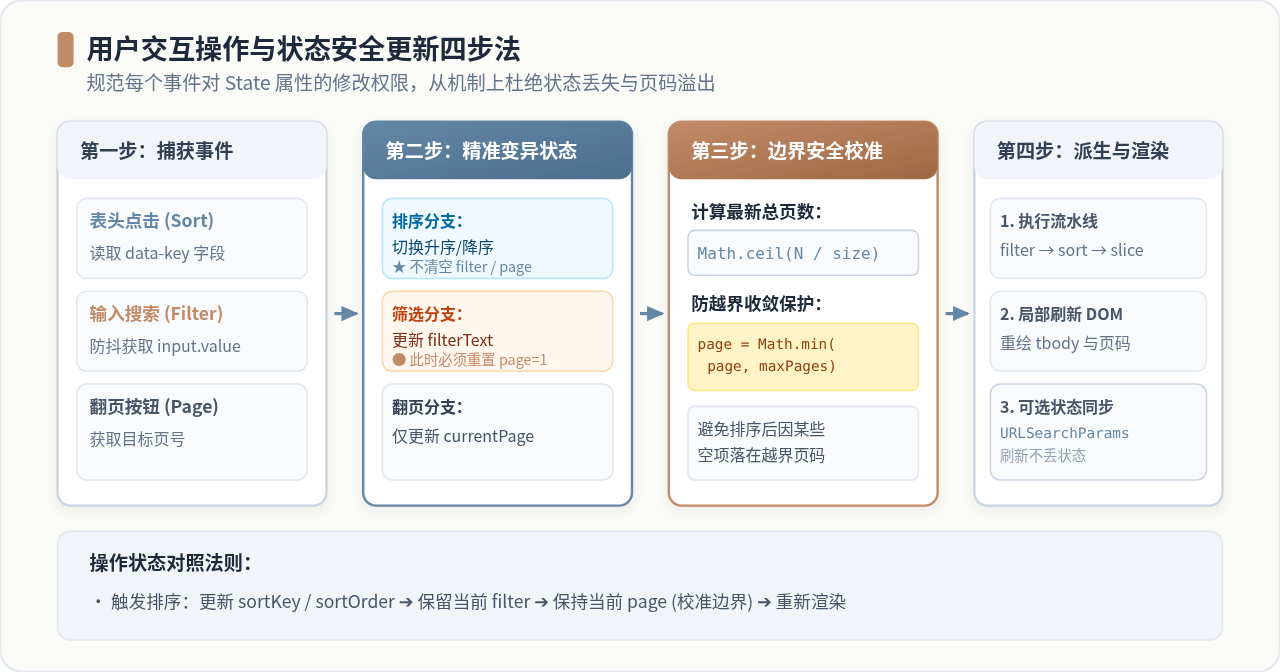
步骤一:编写纯函数数据转换管道
封装一个纯函数 getProcessedData(state, rawData),接受当前状态与全量数据,返回当前页所需的数据以及派生出的分页元信息:
function getProcessedData(state, rawData) {
  // 1. 过滤筛选(不污染原始数据)
  const query = state.filterText.trim().toLowerCase();
  const filtered = query
    ? rawData.filter(item =>
        Object.values(item).some(val =>
          String(val).toLowerCase().includes(query)
        )
      )
    : [...rawData];

  // 2. 全量排序(对所有符合筛选条件的数据排序)
  filtered.sort((a, b) => {
    const valA = a[state.sortKey];
    const valB = b[state.sortKey];
    if (valA === valB) return 0;

    // 支持数值与字符串本地化对比
    const comparison = typeof valA === 'number' && typeof valB === 'number'
      ? valA - valB
      : String(valA).localeCompare(String(valB), 'zh-CN');

    return state.sortOrder === 'asc' ? comparison : -comparison;
  });

  // 3. 计算分页边界并校准当前页
  const totalItems = filtered.length;
  const totalPages = Math.max(1, Math.ceil(totalItems / state.pageSize));

  // 边界保护:确保当前页不超过实际最大可用页数
  const safePage = Math.min(Math.max(1, state.currentPage), totalPages);

  // 4. 当前页切片
  const startIndex = (safePage - 1) * state.pageSize;
  const pageData = filtered.slice(startIndex, startIndex + state.pageSize);

  return {
    items: pageData,
    totalItems,
    totalPages,
    safePage
  };
}
步骤二:分发事件并差异化更新状态
不同的用户交互对状态的影响范围是不同的,必须明确权限边界:
-
点击表头排序:更新
sortKey,若点击同一列则翻转sortOrder(asc↔desc)。此时绝对不要重置 currentPage 和 filterText。 -
输入筛选关键字:更新
filterText。由于筛选可能会大幅减少总记录数,导致原有的大页码(如原本在第 8 页,筛选后仅剩 2 页)失效,因此修改筛选词时必须将 currentPage 重置为 1。 -
点击分页按钮:仅更新
currentPage,不改动筛选与排序。
步骤三:执行边界收敛(Clamp Protection)
虽然排序本身不会改变筛选后匹配的总记录数,但在某些动态增删数据的场景下,将数据重新排序后,依然要执行:
state.currentPage = Math.min(state.currentPage, totalPages);这样可以避免在极端并发或数据条目变动时用户停留在不存在的空白页。
步骤四:单一渲染入口与表头指示符更新
事件触发后,统一调用 render() 函数。它根据最新的计算结果重绘 <tbody>,更新底部分页控件的高亮按钮,并在当前排序列的表头上渲染升序(▲)或降序(▼)图标。
四、常见误区与方案对比
通过下表与对比图,我们可以清晰地识别常见错误做法与状态流水线方案在原理和用户体验上的本质差别:
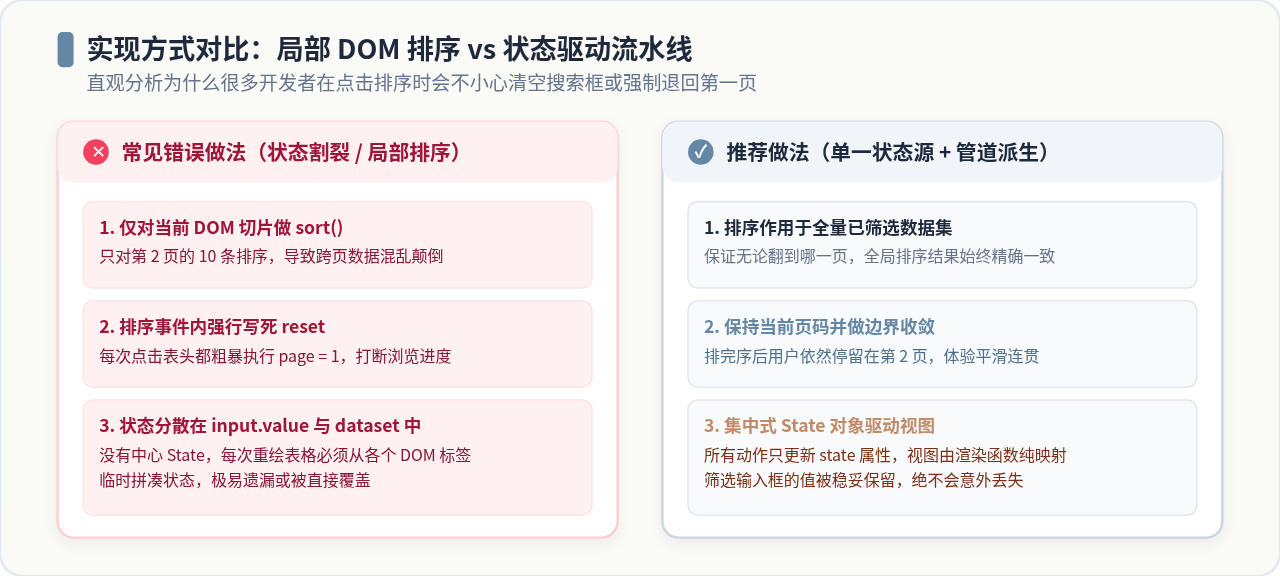
| 对比维度 | 常见错误做法(DOM/局部操作) | 标准做法(单一状态源流水线) |
|---|---|---|
| 排序执行时机 | 在 slice() 截断后对当前页 10 条数据局部排序 |
在 filter() 筛选后、slice() 切片前对全量数据排序 |
| 跨页排序一致性 | 无法保障,翻到下一页后数据大小颠倒混乱 | 全局一致,第 1 页最大值必然小于或等于第 2 页最小值 |
| 排序时页码处理 | 简单粗暴写死 currentPage = 1,打断用户操作 |
平滑保留 currentPage,并做 Math.min 边界保护 |
| 筛选词保护 | 重新渲染后由于无全局状态,输入框内容被重置清空 | 状态对象中始终存有 filterText,输入框稳妥回填保持 |
五、完整可运行的原生 JavaScript 代码示例
下面是一个完整的单文件原生 JavaScript 示例。你可以将其复制到本地任何 HTML 文件中直接在浏览器中打开验证:
<!DOCTYPE html>
<html lang="zh-CN">
<head>
  <meta charset="UTF-8">
  <title>表格排序与分页筛选协同演示</title>
  <style>
    body { font-family: sans-serif; padding: 20px; }
    .toolbar { margin-bottom: 15px; display: flex; gap: 10px; }
    .toolbar input { padding: 6px 12px; width: 220px; }
    table { width: 100%; border-collapse: collapse; margin-bottom: 15px; }
    th, td { border: 1px solid #ddd; padding: 10px; text-align: left; }
    th { background: #f4f6f8; cursor: pointer; user-select: none; }
    th:hover { background: #e5e9f0; }
    .sort-indicator { margin-left: 5px; color: #6487A5; }
    .pagination { display: flex; gap: 6px; align-items: center; }
    .pagination button { padding: 4px 10px; cursor: pointer; }
    .pagination button.active { background: #6487A5; color: #fff; font-weight: bold; border-color: #6487A5; }
  </style>
</head>
<body>

  <div class="toolbar">
    <input id="filterInput" type="text" placeholder="搜索姓名、部门或薪资...">
  </div>

  <table id="dataTable">
    <thead>
      <tr>
        <th data-key="id">ID <span class="sort-indicator"></span></th>
        <th data-key="name">姓名 <span class="sort-indicator"></span></th>
        <th data-key="dept">部门 <span class="sort-indicator"></span></th>
        <th data-key="salary">薪资 <span class="sort-indicator"></span></th>
      </tr>
    </thead>
    <tbody id="tableBody"></tbody>
  </table>

  <div class="pagination" id="pagination"></div>

  <script>
    // 1. 模拟全量数据源(保持只读不可变)
    const RAW_DATA = [
      { id: 101, name: '张小丽', dept: '研发部', salary: 18500 },
      { id: 102, name: '李天宇', dept: '市场部', salary: 12000 },
      { id: 103, name: '王敏', dept: '财务部', salary: 15000 },
      { id: 104, name: '赵强', dept: '研发部', salary: 23000 },
      { id: 105, name: '孙博', dept: '设计部', salary: 14500 },
      { id: 106, name: '钱静', dept: '运营部', salary: 11000 },
      { id: 107, name: '周海洋', dept: '研发部', salary: 21000 },
      { id: 108, name: '吴磊', dept: '研发部', salary: 16500 },
      { id: 109, name: '郑华', dept: '设计部', salary: 17000 },
      { id: 110, name: '冯伟', dept: '市场部', salary: 13500 },
      { id: 111, name: '陈思远', dept: '研发部', salary: 19500 },
      { id: 112, name: '楚云飞', dept: '运营部', salary: 12800 }
    ];

    // 2. 单一状态源
    const state = {
      filterText: '',
      sortKey: 'id',
      sortOrder: 'asc',
      currentPage: 1,
      pageSize: 4
    };

    // 3. 核心流水线计算函数
    function processPipeline(state, data) {
      const text = state.filterText.trim().toLowerCase();
      let list = data.filter(item => {
        if (!text) return true;
        return Object.values(item).some(v => String(v).toLowerCase().includes(text));
      });

      list.sort((a, b) => {
        const vA = a[state.sortKey];
        const vB = b[state.sortKey];
        if (vA === vB) return 0;
        const res = (typeof vA === 'number' && typeof vB === 'number')
          ? vA - vB
          : String(vA).localeCompare(String(vB), 'zh-CN');
        return state.sortOrder === 'asc' ? res : -res;
      });

      const totalItems = list.length;
      const totalPages = Math.max(1, Math.ceil(totalItems / state.pageSize));

      // 边界收敛:防止页码超出
      state.currentPage = Math.min(Math.max(1, state.currentPage), totalPages);

      const start = (state.currentPage - 1) * state.pageSize;
      const sliceData = list.slice(start, start + state.pageSize);

      return { sliceData, totalPages, totalItems };
    }

    // 4. 视图渲染中心
    function render() {
      const { sliceData, totalPages, totalItems } = processPipeline(state, RAW_DATA);

      // 渲染表格主体
      const tbody = document.getElementById('tableBody');
      if (sliceData.length === 0) {
        tbody.innerHTML = '<tr><td colspan="4" style="text-align:center; color:#999;">无匹配数据</td></tr>';
      } else {
        tbody.innerHTML = sliceData.map(item => `
          <tr>
            <td>#${item.id}</td>
            <td>${item.name}</td>
            <td>${item.dept}</td>
            <td>¥${item.salary.toLocaleString()}</td>
          </tr>
        `).join('');
      }

      // 更新表头排序指示符
      document.querySelectorAll('#dataTable thead th').forEach(th => {
        const key = th.getAttribute('data-key');
        const indicator = th.querySelector('.sort-indicator');
        if (key === state.sortKey) {
          indicator.textContent = state.sortOrder === 'asc' ? '▲' : '▼';
        } else {
          indicator.textContent = '';
        }
      });

      // 渲染分页器
      const paginationEl = document.getElementById('pagination');
      let pageHtml = `<span style="margin-right:10px; color:#666;">共 ${totalItems} 条记录</span>`;
      for (let i = 1; i <= totalPages; i++) {
        pageHtml += `<button class="${i === state.currentPage ? 'active' : ''}" data-page="${i}">${i}</button>`;
      }
      paginationEl.innerHTML = pageHtml;
    }

    // 5. 事件绑定:表头排序(维持当前筛选与当前页码)
    document.querySelector('#dataTable thead').addEventListener('click', (e) => {
      const th = e.target.closest('th');
      if (!th) return;
      const key = th.getAttribute('data-key');
      if (state.sortKey === key) {
        state.sortOrder = state.sortOrder === 'asc' ? 'desc' : 'asc';
      } else {
        state.sortKey = key;
        state.sortOrder = 'asc';
      }
      // 排序后保留原有 filterText 与 currentPage
      render();
    });

    // 6. 事件绑定:搜索筛选(此时必须重置为第 1 页)
    let debounceTimer = null;
    document.getElementById('filterInput').addEventListener('input', (e) => {
      clearTimeout(debounceTimer);
      debounceTimer = setTimeout(() => {
        state.filterText = e.target.value;
        state.currentPage = 1; // 筛选条件变更,总页数改变,安全重置为第1页
        render();
      }, 250);
    });

    // 7. 事件绑定:分页点击(仅改变当前页)
    document.getElementById('pagination').addEventListener('click', (e) => {
      if (e.target.tagName !== 'BUTTON') return;
      const page = parseInt(e.target.getAttribute('data-page'), 10);
      if (page && page !== state.currentPage) {
        state.currentPage = page;
        render();
      }
    });

    // 初始化初次渲染
    render();
  </script>
</body>
</html>
六、进阶:利用 URLSearchParams 实现状态持久化
在实际生产环境中,用户往往希望在排序或翻页后,刷新浏览器页面或者把当前链接复制给同事时,表格能丝毫不差地恢复当前的所有条件。
借助浏览器原生的 URLSearchParams 和 window.history.replaceState,可以在不重新加载页面的前提下实时同步浏览器地址栏参数:
// 状态序列化写入 URL 地址栏
function syncStateToURL(state) {
  const params = new URLSearchParams();
  if (state.filterText) params.set('q', state.filterText);
  if (state.sortKey !== 'id') params.set('sort', state.sortKey);
  if (state.sortOrder !== 'asc') params.set('order', state.sortOrder);
  if (state.currentPage > 1) params.set('page', state.currentPage);

  const newUrl = `${window.location.pathname}?${params.toString()}`;
  window.history.replaceState(null, '', newUrl);
}

// 页面初次加载时从 URL 反序列化恢复状态
function loadStateFromURL() {
  const params = new URLSearchParams(window.location.search);
  return {
    filterText: params.get('q') || '',
    sortKey: params.get('sort') || 'id',
    sortOrder: params.get('order') === 'desc' ? 'desc' : 'asc',
    currentPage: parseInt(params.get('page'), 10) || 1,
    pageSize: 10
  };
}
将 syncStateToURL(state) 挂载在统一的 render() 函数尾部,即可在用户任意操作(无论是排序、搜索还是翻页)后,令地址栏与当前表格状态毫秒级无缝同步。
七、总结与落地检验准则
JavaScript 表格排序后保持分页与筛选状态,本质上不是一个算法复杂度问题,而是一个**架构数据流向的设计问题**。
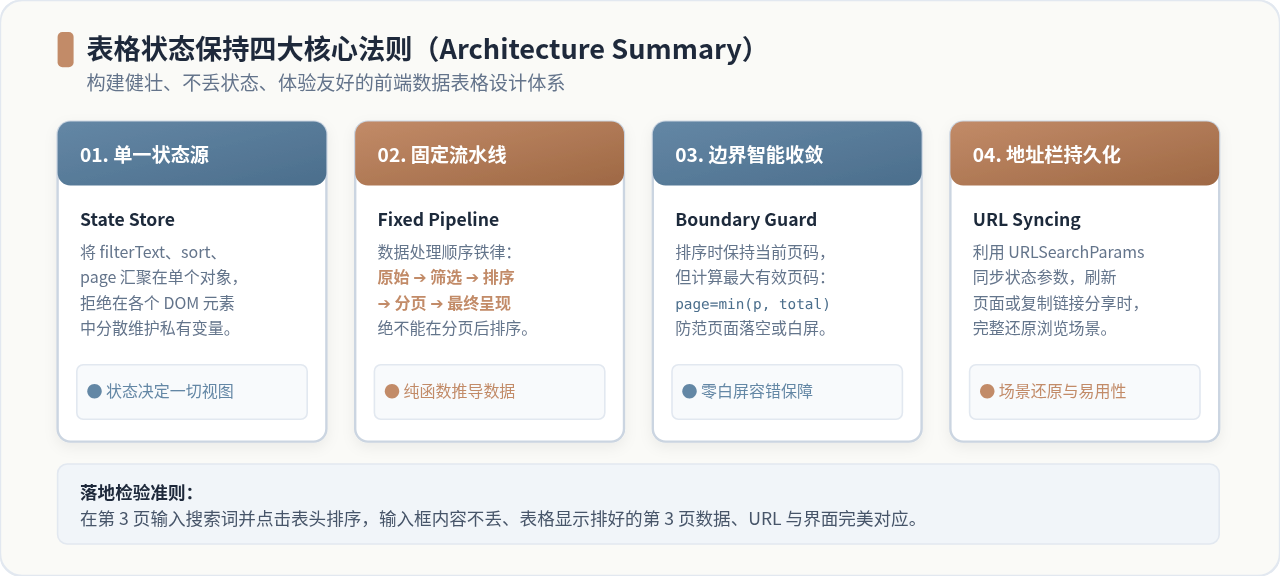
上线前自查 Checklist:
- 筛选状态保留:在搜索框中键入关键字(例如“开发部”),点击任何表头列进行升降序切换,搜索框文本未被重置,筛选结果未被还原。
- 翻页位置保持:翻到第 3 页后点击表头排序列,页面依然停留在第 3 页,展示的是全量数据排序后位于第 3 页的记录区间。
- 跨页一致性:上一页的最后一条数据与下一页的第一条数据在排序列上大小关系严格递增/递减。
- 边界收敛保护:清除搜索词或更换筛选条件导致总页数从 5 页缩减至 2 页时,页码能平滑收敛到有效区间,杜绝出现空白内容。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章