

llama.cpp b12484、b12485、b12487、b12488 均为预发布构建。 预发布构建的变更范围并不相同。数据格式、运算类型、输入规模和显卡架构共同决定哪些改动与当前工作负载相关。
llama.cpp b12484、b12485、b12487、b12488 的预发布范围怎么看?
作者:百宝袋
时间:2026-11-18
浏览:592
文章目录
预发布构建的变更范围并不相同。数据格式、运算类型、输入规模和显卡架构共同决定哪些改动与当前工作负载相关。
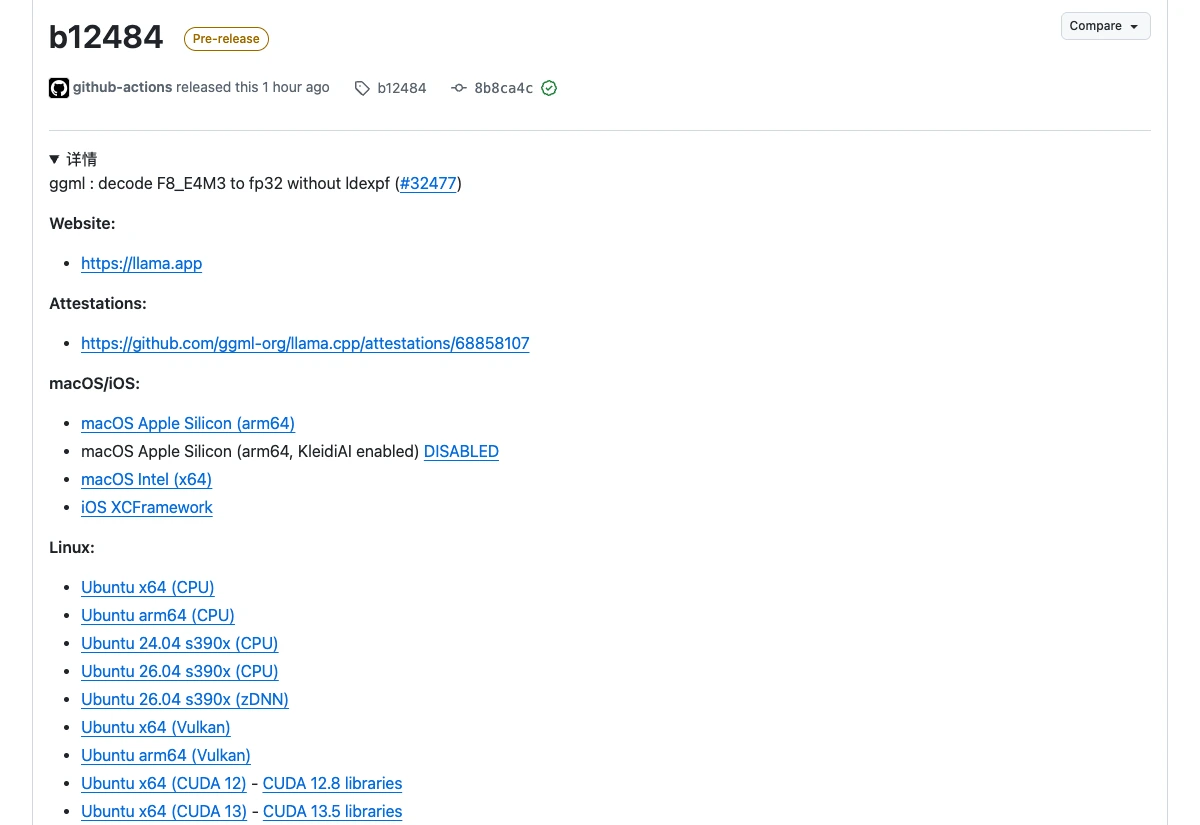
b12484 的浮点转换维护
llama.cpp b12484 调整 F8_E4M3 解码到 fp32 的实现,采用不依赖 ldexpf 的转换路径。该构建的说明对应浮点格式转换,实际表现仍取决于所用路径。
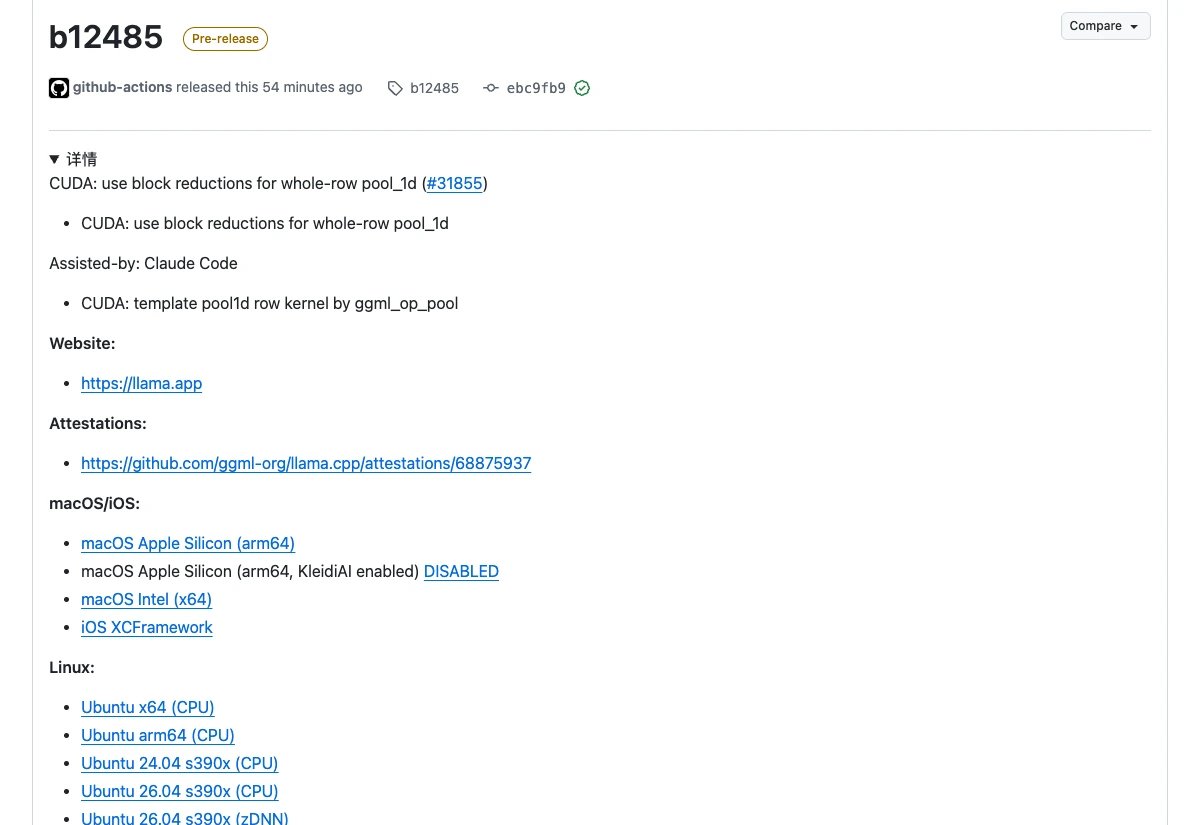
b12485 的整行池化路径
b12485 在 CUDA 的 whole-row pool_1d 路径使用块归约,并按池化操作对行内核进行模板化。适用对象是这条 CUDA 池化实现,其他后端的池化行为需独立判断。
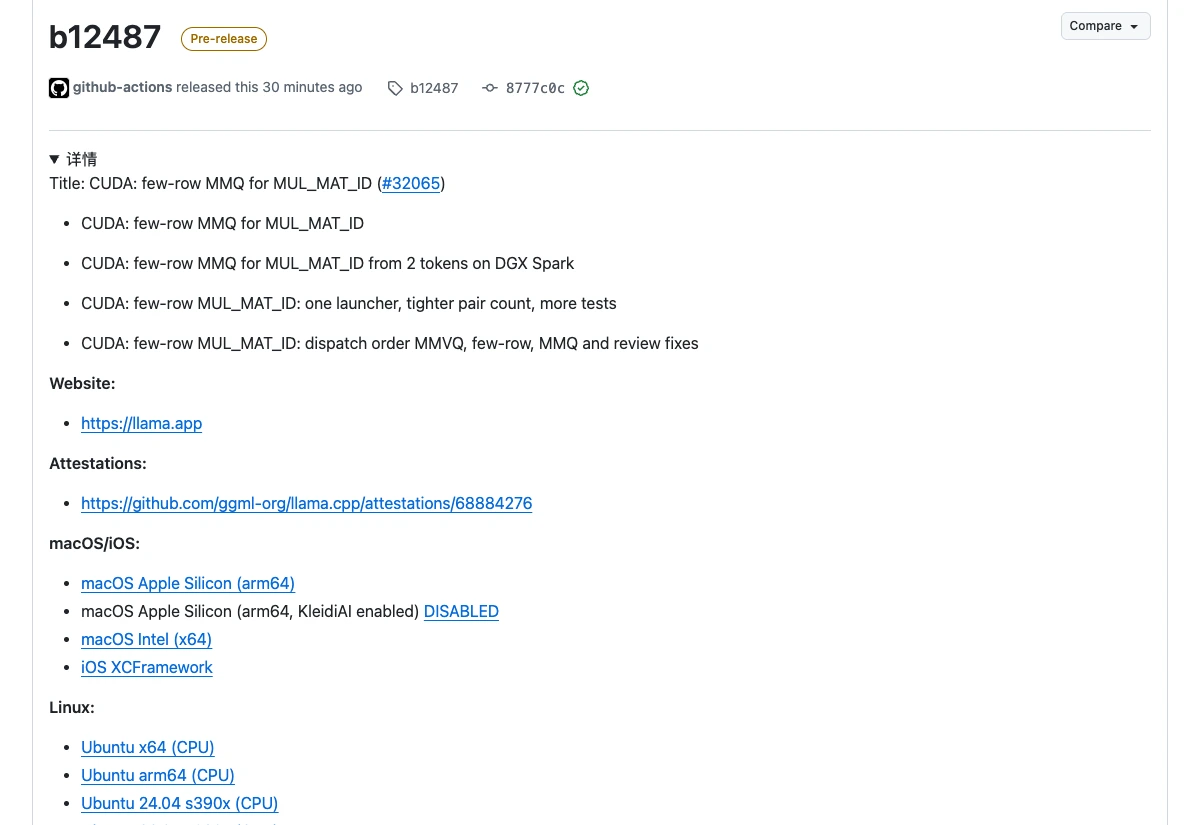
b12487 的少行矩阵计算
b12487 为 CUDA 的 MUL_MAT_ID 增加 few-row MMQ 路径,并调整启动与分发顺序。官方说明包含 DGX Spark 上从两个 token 起的处理分支,评估时需要关注具体硬件与输入规模。
b12488 的 Pascal 融合限制
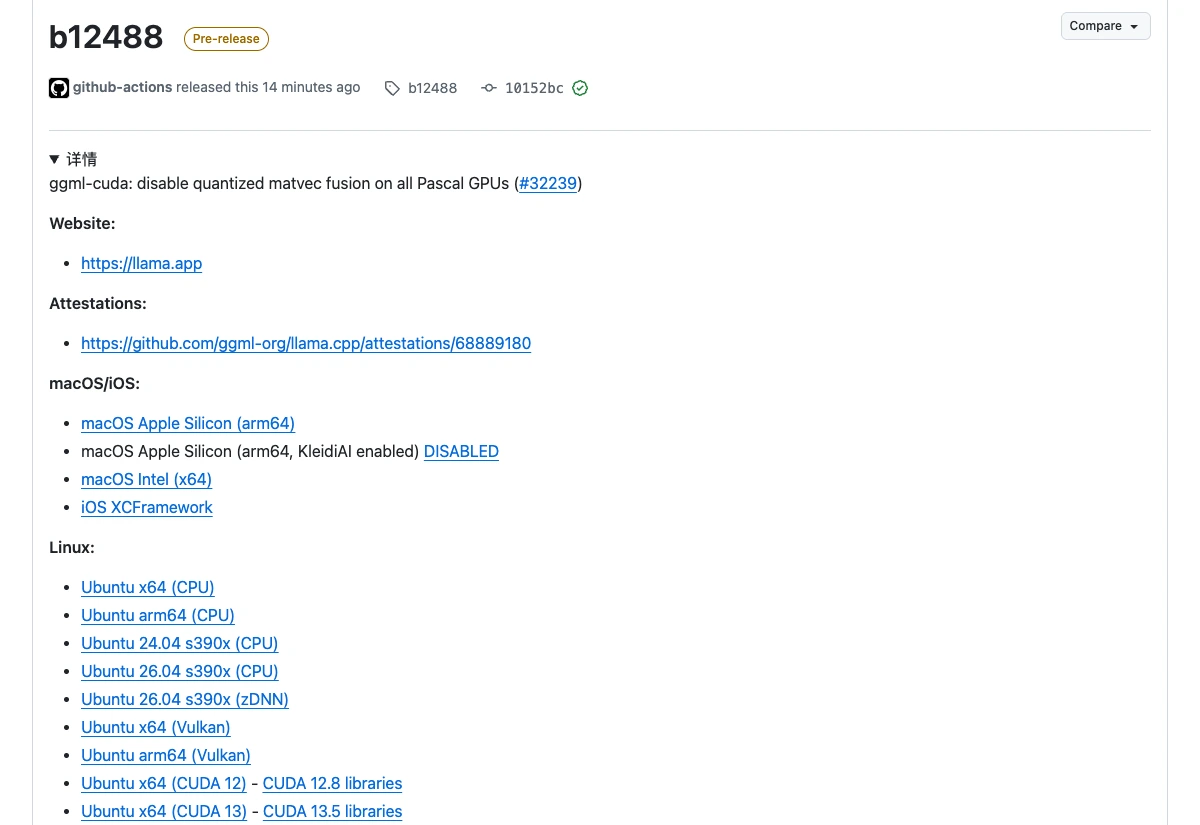
b12488 在所有 Pascal GPU 上禁用量化 matvec 融合,范围是该架构下对应的量化矩阵向量计算路径。四个构建都已作为预发布公开,实际采用仍需按数据类型、后端、显卡与运算范围核对。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章