

llama.cpp b12477 调整了多阶段 CUDA 内核读取 K/V 分块的顺序。这个优化涉及缓存复用,长前缀任务的实测结果需要按测试条件来读。
llama.cpp b12477 的 K/V 分块读取顺序和长上下文有什么关系?
作者:小满
时间:2026-11-18
浏览:657
文章目录
改变的是哪一段读取逻辑
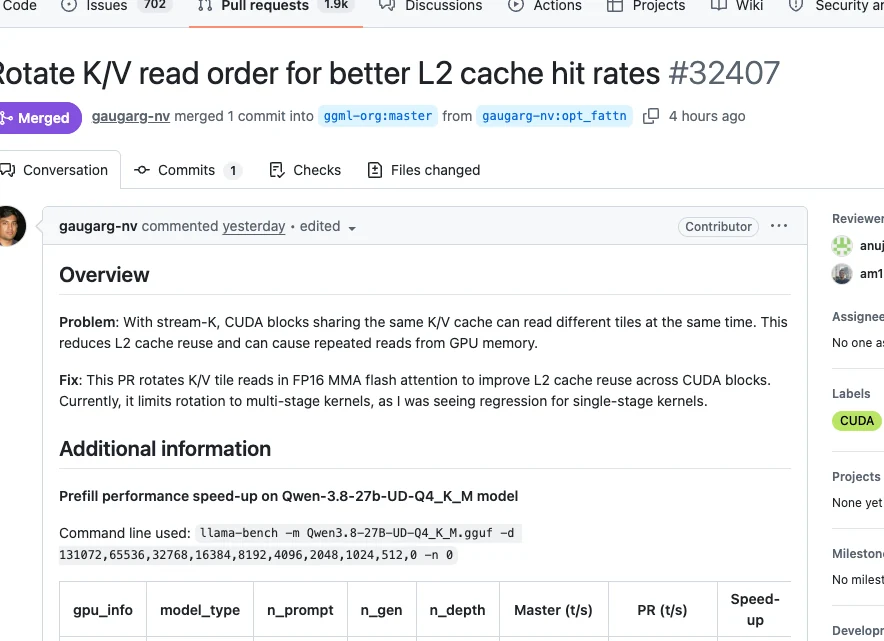
使用 stream-K 时,共享同一 K/V 缓存的 CUDA 线程块可以同时读取不同的分块,从而减少二级缓存的复用机会。b12477 的实现为多阶段 FP16 MMA Flash Attention 调整分块读取顺序,使不同线程块更容易重用现有缓存。
哪些内核不在这次改动范围内
维护者在单阶段内核中观察到退化,因此未把轮转策略用于单阶段。发布提供了不同平台的构建,但该优化针对 CUDA 的特定注意力计算路径。仅凭是否用了 b12477 无法推导出 CPU、其他 GPU 后端或所有 CUDA 调用都会获益。
如何解读维护者的长上下文基准
维护者在 GeForce RTX 5090 和 Qwen3.8-27B-UD-Q4_K_M.gguf 上给出预填充对照。表中 131072 和 65536 的深度下提升明显,多个较短深度的成绩近似持平。表中数值属于这套 GPU、模型及预填充条件,不代表其他模型或生成阶段的统一加速比。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章