

llama.cpp b12474 修改 Qwen3-Next 的线性注意力输出投影,令矩阵乘法调用接收已有的 ssm_out_s。这样缩放与当前层的输出权重对应。
llama.cpp b12474 的 Qwen3-Next 输出投影如何纳入缩放张量?
作者:开源拾贝
时间:2026-11-17
浏览:465
文章目录
先得到注意力输出,再进入投影
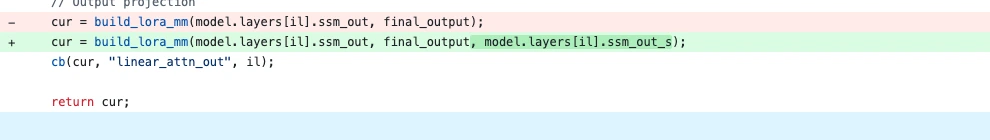
线性注意力计算先生成 final_output。随后用 ssm_out 投影,调用的结果仍作为 linear_attn_out 记录。变化发生在投影调用参数。
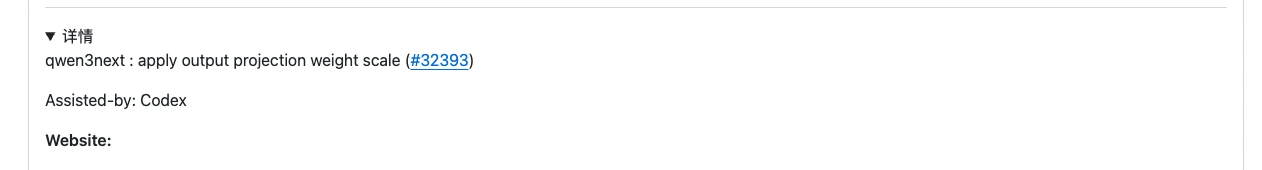
代码差异中的新增参数
在 build_layer_attn_linear 里,build_lora_mm 现在多接收 model.layers[il].ssm_out_s。这对应不同层各自持有的权重缩放。
运行范围看构建和架构
llama.cpp b12474 为预发布构建。该说明只核实 Qwen3-Next 的此处计算路径,公告未附推理效果比较。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章