

llama.cpp b12429代码标签修复Ripple DFlash2的NoPE元数据转换。此前直接把no_rope_layers逐项转为布尔值,新逻辑在列表长度不等于层数时将其视为层索引,逐层生成rope_pattern;它修正表示方式,不等同于已经提供所有平台的预编译包。
llama.cpp b12429代码标签怎么处理Ripple DFlash2的no_rope_layers
作者:键盘侠
时间:2026-11-16
浏览:478
文章目录
问题出在把层索引当成逐层标记
旧逻辑直接对no_rope_layers中的每一项应用bool,再把结果写为rope_pattern。如果列表本来表达的是每一层的标记,输出长度与层数可以对应;但如果列表只保存少量NoPE层的索引,直接逐项转换就既没有展开到完整层数,也失去了索引所代表的位置。
b12429对应提交把这两种情况分开:列表长度等于block_count时,仍按逐项布尔转换;其他情况下,遍历从0到block_count减1的所有层索引,用“当前索引不在no_rope_layers中”生成对应值,再调用add_rope_pattern写入GGUF。
Ripple DFlash2的实际配置说明了什么
该提交引用固定模型配置中的no_rope_layers为[4],num_hidden_layers为5。转换器的block_count从包括num_hidden_layers在内的层数字段解析,所以这里涉及五个层位置,而不是把列表里的数字4当作一个独立布尔标记。
按新逻辑,索引0、1、2、3不在[4]中,对应True;索引4在名单内,对应False,得到长度为5的rope_pattern。旧的逐项bool转换面对同一列表只会得到[True]。两者差异是元数据长度与对应层位置,不能直接等价为某个固定性能差值。
怎样核对这段映射的含义
以下示例适用于已有Python 3的环境,使用提交所引用模型配置中的两个实际值,单独演示层索引展开逻辑。它不加载模型、不转换权重,也不验证任何硬件上的推理结果。
block_count = 5
no_rope_layers = [4]

rope_pattern = [
    i not in no_rope_layers
    for i in range(block_count)
]
print(rope_pattern)
print(sum(rope_pattern), len(rope_pattern))
该映射的预期结果为[True, True, True, True, False],两项计数分别为4和5。这对应四个True标记及五个总层位置。示例只复现修正分支的布尔映射;实际GGUF生成仍属于完整转换器的职责。
模型配置另有num_target_layers为80,它与这里转换器解析的五层不能混为一谈。把目标模型层数直接代入这个例子,会改变要解释的数据对象,也就无法说明这个特定元数据修正。
为什么这不是所有模型的通用升级结论
这次提交修改conversion/base.py中的一段参数处理,明确针对Ripple DFlash2 NoPE元数据。它没有提供可据以宣传的通用速度、显存、质量或上下文长度测量,也不能证明其他模型的转换问题同时得到解决。
理解影响范围时,应同时保留模型配置形式、转换器代码和生成的rope_pattern三者的对应关系。文件能被写出与元数据表达正确是不同的检查对象;单纯看到转换过程结束,不能解释层索引是否被正确展开。
代码标签与二进制发行状态怎样区分
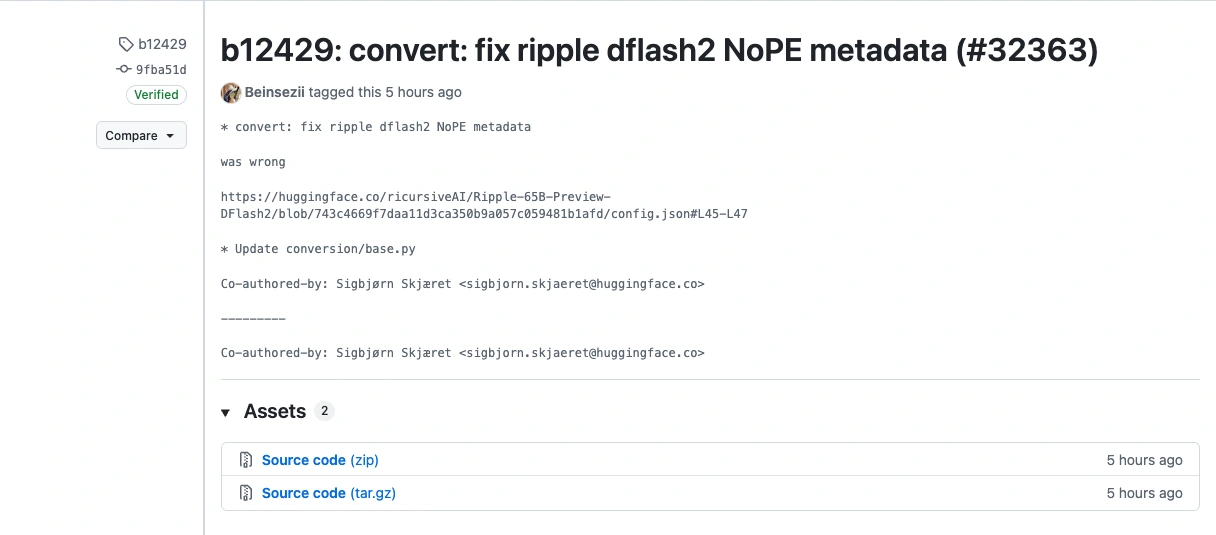
b12429页面将这次记录显示为代码标签,关联提交为9fba51d2c9a1b5cb5f0c47986c031334e2d7663a,页面可见的是Source code压缩归档。这证明对应代码可以按标签定位,不等于已为Windows、macOS、CUDA或其他平台发布可直接使用的预编译安装包。
因此,b12429应按准确代码标签和这项转换修正讨论。上轮b12420、b12424、b12426和b12428分别涉及其他模型或模板变化,不能把那些构建的下载列表、运行方式或验证结果移作b12429预编译包存在的证明。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章