
全面解析Node.js的应用全景:从独立后端服务、高并发API、BFF中间层,到现代前端工程化工具链、自动化脚本与跨平台桌面应用,带你清晰了解Node.js的核心能力、运行机制与技术选型边界。

当前位置:首页 > Node.js 基础 > 正文
Node.js能做什么?从Web服务器到前端工具链的应用全景
作者:慢半拍
时间:2026-11-13
浏览:654
文章目录
一、Node.js 的底层能力:为什么它能跳出浏览器进入服务端?
很多开发者在初学时常有一个疑问:JavaScript 原本只在浏览器里控制 DOM 和动画,为什么在服务器上能处理数以万计的并发请求并读写数据库?要理解这一点,必须厘清 Node.js 的运行底座由哪几部分组成。
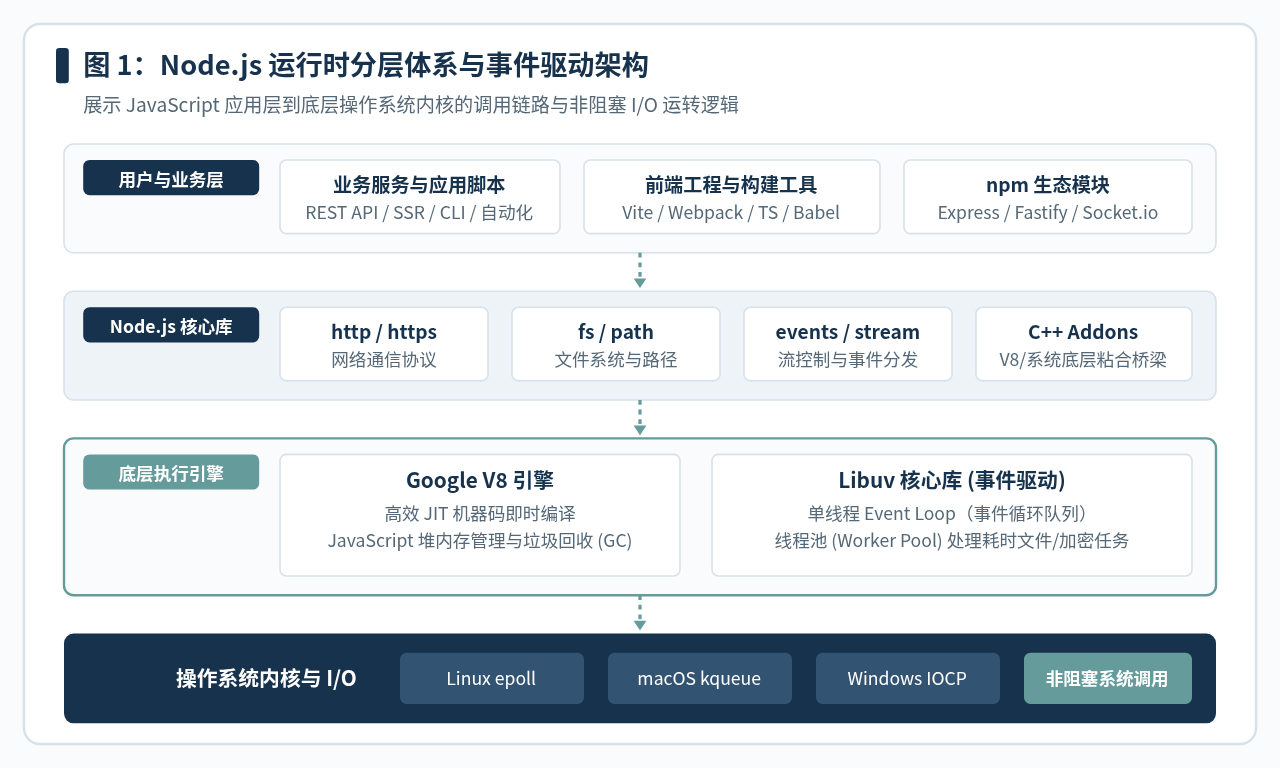
Node.js 本质上由三大部分结合而成:
- Google V8 引擎:负责将 JavaScript 源代码解析为抽象语法树(AST),并通过 JIT(即时编译)机制直接编译为高效的机器码执行,保障代码执行的高性能。
- Libuv 异步 I/O 库:跨平台的 C 语言底层库,封装了 Linux 上的
epoll、macOS 上的kqueue以及 Windows 上的IOCP。它维护了一个单线程的事件循环(Event Loop),并通过底层线程池处理耗时的文件 I/O、DNS 解析与加解密任务。 - C++ 绑定与核心内置库:提供了
http、fs(文件系统)、net、stream等系统级模块,使得 JavaScript 代码通过一套简洁的 API 即可直接操纵网络套接字与磁盘存储。
传统的服务端架构(如早期的 Apache 或经典多线程模型)通常采用“一个请求对应一个系统线程”的模式。当客户端数量增加时,每个线程都需要占用独立的栈内存(通常为 1MB 到几兆字节),大量线程之间的上下文切换开销也会迅速拖垮 CPU。而 Node.js 采用了单线程主事件循环 + 非阻塞异步 I/O 的设计。主线程仅负责分发事件、接收请求和执行轻量逻辑,耗时的网络与磁盘等待全部委托给操作系统内核。当 I/O 完成后,内核再通过回调通知主线程处理后续逻辑。这一机制赋予了 Node.js 单机支撑数万长连接与高并发吞吐的天然优势。
二、核心场景一:作为独立的 Web 服务器与 API 网关
在后端服务领域,Node.js 并不是一个单纯的“脚本解释器”,而是被广泛应用于生产环境的高性能服务器运行时。它的应用形态主要集中在以下三个典型方向:
1. 高性能 RESTful API 与微服务
由于 Node.js 原生以 JavaScript 运行,而 Web 传输的标准数据格式恰好是 JSON,因此在接收请求和响应数据时,Node.js 避免了传统强类型语言频繁的对象反射与复杂序列化成本,数据吞吐格外轻快。搭配 Express、Fastify 或 NestJS 等框架,能够极速搭建轻量微服务与数据分发网关。
下面是一个使用 Node.js 原生 node:http 模块编写的微型 API 服务,能够处理 GET 请求获取系统状态,以及 POST 请求接收 JSON 报文:
// server.mjs
import http from 'node:http';

const PORT = 3000;

const server = http.createServer(async (req, res) => {
  const { method, url } = req;

  // 统一响应 JSON 辅助函数
  const sendJson = (statusCode, data) => {
    res.writeHead(statusCode, { 'Content-Type': 'application/json; charset=utf-8' });
    res.end(JSON.stringify(data));
  };

  // 路由 1:健康检查接口 GET /api/health
  if (method === 'GET' && url === '/api/health') {
    return sendJson(200, {
      status: 'ok',
      uptime: process.uptime(),
      nodeVersion: process.version
    });
  }

  // 路由 2:数据提交接口 POST /api/echo
  if (method === 'POST' && url === '/api/echo') {
    let body = '';
    req.on('data', chunk => { body += chunk; });
    req.on('end', () => {
      try {
        const payload = JSON.parse(body || '{}');
        sendJson(200, { received: payload, timestamp: Date.now() });
      } catch (err) {
        sendJson(400, { error: 'Invalid JSON payload' });
      }
    });
    return;
  }

  // 未匹配路由
  sendJson(404, { error: 'Not Found' });
});

server.listen(PORT, () => {
  console.log(`[API Server] Running at http://localhost:${PORT}`);
});
在终端中启动并验证上述服务:
# 启动服务
node server.mjs
控制台输出示例
[API Server] Running at http://localhost:3000
# 使用 curl 测试健康检查接口
curl -X GET http://localhost:3000/api/health
接口返回示例
{"status":"ok","uptime":4.1205,"nodeVersion":"v20.11.0"}
2. 实时通信与长连接系统
在线协作文档(如协同表格、白板)、即时聊天通讯、在线多人游戏状态同步、物联网设备监控大屏等业务场景,需要服务器维持海量的长连接(WebSocket 或 SSE)并进行低延迟的消息广播。如果采用传统线程模型,维护 5 万个空闲连接可能耗费几十 GB 内存,而 Node.js 的事件循环只在有数据流动时才消耗计算资源,单台 4 核 8G 服务器即可平稳维持数万到十万级别的并发连接。
3. BFF 层(Backend for Frontend)与服务端渲染(SSR)
现代大型企业系统的底层通常是由 Java、Go 或 C++ 编写的分布式微服务。但是移动端、Web 端、小程序对接口的数据格式、字段粒度需求千差万别。如果直接让前端调用底层微服务,不仅会导致客户端发送大量碎片化请求,还会暴露内部安全拓扑。
Node.js 是最理想的 BFF 适配层:前端团队可以使用熟悉的 JavaScript/TypeScript 自主开发 BFF,在一个节点上并行聚合 5 个微服务的数据,裁剪多余字段,组合成一个干净的接口返回给前端。此外,Next.js、Nuxt 等现代框架的服务端渲染(SSR)能力也全部依赖 Node.js,它在服务端直接运行组件逻辑,将完整的 HTML 字符串输出给爬虫和首屏用户,彻底解决了单页应用(SPA)的首屏白屏和 SEO 难题。
三、核心场景二:前端工程化与现代工具链的基石
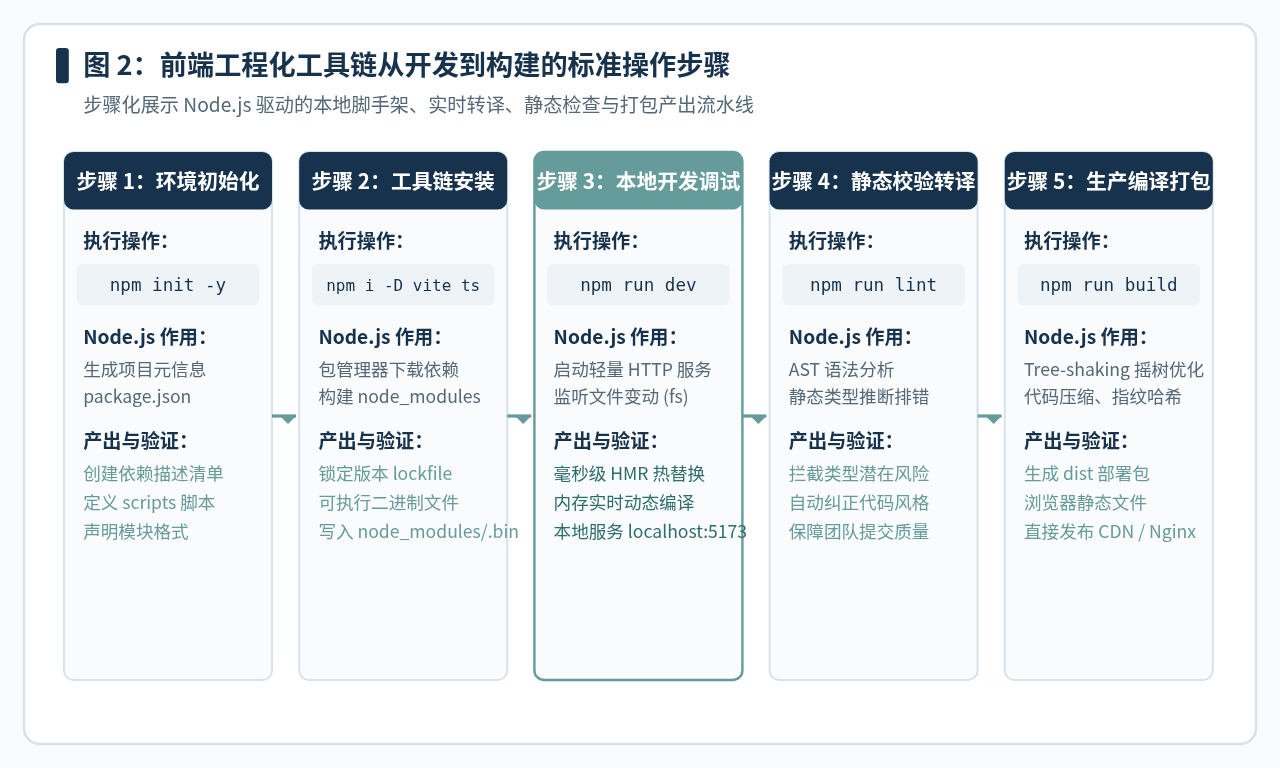
许多开发者在开发 Vue、React 等前端项目时,只在浏览器中看到最终效果,却忽略了一个根本事实:现代前端的所有代码,在被浏览器加载之前,几乎 100% 都是在 Node.js 环境中生产出来的。
现代 Web 已经告别了手工编写单个 HTML 并在 <script> 标签里罗列几百个 JS 文件的时代。现代前端项目依赖一套高度复杂的工程化工具链,而 Node.js 就是这套工具链的发动机:
1. 模块打包与本地极速开发服务器
浏览器并不天然认识 .vue、.jsx 文件,也不支持大型项目成百上千个模块的复杂依赖分析。像 Vite、Webpack、Rollup、esbuild 这类工具,通过 Node.js 读取本地源码,解析模块依赖图谱,并在本地启动一个具备模块热替换(HMR)功能的 HTTP 开发服务器。当开发者修改一行代码并保存时,Node.js 毫秒级捕获文件变化,将增量编译后的补丁推送到浏览器,无需刷新页面即可直接看到更新。
2. 语法转译与静态类型系统
TypeScript 已经成为前端开发的事实标准。然而,浏览器原生并不认识类型注解,所有的 interface、泛型和类型断言,都必须通过 Node.js 运行的 TypeScript 编译器(tsc)或 Babel / SWC 进行静态类型推导,剔除类型声明,将前沿的 ESNext 语法安全降级为所有目标浏览器均能正常运行的通用 ECMAScript 规范。
3. 代码规范治理与自动化流水线
在多人协作团队中,代码风格统一和质量防御尤为关键。基于 Node.js 运行的 ESLint 会遍历源码的抽象语法树(AST),发现潜在的逻辑 Bug(如未定义变量、异步逻辑未处理等);Prettier 负责自动化换行与排版;配合 Husky 在 Git commit 时自动拦截违规代码,确保只有合规代码能够合入主干分支。
四、核心场景三:命令行工具、自动化脚本与跨平台桌面应用
除了 Web 服务与前端编译,Node.js 凭借其对系统文件、进程和终端输入的完整控制力,在系统自动化与桌面应用开发中也占据了不可替代的位置。
1. 命令行交互工具(CLI)与脚手架
在日常开发中,输入 npm create vite@latest 或 npx git-cz 就能弹出带交互式箭头选择、颜色高亮提示的命令行终端,这完全得益于 Node.js 丰富的终端库生态(如 Commander.js、Inquirer、Chalk)。团队可以将日常繁琐的项目模板搭建、接口模型代码生成、多环境切换打包封装成统一的 CLI 工具,发布到内部 npm 私有仓库供全员使用。
2. 自动化批处理与 DevOps 运维脚本
过去运维与批处理任务主要依赖 Bash 脚本或 Python。对于前端与 JavaScript 开发者而言,直接用 Node.js 编写批处理任务更加得心应手。无论是多语言 i18n 文件的自动化提取与合并、图片静态资源的批量无损压缩、CDN 缓存刷新脚本,还是利用 Puppeteer 启动无头浏览器进行页面自动化截图和端到端测试,Node.js 都能在几十行代码内高质交付。
3. 跨平台桌面客户端开发(Electron / Tauri 扩展)
桌面软件开发曾受限于各操作系统的原生 UI 框架(Windows MFC/WPF、macOS Cocoa、Linux GTK)。Electron 的诞生彻底改变了这一格局。它的核心设计理念是:Chromium 浏览器内核负责渲染精美且跨平台的 Web 界面,Node.js 负责主进程与操作系统原生底层沟通(如系统托盘、读写本地私有文件、注册全局快捷键、调用 C++ 硬件驱动等)。如今人们每天都在使用的 Visual Studio Code、Slack、Postman、Figma 桌面版、Discord,其底层均深度集成了 Node.js 的能力。
五、实践验证:上手验证 Node.js 双重角色的可复现步骤
为了直观感受 Node.js 在“Web 服务”与“前端工程化”两个维度的实际运作方式,以下提供两个极简且完全可复现的操作实验。确保本地已安装 Node.js(推荐 LTS 版本,如 v18 或 v20 及以上)。
准备工作:检查运行环境
在终端执行 node -v 与 npm -v,确认输出版本号。若未安装,可从官网下载或通过 nvm 安装。
实验 A:快速启动一个原生 Web 静态资源服务
- 新建空目录并进入:
mkdir demo-server && cd demo-server - 创建
index.html文件,写入简单页面:echo "<h1>Hello from Node.js Web Server!</h1>" > index.html - 无需安装任何第三方库,直接使用一行 Node.js 脚本启动本地 HTTP 服务:
node -e "const http=require('http'),fs=require('fs');http.createServer((q,s)=>{s.writeHead(200,{'Content-Type':'text/html;charset=utf-8'});fs.createReadStream('index.html').pipe(s);}).listen(8080,()=>console.log('Server: http://localhost:8080'));"
运行验证示例
Server: http://localhost:8080
在浏览器访问 http://localhost:8080 即可看到 "Hello from Node.js Web Server!"。
在浏览器访问 http://localhost:8080 即可看到 "Hello from Node.js Web Server!"。
实验 B:感受前端工具链的打包全过程
- 新建前端测试工程目录:
mkdir demo-toolchain && cd demo-toolchain - 初始化项目描述文件并安装 Vite 构建工具:
npm init -y npm i -D vite - 创建
index.html与main.js源码:echo '<!DOCTYPE html><html><body><script type="module" src="./main.js"></script></body></html>' > index.html echo 'console.log("Toolchain test: " + (2 ** 3));' > main.js - 运行生产构建命令:
npx vite build
打包输出示例
vite v5.0.0 building for production...
transforming...
✓ 2 modules transformed.
dist/index.html 0.31 kB │ gzip: 0.22 kB
dist/assets/index-D7h51_L2.js 0.05 kB │ gzip: 0.07 kB
✓ built in 48ms
transforming...
✓ 2 modules transformed.
dist/index.html 0.31 kB │ gzip: 0.22 kB
dist/assets/index-D7h51_L2.js 0.05 kB │ gzip: 0.07 kB
✓ built in 48ms
检查目录可以发现,Node.js 自动生成了 dist/ 产物目录,完成了文件名指纹哈希、代码体积统计与静态优化。这就是现代前端工具链的最简缩影。
开发常见陷阱与排查提醒:
- 端口冲突 (EADDRINUSE):当提示
listen EADDRINUSE: address already in use :::3000时,说明 3000 端口已被其他进程占用,可通过lsof -i :3000找到对应 PID 并关闭,或修改代码中的端口常量。 - CommonJS 与 ESModule 语法冲突:若在
package.json中没有声明"type": "module",直接在.js文件中使用import/export会触发语法报错。解决方式是在package.json中加入"type": "module",或者将文件后缀明确命名为.mjs。
六、Node.js 的能力边界与技术选型决策
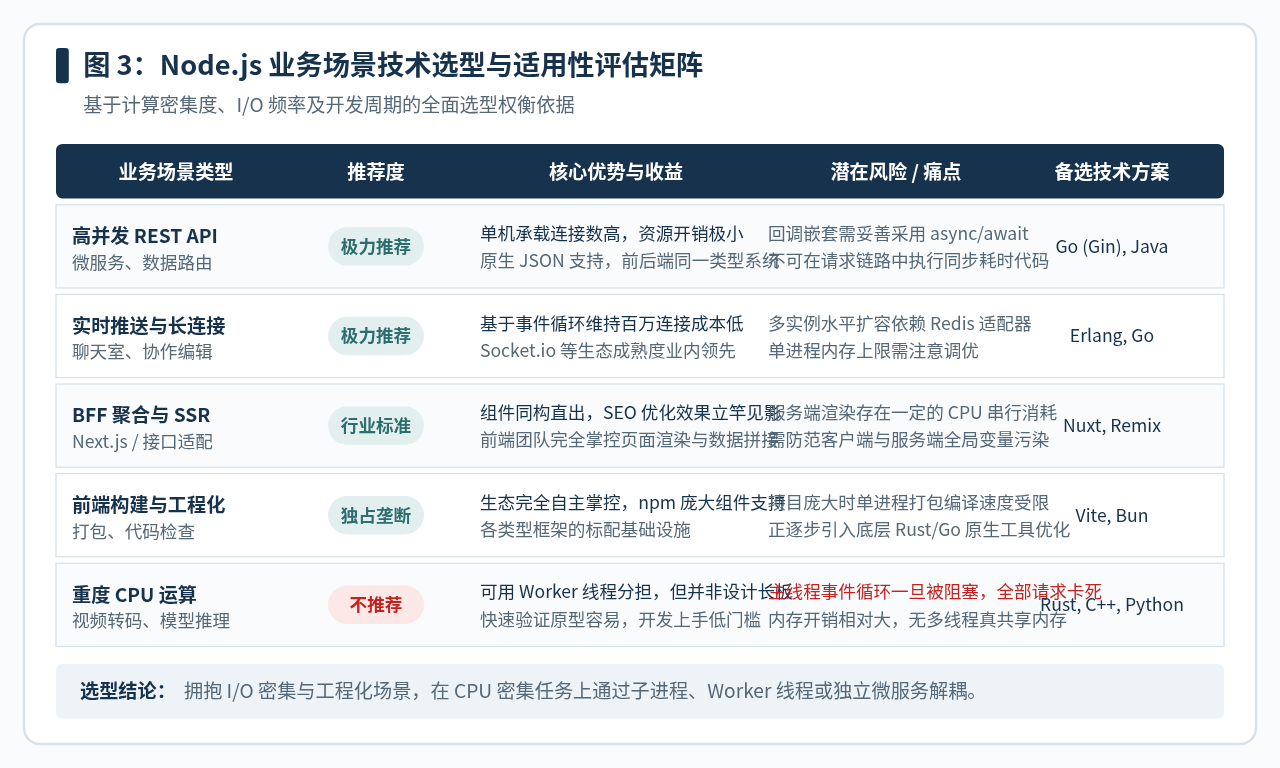
没有一种技术是万能的。Node.js 的优势极其突出,但其独特的单线程事件驱动模型也直接决定了它的绝对短板。在进行架构选型时,必须清楚它的长处与局限。
Node.js 最擅长的场景(优势区)
- I/O 密集型的高并发 Web API:数据库 CRUD 操作频繁、网络请求多、业务计算相对简单的场景。
- 实时双向通讯应用:聊天室、消息推送平台、多人协作编辑软件。
- 前端基础设施与工程化流水线:几乎没有任何技术能够动摇 Node.js 在这一领域的支配地位。
- BFF 接口适配层与 SSR 服务端渲染:前后端数据解耦和单页应用首屏优化。
Node.js 不擅长甚至应避免的场景(风险区)
- 重度 CPU 计算密集型任务:例如高清晰度视频格式转码、大规模 3D 图形渲染、复杂的科学数值计算、机器学习模型本地推理。因为 Node.js 的业务主逻辑由单线程承载,一旦某个请求触发了一个耗时 3 秒的循环运算,主线程将无法响应事件循环中的任何其他网络请求,导致整个服务器陷入假死。
- 强依赖多线程共享内存的底层系统:Node.js 虽然提供了
worker_threads模块,但相比 C++、Rust 或 Go 原生的一级多线程支持,在内存调度与线程间数据通信上依然有额外开销。
七、全景总结与知识脉络
回看全文,Node.js 绝不仅仅是“运行在后端的 JavaScript”,它重新定义了现代软件开发的协作边界。通过打通前后端语言屏障,Node.js 实现了两大层面的深刻统一:
- 语言与思维方式的统一:全栈工程师可以使用同一种语法、同一种数据格式(JSON)和同一套包管理器(npm)在客户端、服务端和桌面端自由切换,大幅消除了上下文切换成本与团队沟通损耗。
- 从运行时到工程化交付的闭环:Node.js 既是终端生产环境中的业务服务器,也是开发阶段构建、测试、打包的前端数字工厂。
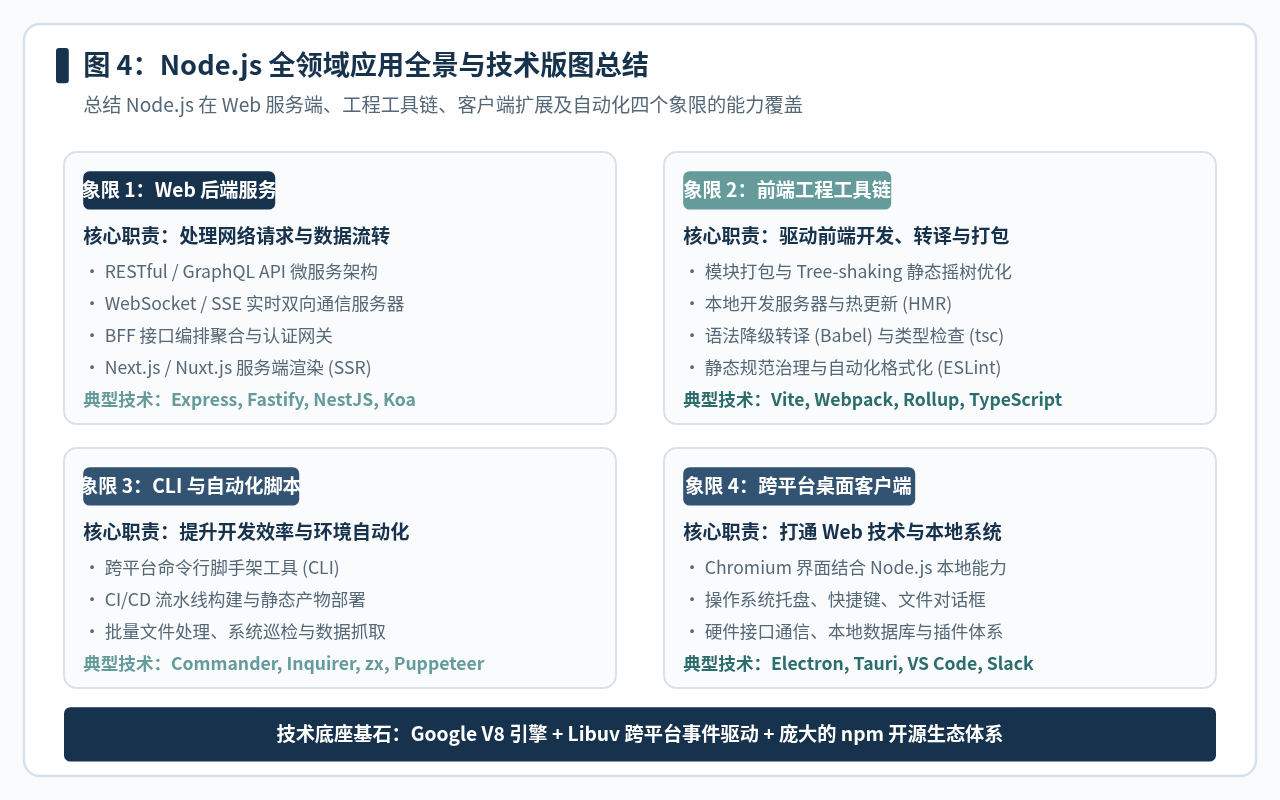
在技术选型时,最成熟的策略是“扬长避短”:在 Web 接口层、BFF 聚合、实时通信和前端构建中坚决选用 Node.js;当系统遇到超大型 CPU 计算密集型瓶颈时,通过微服务或子进程委派给 Go、Rust、C++ 或 Python 处理,从而构建出既具备极高交付效率、又具备高稳定性的现代化分布式架构。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章