

深入解析React Router 7中loader与action的使用方法、数据流转机制及与6.x的核心差异,包含代码实操、自动重新验证流程及迁移避坑要点。
ReactRouter7的loader和action怎么用?和6.x差别在哪?
作者:远帆
时间:2026-11-12
浏览:627
文章目录
React Router 7
数据路由 (Data APIs)
适用场景:现代 React 单页应用及全栈架构
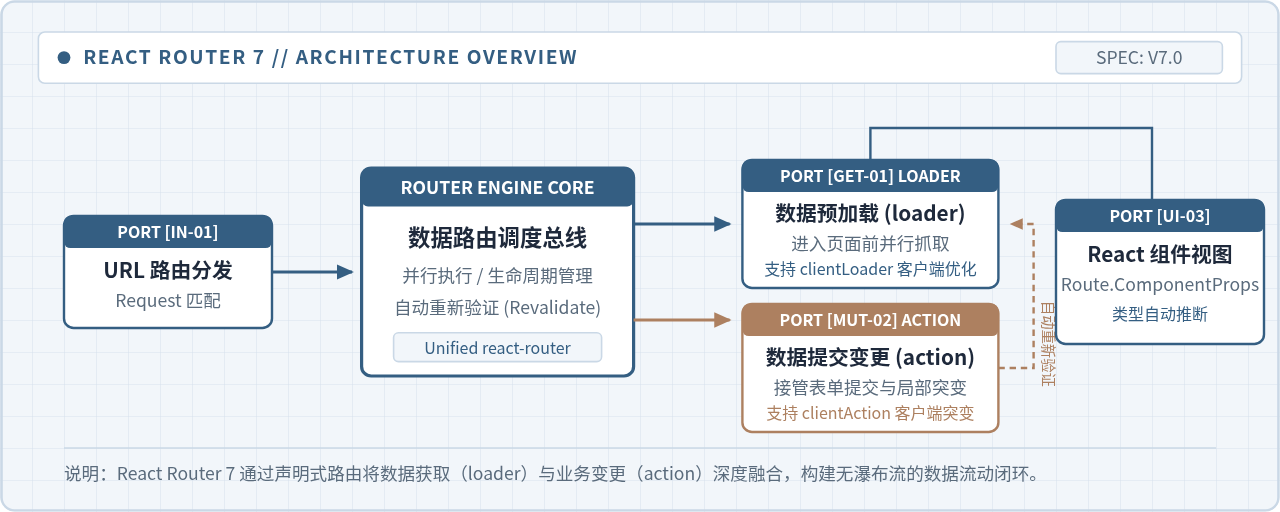
在 React Router 7 中,
loader 用于在组件渲染之前并行准备好只读数据(对应 HTTP GET),而 action 用于集中处理表单提交与数据变更(对应 HTTP POST/PUT/DELETE)。两者的配合彻底消除了传统 useEffect 导致的请求瀑布流与重复刷新状态。与 6.x 相比,7.x 将 Remix 全面合并,统一收敛为单一的 react-router 依赖,带来了基于代码生成的全自动 TypeScript 类型推导,并新增了原生支持客户端离线缓存与拦截的 clientLoader / clientAction。本文将结合完整示例、数据流拓扑与避坑要点,逐一拆解其实际用法与升级差异。
一、Loader 的作用机制与实际用法
在传统的 React 开发中,通常是在组件挂载后通过 useEffect 发起请求,随后通过 useState 存储数据。这种方式容易造成页面初次渲染时的“空白闪烁”,以及父子嵌套组件连续触发的“请求瀑布流”。
React Router 7 的 loader 在路由匹配完成后、组件真正挂载前立即执行。它直接运行在路由层,支持并行拉取嵌套子路由的数据,等数据准备完毕后再呈递视图。
1. 基础用法:在路由定义中配置 loader
在轻量级库模式(Library Mode)下,我们使用 createBrowserRouter 配置路由,并通过 useLoaderData 在组件中消费数据:
import { createBrowserRouter, RouterProvider, useLoaderData } from "react-router";

// 1. 定义数据加载函数
async function userLoader({ params, request }) {
  const url = new URL(request.url);
  const keyword = url.searchParams.get("q") || "";

  // params 包含动态路由参数,如 :userId
  const res = await fetch(`/api/users/${params.userId}?keyword=${keyword}`, {
    signal: request.signal, // 支持用户快速跳转时自动中止未完成的请求
  });

  if (!res.ok) {
    // 抛出 Response 会被路由层的 ErrorBoundary 自动捕获
    throw new Response("用户数据不存在", { status: 404 });
  }

  return res.json();
}

// 2. 消费数据的组件
function UserProfile() {
  const user = useLoaderData();
  return (
    <div className="user-card">
      <h2>{user.name}</h2>
      <p>邮箱:{user.email}</p>
    </div>
  );
}

// 3. 配置路由树
export const router = createBrowserRouter([
  {
    path: "/users/:userId",
    loader: userLoader,
    element: <UserProfile />,
  },
]);
2. 请求参数与中止信号(AbortSignal)
loader 函数接收一个对象参数,其中包含两个核心属性:
params:当前路径中匹配到的动态参数,例如:userId会解析为params.userId。request:标准的 Web FetchRequest实例。你可以通过new URL(request.url)轻松获取查询参数(Query Params),并利用request.signal传递给fetch,当用户在请求返回前点击了其它链接,未完成的网络请求会被自动取消,避免竞态问题。
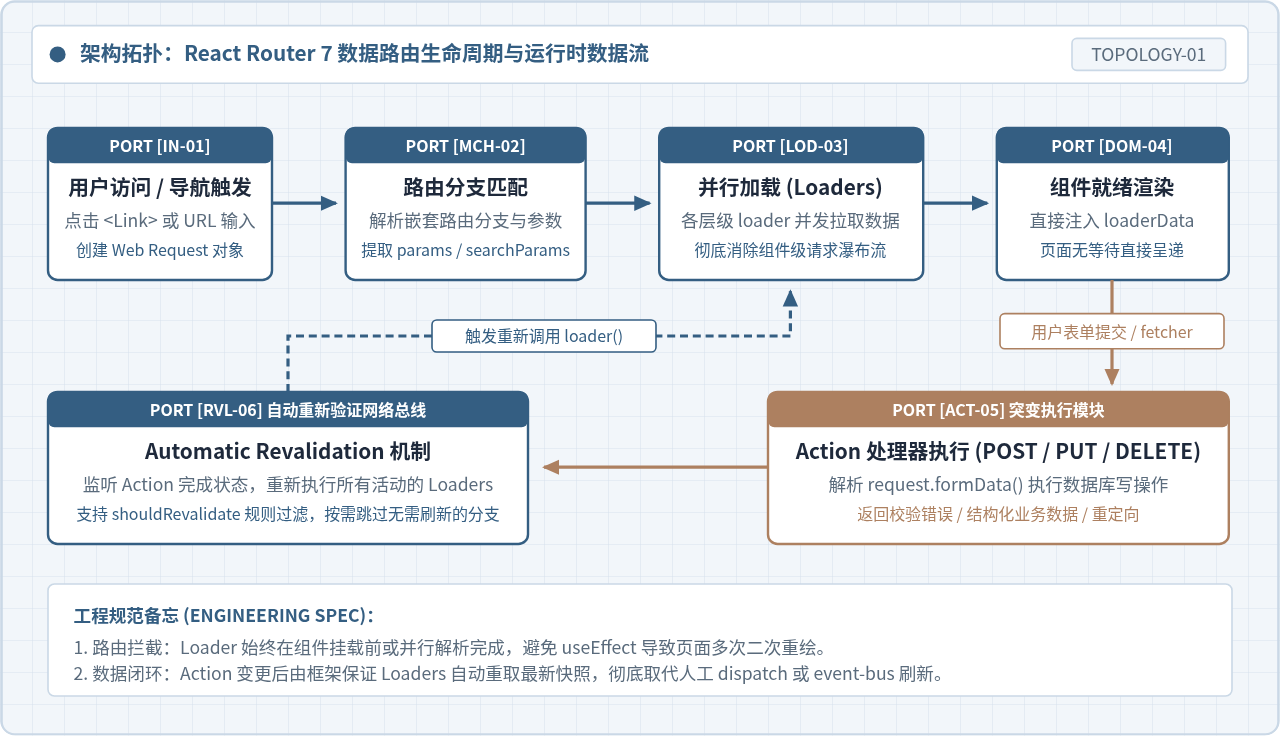
二、Action 的作用机制与实际用法
action 是 React Router 处理“写操作”的核心入口。只要页面发生了数据变更(例如创建任务、更新资料、删除列表项),就应该由 action 接管。它的底层同样基于 Web 标准的 Request 对象,让表单提交回归到类似原生 HTML 的清晰模型,但无需刷新整页。
1. 结合 <Form> 处理标准表单提交
页面中使用 React Router 提供的 <Form method="post">,框架会自动拦截浏览器的默认导航行为,把表单元素序列化为 FormData 并传递给路由的 action:
import { Form, redirect, useActionData } from "react-router";

// 1. 处理数据变更的 action 函数
export async function taskAction({ request }) {
  const formData = await request.formData();
  const title = formData.get("title");
  const priority = formData.get("priority");

  // 业务校验
  if (!title || typeof title !== "string" || title.trim().length === 0) {
    return { error: "任务标题不能为空" };
  }

  // 模拟调用持久化接口
  const res = await fetch("/api/tasks", {
    method: "POST",
    headers: { "Content-Type": "application/json" },
    body: JSON.stringify({ title, priority }),
  });

  if (!res.ok) {
    return { error: "保存失败,请稍后重试" };
  }

  // 操作成功后重定向到任务列表页
  return redirect("/tasks");
}

// 2. 包含表单的组件
export function NewTask() {
  const actionData = useActionData(); // 获取 action 返回的错误信息或验证结果

  return (
    <Form method="post" className="task-form">
      <div>
        <label>任务标题:</label>
        <input type="text" name="title" />
      </div>
      <div>
        <label>优先级:</label>
        <select name="priority">
          <option value="low">普通</option>
          <option value="high">紧急</option>
        </select>
      </div>

      {actionData?.error && (
        <p style={{ color: "#AD8060" }}>{actionData.error}</p>
      )}

      <button type="submit">保存任务</button>
    </Form>
  );
}
2. 局部交互与独立提交:使用 useFetcher
如果当前操作不需要改变 URL 地址栏,也不需要发生页面级重定向(例如列表行内的“删除”、文章“点赞”或“标记为已读”),可以使用 useFetcher()。它拥有自己独立的 fetcher.Form 和 fetcher.submit(),既能触发 action,又不会造成浏览器历史记录堆叠。
import { useFetcher } from "react-router";

function DeleteTaskButton({ taskId }) {
  const fetcher = useFetcher();
  const isDeleting = fetcher.state === "submitting";

  return (
    <fetcher.Form method="post" action={`/tasks/${taskId}/delete`}>
      <button type="submit" disabled={isDeleting}>
        {isDeleting ? "正在删除..." : "删除任务"}
      </button>
    </fetcher.Form>
  );
}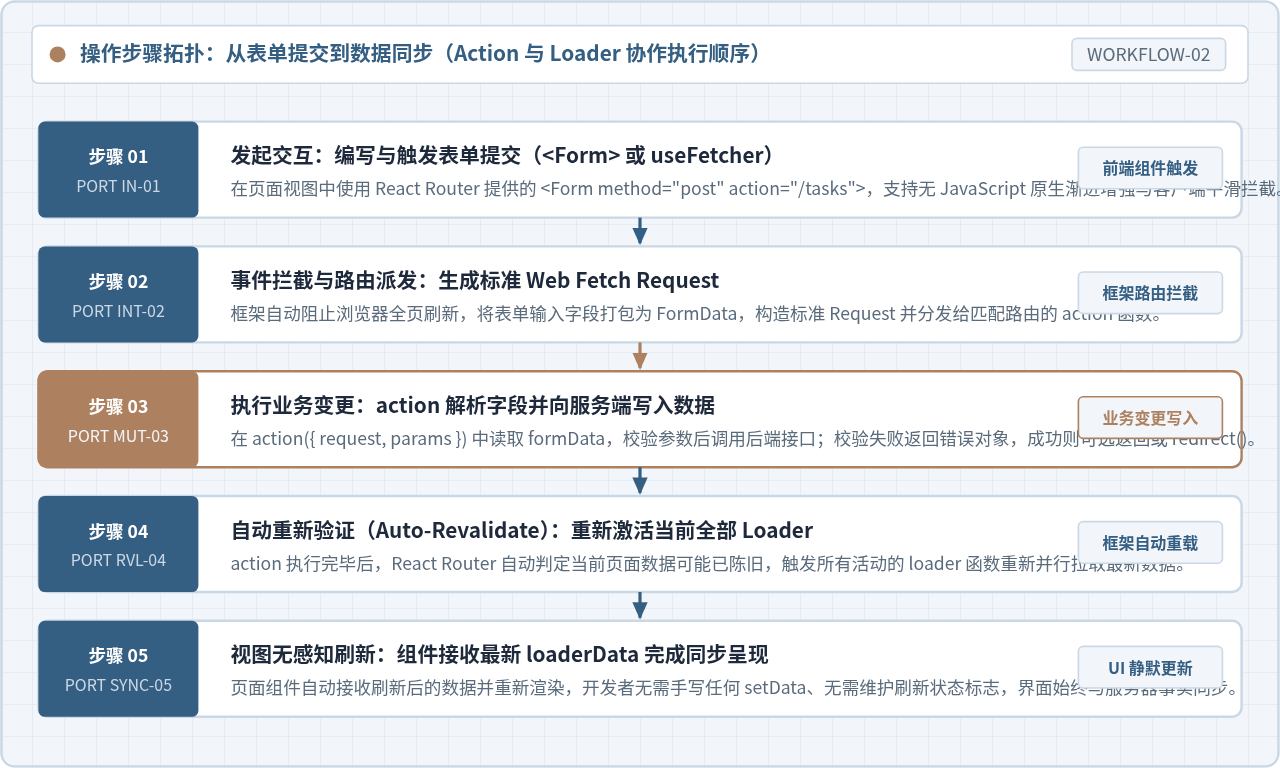
三、核心协同机制:Action 之后的自动重新验证(Revalidation)
在很多前端项目中,开发者在提交一个表单后,必须手动写代码通知各个组件重新获取数据(例如通过 Redux dispatch、React Query 的 invalidateQueries 或自定义事件)。
在 React Router 7 中,只要任何一个 action 执行完毕且没有发生硬跳转,框架就会自动触发当前页面上所有处于激活状态的 loader 重新拉取数据。这种机制被称为自动重新验证(Automatic Revalidation)。
设计哲学:React Router 认为,既然用户调用了
action,就意味着后端数据状态发生了改变。为了保证页面呈现的数据始终与后端保持一致,最可靠的做法就是自动刷新当前页面依赖的所有 Loader 数据,让状态管理从“命令式手动同步”回归到“声明式自动刷新”。
如果你希望在某些特定场景下跳过部分 loader 的重复请求(例如翻页组件或仅展开折叠面板的操作),可以在路由配置中定义 shouldRevalidate 函数进行精细化拦截:
export function shouldRevalidate({ currentUrl, nextUrl, formMethod, defaultShouldRevalidate }) {
  // 如果只是查询参数里的 page 发生了改变,或者不是提交表单,可按需跳过
  if (formMethod === "GET" && currentUrl.pathname === nextUrl.pathname) {
    return false;
  }
  return defaultShouldRevalidate;
}
四、React Router 7 与 6.x 的核心差别在哪里?
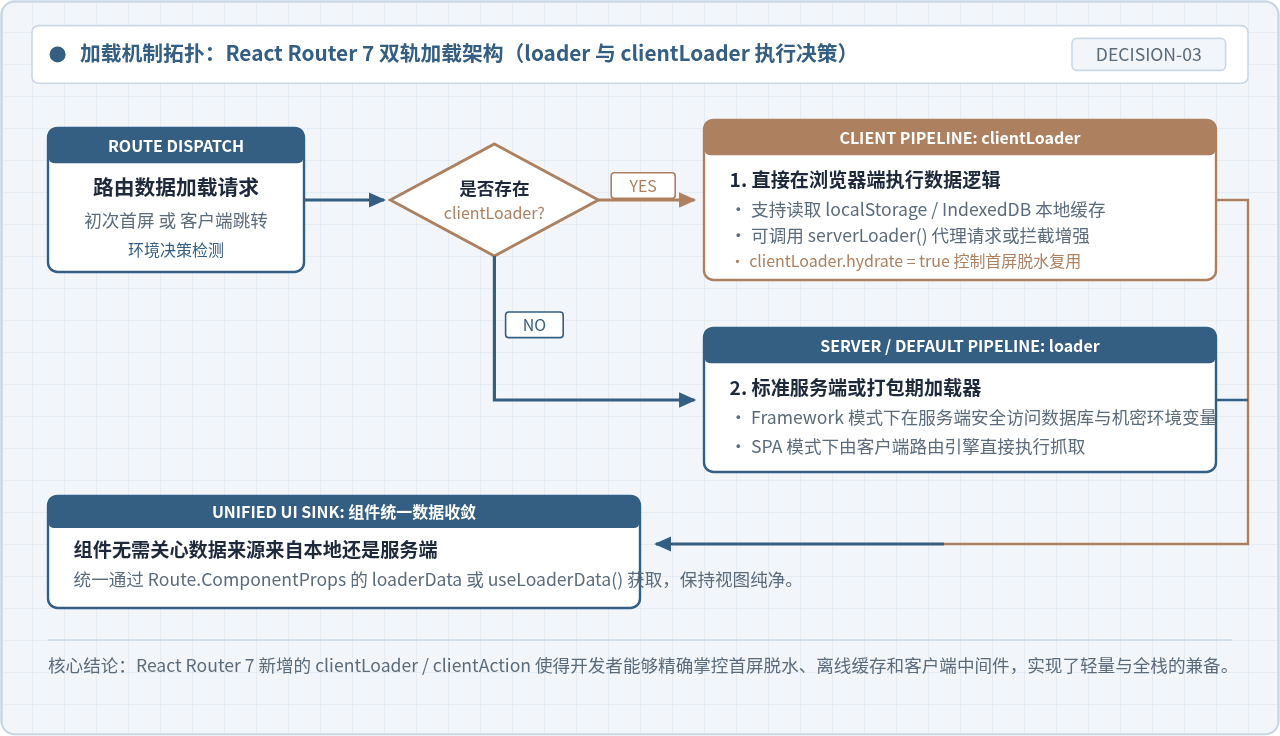
很多开发者会有疑问:React Router 6.4 其实就已经引入了 loader 和 action,那 7.x 究竟改动了什么?答案是:7.x 并不是推倒重来,而是将 Remix 的全栈开发范式与 React Router 的客户端路由深度融合,构建了统一、类型安全且更现代的数据架构。
1. 依赖体系收敛:彻底告别多包与 Remix 割裂
在 6.x 时代,生态被切分为 react-router、react-router-dom、以及需要全栈时使用的 @remix-run/react、@remix-run/node。这导致社区在选型时常常纠结是选择 Remix 还是 React Router。
React Router 7 将两者正式统一。只需要安装单一的 react-router 包,无论是纯客户端 SPA,还是带有 SSR、静态预渲染(SSG)的全栈项目,API 和心智模型完全一致。
2. 类型安全:从“手动强转”到“零断言自动推导”
在 React Router 6.x 中,useLoaderData() 默认返回 unknown。开发者往往不得不写出如下代码:
// 6.x 的常见写法:类型极易与实际返回脱节
const data = useLoaderData() as { title: string; count: number };
而在 React Router 7 的框架模式(Framework Mode)中,通过内置的 Vite 插件自动为每个路由生成局部类型文件(位于 ./+types/路由文件名)。组件和加载器能够做到端到端完全类型推导:
// 7.x 推荐写法:严格类型保障
import type { Route } from "./+types/user-detail";

export async function loader({ params }: Route.LoaderArgs) {
  // params.userId 会自动推断为 string 类型
  return { id: params.userId, score: 98, role: "admin" };
}

export default function UserDetail({ loaderData }: Route.ComponentProps) {
  // loaderData 自动推断为 { id: string; score: number; role: string }
  return <div>用户ID:{loaderData.id},积分:{loaderData.score}</div>;
}
3. 新增 clientLoader 与 clientAction:精确掌控客户端生命周期
在 6.x 中,loader 和 action 只能以统一的逻辑运行。但在混合架构或需要极致离线体验的场景中,往往需要明确区分“服务端执行”还是“客户端直接执行”。
React Router 7 引入了 clientLoader 和 clientAction:
- 客户端专属逻辑:可以直接在
clientLoader中读写浏览器的localStorage、IndexedDB或优先命中前端内存缓存。 - 首屏水合控制:通过设置
clientLoader.hydrate = true,开发者可以显式决定初次 SSR 渲染进入页面时,是否必须在客户端再次执行该加载器。
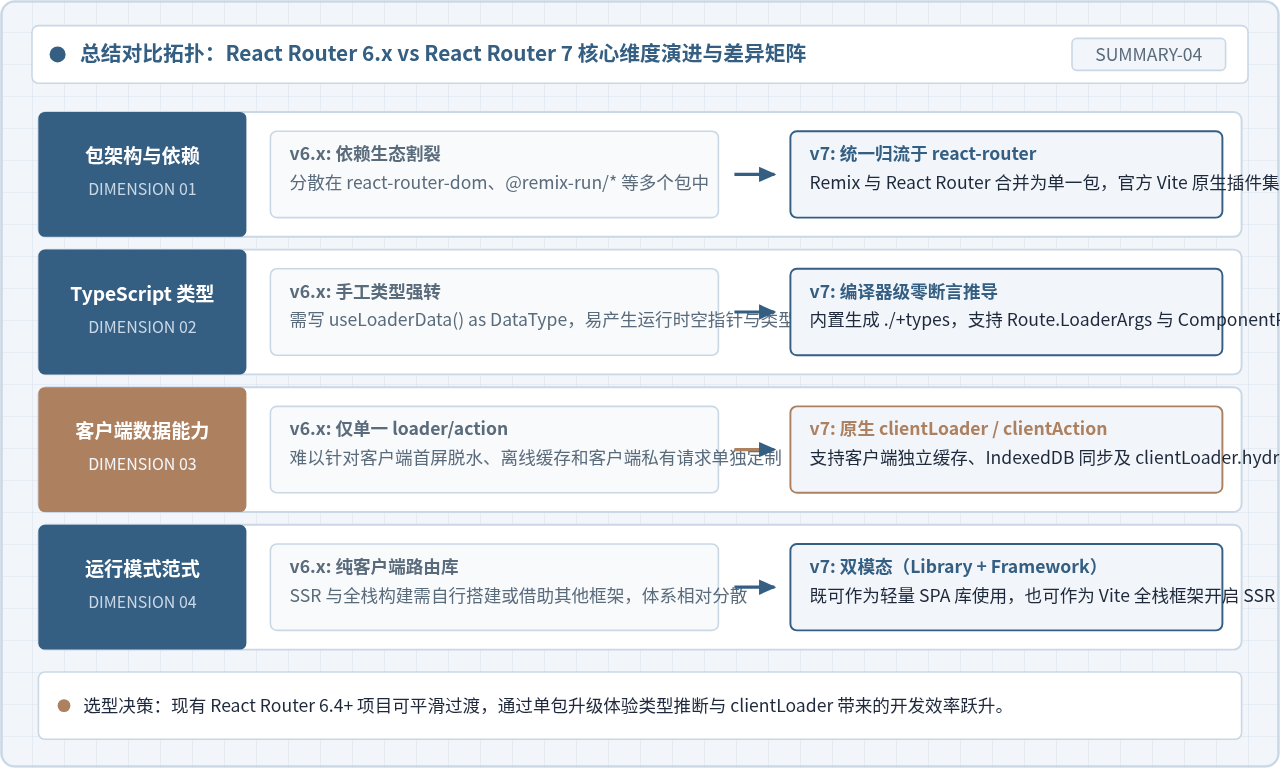
4. 核心维度对比表
| 对比维度 | React Router 6.x (6.4+) | React Router 7 |
|---|---|---|
| 核心依赖包 | react-router-dom / 分散的多包体系 |
统一收敛至 react-router |
| TypeScript 支持 | 需手动使用 as 类型断言或声明推断辅助类型 |
框架自动生成 Route.LoaderArgs 与 Route.ComponentProps |
| 客户端专用数据钩子 | 无,仅有通用的 loader / action | 新增原生的 clientLoader 与 clientAction |
| 首屏水合控制 | 不可控,客户端与服务端逻辑绑定较死 | 提供 clientLoader.hydrate 显式配置 |
| 运行范式 | 主要作为纯客户端 SPA 路由库使用 | 兼具轻量 Library Mode 与开箱即用的 Vite Framework 全栈模式 |
| 底层引擎演进 | 独立演进,与 Remix 存在重复建设 | 完全吸收 Remix 核心资产,成为事实上的统一标准 |
五、从 6.x 升级到 7 的实操迁移建议与注意事项
-
平滑过渡:先以 Library Mode 运行
如果你的项目是基于 Vite 或 Webpack 构建的经典 SPA,不必立刻重构为全栈 Framework Mode。只需将依赖由react-router-dom替换为react-router,原有的createBrowserRouter、RouterProvider、loader与action配置无需修改语法即可正常跑通。 -
注意 FormData 的类型转换
在action中通过request.formData()读取数据时,所有表单值默认都是string或File类型。如果数据库需要数字或布尔值,务必显式做Number(formData.get("age"))转换,切勿直接原样传给后端接口。 -
避免在 loader 中执行具有破坏性的写操作
由于 React Router 会在页面发生 action 变更、URL 查询参数变化、甚至某些预加载动作(Prefetch)时反复调用loader,因此loader必须严格保持幂等只读。任何增删改逻辑必须放入action中处理。 -
合理利用 ErrorBoundary 隔离错误
当loader或action抛出错误时(如 404 或网络中断),React Router 会向上冒泡寻找最近的ErrorBoundary。建议在关键页面路由配置中放置局部的错误捕获组件,避免单个组件请求失败导致整个应用白屏崩溃。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章