
深入讲解通过JavaScript为select下拉框设置默认值并自动生成内容后,如何进行规范归档与高效检索。涵盖键值快照设计、结构化存储、元数据索引与异步时序防错方案。

当前位置:首页 > JavaScript DOM 与事件 > 正文
js给select设置默认值生成的内容怎么归档方便检索
作者:竹影
时间:2026-11-08
浏览:266
文章目录
通过 JavaScript 为
<select> 下拉框预设默认值并由此触发生成记录(如系统工单、分类导出报告、日志快照或自动化配置)时,要让归档内容具备高检索性,核心解决方案在于:在内容生成的第一时间,将“选中编码(Value)”、“显示文本(Label)”以及“预设来源标记(isDefault)”打包为不可篡改的元数据快照,并采用结构化与全文本双轨索引机制存储。避免仅存储单一编码或未加标记的散乱文本,是保障后续跨维度高效检索的关键。
一、归档痛点辨析:为什么简单存储会导致检索失效?
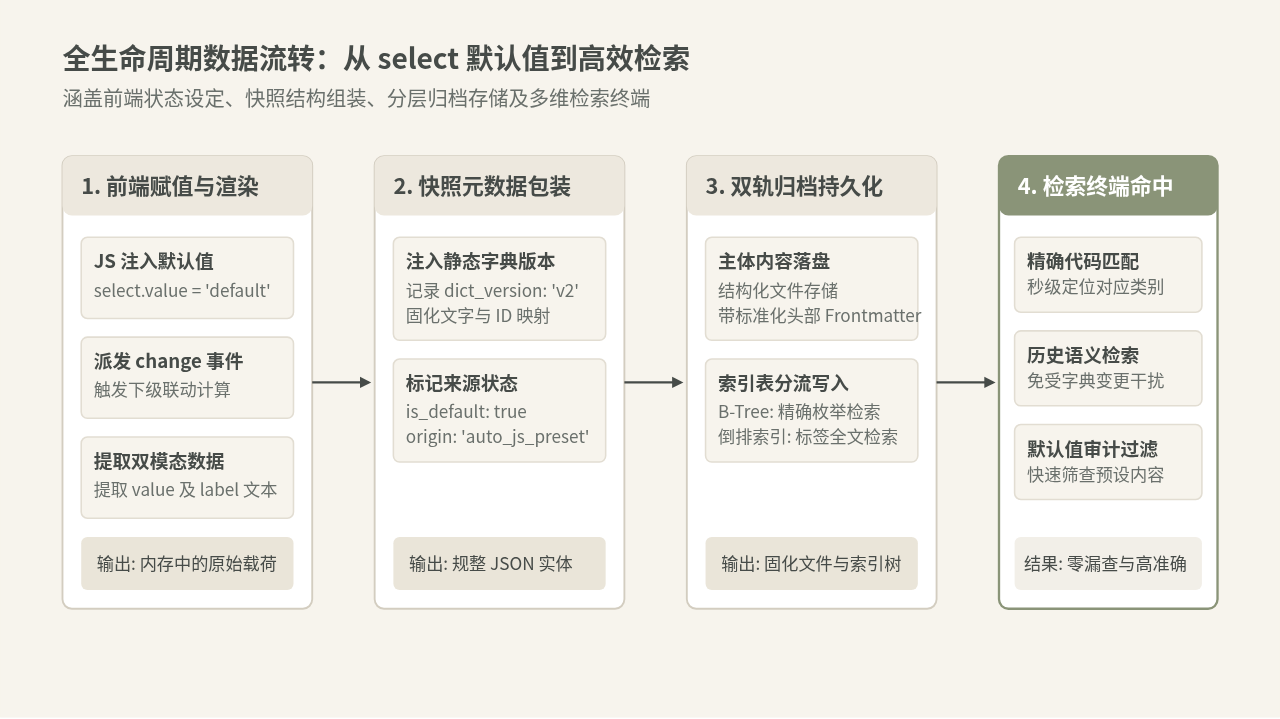
在许多前端应用中,开发者常通过 select.value = 'default_code' 或操作 selectedIndex 为表单赋初值,并依托事件监听器触发下游模板或生成文档。然而在随后的归档环节,往往存在以下两类典型设计偏差:
- 偏差一:仅持久化基础键值(例如只存
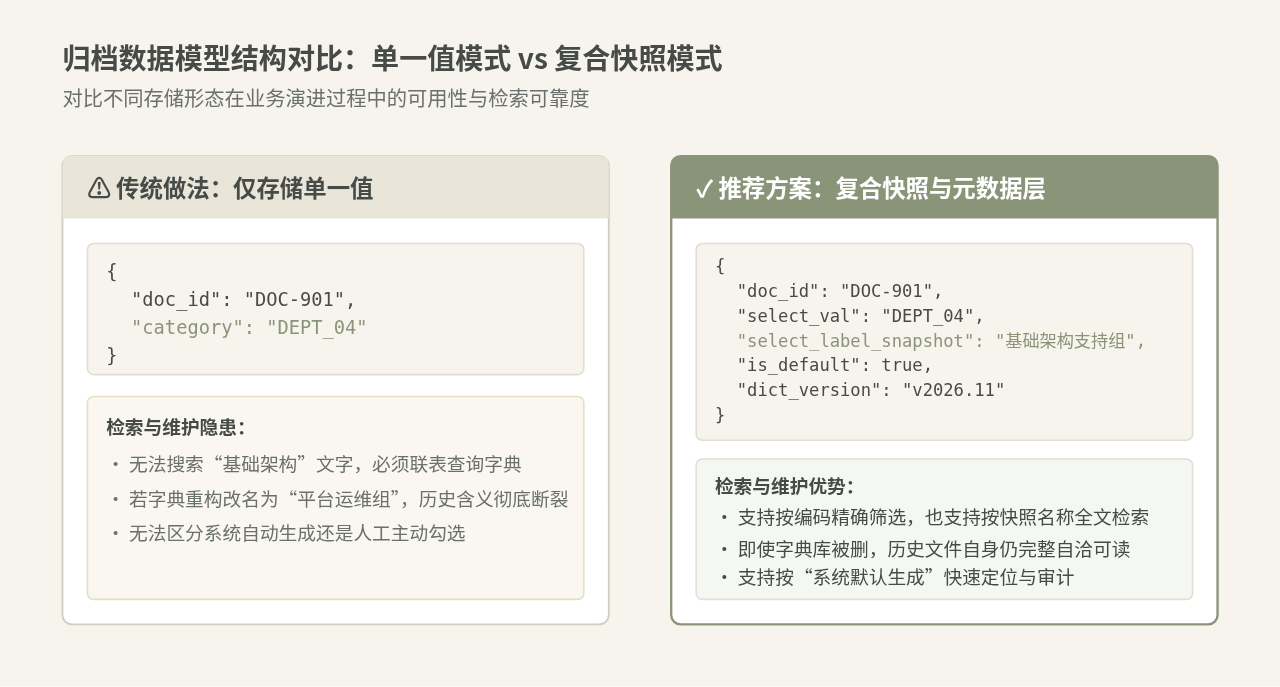
category: "102")。这种做法看似规范且节省存储空间,其假设是后端总能通过外键关联查到对应的展示名称。但随着业务迭代,字典表中102的对应文本可能从“待处理-技术部”被修改为“已归档-开发组”,甚至该字典项被物理删除。此时若根据用户关键词检索历史归档,查询将彻底脱节,甚至呈现错误语义。 - 偏差二:仅抓取当前页面显示的文本(例如只存
category: "技术部")。这种做法虽然方便按文字直接模糊搜索,却失去了结构化筛选能力。当需要进行状态聚合、按代码范围统计,或与外部系统做精确 ID 匹配时,文本匹配的歧义和空格差错会导致统计漏查。 - 偏差三:缺失“默认值”上下文标识。未标注该选项是由系统脚本自动填充还是由操作员主动修改,当发生合规审查或操作溯源时,检索系统无法快速筛选出“采用系统默认规则生成的文件”。
二、核心设计原则:快照模型与标准化元数据
解决检索难题的关键不是在搜索时进行复杂的关联查询,而是在数据生成落盘的一瞬间,将下拉框的完整状态“固化”。具体需要构建如下元数据快照结构:
| 字段键名 | 典型值示例 | 主要检索用途与业务保障 |
|---|---|---|
select_id |
"dept_selector" |
标记产生该内容的具体表单组件标识,支持按组件来源过滤。 |
selected_value |
"DEPT_04" |
稳定枚举编码,用于数据库精确匹配、范围筛选和自动化流程对接。 |
selected_label |
"基础架构支持组" |
生成时刻的文本快照,用于直接全文模糊检索,彻底免疫后续字典修改。 |
is_default |
true |
布尔值标记,标识该内容是使用默认预设值还是操作员主动更改后的值。 |
dict_version |
"2026.11" |
字典配置版本号,便于必要时对历史数据进行词义溯源与回溯对账。 |
generated_time |
"2026-11-05T09:30:00Z" |
ISO 时间戳,支持以年、月、日分区路径归档与按时间区间快速筛选。 |
三、实操实施:从前端赋值到归档落盘的四个步骤
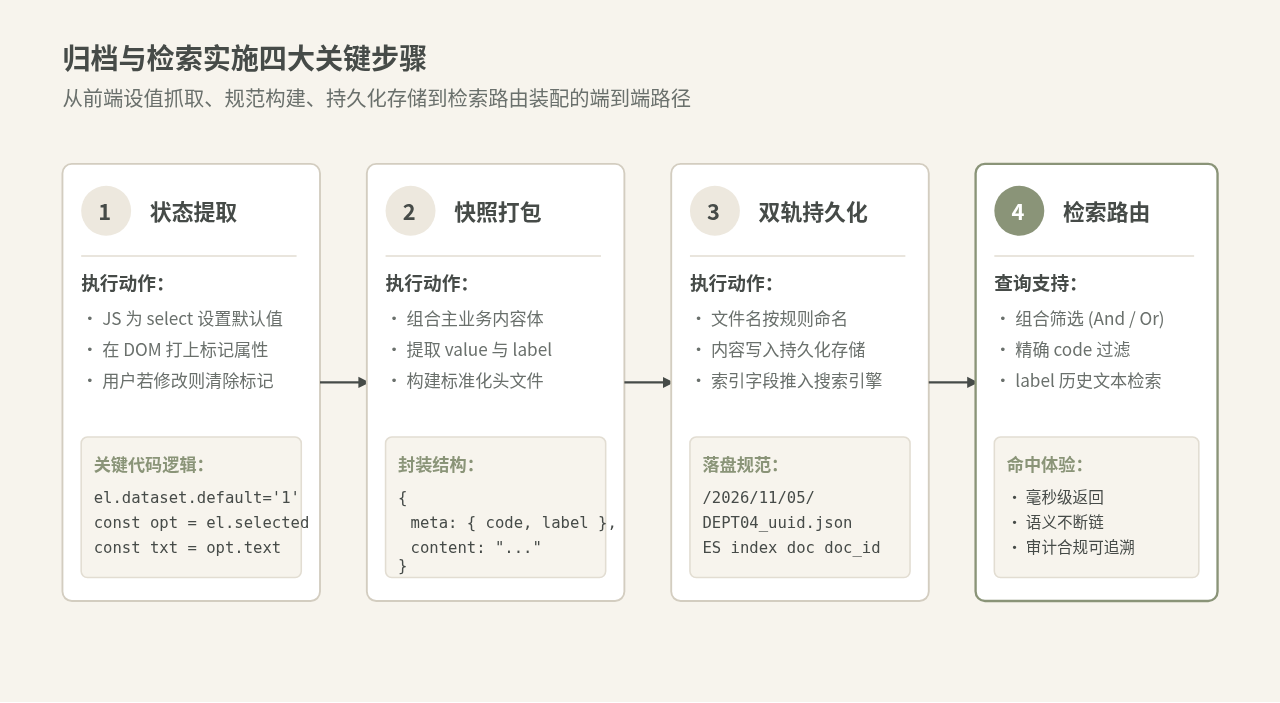
在系统落地过程中,归档操作应嵌入在业务动作生成的节点上,具体实施可以拆解为四个关键步骤。
步骤 1:前端设值、标记与状态提取
在前端给 <select> 注入默认值时,应当记录其赋值原因,并通过自定义数据属性(dataset)对“当前是否仍处于系统默认态”进行标记。一旦用户手动触发下拉框修改,该标记立即更新。
// 初始化下拉框并设置默认值
function initSelectWithDefault(selectEl, defaultVal) {
  selectEl.value = defaultVal;
  // 标记当前状态来自默认设定
  selectEl.dataset.isDefault = 'true';
  selectEl.dataset.defaultValue = defaultVal;

  // 用户主动修改后,解除默认值标记
  selectEl.addEventListener('change', function() {
    if (this.value === this.dataset.defaultValue) {
      this.dataset.isDefault = 'true';
    } else {
      this.dataset.isDefault = 'false';
    }
  });

  // 派发事件通知下游生成依赖内容
  selectEl.dispatchEvent(new Event('change'));
}

// 获取待归档的完整选择快照
function extractSelectSnapshot(selectEl) {
  const selectedOption = selectEl.options[selectEl.selectedIndex];
  return {
    select_id: selectEl.id || selectEl.name || 'unnamed_select',
    value: selectEl.value,
    label: selectedOption ? selectedOption.text.trim() : '',
    is_default: selectEl.dataset.isDefault === 'true',
    dict_version: selectEl.dataset.dictVersion || 'default_v1'
  };
}
步骤 2:构建用于归档的标准化载荷
生成的内容如果是 Markdown、HTML 还是纯文本文档,通常推荐在文件头部使用 Front-Matter 格式组织元数据;若是 JSON 存储,则单独维护一个 metadata 节点。这种设计保证了无论后续是直接阅读文件,还是使用脚本扫盘索引,都可以无成本解析出检索头。
// 构建标准归档载荷
function createArchivePayload(generatedContent, selectEl, extraContext = {}) {
  const selectSnapshot = extractSelectSnapshot(selectEl);
  const now = new Date();

  return {
    archive_id: "ARC-" + Date.now() + "-" + Math.random().toString(36).substring(2, 7),
    created_at: now.toISOString(),
    // 归档维度:保留 select 核心上下文
    selector_metadata: {
      category_code: selectSnapshot.value,
      category_label: selectSnapshot.label,
      is_system_default: selectSnapshot.is_default,
      dict_version: selectSnapshot.dict_version
    },
    context: extraContext,
    content_body: generatedContent
  };
}
防错提示:异步渲染下的设值时序陷阱
如果下拉框的 <option> 是通过 AJAX 异步拉取的,必须确保在 options 完成 DOM 插入后再执行 select.value = defaultVal。若过早赋值,select.value 会静默退化为空字符或第一项,此时生成的内容会导致分类缺失。务必使用 Promise 或渲染完成回调保障设值与快照提取的时序一致。
步骤 3:文件命名与分层目录规整
除了内容内部包含元数据,在存储落盘时,文件路径与文件名本身应承担第一道物理检索过滤功能。推荐采用分层结构:
/archives/
  ├── 2026/
  │   └── 11/
  │       ├── DEPT04/
  │       │   ├── 20261105_DEFAULT_ARC-88219.json
  │       │   └── 20261105_CUSTOM_ARC-88220.json
  │       └── DEPT08/
  │           └── 20261105_DEFAULT_ARC-88221.json
命名遵循格式:{YYYYMMDD}_{STATUS}_{ID}.json。其中 STATUS 直接体现 DEFAULT 或 CUSTOM。这使得运维人员在仅通过终端 find、grep 或云存储前缀(Prefix)搜索时,无需读取文件内容即可秒级过滤某分类下系统默认生成的所有记录。
步骤 4:构建索引表以支持高速多维检索
对于生产系统,不能完全依赖遍历文件磁盘。在归档入库的同时,应将快照元数据同步写入检索索引表(如 SQLite、PostgreSQL 或 Elasticsearch):
// 模拟向轻量检索索引库插入记录
async function indexArchiveRecord(db, archivePayload) {
  const query = `
    INSERT INTO archive_index (
      archive_id, category_code, category_label,
      is_default, created_at, file_path
    ) VALUES (?, ?, ?, ?, ?, ?)
  `;
  const meta = archivePayload.selector_metadata;
  await db.run(query, [
    archivePayload.archive_id,
    meta.category_code,
    meta.category_label,
    meta.is_system_default ? 1 : 0,
    archivePayload.created_at,
    archivePayload.stored_path
  ]);
}
四、多维检索查询的落地应用示例
当数据按照上述规范归档后,面对业务层提出的不同检索诉求,系统可以从容应对:
- 场景 1:按类别编码精确过滤。直接根据
category_code = 'DEPT_04'查询,快速定位所有归属该业务分类的归档,执行效率最高(走 B-Tree 索引)。 - 场景 2:按历史名称模糊搜索。即使未来该部门名称已改为“平台架构事业部”,用户输入“基础架构”时,通过搜索
category_label LIKE '%基础架构%'仍能准确召回历史时期生成的内容。 - 场景 3:审计排查“全部由系统默认值生成”的内容。使用
WHERE is_default = 1 AND category_code = 'DEPT_04',可精确排查哪些文件从未被人工确认或干预,满足数据治理和自动化稽核需求。
五、总结与维护建议
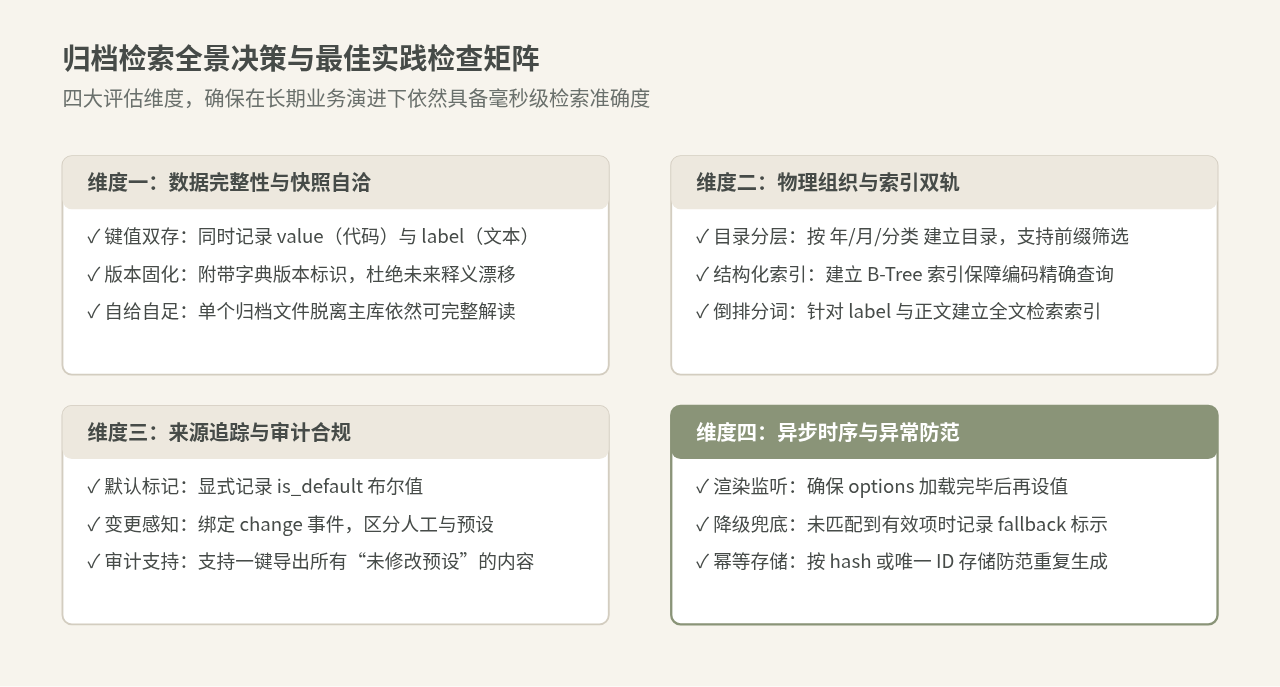
归纳而言,针对 JavaScript 给 select 设置默认值所生成内容的归档检索问题,不能仅仅将 select 视为临时的界面输入工具,而要将其作为内容分类元数据的第一发源地。
在实际工程实现中,最推荐的做法是遵循“设值时打标、生成时快照、落盘时双存、检索时分流”的原则。通过在文件和数据库中同时留存 value、label 以及 is_default 标记,不仅能在系统日趋庞大、字典更迭频繁时保证历史归档可被准确检索,更能在审计和统计分析中带来清晰的来源依据与合规保障。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章