
深入对比 JavaScript 生态中解析与处理 Excel 的两大核心库 SheetJS 与 ExcelJS:从底层对象模型、格式兼容、样式排版、大文件流式解析到内存开销与安装分发,提供清晰可落地的技术选型指南。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS解析Excel:SheetJS与exceljs库选型对比
作者:慢半拍
时间:2026-11-05
浏览:180
文章目录
在 JavaScript 环境(浏览器与 Node.js)下解析与生成 Excel 文件,最常见的两个核心选项是 SheetJS(社区常称
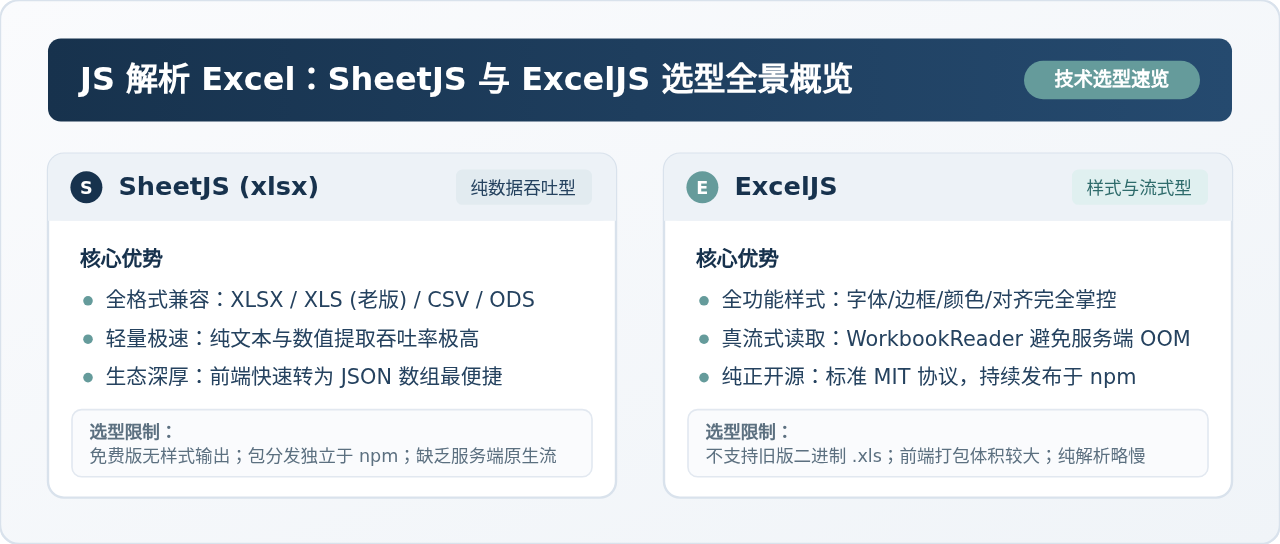
xlsx)和 ExcelJS。两者的根本区别在于设计目标:SheetJS 专注于纯数据提取的高性能与多格式兼容,擅长以极快速度将各类电子表格平铺解构成内存矩阵或 JSON 数组;ExcelJS 则专注于完整文档对象模型与丰富样式渲染,在单元格格式化、数据验证、图表公式、以及应对上百兆大文件的流式(Stream)内存管控上具备显著优势。如果业务核心是批量摄取结构化数据或兼容老旧 .xls,SheetJS 更顺手;如果需要保留精密排版或在服务端防范内存溢出(OOM),ExcelJS 是更稳健的方案。
一、底层架构与数据模型差异
评估一个表格处理库能否满足长远需求,首先需要理解它们是如何在内存中建模一份 Excel 文档的。底层的组织结构不仅直接影响编码手感,也决定了功能扩展的上限。
1. SheetJS 的平铺键值字典模型
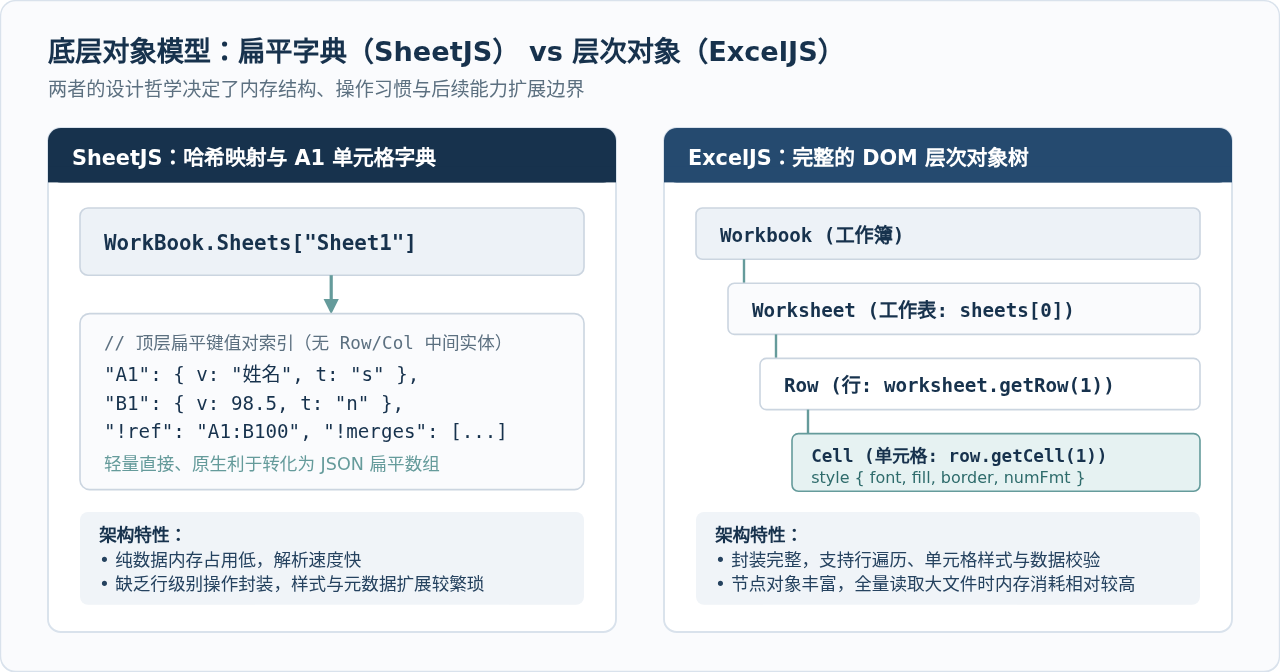
SheetJS 采用了以单元格坐标为键的扁平哈希字典设计。当通过 XLSX.read 解析文件后,工作表对象 worksheet 本质上是一个巨大的 JavaScript 键值映射表。例如坐标 A1 的单元格直接挂载在 worksheet['A1'] 上,内容为简单的纯数据对象(如 { v: "张三", t: "s" },其中 v 代表原始值,t 代表数据类型标记)。
工作表的尺寸边界由 worksheet['!ref'] 字符串(例如 "A1:C100")定义。这种设计的优势在于数据结构轻巧紧凑,几乎没有多余的面向对象属性开销,配合内置的 XLSX.utils.sheet_to_json 工具函数,只需一行代码即可将行列矩阵拍平成前端表格所需的对象数组。然而,其代价是缺乏行与列的实体封装抽象,任何跨行跨列的逻辑或复杂格式配置都必须直接操作底层的元属性键(如 !merges、!cols),在处理复杂版面时代码显得较为晦涩。
2. ExcelJS 的层级面向对象模型
ExcelJS 严格遵循现代 OOXML(Office Open XML)的标准层级结构,构建了一个完整的 DOM 风格对象树:
Workbook(工作簿) → Worksheet(工作表) → Row(行) → Cell(单元格)
在 ExcelJS 中,无论是行还是单元格都是独立的对象实例。通过 worksheet.getRow(1) 或 row.getCell('A') 可以直观操作具体单元格。每个单元格对象原生承载了 font(字体与大小)、fill(背景底纹)、border(各方向边框)、alignment(对齐方式)以及 numFmt(数值与货币格式代码)。这种高度结构化的封装让样式与复杂排版操作非常符合开发者的直觉,但这也意味着每个单元格在内存中都需要额外的引用对象,全量解析时的内存开销相对更重。
二、核心选型维度深度剖析
1. 格式兼容性与包管理分发
在格式覆盖面上,SheetJS 展现出极强的工业兼容性。它不仅支持现代的 .xlsx、.xlsm 和纯文本 .csv,还深度兼容 1997~2003 年代老旧二进制格式 .xls(BIFF8/BIFF5)、.xlsb、.ods 甚至 Lotus 1-2-3 等冷门格式。如果你的系统需要接收客户、政府部门或老旧财务系统导出的 .xls 历史文件,SheetJS 几乎是 JavaScript 环境下唯一开箱即用且成熟的选择。
相比之下,ExcelJS 的重心完全放在现代标准的 .xlsx 以及 .csv 上,明确不支持老旧二进制 .xls 格式的直接解析。如果强行读取 .xls,会直接抛出文件解压或格式不合法的异常。
包生态与安装协议注意事项:
从 0.18.5 版本之后,SheetJS 官方团队将最新版本发布渠道迁出了公共 npm 官方源,转移至自建 CDN(
从 0.18.5 版本之后,SheetJS 官方团队将最新版本发布渠道迁出了公共 npm 官方源,转移至自建 CDN(
https://cdn.sheetjs.com)。公共 npm 上的 xlsx 包已冻结在 0.18.5,且商业使用时免费社区版(CE)受其特定许可证约束。ExcelJS 则始终完全开源(MIT 协议),并在 npm 官方源保持常规发版,在大型企业的代码合规性审查与自动化构建流水线中往往更加平滑。
2. 单元格样式与复杂表格特性
如果你需要输出符合企业视觉标准或财务审计规范的报表,样式的控制能力将成为选型的决定性考量:
- SheetJS 社区版(免费版):默认不支持向导出的 Excel 文件中写入自定义样式(如背景颜色、字体颜色、粗体、斑马纹和自定义边框)。虽然社区存在分支修改库(如
xlsx-style),但这些分支往往长期处于缺乏维护的状态,且与高版本存在兼容冲突;官方完整的样式与图表功能被归入其商业 Pro 版本中。 - ExcelJS:样式能力属于一等公民。无论是在 Node.js 还是在前端环境,ExcelJS 均原生支持高精度的 ARGB 颜色定义、单元格合并、多级表头冻结窗口、公式计算值读取、数据校验下拉菜单、超链接绑定,甚至可以在单元格内精确锚定并插入 PNG/JPEG 图片。
3. 服务端性能与流式内存管控
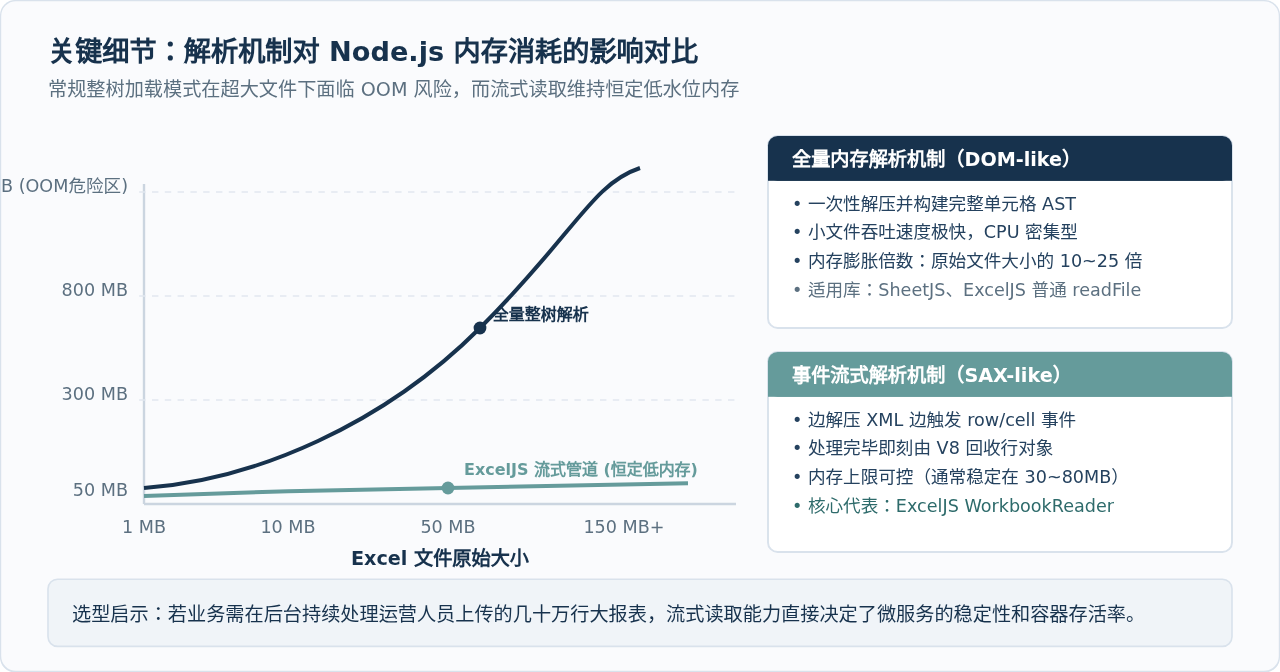
常规的文件读取方式是将文件全部读入内存后一次性解压并构建语法树。这种全量加载机制(DOM-like)在文件较小时非常高效,但当文件增长到数十兆、数据行数达到数万至数十万时,解压后的 XML 文本和单元格哈希表会产生 10 到 20 倍的内存膨胀。在 Node.js 默认堆内存限制(通常为 1.4GB 左右)下,极易触发 JavaScript heap out of memory 崩溃。
针对超大文件导入场景,ExcelJS 提供了专门的 WorkbookReader。它基于 Node.js 管道流(Stream)和事件驱动架构,在底层解压 ZIP 包时同步进行 SAX 式 XML 节点解析,每解析完一行即触发 row 事件,处理完毕后当行对象可被垃圾回收机制及时释放。这使得即使解析 200MB 的海量表格,内存占用也能稳定保持在数十兆的极低水位。SheetJS 社区版在服务端则缺乏成熟的原生行流驱动机制,主要依赖整块 Buffer 解析。
三、解析操作标准化流程与步骤
在实际生产环境中,将一个用户上传或服务端存储的 Excel 转换为业务可用数据的操作,可以抽象为五个标准步骤。无论选择哪一个库,遵循统一的流水线能够确保数据异常与内存泄漏被有效拦截。
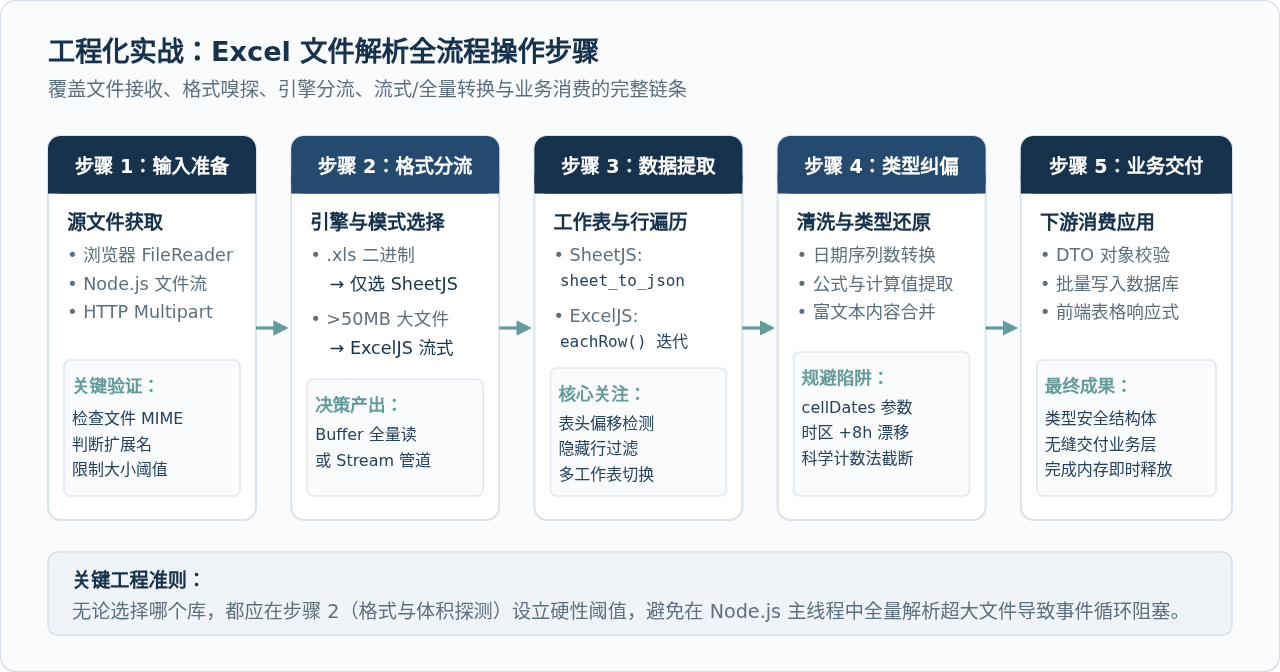
- 步骤 1:输入准备与前置校验 —— 接收前端上传的 File 对象或 Node.js 内部的 ReadStream。首先检查文件魔数与扩展名,设定合理的体积阈值,拦截空文件与伪造格式。
- 步骤 2:格式探测与解析通道分流 —— 根据文件扩展名与体积判断:若是
.xls二进制文件,直接分流至 SheetJS;若在服务端且文件体积超过预设阈值(例如 30MB),分流至 ExcelJS 的流式管道。 - 步骤 3:数据提取与遍历 —— 在选定的引擎中读取工作表。SheetJS 可快速转换为平铺对象数组;ExcelJS 则通过
worksheet.eachRow遍历行并逐列抽取。 - 步骤 4:类型纠偏与格式清洗 —— 修正 Excel 特有的日期序列数偏移、统一公式单元格的计算结果输出、清理首尾空格与富文本格式碎片。
- 步骤 5:业务交付与内存清理 —— 结合业务 DTO 进行字段校验,批量入库或返回给客户端,并确保临时 Buffer 与文件句柄被及时销毁释放。
四、实战代码对比:解析与数据提取
1. 场景一:Node.js 中快速读取 XLSX 并转为 JSON
这是日常开发中最普遍的需求:读取一个 .xlsx 文件,获取其第一个工作表的内容,并输出为扁平的结构化对象数组。
环境要求:Node.js 16+,安装对应依赖包。
// 依赖安装命令示例:
// npm install exceljs
// npm install @sheetjs/ce --registry=https://cdn.sheetjs.com
SheetJS 实现方案:
const XLSX = require('xlsx');

function parseWithSheetJS(filePath) {
  // 1. 读取本地工作簿,cellDates 确保日期被还原为 JS Date 而不是纯数值
  const workbook = XLSX.readFile(filePath, { cellDates: true });

  // 2. 取第一个工作表
  const firstSheetName = workbook.SheetNames[0];
  const worksheet = workbook.Sheets[firstSheetName];

  // 3. 直接转换为对象数组(首行自动识别为 Key)
  const jsonData = XLSX.utils.sheet_to_json(worksheet, {
    defval: '', // 空单元格默认值
    blankrows: false
  });

  return jsonData;
}
ExcelJS 实现方案:
const ExcelJS = require('exceljs');

async function parseWithExcelJS(filePath) {
  const workbook = new ExcelJS.Workbook();
  // 1. 异步加载文件
  await workbook.xlsx.readFile(filePath);

  // 2. 获取第一个工作表
  const worksheet = workbook.getWorksheet(1);
  const results = [];
  let headers = [];

  // 3. 逐行提取数据
  worksheet.eachRow((row, rowNumber) => {
    const values = row.values; // values 下标从 1 开始
    if (rowNumber === 1) {
      headers = values;
    } else {
      const record = {};
      for (let col = 1; col < headers.length; col++) {
        const key = headers[col];
        // 提取单元格纯文本值,兼容公式单元格
        const cellValue = row.getCell(col).value;
        record[key] = (cellValue && typeof cellValue === 'object' && cellValue.result !== undefined)
          ? cellValue.result
          : cellValue;
      }
      results.push(record);
    }
  });

  return results;
}
对比解析:在纯数据提取上,SheetJS 的
XLSX.utils.sheet_to_json 高度精炼,内部完成了表头匹配与空列修补;而 ExcelJS 需要通过 eachRow 遍历与手动提取。但如果这一过程中需要获取单元格的字体颜色、校验格式规则或公式原型,ExcelJS 的 row.getCell(col) 能够提供完整的元信息。
2. 场景二:服务端大文件流式读取(防止内存溢出)
当处理运营上传的上百兆流水账单或日志报表时,全量模式会把整个解压后的文档树存入内存。使用 ExcelJS 的流式读取器可以在内存中只保留当前行,实现高可靠的大文件摄取:
const ExcelJS = require('exceljs');
const fs = require('fs');

async function processHugeExcelStream(filePath, onBatchInsert) {
  const options = {
    entries: 'emit',
    sharedStrings: 'cache',
    styles: 'cache',
    hyperlinks: 'ignore'
  };

  const workbookReader = new ExcelJS.stream.xlsx.WorkbookReader(filePath, options);
  let batchBuffer = [];
  let headers = [];

  for await (const worksheetReader of workbookReader) {
    for await (const row of worksheetReader) {
      if (row.number === 1) {
        headers = row.values;
      } else {
        const item = {};
        for (let i = 1; i < headers.length; i++) {
          item[headers[i]] = row.values[i];
        }
        batchBuffer.push(item);

        // 每 2000 条分批刷入数据库并清理缓存,控制内存水位
        if (batchBuffer.length >= 2000) {
          await onBatchInsert(batchBuffer);
          batchBuffer = [];
        }
      }
    }
  }

  // 刷入尾部残留数据
  if (batchBuffer.length > 0) {
    await onBatchInsert(batchBuffer);
  }
}
五、关键细节:内存机制与性能特征分析
了解底层的内存机制有助于我们在高并发场景下合理预估服务器的资源规格。以下是两类工作机制在典型数据量级下的行为特征:
| 评测场景 | SheetJS (xlsx) | ExcelJS (普通 readFile) | ExcelJS (WorkbookReader 流式) |
|---|---|---|---|
| 5MB 以内常见表格 | 约 30~70ms,纯数据转换最快 | 约 90~180ms,耗时稍长 | 流式开销稍显冗余,不推荐 |
| 50MB 级大型报表 | 全量占用内存约 400~600MB | 全量占用内存约 600~900MB | 内存恒定保持在 40~80MB |
| 150MB+ 海量历史流水 | 极易触发 V8 堆内存耗尽 OOM | 直接抛出内存溢出异常退出 | 稳定逐行流式解析,不崩服 |
| 浏览器纯前端运行 | 加载轻巧,开箱即用 | 打包体积较大,需 Polyfill | 不适用流式(仅限 Node/Stream) |
六、开发常见陷阱与避坑策略
1. 日期格式偏移与时区偏差
Excel 内部并没有原生的“ISO 日期字符串”类型,而是将日期记录为基于 1900 年 1 月 0 日(或 1904 系统)起算的浮点序列天数。例如整数 45200 实际上代表一个具体日期。
- 在 SheetJS 中,如果不显式声明
cellDates: true,解析得到的单元格值会直接呈现为原始浮点数字,导致业务逻辑出现严重偏差。开启后需注意本地时区与 UTC 之间的 8 小时转换。 - 在 ExcelJS 中,当单元格类型为日期格式时,
cell.value会自动被识别为原生 JavaScriptDate对象,但需注意在写入导出时指定统一的numFmt: 'yyyy-mm-dd hh:mm:ss'。
2. 浏览器打包体积与环境依赖
如果你的目标是将表格解析放在客户端执行:
- SheetJS:经过独立打包后的社区脚本(如
xlsx.full.min.js)在去除了不必要的格式扩展后,体积易于把控,且没有对 Node.js 核心模块的隐式依赖。 - ExcelJS:在 Webpack 5 或 Vite 等现代前端工程中引入
exceljs时,由于其内部引用了 Node.js 的stream、buffer、events等模块,通常需要在构建工具中配置 Polyfill(或引入官方提供的预构建前端产物exceljs/dist/exceljs.min.js),且未压缩前体积接近 1MB,需要注意移动端首屏加载开销。
3. 公式单元格与计算值
当单元格包含公式(如 =SUM(A1:A10))时,Excel 文件中通常同时保存了“公式字符串”和“上次保存时的计算结果缓存”。
- 在 SheetJS 中,公式保存在
cell.f中,计算值保存在cell.v中。默认情况下sheet_to_json读取的是cell.v。 - 在 ExcelJS 中,如果单元格是公式类型,
cell.value返回的是一个复合对象{ formula: 'SUM(A1:A10)', result: 100 }。如果直接将其作为标量拼装成 JSON,会造成下游系统类型异常,必须显式取cell.value.result。
七、选型决策总结矩阵
综合以上分析,选型不应停留在抽象的“谁更好”,而应精确匹配业务的硬性约束条件。通过下方的决策矩阵与分支推荐,可以迅速确定最匹配的技术栈:
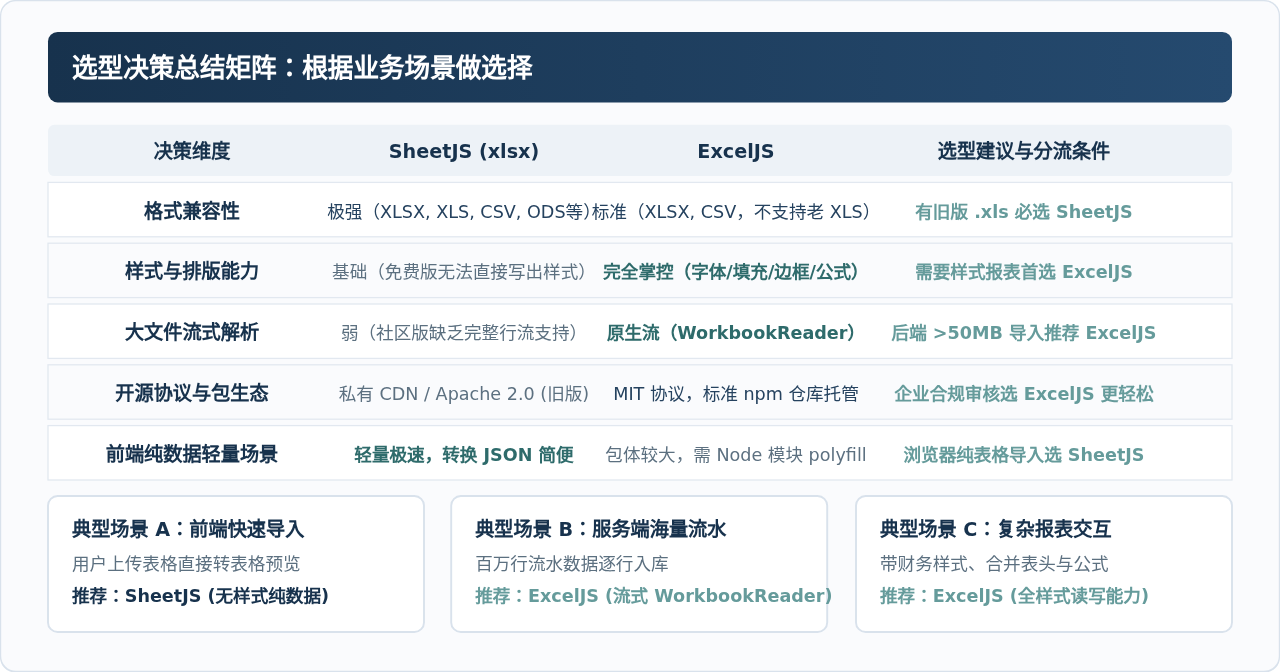
最终选型决策清单:
- 必须选 SheetJS 的情况:
- 业务输入中明确包含老旧二进制
.xls格式(Excel 97-2003),且无法强制用户在上传前转换格式。 - 纯前端环境下的轻量数据导入/导出,追求最快的数据转换速度与最简单的集成方式,不需要处理复杂单元格样式。
- 业务输入中明确包含老旧二进制
- 必须选 ExcelJS 的情况:
- 企业级报表导出需求,对表格外观有严格要求(包括表头背景色、自定义字体、边框分割线、冻结行列窗格、数据验证下拉框或嵌入图片)。
- 服务端 Node.js 导入超大体积 Excel(50MB 以上或几十万行),需要利用
WorkbookReader流式管道防止 Node 进程 OOM 崩溃。 - 团队非常注重开源合规,要求所有生产依赖必须遵循宽松标准的 MIT 开源协议并托管于 npm 官方仓库。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章