
深入解析如何利用JavaScript迭代器与异步生成器优雅处理无限数据流与接口分页数据。从底层拉取机制、内存优化、实战代码到流式管道与资源终止,实现O(1)内存的高效数据消费。

当前位置:首页 > JavaScript 异步编程 > 正文
使用JS迭代器处理无限数据流或分页数据
作者:半夏
时间:2026-11-05
浏览:231
文章目录
技术解析
JavaScript / ES6+
异步迭代器
性能与内存优化
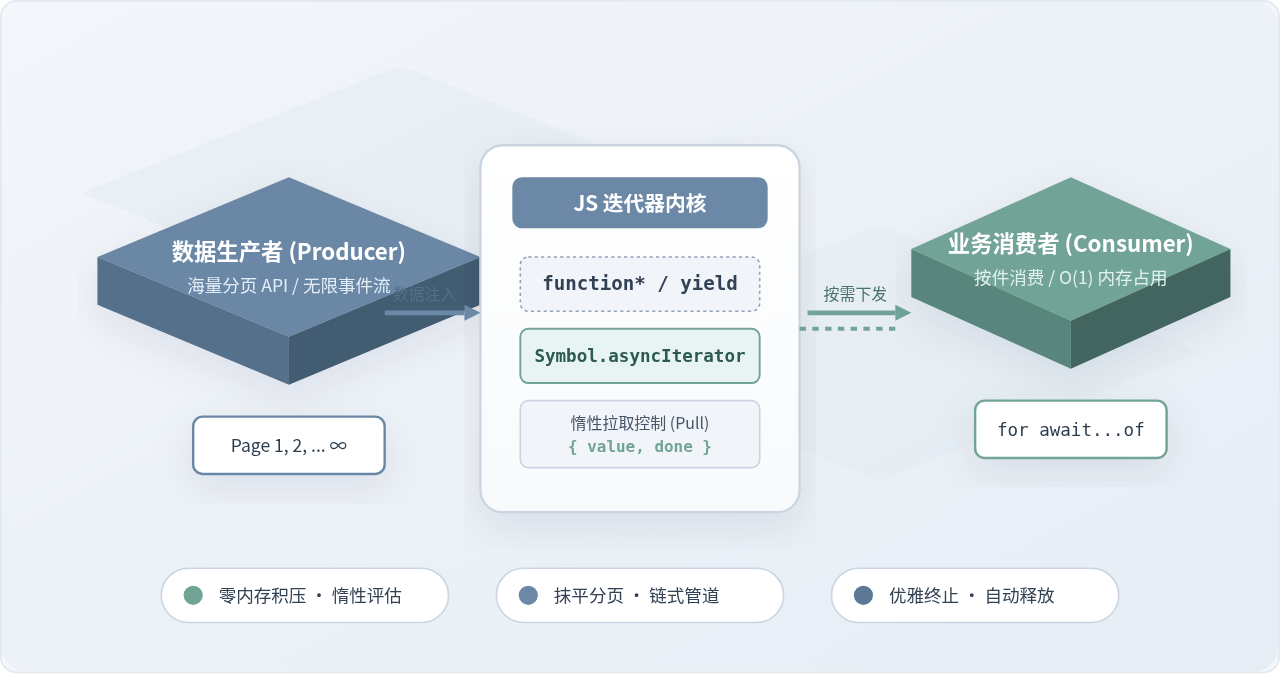
在前端与 Node.js 业务开发中,面对成千上万条记录的分页接口或源源不断产生的事件、时间戳等无界数据流,传统数组一次性加载的做法极易造成内存暴涨、主线程停顿与首屏长时间等待。处理这类场景最优雅且高性能的方案,是利用 JavaScript 原生的迭代协议(Iterator Protocol)与异步生成器(Async Generator)。通过将数据生产与消费解耦,变全量推送为按需拉取(Pull-based),以恒定的 $O(1)$ 内存占用抹平多页接口的请求边界,让海量乃至无限数据可以像遍历普通列表一样自然流转。
一、为什么传统数组会失效:从推模式到拉模式的转变
当我们在前端拉取一个拥有上万条记录的导出任务,或者在后台抓取第三方分页接口时,最直觉的写法往往是创建一个空数组 const allItems = [],通过循环逐页抓取并用 allItems.push(...pageData) 拼接,直到所有数据全部下载完毕再返回给业务层。
这种做法在数据量极小(如几十条记录)时简单有效,但本质上属于推模式(Push / Eager Loading)。生产者强行把所有数据一次性塞入内存,导致了三个致命的架构缺陷:
- 内存消耗与数据规模成正比($O(N)$ 激增):随着数据量从成百上千扩展到数十万,大数组会持续霸占堆内存,极易诱发频繁的垃圾回收卡顿(GC Pause)甚至触发
FATAL ERROR: Ineffective mark-compacts near heap limit Allocation failed - JavaScript heap out of memory崩溃。 - 首项等待延迟(TTFI - Time To First Item)极高:调用方无法在收到第 1 条数据时就开始处理,必须等待全部网络请求全部完成后才能开始工作,造成严重的界面白屏或任务挂起。
- 无法表达“无限”与“无界”:如果面对的是连续不断的 WebSocket 推送、滚动窗口生成器或自增序列,数组根本无法表达无界概念,强行 push 必然爆满内存。
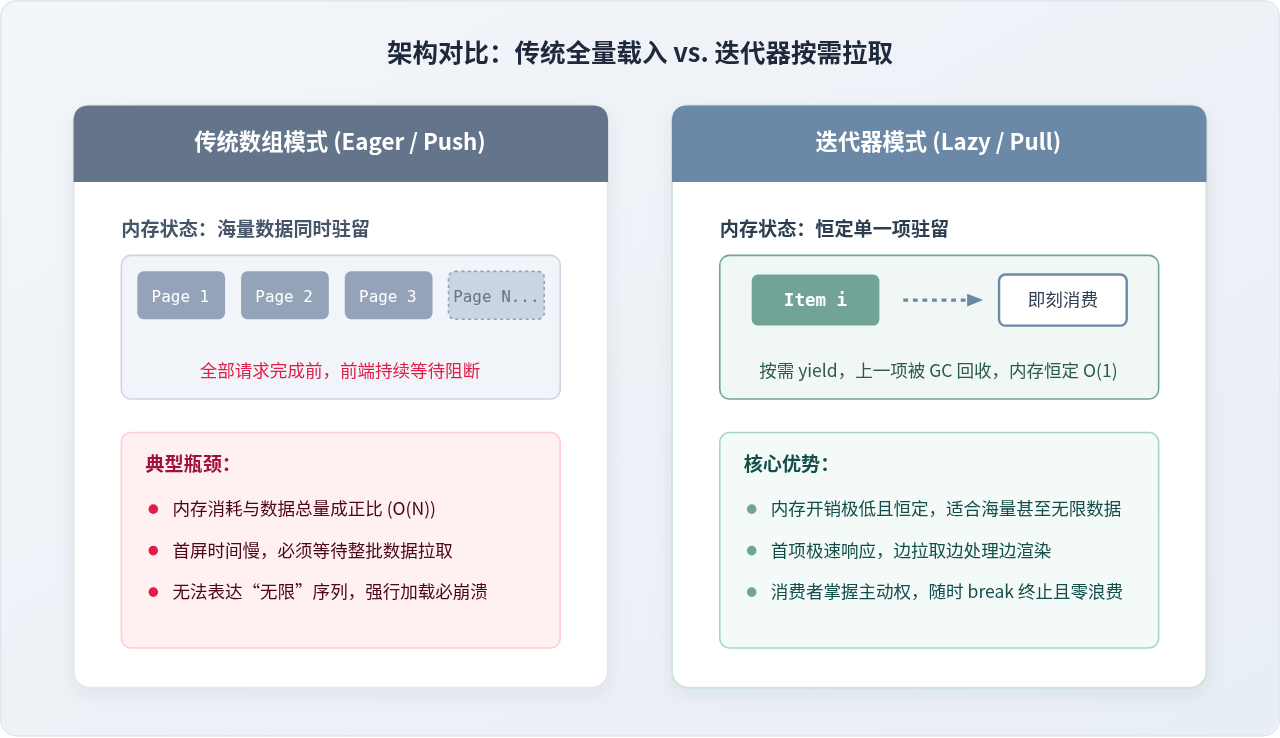
迭代器模式(Pull-based / Lazy Evaluation)彻底颠覆了这一关系。生产者并不一次性产生所有数据,而是定义一个“生产契约”。只有当消费者明确调用 next() 索取下一个元素时,生产者才会计算或拉取当前这一个数据项并立即交付给消费者。消费完毕后该项即可被垃圾回收,整个流转过程中的内存占用始终恒定在 $O(1)$。
二、基础机制:用同步生成器表达无界无限流
在深入异步接口前,我们需要掌握 JavaScript 迭代协议的基本运转机制。JavaScript 原生定义了两个关键协议:
- 可迭代协议(Iterable Protocol):一个对象只要实现了
[Symbol.iterator]()方法,且该方法返回一个迭代器,它就是可迭代的(可被for...of、解构赋值遍历)。 - 迭代器协议(Iterator Protocol):一个拥有
next()方法的对象,每次调用返回形如{ value: any, done: boolean }的对象。
手动书写带有状态闭包的 next() 容易出错,ES6 提供的生成器函数(function*)大幅简化了这一过程。生成器函数内部可以使用 yield 关键字,在产出当前值后暂停执行,并保留所有局部变量与调用上下文,直到外部再次请求才恢复运行。
代码示例:构建一个无界无限流
以下代码展示了一个无界的序列生成器与滑动窗口时间戳发生器。它包含一个看似“死循环”的 while (true),但因为 yield 的暂停特性,它绝不会耗尽 CPU 或阻塞主线程:
// 无限自增 ID 生成器(无界数据流)
function* infiniteSequence(start = 1, step = 1) {
  let current = start;
  while (true) {
    yield current;
    current += step;
  }
}

// 消费者主动决定拉取多少,避免无限循环
const idGenerator = infiniteSequence(1001, 2);

console.log(idGenerator.next().value); // 示例输出: 1001
console.log(idGenerator.next().value); // 示例输出: 1003
console.log(idGenerator.next().value); // 示例输出: 1005
注意:直接对无限迭代器执行
for (const x of infiniteSequence()) 会导致无限死循环!处理无限流时,必须在循环内部设置明确的退出条件(如 break),或者通过管道截断操作符控制消费数量。
三、实战突破:异步生成器抹平分页 API 请求
实际业务中最常见的无界或大数据流其实是后端分页接口(Pagination API)。通常服务端受限于性能,单次请求只返回 20 或 50 条记录,并附带 nextPage 序号或 nextCursor 游标。
传统代码通常要求调用方层层传递页码参数,写出一堆包含递归 fetch 的模板代码。而利用 ES2018 引入的异步迭代器(Symbol.asyncIterator)与异步生成器(async function*),我们可以把跨越多次网络 I/O 的分页操作彻底封装成一个平滑的、打平的单项数据流。
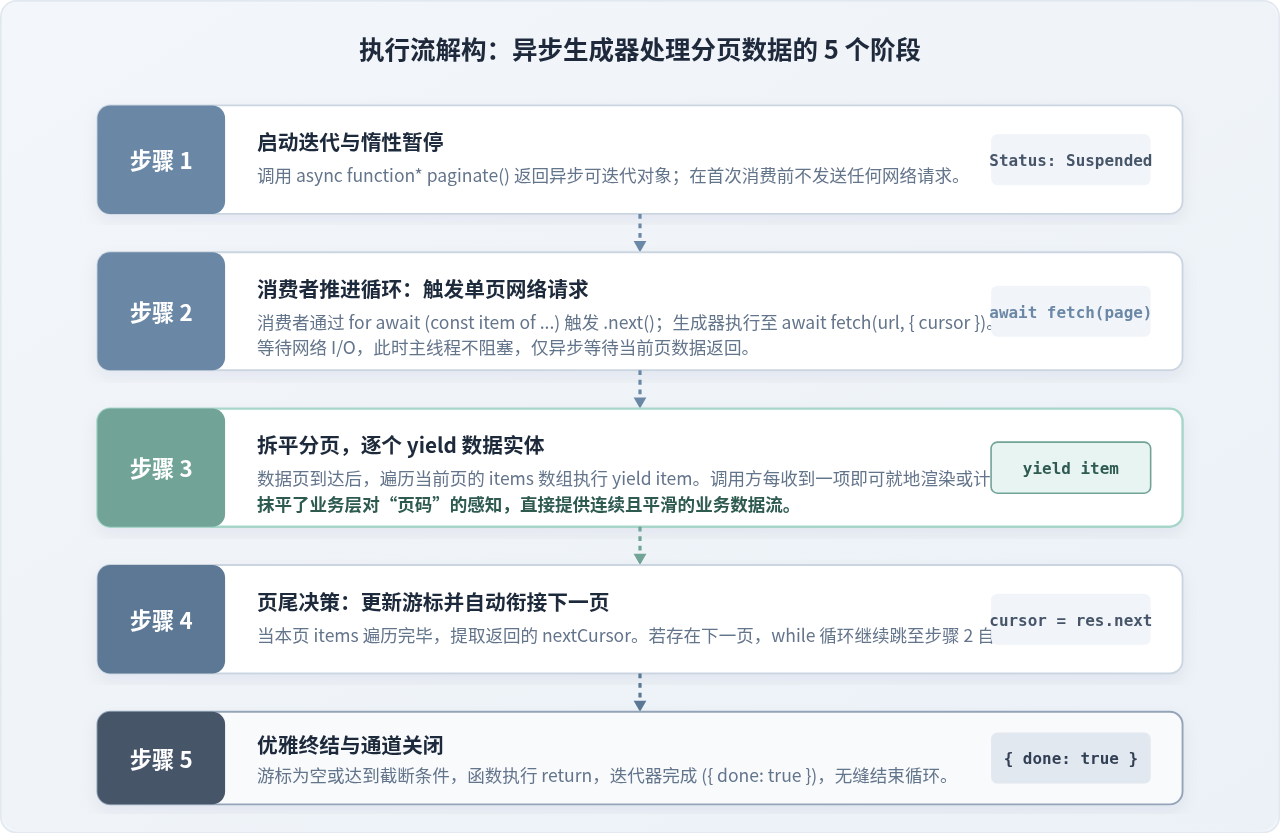
核心步骤拆解
阶段 1 初始化与惰性挂起
调用封装后的 paginateUsers() 函数,此时并不会触发网络请求,仅返回一个实现了 Symbol.asyncIterator 的异步生成器对象。
阶段 2 消费者按需推进请求
当外部通过 for await (const user of paginateUsers()) 循环或者手动调用 await gen.next() 时,函数内部开始执行,向远端发起第一页 HTTP 请求。
阶段 3 打平当前页数据并逐个 yield
拿到单页响应后,函数内部循环遍历该页内的每项数据执行 yield item。外部消费者每收到一个实体就立即执行业务渲染或保存,内存中永远只驻留当前处理的那一条记录。
阶段 4 页尾自动检测与游标跃迁
当前页数据被全部消费后,循环自然到达底部。生成器检查响应中的 hasMore 或 nextCursor,若仍有后续数据,自动递增页码并发起下一轮请求;若无数据则退出。
阶段 5 循环终结与信道关闭
当没有更多页面时,函数执行完毕并返回 { value: undefined, done: true },异步循环自然终结,无需外部介入。
完整可执行代码:通用分页异步迭代器封装
/**
 * 模拟一个带有网络延迟的远程游标分页接口
 * @param {string|null} cursor 游标标识
 */
async function fetchUserPageApi(cursor = null) {
  await new Promise(resolve => setTimeout(resolve, 80)); // 模拟 80ms 网络延时

  const pageIndex = cursor ? parseInt(cursor, 10) : 1;
  const pageSize = 3;
  const totalPages = 4; // 假设总共有 4 页

  if (pageIndex > totalPages) {
    return { items: [], nextCursor: null };
  }

  const items = Array.from({ length: pageSize }, (_, i) => ({
    id: (pageIndex - 1) * pageSize + i + 1,
    name: `User_${(pageIndex - 1) * pageSize + i + 1}`,
    page: pageIndex
  }));

  return {
    items,
    nextCursor: pageIndex < totalPages ? `${pageIndex + 1}` : null
  };
}

/**
 * 异步生成器:将分页网络接口抹平为单项数据流
 */
async function* paginateUsers() {
  let cursor = null;

  while (true) {
    const { items, nextCursor } = await fetchUserPageApi(cursor);

    // 逐个产出实体对象,调用方每获取一个即可立即处理
    for (const item of items) {
      yield item;
    }

    // 没有下一页则直接退出生成器
    if (!nextCursor) {
      break;
    }

    cursor = nextCursor;
  }
}

// 业务调用侧:使用 for await...of 消费,代码如同遍历本地数组一样平滑
(async () => {
  console.log("开始按件拉取分页数据...");
  for await (const user of paginateUsers()) {
    console.log(`消费实体: ID=${user.id}, Name=${user.name} (来自Page ${user.page})`);
  }
  console.log("全部页面拉取并消费完毕!");
})();
代码效果解析:从调用方的视角看,
for await...of 内部完全感受不到分页参数、游标变更和递归逻辑。当拿到第 1 页的第 1 条数据时,循环体立刻执行,UI 能够秒级呈现首项;而只有当前页的条目被全部遍历后,内部的 while 循环才会发起下一页网络请求,自动形成了优雅的背压(Backpressure)控制。
四、流式管道组合:高阶惰性操作符
在许多业务场景下,我们并不需要消费全部的分页数据。例如用户在一个含有数万条日志的接口中搜索“最近 5 条错误日志”,或者在无限流中只需要前 $N$ 个符合条件的指标。
如果使用常规数组的 .filter().slice(0, 5),我们必须先把所有数据下载完成并过滤完毕再切片,浪费了海量的网络与计算资源。通过将异步生成器串联成操作符管道(Pipeline),我们可以实现“只下载匹配所需数量的最小数据”,达成彻底的惰性过滤。
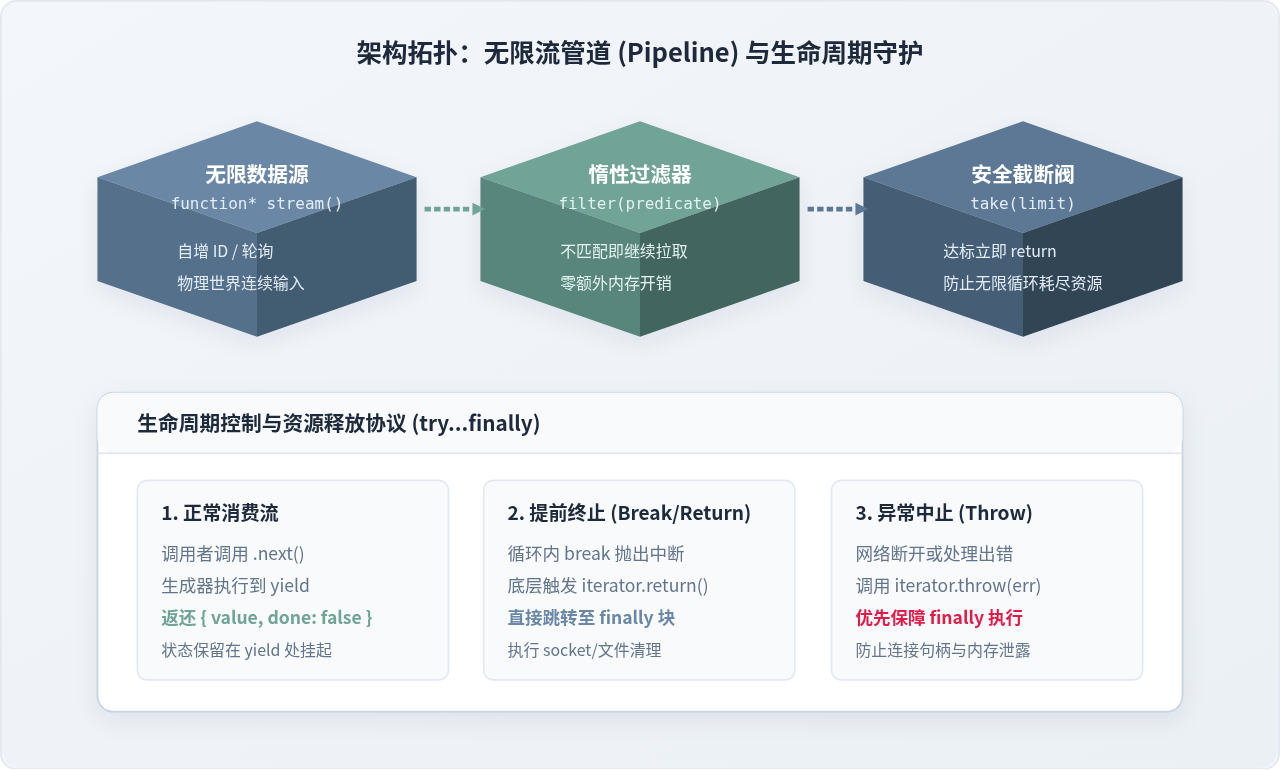
实现轻量级流式操作符
// 操作符 1: 截断操作符 take(asyncIterable, count)
async function* take(source, limit) {
  let count = 0;
  for await (const item of source) {
    if (count >= limit) return;
    yield item;
    count++;
  }
}

// 操作符 2: 过滤操作符 filter(asyncIterable, predicate)
async function* filter(source, predicate) {
  for await (const item of source) {
    if (await predicate(item)) {
      yield item;
    }
  }
}

// 操作符 3: 转换操作符 map(asyncIterable, transform)
async function* map(source, transform) {
  for await (const item of source) {
    yield await transform(item);
  }
}

// 组合消费示例:只提取符合偶数 ID 的前 3 个用户
(async () => {
  const rawStream = paginateUsers();
  const evenUsers = filter(rawStream, user => user.id % 2 === 0);
  const topThree = take(evenUsers, 3);

  for await (const user of topThree) {
    console.log("匹配用户:", user);
  }
  // 示例输出: 匹配 User_2, User_4, User_6。一旦满足 3 个,剩余页面绝不会再发起请求!
})();
五、生命周期与异常安全:清理与优雅终止
当消费者在使用 for await...of 循环时,可能会因为业务逻辑主动执行 break、return,或者在处理某条数据时抛出了未捕获的异常。
此时如果生成器内部打开了数据库游标、建立了 WebSocket 连接、启动了定时器轮询或持有着未完成的 HTTP 请求,如果未能妥善清理,就会发生严重的连接泄露与挂起。
1. 底层原理:迭代器的 return() 协议
当外部循环被 break 中断时,JavaScript 运行时会主动检查该迭代器是否拥有 return() 方法。如果有,运行时会先调用该方法,通知生成器“消费提前终止”。
在生成器函数内部,这个 return() 调用会被映射为一个强制跳转:直接跳转到外层的 finally 块中执行。因此,任何需要回收的资源,都必须包裹在 try...finally 结构中。
2. 支持 AbortSignal 的安全生成器
async function* safePaginateWithAbort(endpoint, signal) {
  let page = 1;
  let activeController = new AbortController();

  try {
    while (true) {
      // 如果外部已发出取消信号,直接终止
      if (signal?.aborted) {
        throw new Error("操作已由外部取消");
      }

      const response = await fetch(`${endpoint}?page=${page}`, {
        signal: signal || activeController.signal
      });
      const data = await response.json();

      if (!data.list || data.list.length === 0) break;

      for (const item of data.list) {
        yield item; // 若调用者在此处 break,立刻跳转至下方 finally
      }

      page++;
    }
  } finally {
    // 极其关键:无论正常完成、break中断还是异常抛出,均会执行此处
    console.log("[资源释放] 迭代通道已终止,执行断开连接与取消在途请求");
    activeController.abort();
  }
}
六、常见误区与生产环境检查清单
在实际项目落地迭代器处理流与分页时,开发者经常会因为对异步协议细节理解偏差而踩入陷阱。以下是三个最普遍的问题与对应排查手段:
| 常见误区 | 典型错误写法 | 正确解决思路 |
|---|---|---|
| 误区一:混淆 Promise.all 与迭代器 | 面对批量拉取一律采用 Promise.all(pages.map(fetch)) 并发抓取 |
并发请求会瞬间冲击服务端并耗尽前端带宽;异步迭代器建立的是串行按需流,需高并发可配合带并发限制的滑动窗口 Worker 池。 |
| 误区二:在普通 for...of 中消费异步生成器 | 写出 for (const item of asyncGen()) 导致 item 拿到的全是处于 Pending 状态的 Promise 对象 |
必须使用带有 await 的语法:for await (const item of asyncGen()),才能逐项解包 Promise。 |
| 误区三:无限生成器缺少熔断退出 | 在业务代码中未引入计数器或中断阀直接持续循环消费 | 在管道顶层必须封装 take(n) 或设置超时限制(AbortSignal.timeout(ms)),防止不可逆的死循环耗尽服务器。 |
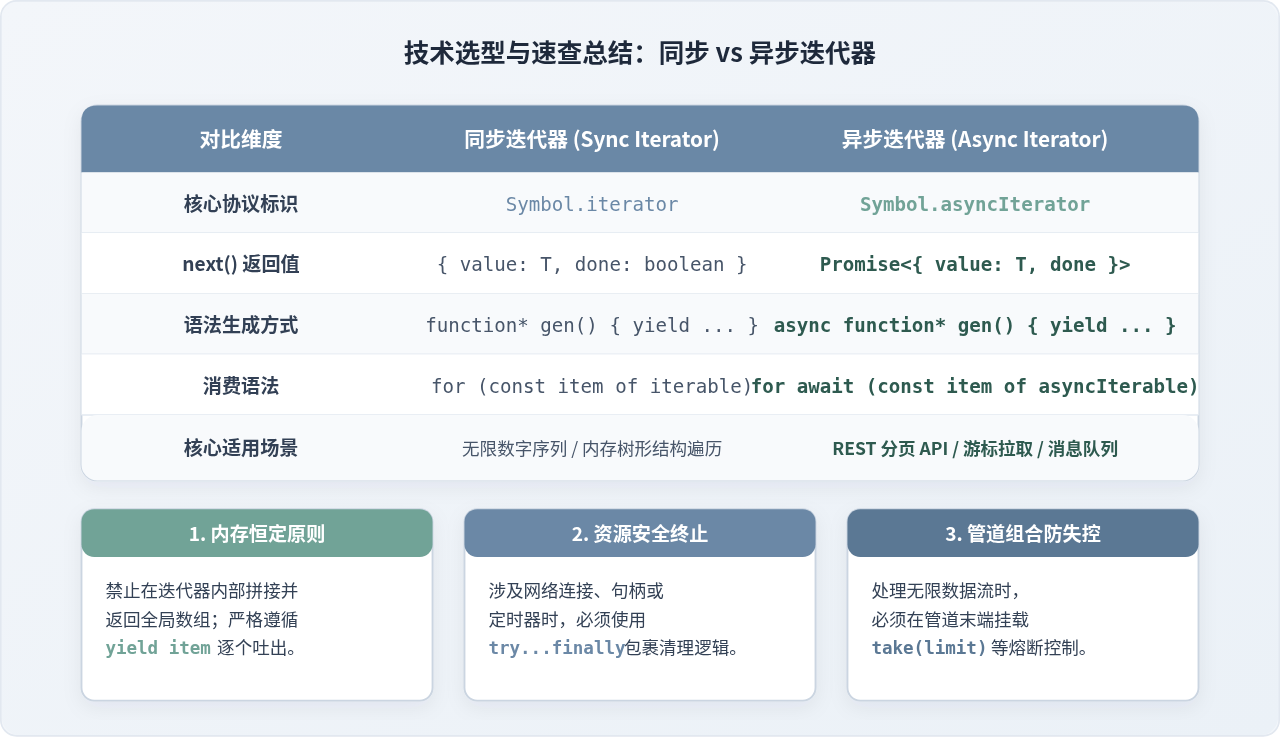
七、总结
使用 JavaScript 迭代器与异步生成器处理无限数据流或分页数据,核心在于建立了一种由消费者主导的拉取机制(Pull-based Architecture):
- 架构解耦:数据生产者只关心如何获取单页或单项数据,消费者只关心业务逻辑处理,复杂的翻页状态、游标跟踪与网络重试全部内聚在迭代器之中。
- 极佳的内存与首屏表现:杜绝了数组全量积压对堆内存的吞噬,内存开销恒定保持在 $O(1)$,同时让首项数据到达后即可立刻投入渲染与处理。
- 组合度极高:借助原生的
function*与async function*,我们可以在完全不依赖庞大响应式框架的前提下,写出直观优雅的filter、map、take流式管道。 - 生命周期安全可控:结合
try...finally与AbortController,无论正常遍历结束还是被中途break打断,底层资源与网络连接都能得到确定性的回收。
掌握这一范式,能够让你的 JavaScript 代码在面对海量日志导出、大文件流式解析、长列表滚动和跨页数据聚合等复杂场景时,展现出高弹性与高稳健度。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章