

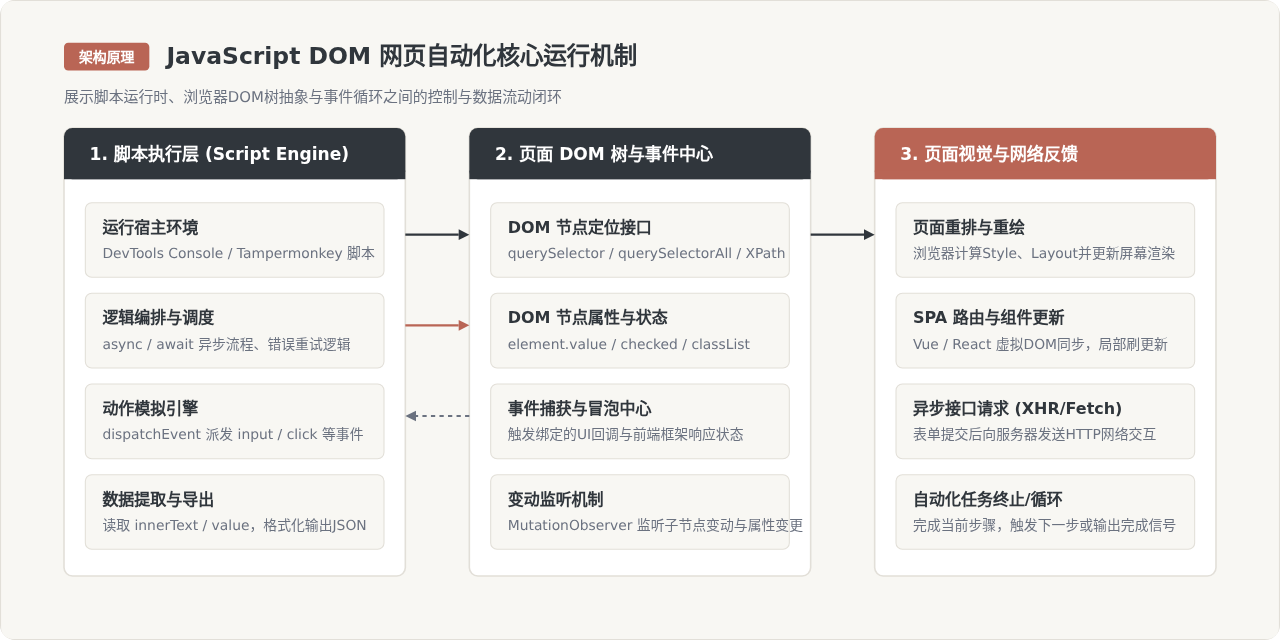
详细讲解如何使用原生JavaScript操作DOM实现网页自动化,涵盖元素精确定位、异步加载等待、表单事件仿真及现代前端框架避坑策略,并配有执行原理与架构SVG图解。
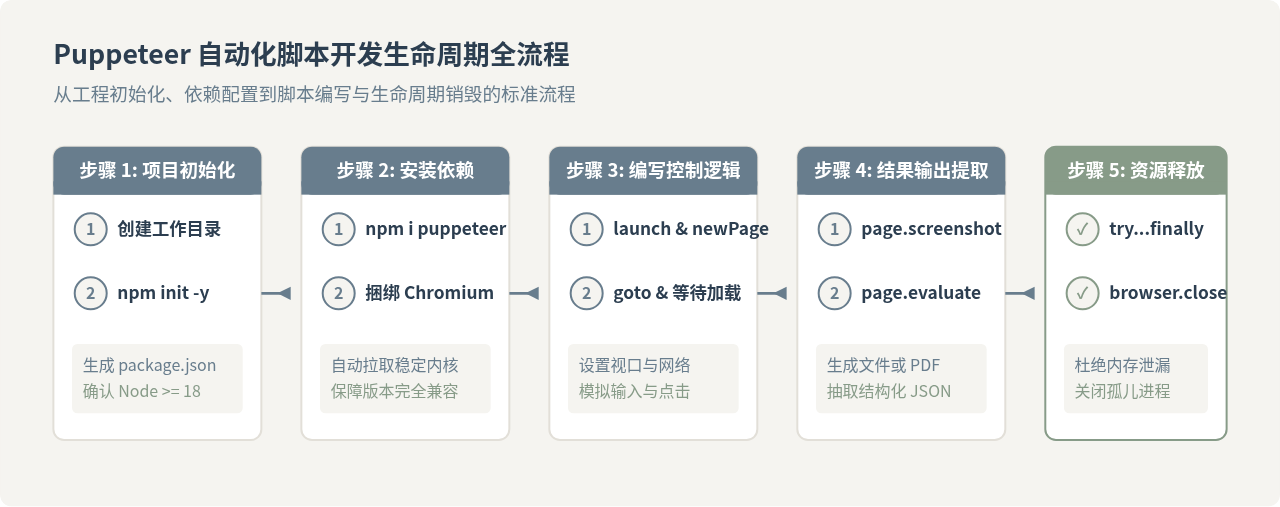
详细讲解如何使用Puppeteer编写JavaScript无头浏览器自动化脚本,涵盖环境搭建、核心架构原理、网页截屏、表单交互与数据抓取、有头与无头模式对比以及生产环境稳健运行的最佳实践。
本文介绍如何利用Node.js和Playwright进行页面性能自动化测试。通过调用浏览器提供的性能API,如导航时间、资源加载、绘制时间及长任务监控,结合WebVitals指标,实现对网站速度的自动化检测与回归,帮助前端工程师快速定位并优化性能瓶颈。
本文介绍如何使用 Node.js 和 Playwright 自动化测试工具,结合 2Captcha 验证码识别服务,解决 B 站 Geetest 验证码导致的自动登录难题。通过拦截接口获取参数、调用 2Captcha API 识别验证码,并模拟用户操作完成登录流程,提供完整的代码实现与步骤解析。
本文详解如何利用Node.js和Puppeteer进行复杂网页数据抓取。文章解析了Puppeteer的Browser、Page和Frame架构,对比了其与Cheerio的区别,并通过TypeScript实现了一个抓取淘宝商品信息的完整案例。内容涵盖代码结构、性能优化、多进程处理及错误处理机制,为开发者提供从理论到实践的完整参考。
本文介绍如何使用 Node.js 的 Puppeteer 库进行网页爬取。通过配置 launch 参数启动无头浏览器,利用 page 对象导航至豆瓣电影页面,提取电影标题、评分及海报等数据。最后,演示如何将抓取到的网页内容直接转换为 A4 规格的 PDF 文件,实现资源抓取与文档生成的完整流程。
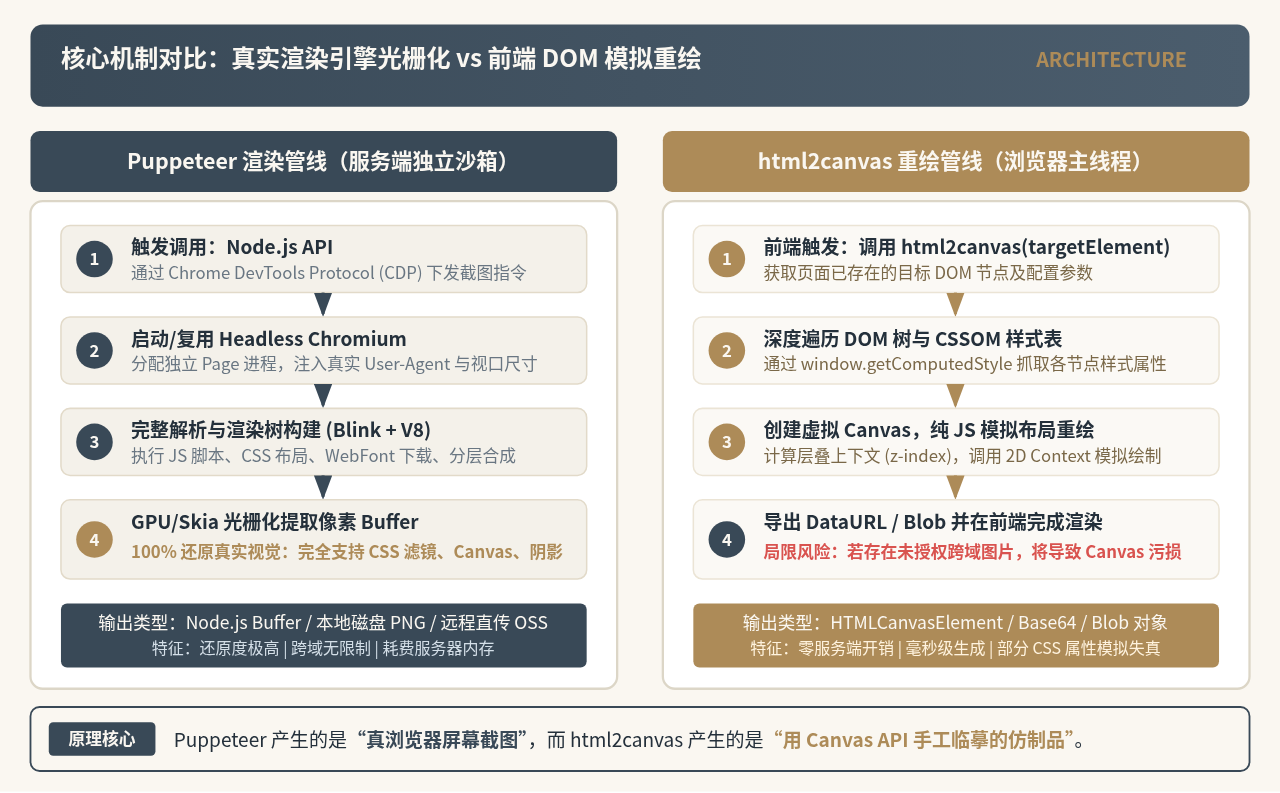
深度对比 Puppeteer 服务端真实 Chromium 渲染与 html2canvas 客户端 DOM-Canvas 模拟重绘两套 JavaScript 网页截图技术方案,从核心原理、实现步骤、保真度、跨域处理到服务器开销全面剖析并提供明确选型指南。
本文演示如何利用 PyQt5 的 QWebEngineView 加载网页,并通过 QWebEngineProfile 全局注入 JavaScript 脚本。脚本依据 URL 路径判断页面状态并自动执行点击、填值等交互操作,以廉价机票预订网站为例,展示从加载网页到自动化操作的完整流程与代码实现。