

1. Redis持久化 关于Redis的数据持久化,主要包含三种方式:RDB快照、AOF日志以及混合持久化。它们各有特点,也各有优劣,下面逐一介绍。 1.1 RDB快照 RDB快照的原理是将内存中的全部数据生成一个“快照”保存到磁盘中。当Redis重启时,直接加载这个快照即可恢复数据。由于RDB保存
Redis分布式缓存方式:RDB、AOF和主从同步
作者:技术拾光
时间:2026-07-25
浏览:114
文章目录
1. Redis持久化
关于Redis的数据持久化,主要包含三种方式:RDB快照、AOF日志以及混合持久化。它们各有特点,也各有优劣,下面逐一介绍。
1.1 RDB快照
RDB快照的原理是将内存中的全部数据生成一个“快照”保存到磁盘中。当Redis重启时,直接加载这个快照即可恢复数据。由于RDB保存的是全量数据,手动执行save可能会阻塞主线程,因此生产环境中通常使用bgsave——通过fork一个子进程在后台处理。
配置方式也很直观,例如:
# 900秒内,如果至少有1个key被修改,则执行bgsave
save 900 1
save 300 10
save 60 10000
注意:如果设置为 save "" 则代表禁用RDB。
问题:执行快照期间,数据还能被修改吗?
答案是肯定的。bgsave采用写时复制(Copy-on-Write)技术:主进程fork出一个子进程,并复制页表。主进程读取数据时,直接通过页表映射到磁盘;若主进程需要写入数据,则会创建一份副本,子进程将这份副本写入新的RDB文件。整个过程互不干扰。
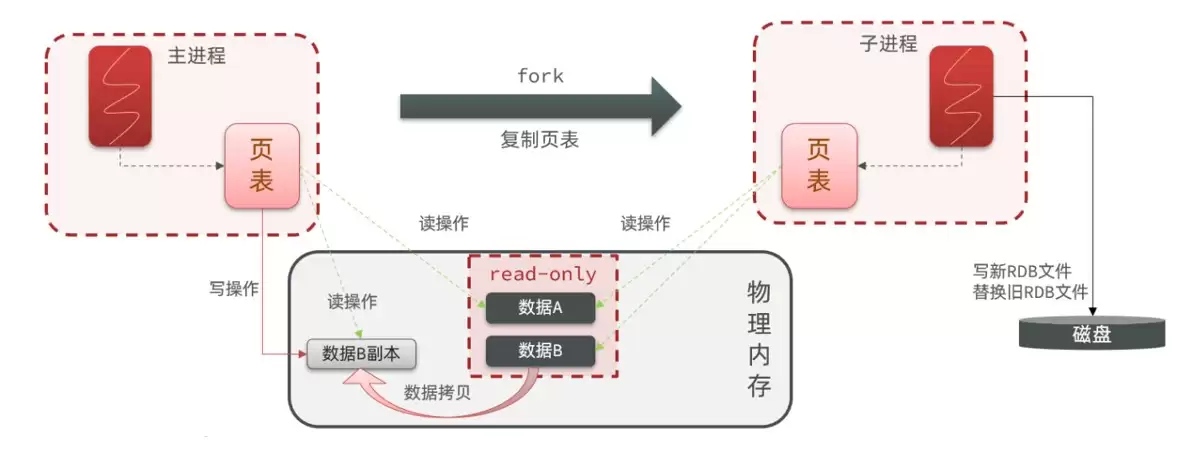
RDB的bgsave流程总结:
- fork主进程得到子进程,共享内存空间
- 子进程读取内存数据,异步写入新的RDB文件
- 用新RDB文件替换旧的RDB文件
RDB触发时机有哪些?
- 默认服务停止时自动执行
- 手动执行save或bgsave
- 满足配置条件,如
save 60 1000表示60秒内至少有1000次写操作,则触发bgsave
RDB的缺点也比较明显:
- 两次快照之间间隔较长,一旦宕机,这段时间内写入的数据就会丢失
- fork子进程、压缩、写RDB文件都比较耗时,对性能有一定影响
1.2 AOF日志
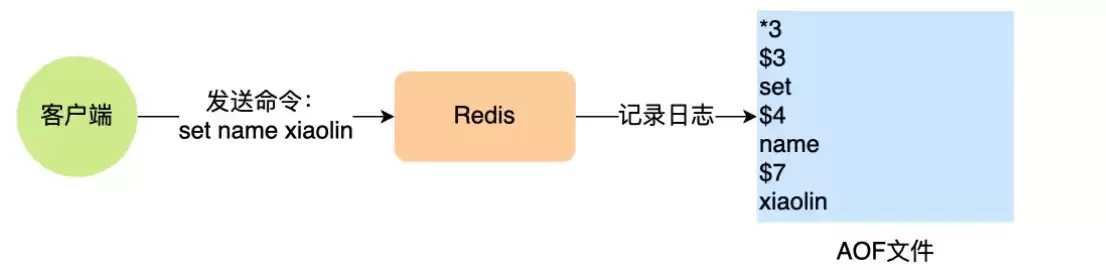
AOF的思路与RDB不同:它记录的是每条写命令本身。Redis执行完写命令后,将该命令追加到一个文件中。重启时,逐条执行文件中的命令,即可恢复数据。
1.2.1 AOF的三种回写策略
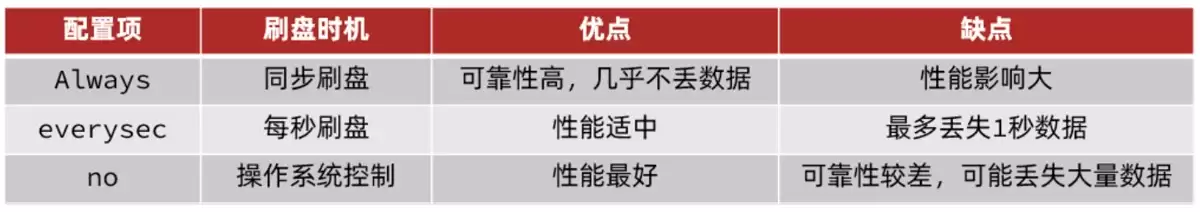
- Always:每执行一个命令就立即写入AOF文件,安全性最高但性能最差
- Everysec:命令先写入缓冲区,每过1秒将缓冲区内容刷到AOF文件,属于折中方案
- No:命令同样先进缓冲区,但由操作系统决定何时刷盘,不可控
1.2.2 AOF重写机制
AOF文件会随着命令增多而变得越来越大,因此Redis提供了重写机制:直接读取数据库当前的键值对,用最少的命令(如批量命令)记录,然后替换掉旧的AOF文件。举例说明:
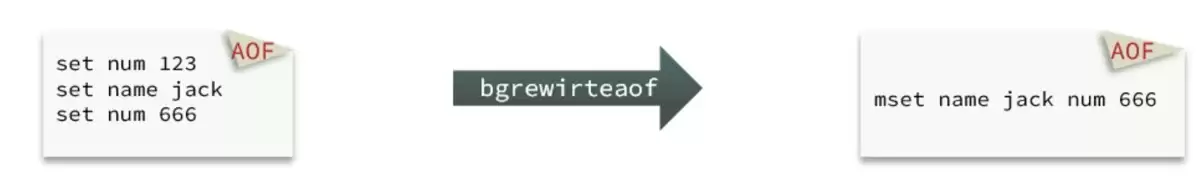
原本三个命令修改了两次num,但只有最后一次set才是有效操作。既然都是set,完全可以合并成一条mset命令。重写就是实现这个目的——删除冗余,精简文件。
重写过程:主进程fork一个子进程,父子进程共享物理内存。子进程只读内存,读取所有键值对,转化为一条条命令写入新的AOF文件。与此同时,主进程仍然可以正常处理命令——但问题来了:主进程在处理新写入时,子进程和主进程的内存数据就不一致了,如何解决?
Redis的解决方法是引入AOF重写缓冲区。主进程每执行一个写命令,会同时写入两个地方:原来的[AOF缓冲区]和[AOF重写缓冲区]。
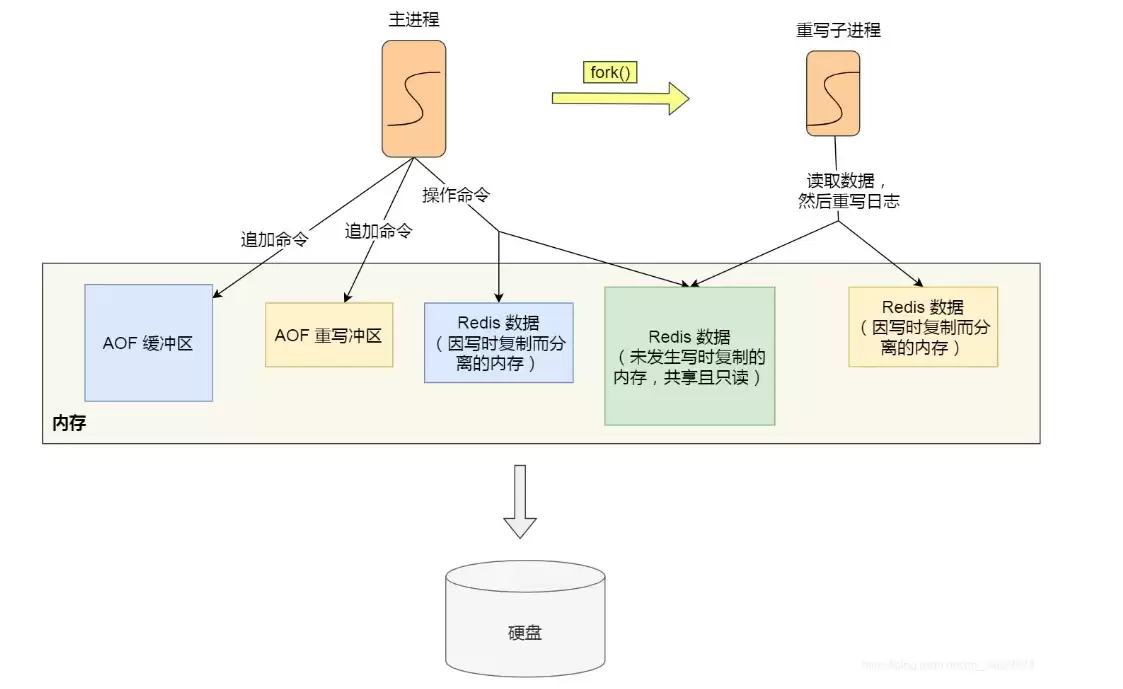
子进程完成重写后,向主进程发送信号。主进程收到信号后,调用信号处理函数:将AOF重写缓冲区中的所有内容追加到新AOF文件末尾,然后用新文件覆盖旧文件。这样,数据就完全同步了。
1.3 RDB和AOF对比
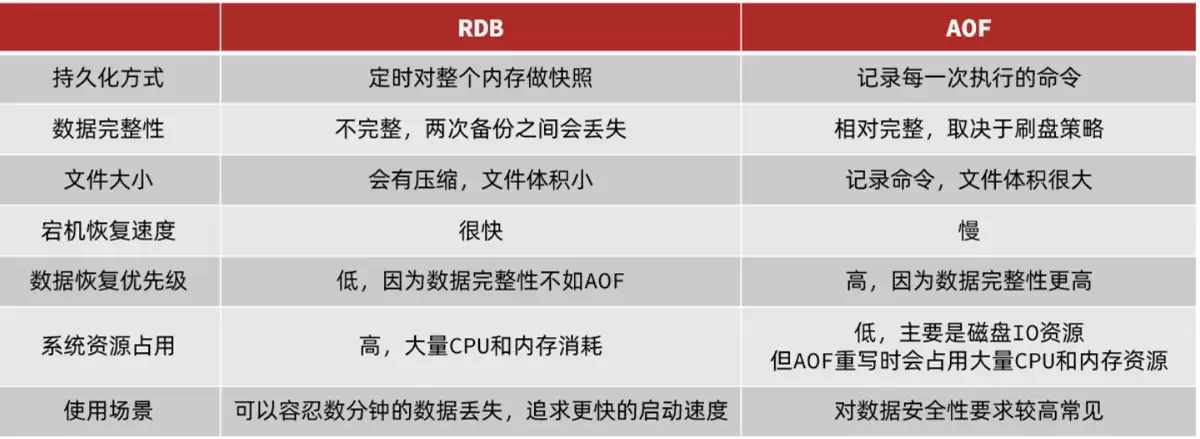
两者各有优劣:RDB恢复快但可能丢失数据;AOF数据更安全但文件大、恢复慢。那么能否结合两者优点?
1.4 混合持久化
混合持久化正是取长补短的产物:AOF文件前半部分是RDB格式的全量数据,后半部分再追加AOF格式的增量命令。这样既兼顾了RDB的恢复速度,又保留了AOF的细粒度。
缺点也很实际:可读性差,兼容性差——旧版Redis无法识别这种混合文件。
2. Redis主从复制
单机Redis再强大也担心宕机。解决办法很简单:部署多台服务器,将数据同步过去。这种同步机制就是主从复制。
2.1 第一次同步
主从第一次握手的过程,可以分为三个阶段:
- 建立连接、协商同步
- 主服务器全量同步数据
- 主服务器持续发送新写命令
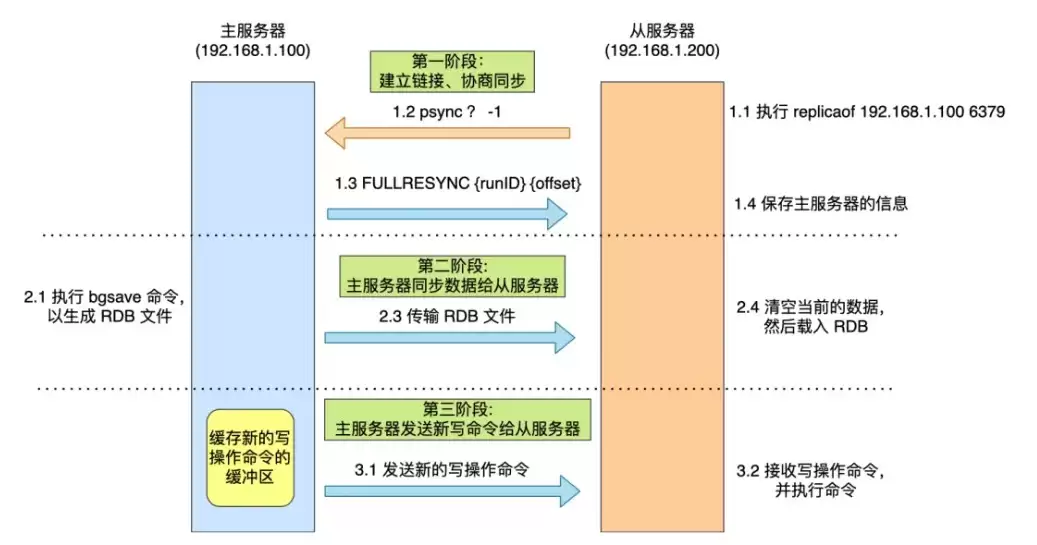
第一阶段:建立连接,协商同步
- 从服务器执行
replicaof命令后,向主服务器发送psync命令,表示要同步。 - 命令中包含两个参数:
runID(服务器唯一标识)和offset(复制进度)。 - 主服务器判断:如果runID不同,说明是第一次连接,返回
FULLRESYNC(全量同步),同时附上自己的runID和offset。
第二阶段:主服务器同步数据给从服务器
- 主服务器执行
bgsave生成RDB文件,然后发送给从服务器。 - 从服务器收到后,先清空自己的数据,再载入RDB文件。
- 但主服务器在生成和传输RDB期间,还可能执行新的写操作。这些操作如何保证不丢失?
- 关键:主服务器会将三个时间段内的写操作都记录到
replication buffer缓冲区里——分别是生成RDB期间、发送RDB期间、从服务器加载RDB期间。
第三阶段:主服务器发送新写操作给从服务器
- 从服务器加载完RDB后,发送确认消息。主服务器接着把
replication buffer里的所有写命令发送过去,从服务器一一执行。 - 至此,第一次同步完成,主从数据完全一致。
2.2 命令传播
第一次同步结束后,主从之间会建立一条TCP长连接。后续主服务器执行的写命令,都会通过这条连接实时传播给从服务器,这就是命令传播阶段。
2.3 增量复制
如果主从之间的连接断开了,过一会儿重连,此时不需要再做全量同步——只要把断开期间缺失的命令补上即可,这就是增量复制。
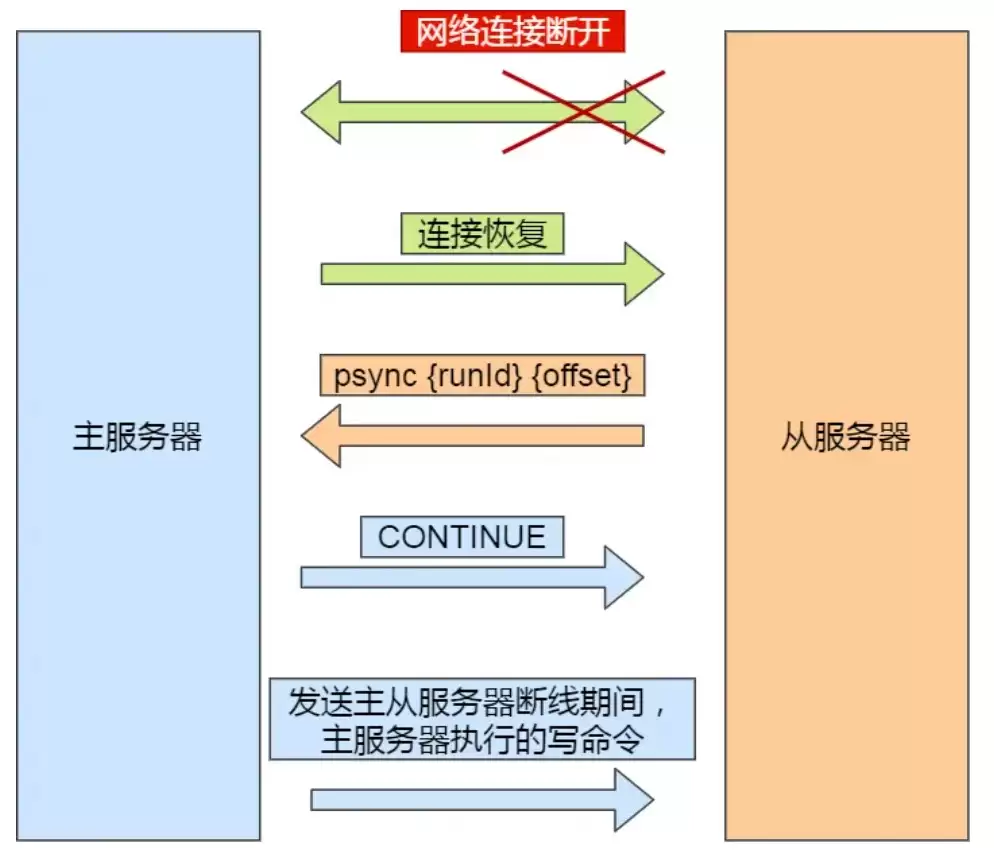
流程分为三步:
- 从服务器再次发送
psync命令 - 主服务器判断runID相同,返回
CONTINUE,通知从服务器走增量同步 - 主服务器将断开期间执行的写命令发送给从服务器,从服务器执行
这里面有两个关键角色:
- repl_backlog_buffer:一个环形缓冲区,专门用于记录最近的写命令。主从断开后,通过它找到差异数据。
- offset:进度标记。主服务器和从服务器各自维护一个offset,通过对比就能计算出缺少哪些数据。
那么repl_backlog_buffer里的内容是什么时候写入的呢?实际上,主服务器在命令传播阶段,也会同步将写命令存入这个环形缓冲区。
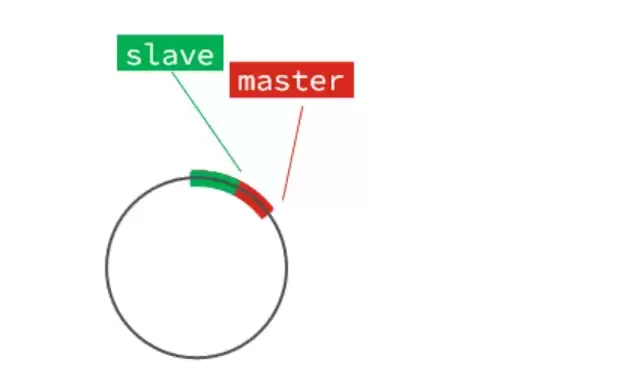
主从之间的offset差,就是需要增量同步的数据量。
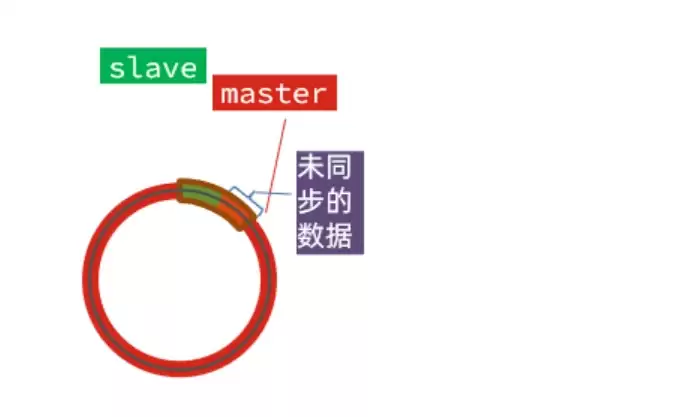
但有一个需要注意的问题:环形缓冲区大小是固定的。如果主从断连时间过长,从服务器未同步的数据被新数据覆盖掉,那么增量复制就无法进行——只能退回到全量同步。
因此,实际部署时,需要合理设置repl-backlog-size,给缓冲区留足余量,避免频繁触发全量同步。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。