

6月24日,上海世博中心。 今年AWS中国峰会的主题是「Agentic Now, Go Build」。 逛下来最大的感受是,大家已经不再热衷讨论模型参数、排行榜,或者谁家的模型更聪明。无论是Keynote还是展区交流,讨论最多的话题其实是Agent如何真正进入生产环境。 过去一年,大模型能力提升很快
Databend在AWS中国峰会展示Agent数据基础设施新思路
作者:技术拾光
时间:2026-06-27
浏览:157
文章目录
6月24日,上海世博中心。
今年AWS中国峰会的主题是「Agentic Now, Go Build」。
逛下来最大的感受是,大家已经不再热衷讨论模型参数、排行榜,或者谁家的模型更聪明。无论是Keynote还是展区交流,讨论最多的话题其实是Agent如何真正进入生产环境。
过去一年,大模型能力提升很快,但真正上手做Agent项目之后会发现,很多问题最后都不是模型本身的问题。
- Trace怎么存?
- Memory怎么管理?
- 实时数据怎么接入?
- 向量检索和分析查询怎么协同?
- 系统规模上来以后成本怎么控制?
这些问题往往比Prompt调优更让人头疼。
最近团队也在参与Agent数据底座建设,所以看到Databend展台时,特意多停留了一会儿。原因很简单——他们展示的几个场景,刚好和我们最近遇到的问题比较接近。
Agent落地之后,数据层开始变得复杂
过去的时候,Databend展台周围已经围了不少人。
有做AI应用的,有做数据平台的,也有不少基础设施工程师。
大家关注点不一样,但提的问题很类似:
- Agent Trace怎么长期存储?
- Memory数据量大了以后怎么召回?
- 实时日志如何处理?
- 向量检索和分析查询能不能用同一套系统?
这些问题最终都会落到同一个方向:数据底座怎么建?
Databend现场展示的内容,基本都围绕这个主题展开。
从架构上看,他们采用Amazon S3作为开放存储层,计算运行在Amazon EC2 Gra viton实例上,上层由Databend Cloud提供数据处理能力。
让人比较关注的是,他们尝试把原本分散在多套系统中的能力放到同一个平台里。包括:
- SQL分析
- JSON处理
- 全文检索
- 向量检索
- 实时增量处理
- AI UDF调用
这些能力单独拿出来都不算新鲜,但若是能基于同一份数据协同工作,确实能减少不少数据搬运和系统维护成本。
对于做基础设施的人来说,这一点还是挺有吸引力的。
Agent数据已经不只是BI数据
过去我们讨论数据平台,很多时候默认服务对象是BI、报表或者离线分析。
但Agent场景不一样。现在的数据里除了业务数据,还有大量:
- Trace
- Memory
- Tool Call
- Prompt
- Embedding
- 日志
- 反馈数据
而且这些数据既要分析,又要搜索,还要参与实时推理过程。
这意味着结构化数据、半结构化数据和向量数据开始同时存在。
Databend展示的思路是把这些数据统一放在对象存储上,通过同一套SQL引擎完成处理和查询。
从能力层面看,主要包括:
- SQL分析与向量化执行
- VARIANT JSON原生处理
- 全文检索与倒排索引
- 向量检索与向量索引
- Task + Stream实时增量处理
- 基于S3的存算分离架构
这一点让人联想到团队之前踩过的一个坑。
当时分析数据在数仓,向量数据在向量数据库,全文搜索又在另一套搜索系统里。
每次排查问题都需要跨系统查数据。
系统越来越多之后,数据同步和运维本身反而成为新的问题。
所以从工程角度来看,如果一份数据能够同时服务分析、检索和AI场景,确实有一定价值。
两个Demo比较有意思:Trace和Memory
现场重点演示了两个场景。
一个是Agent Trace分析。
另一个是Agent Memory Recall。
这两个也是目前Agent系统最容易遇到瓶颈的地方。
Trace:Agent出问题时到底发生了什么
做过Agent的团队应该都有类似经历。
Agent能跑起来并不难。
真正困难的是出了问题以后不知道问题出在哪。
- 某一步为什么调用了工具?
- 为什么走了这条推理路径?
- 哪一次模型输出开始偏离预期?
- Token消耗为什么突然上涨?
如果没有完整的轨迹数据,很多优化工作都只能靠猜。
Databend展示的是一套基于Trace数据的分析方案。
据了解,他们已经在一些大型AI场景中承载大规模Trace数据写入。
对于Trace这种JSON嵌套层级深、Schema经常变化的数据,他们采用VARIANT类型进行原生存储,通过json_transform在库内完成清洗,再结合索引和加速列提升查询效率。
比较有意思的是,他们把Trace数据同时用于:
- Evaluation
- Replay
- Root Cause Analysis
- RL数据管道
也就是说,同一份数据服务多个场景。这个思路很值得关注。
毕竟真正进入生产以后,最大的成本往往不是存储,而是重复建设多套系统。
Memory:百亿级数据怎么查
另一个Demo是Memory Recall。
随着Agent使用时间增长,Memory数据会越来越大。
很多团队会把向量检索和全文检索拆开部署。
结果就是:
- 存两份数据
- 查两次系统
- 最后再自己合并结果
数据量不大的时候问题不明显,但规模上来以后运维复杂度增长很快。
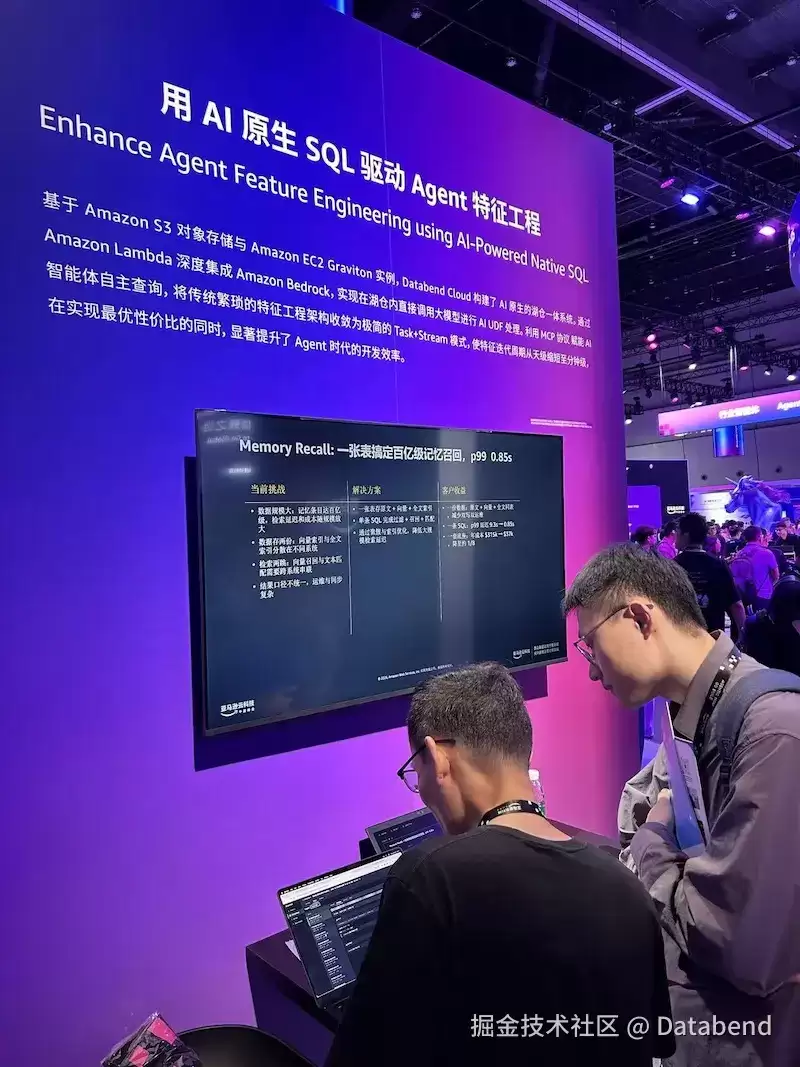
Databend展示的是把原文、向量和索引统一存储在一张表中,通过单次查询完成过滤和召回。
现场展示的数据看起来比较亮眼。
不过作为工程师,更关心的是不同workload下的表现。
毕竟Demo环境和真实生产环境之间永远存在差距。
但从架构思路来看,把分析、检索和Memory放在统一的数据层里,确实值得继续关注。
一个比较接地气的客户案例
除了Agent场景,他们还展示了沉浸式翻译的案例。
这个案例反而觉得更有参考价值。
因为很多团队面临的问题其实不是百亿级Agent数据,而是如何快速搭建一个低运维成本的数据平台。
按照现场介绍,他们通过AWS Marketplace部署Databend Cloud,利用Amazon S3作为数据中转层,再通过Task和COPY INTO实现实时数据导入。
整个方案没有引入太多额外组件。
对于中小团队来说,这种方式确实比较容易落地。
一点感想
逛完整个AWS Summit,越来越觉得Agent基础设施正在进入新的阶段。
过去大家关注模型能力。
现在大家开始关注如何让Agent持续、稳定、低成本地运行。
Agent要访问数据。
要检索记忆。
要分析轨迹。
要调用工具。
还要在反馈中不断优化。
这些需求最终都会落到数据层。
所以未来的数据平台不仅仅是分析平台,还会逐渐承担搜索、检索、上下文管理以及AI工作负载调度的职责。
Databend在展台展示的方向,本质上也是在回应这些变化。
当然,现场Demo和生产环境之间还有距离。
性能、稳定性、多租户隔离、成本模型等问题,最终还要靠真实业务验证。
不过对于正在建设Agent数据基础设施的团队来说,这些思路值得研究。
回去之后,打算拉一个测试环境跑一跑,重点看看Trace存储和Memory Recall两个场景,能不能解决目前遇到的一些问题。
如果后面有新的发现,再单独写篇文章聊聊。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。