

在业务数据出现问题时,最常见的错误并非 SQL 语句写不出来,而是过于匆忙地执行 update 操作。特别是在数据导入场景中,表面上看只是少数金额缺失,但一旦放宽条件,旧批次、退款单、未支付单可能都会被波及。在 KingbaseES 中修复这类数据,语法本身并不复杂,真正的难点在于如何严格控制影响范
线上修复脏数据,别急着全量重来
作者:技术拾光
时间:2026-06-27
浏览:666
文章目录
在业务数据出现问题时,最常见的错误并非 SQL 语句写不出来,而是过于匆忙地执行 update 操作。特别是在数据导入场景中,表面上看只是少数金额缺失,但一旦放宽条件,旧批次、退款单、未支付单可能都会被波及。在 KingbaseES 中修复这类数据,语法本身并不复杂,真正的难点在于如何严格控制影响范围。
本文使用一组订单数据模拟一个典型场景:某个导入批次中,部分已支付订单的金额变为 0。修复值统一设为 199.00(不代表真实业务规则,仅用于清晰展示修复过程)。整个操作围绕三个核心问题:需要修改哪些行、改错后如何撤销、以及留下的操作记录能否与影响行数对应。
数据角色区分
首先创建两张表:业务表 t_scene_order 用于存储订单数据,修复记录表 t_scene_fix_log 用于记录每次修复操作。表创建后,通过 dt app_schema.t_scene_* 确认对象位于 app_schema 模式下,所有者是 app_user。
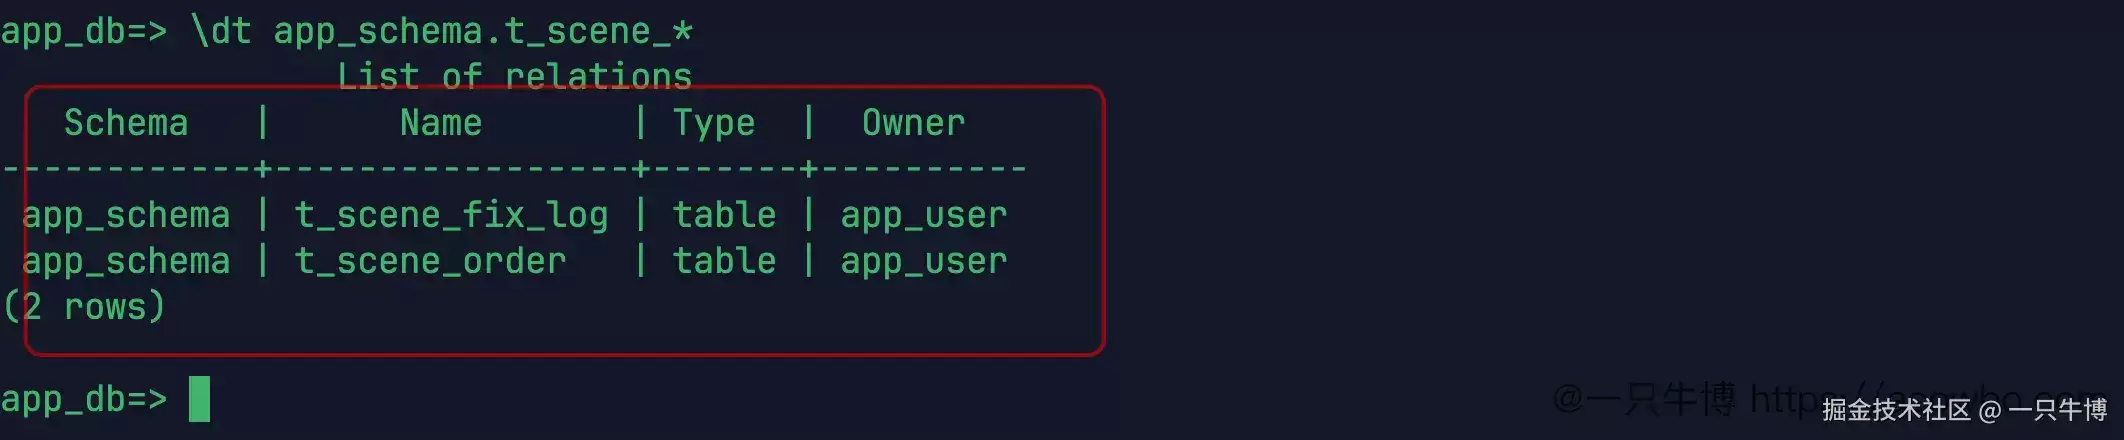
表结构本身并不复杂,需要重点关注的是数据分布——尤其是那些金额同样为 0 的订单,哪些属于本次导入批次,哪些只是看起来类似。
初始数据共 10 行。批次 BATCH_20260609_A 是本次需要处理的导入批次,其中订单 1、2、3、10 均为 paid 状态,金额为 0.00,备注为 import amount missing。订单 4、6、9 虽属于同一批次且已支付,但金额正常。订单 5 未支付,订单 8 为退款,均不能因金额为 0 而修改。
最容易误伤的是第 7 号订单:它同样是 paid 状态,金额也是 0.00,但批次为 BATCH_20260608_B,备注已写明 old batch should not touch。该行数据的目的正是防止修复条件过于随意。
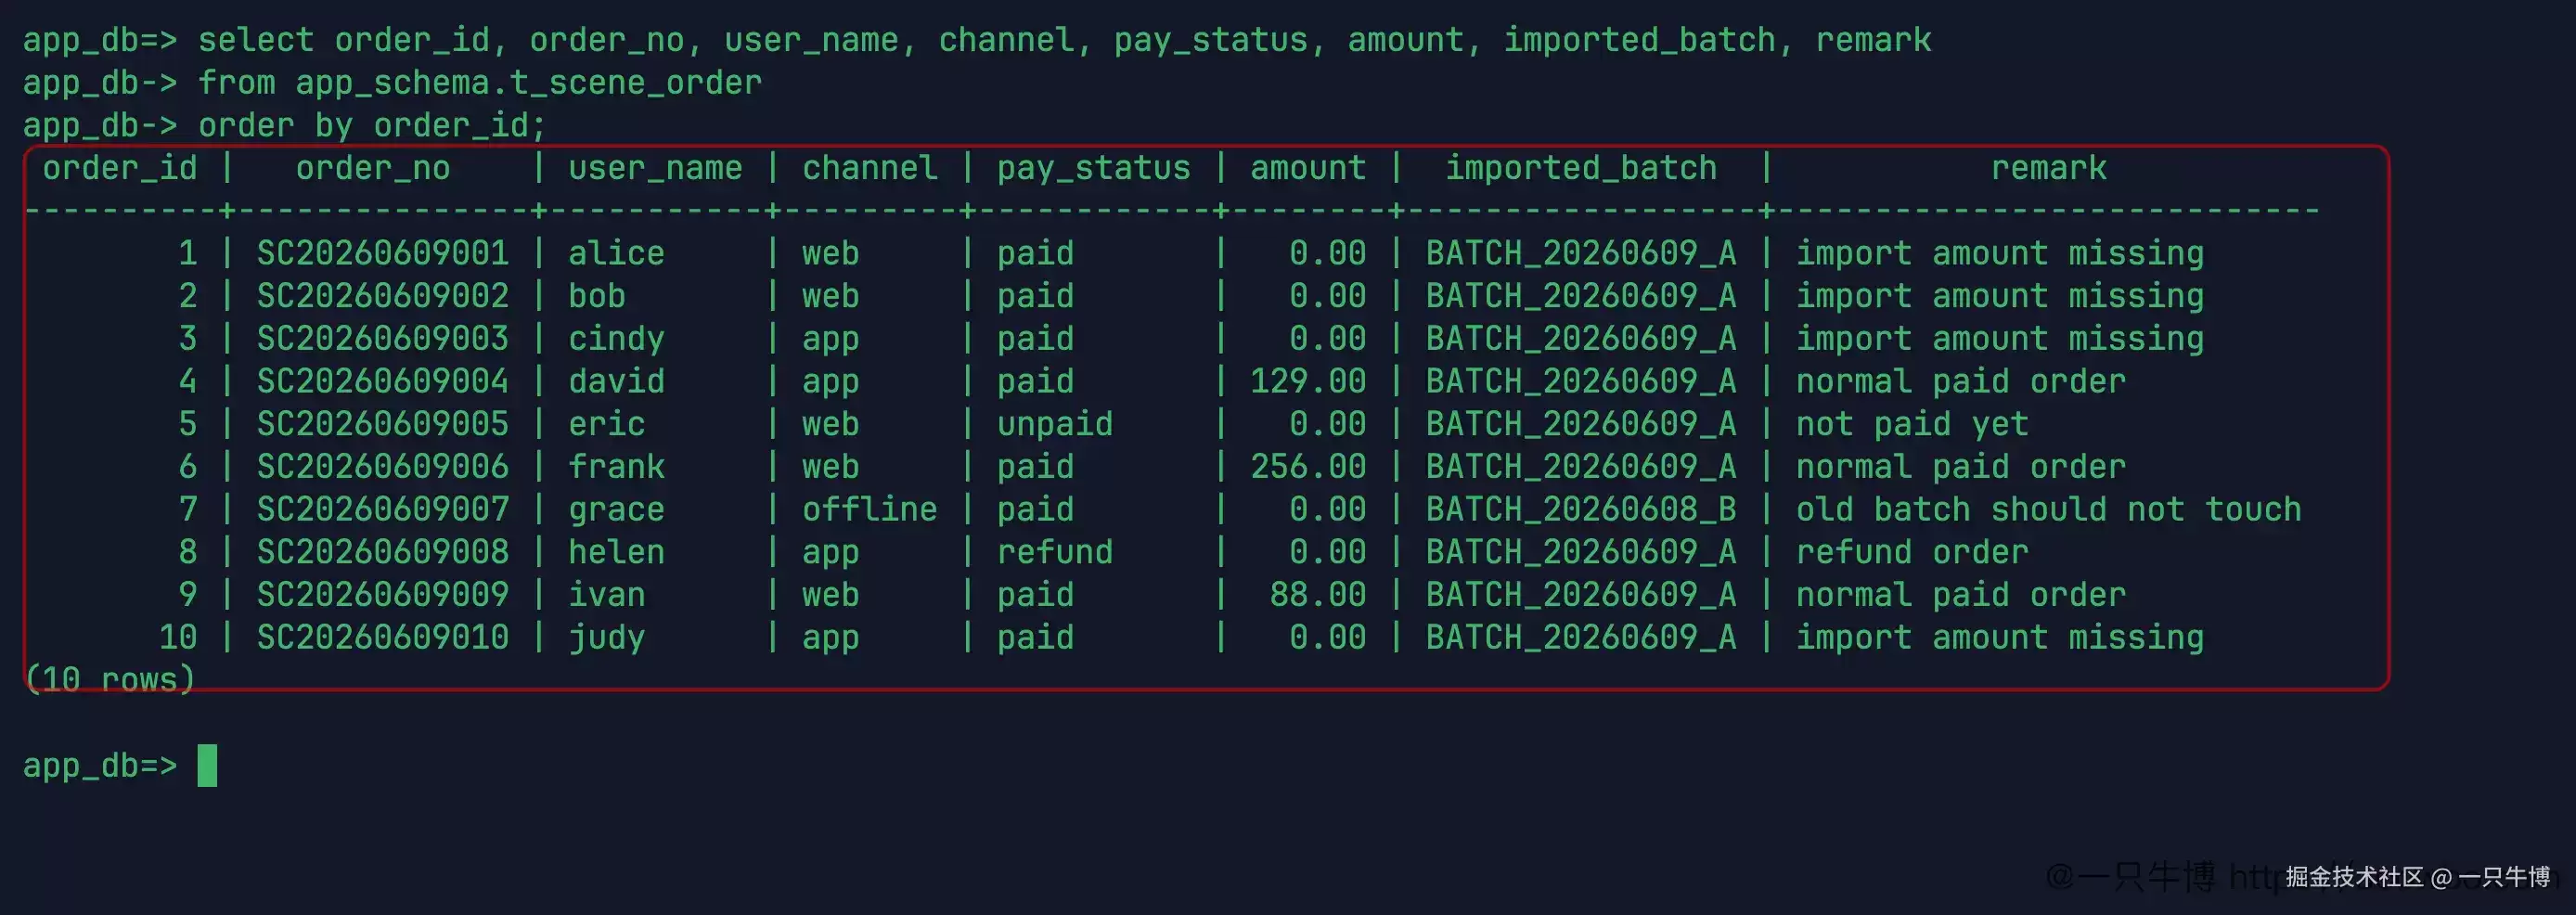
修复前先对这 10 行按角色分类,比后续盯着 SQL 语句更清晰。订单 1、2、3、10 是目标行;订单 7 是误伤参照行;订单 4、6、9 是正常支付订单;订单 5 和 8 金额虽为 0,但状态分别是 unpaid 和 refund,不属于本次修复范围。只要后续 SQL 返回了不应出现的行,便能立即发现异常。
这种准备数据的方式看似繁琐,但更贴近实际业务中的复杂情况。现实中很少只有单一异常行,更多时候是多种状态共存,字段值相似但业务含义截然不同。金额为 0 只是表象,能否修改还需结合支付状态、导入批次和备注上下文来判断。
第一条 SQL 不应是 update
在此场景中,第一条 SQL 不应直接写 update。应首先查询可疑范围,查看条件会带出哪些数据。
先按宽条件查询:pay_status = 'paid' and amount = 0。结果返回 5 行,包含订单 1、2、3、7、10。此时订单 7 立即暴露——它不属于本次导入批次,但会被该条件覆盖。加上 imported_batch = 'BATCH_20260609_A' 后,结果缩减为 4 行,仅剩订单 1、2、3、10。
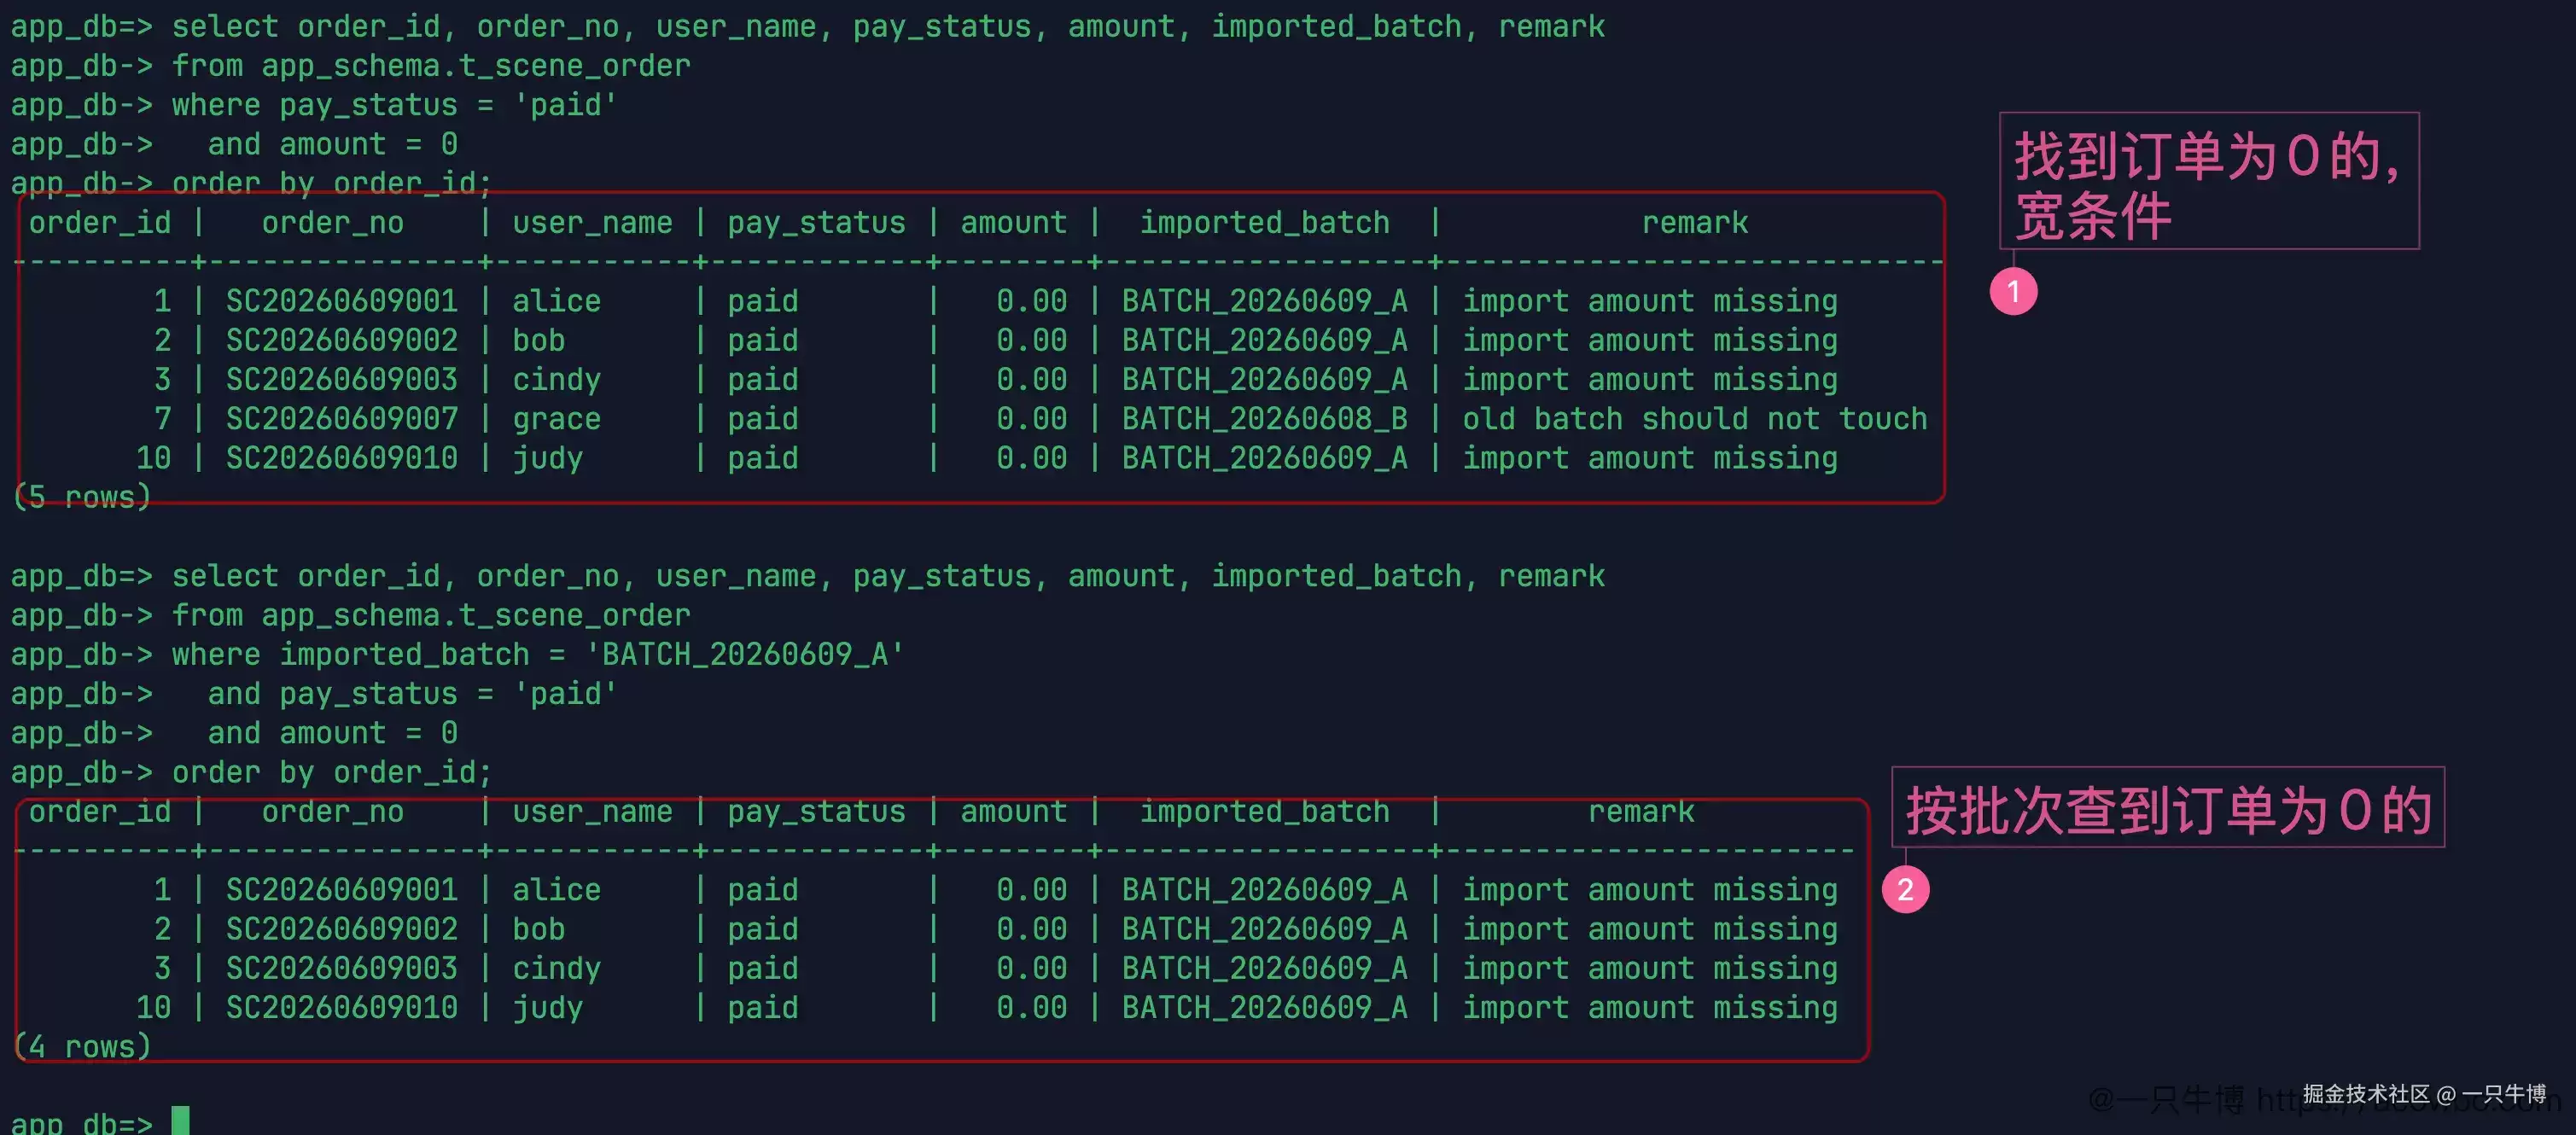
这一步已将风险清晰呈现。仅按“已支付、金额为 0”修复,会多修改一条旧批次订单;通过导入批次收紧条件后,才与实际处理范围一致。后续所有更新都应以这 4 行为基础。
宽条件并非不可用,它适合用于发现边界。第一次查出 5 行,说明异常不仅存在于当前批次;第二次查出 4 行,表明可将批次作为限制条件。两个结果结合,修复条件便不再凭感觉,而是从数据中逐步收窄得出。
这里也可以看出 count(*) 并非唯一选择。很多人在修复前只查数量(例如看到 4 行就准备操作),但数量无法告知这 4 行是否正确的 4 行。同时查询订单号、批次、状态、备注,才能判断条件是否遗漏了业务含义。
修复前保留原始状态
动数据之前,先保留一份原始状态。此处使用 create table as select 创建备份表,将本批次中 paid 且金额为 0 的订单保存下来。执行结果为 SELECT 4,备份表中仅有订单 1、2、3、10,金额仍为 0.00。
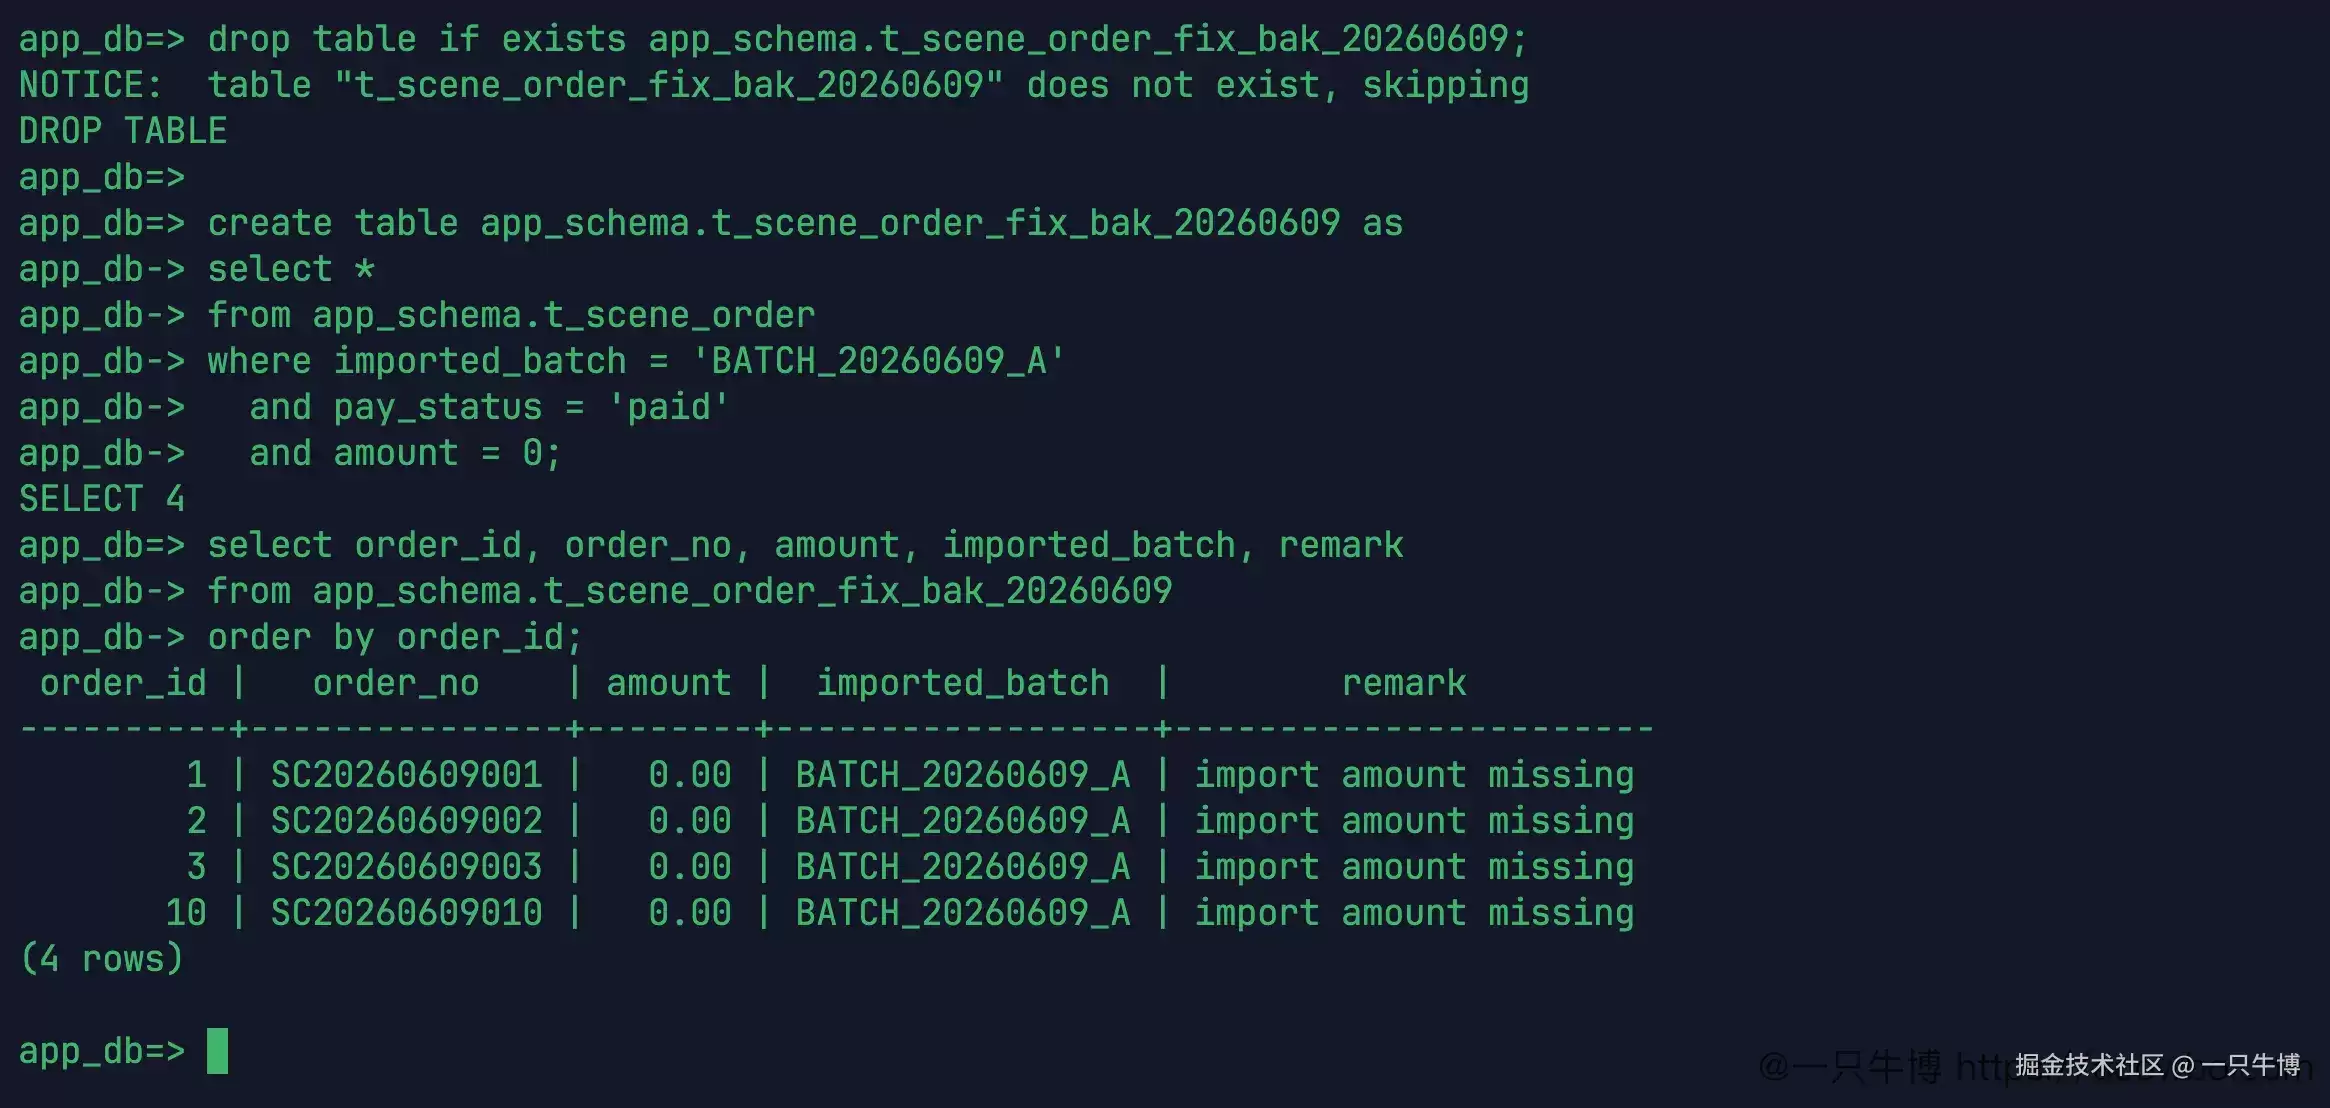
这份备份不解决业务问题,但能为后续核对提供依据。修复前是什么状态,修复后修改了哪些字段,影响行数是否一致,均可回溯此表。临时实验如此操作,正式环境也应具备相应的备份、审批或变更记录,不能仅依赖终端历史。
备份表的价值还在于它不会随事务回滚而消失。此处是在事务试修前单独建立的表,保留的是修复前的候选行。后续无论先试错、回到保存点、还是重新更新,这份原始数据都能留存。当修复金额、备注、更新时间等字段发生改变后,旧值不会仅存在于人的记忆中。
不过,此类备份也不应随意创建。表名包含日期,能识别属于哪次修复;查询条件与后续正式修复条件一致,而非复制整张订单表。正式场景中还需考虑备份表权限、保留时间、敏感字段脱敏等问题,此处仅演示修复前的最小保护动作。
宽条件先暴露风险
接着进入事务,先设置一个保存点 sp_before_fix。此处故意先执行一次宽条件更新,暴露问题:
 复制代码where pay_status = 'paid'
  and amount = 0
该更新将金额改为 199.00,备注改为 fixed by wide condition,并通过 returning 返回被修改的行。结果很直观:返回 5 行,UPDATE 5,其中包含订单 7。
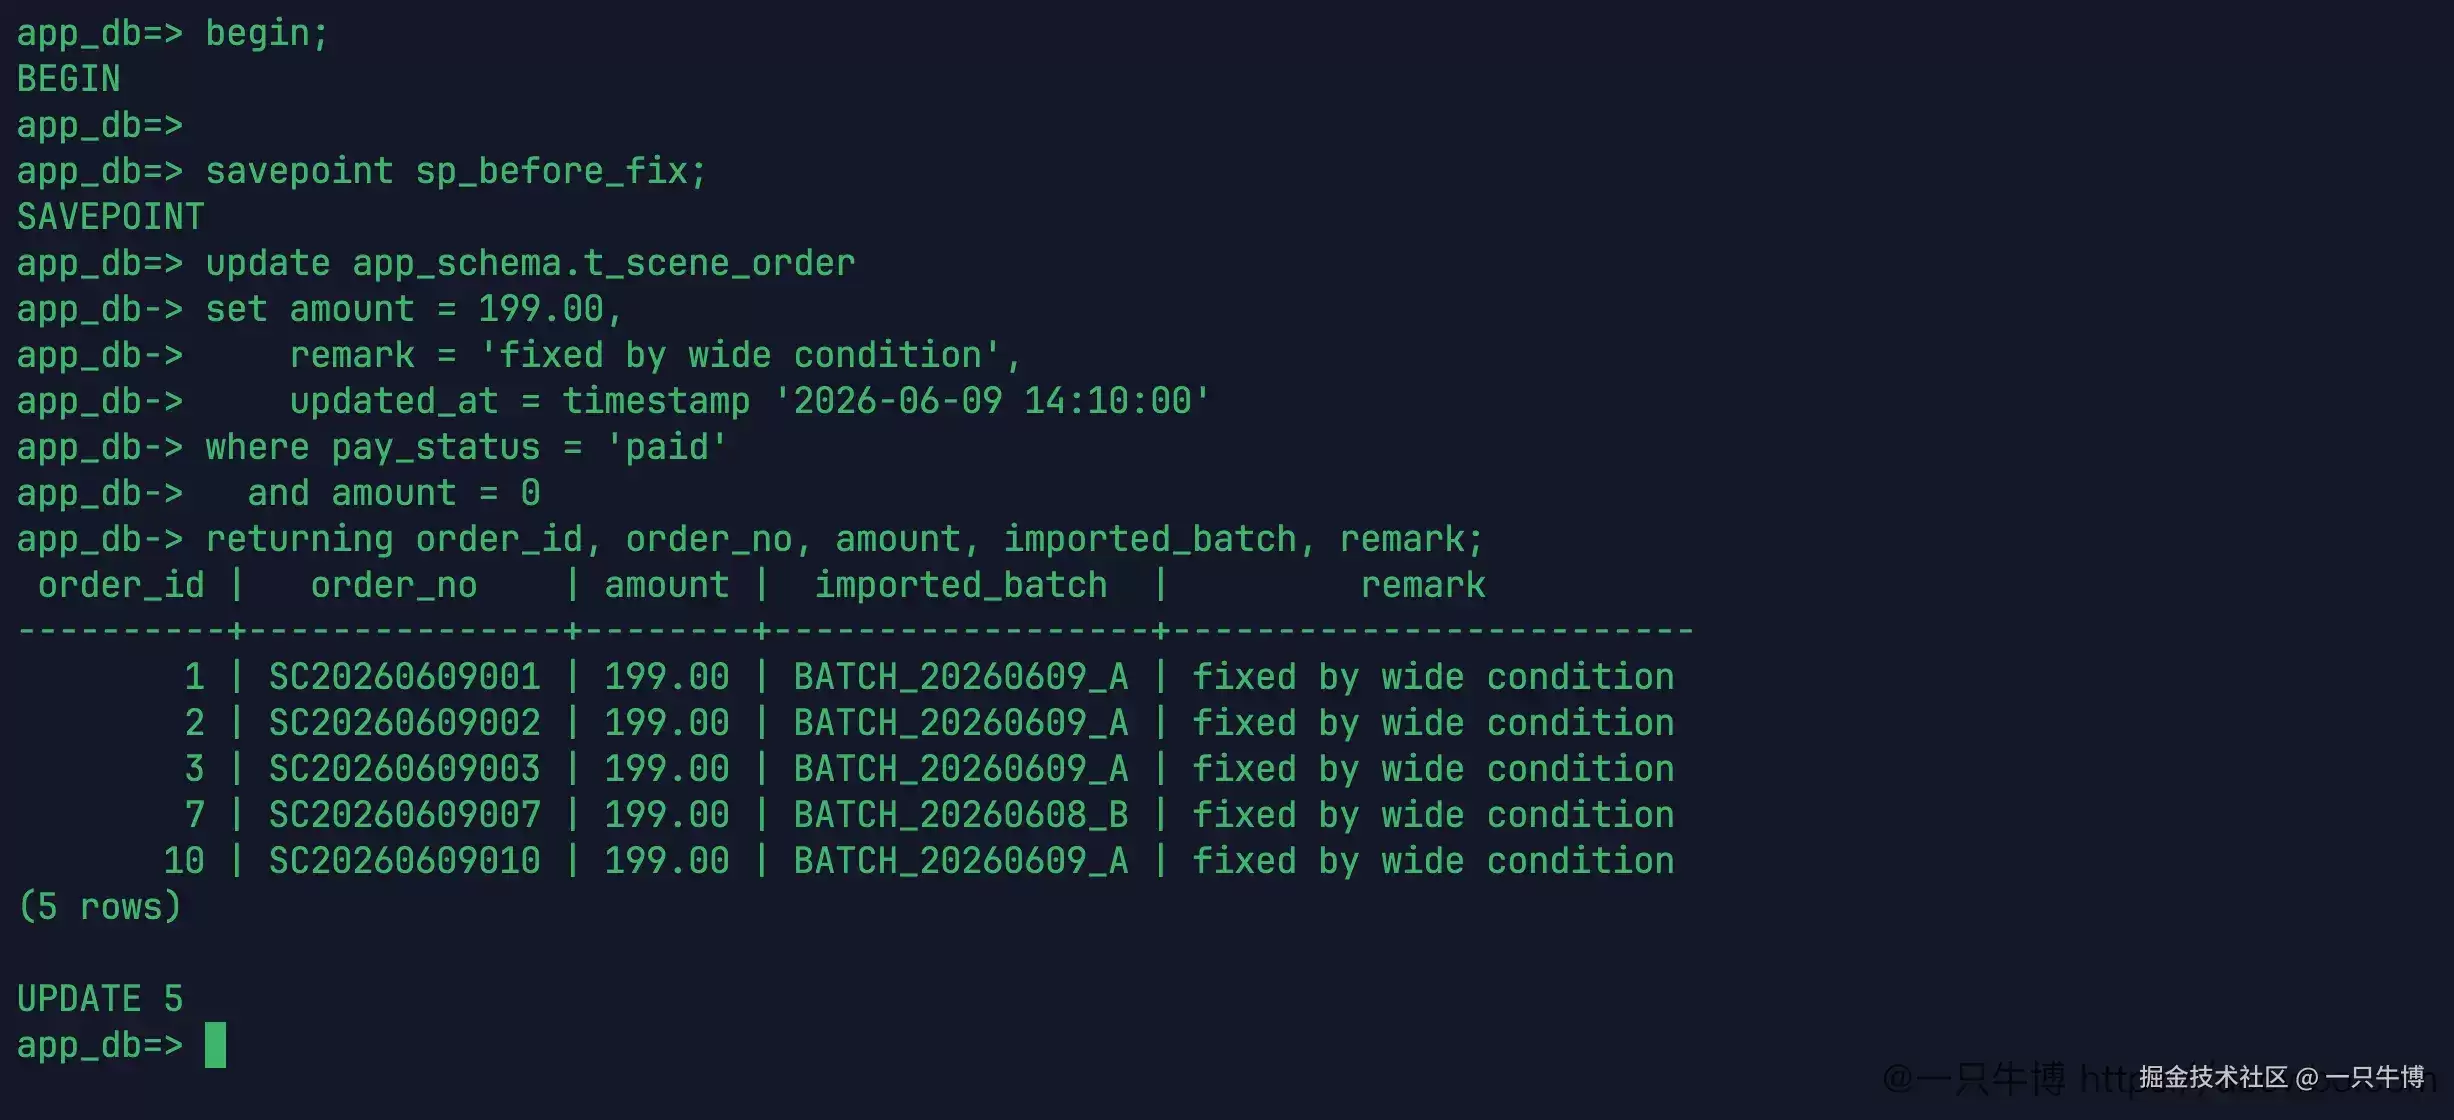
如果没有 returning,仅看 UPDATE 5 也能发现异常——因为前面备份的候选行只有 4 条。但 returning 更直接:订单 7 的批次 BATCH_20260608_B 已出现在返回结果中,说明该 SQL 会误伤旧批次。
此时不应提交,也无需整笔事务重来。保存点已设置,直接回滚到 sp_before_fix。
复制代码rollback to sa vepoint sp_before_fix;
回到保存点后,再次查询订单 1、2、3、7、10。金额全部恢复为 0.00,订单 7 的备注仍为 old batch should not touch,updated_at 也未被写入。刚才的试修已被撤销,事务仍然保持。
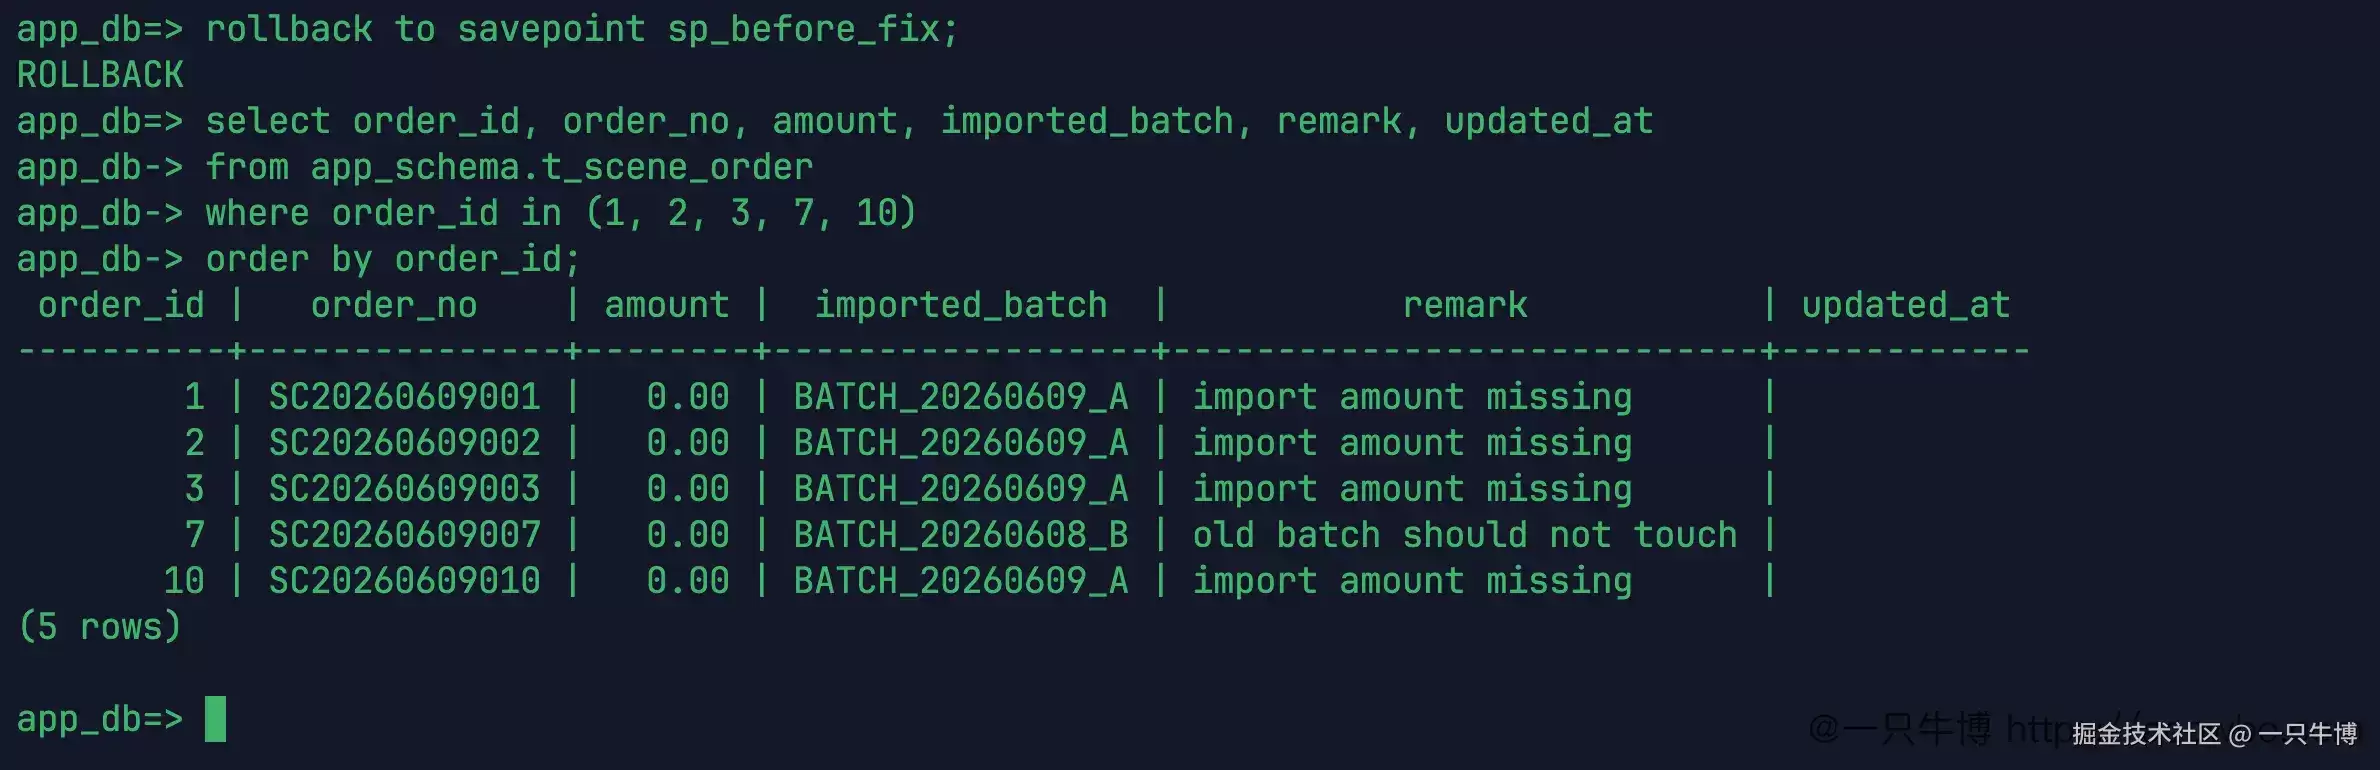
这就是保存点在修复场景中的价值。它并非炫耀语法,而是为试探性操作留出退路。条件写宽了,先撤回到试修之前;前面已完成的备份、范围判断和事务上下文无需重新开始。
回到保存点后,当前会话仍在同一笔事务中。前面的试修结果消失,但数据库连接未退出,后续可继续执行新的 update。这与直接 rollback 整笔事务不同:整笔回滚会撤销当前事务中所有变动,而保存点只撤销保存点之后的部分。
此类修复不适合依靠“应该没问题”来推进。宽条件试修已将订单 7 带出,若此时继续修改,只会使错误叠加。先回保存点,将现场清理回试修前,再换成更窄的条件,后续结果才容易判断。
收紧条件后正式更新
重新编写更新条件,此次加入导入批次:
 复制代码where imported_batch = 'BATCH_20260609_A'
  and pay_status = 'paid'
  and amount = 0
返回结果变为 4 行,恰好是订单 1、2、3、10。金额统一改为 199.00,备注改为 fixed after batch check,更新时间为 2026-06-09 14:20:00。订单 7 未出现在返回结果中。
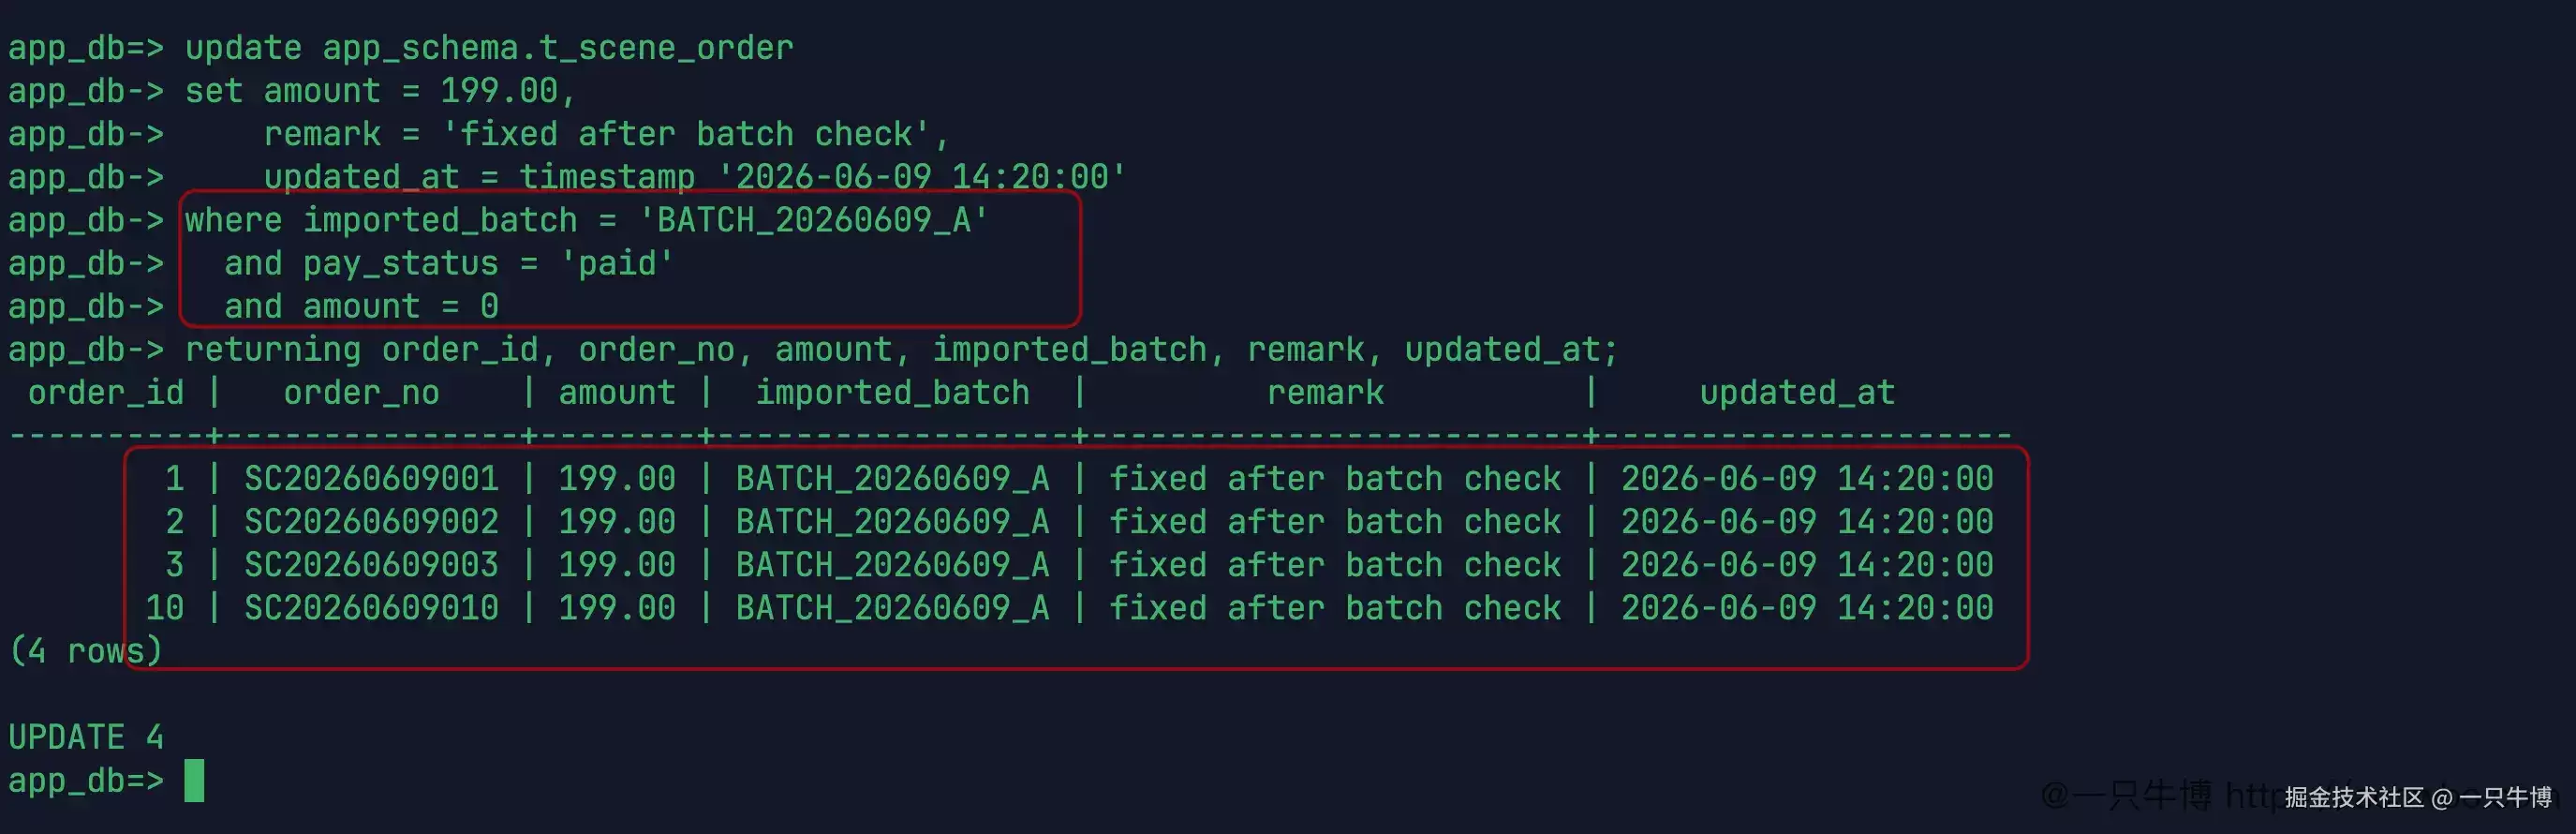
本次影响范围与之前备份表一致:备份 4 行,正式更新 4 行,订单号也相同。修复时最怕只关注 SQL 能否执行,而不关心它修改了哪些数据。此处通过 returning 直接将修改的订单列出,减少了一层猜测。
returning 返回的是更新后的值,因此可以直接看到金额已变为 199.00,备注变为 fixed after batch check,更新时间也写为 2026-06-09 14:20:00。如果仅看 UPDATE 4,还需再执行一条查询才能确认修改后的字段是否符合预期。
当然,returning 不能替代后续对账。它只能说明当前更新命中了哪些行,无法证明没有遗漏其他业务条件。例如退款单 8 未出现,是因为条件限制了 pay_status = 'paid';旧批次 7 未出现,是因为添加了导入批次。字段限制是否完整,仍需回到业务场景中判断。
提交前核对参照行
提交前再进行一次对账。将目标行与订单 7(参照行)一起查询:订单 1、2、3、10 的金额已变为 199.00,备注均为 fixed after batch check;订单 7 仍为 0.00,批次仍为 BATCH_20260608_B。再查询本批次中 paid 且金额为 0 的数量,结果为 0。
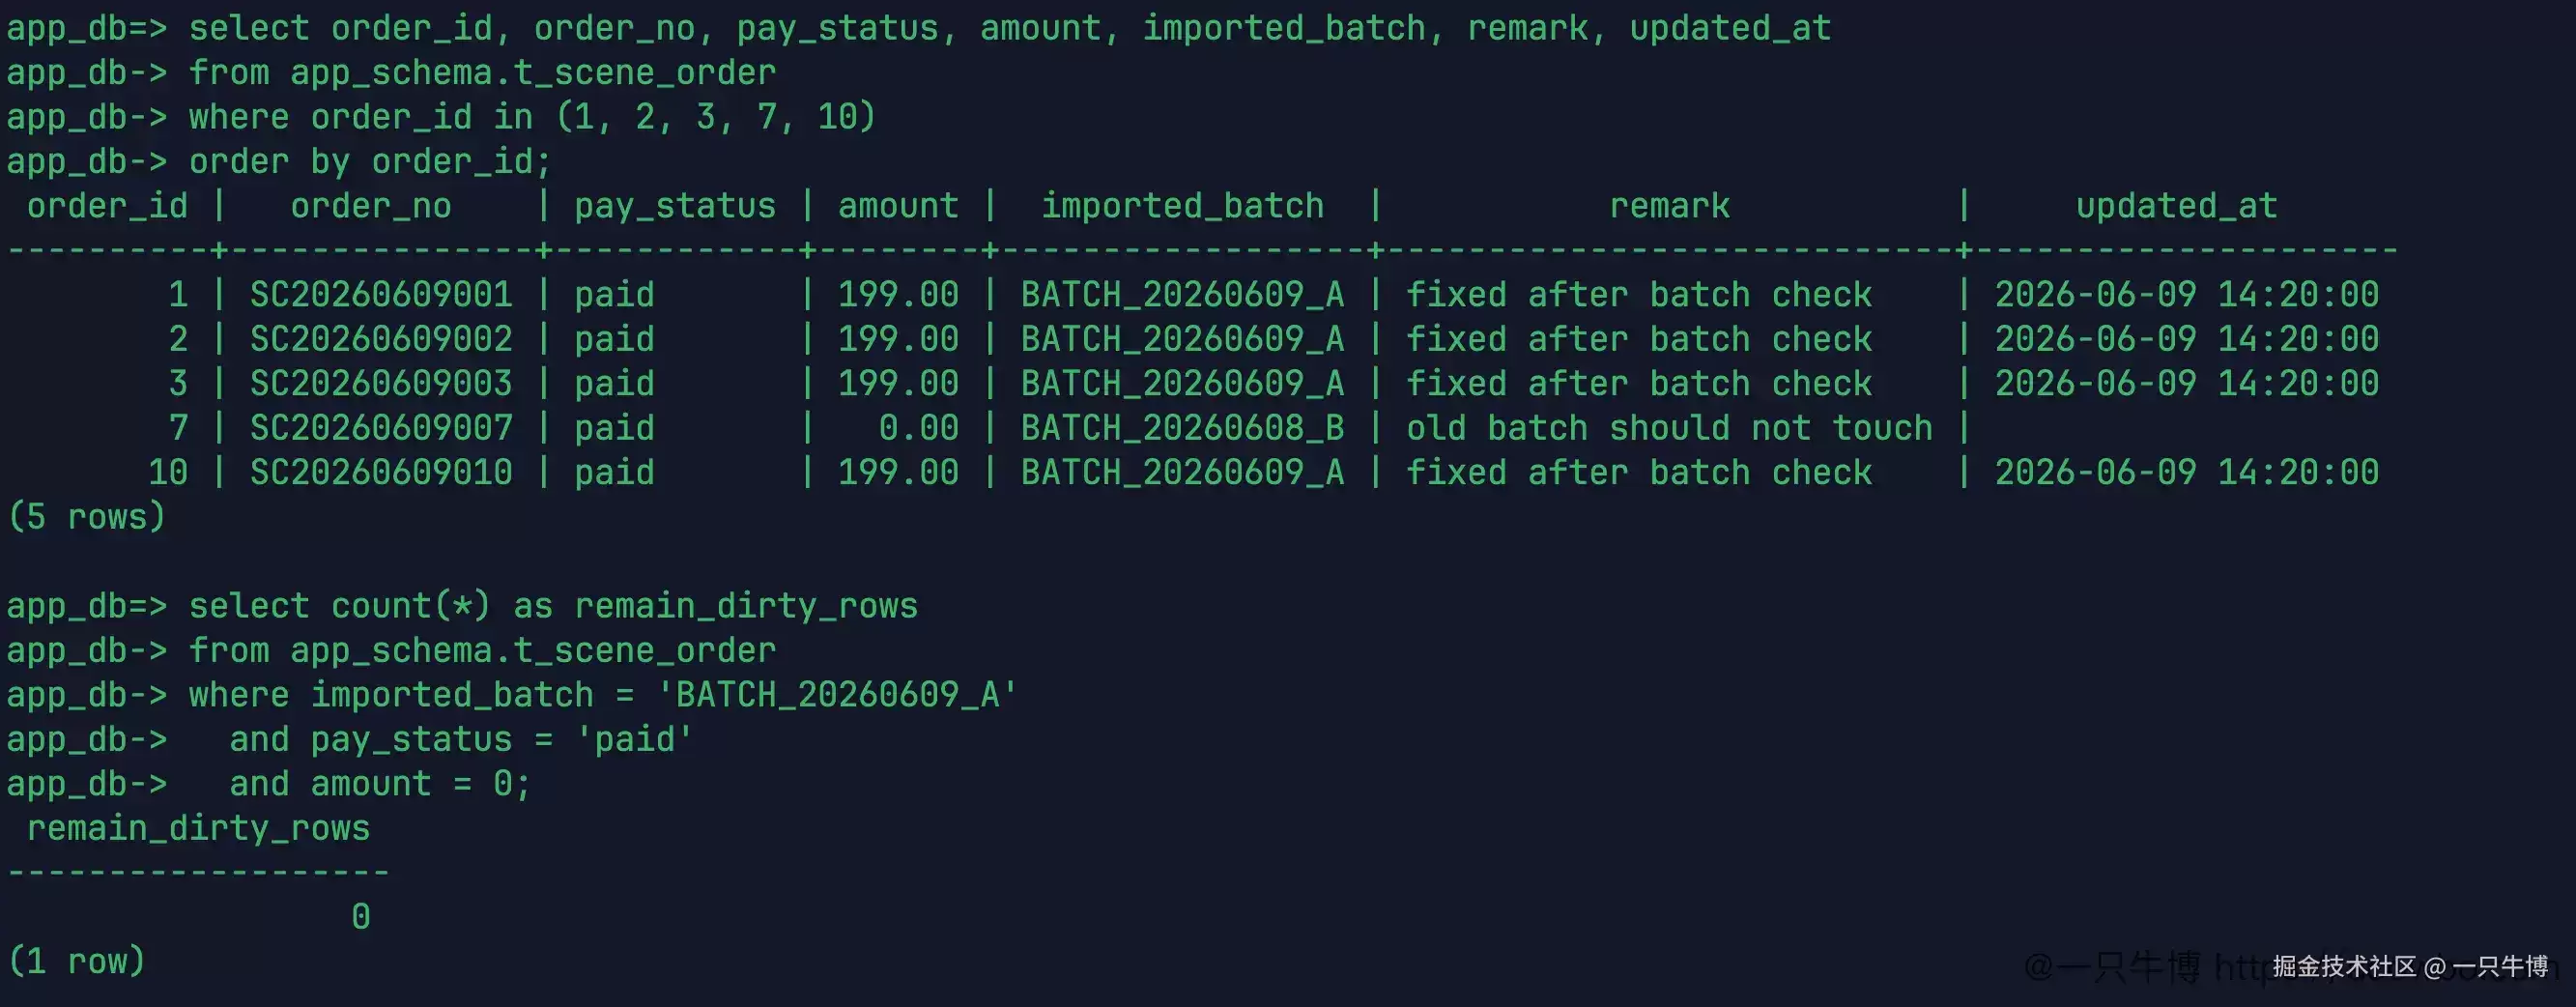
这一步比单纯看 UPDATE 4 更加稳妥。UPDATE 4 只能说明修改了 4 行,不能说明这 4 行就是目标行;对账查询同时查看了目标行、参照行和剩余脏数据,才能确认本次修复未将旧批次纳入。
在对账时将订单 7 加入查询是有意为之。它不是目标行,但却是最容易被宽条件误伤的行。如果只查订单 1、2、3、10,会看到目标行都已修复;将订单 7 一并查询,才能确认“应保持原样的行”确实没有变化。
remain_dirty_rows 返回 0,也只是当前条件下的结果:本批次、已支付、金额为 0 的订单没有剩余。这并不代表整个订单表不再有金额为 0 的数据,因为订单 5、8、7 原本就不在本次修复范围内。需要明确这个边界,否则容易将局部修复误认为全表清洗。
修复记录与影响行数对应
确认范围无误后,再写入一条修复记录。记录写明 fix paid zero amount orders,影响行数为 4,备注为 only BATCH_20260609_A paid orders were updated,时间为 2026-06-09 14:25:00。该记录与前面的更新结果一致。
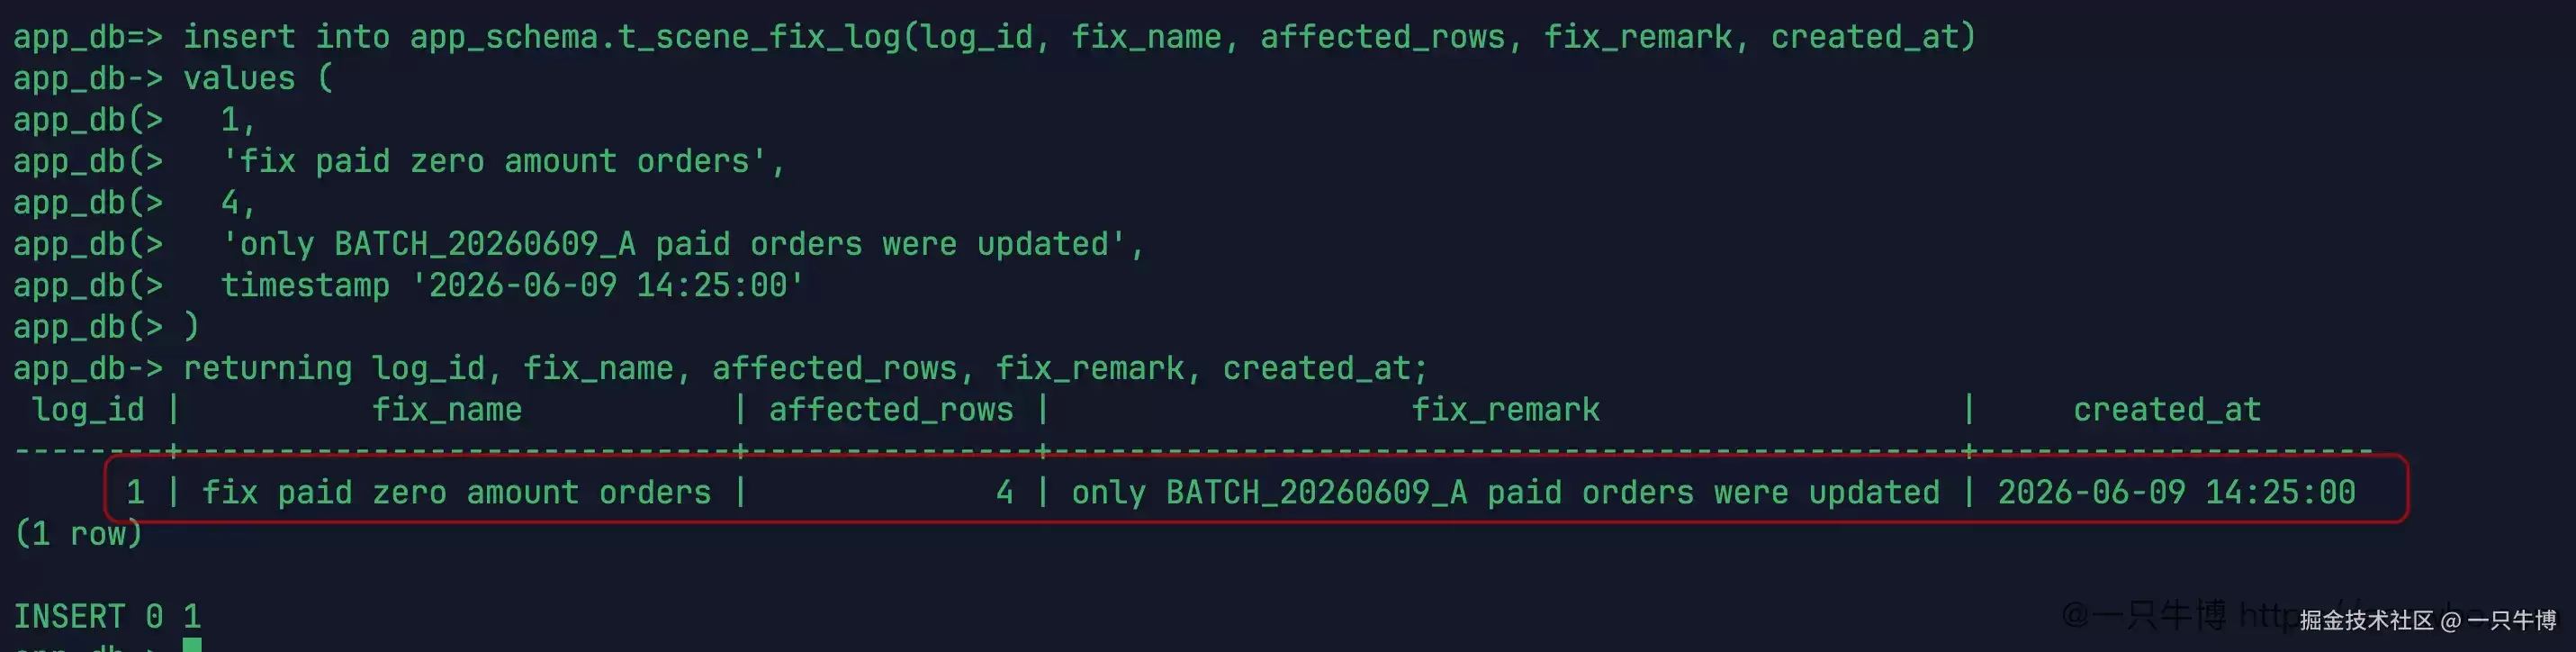
修复记录已插入成功,返回 INSERT 0 1。此处未将后续提交和全表终态强行写为已验证内容,仅按照终端中能确认的结果收尾:修复记录已生成,提交前的对账已确认目标行和参照行状态,记录也对应了具体批次和影响行数。
修复记录中的 affected_rows 写为 4,不能随意填写。它对应的是收紧条件后的 UPDATE 4,而非宽条件试修时的 UPDATE 5。如果此处也写 5,记录本身就会与实际修复范围冲突;如果不写记录,事后只能从日志或终端历史中查找,成本会高得多。
整个流程运行下来:开始时宽条件查出 5 行,表明直接按金额修复会带上旧批次;按批次收紧后为 4 行,备份表也保存了这 4 行;事务中故意尝试宽条件,returning 暴露了订单 7 的误伤;回到保存点后,订单 7 恢复原样;收紧条件再次更新,返回结果仅剩目标 4 行;提交前对账,本批次剩余脏数据为 0。
如果要将本次操作总结为一句话,那就是:将“可能有问题”的数据转化为“确定要处理”的数据。这一过程并非依赖某个固定模板,而是通过多次核对:先宽范围查询,再按批次收窄,接着备份,然后在事务中试运行,发现多改则回退,最后补齐条件。
今后遇到类似修复任务,不要急于执行看起来正确的 SQL。先查询范围,保留原始状态,在事务中试运行一遍,利用返回结果看清影响行,发现异常就回到保存点。最后将修复结果、参照行和记录表核对一致。这样处理虽然多写几条 SQL,但比一次宽条件更新后再追查误伤要省事得多。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。